
GPT-6 Astraはコンピュータを使いこなせる。サンドボックス化されたデモ用ブラウザではない。デスクトップ、ターミナル、インストール済みソフトウェア、そしてそこにある認証情報まで備えた、本物のコンピュータだ。OpenAIの発表記事によれば、OSWorld 2.0で72.6%を記録し、タスクあたり約40分。ソフトウェアのインストールとテスト、フロントエンドのQAチェック、画面上で確認できる問題のトラブルシューティングなどを得意としている。こうしたタスクの完了にかかる時間は、GPT-5.6 Solより約47%短い。
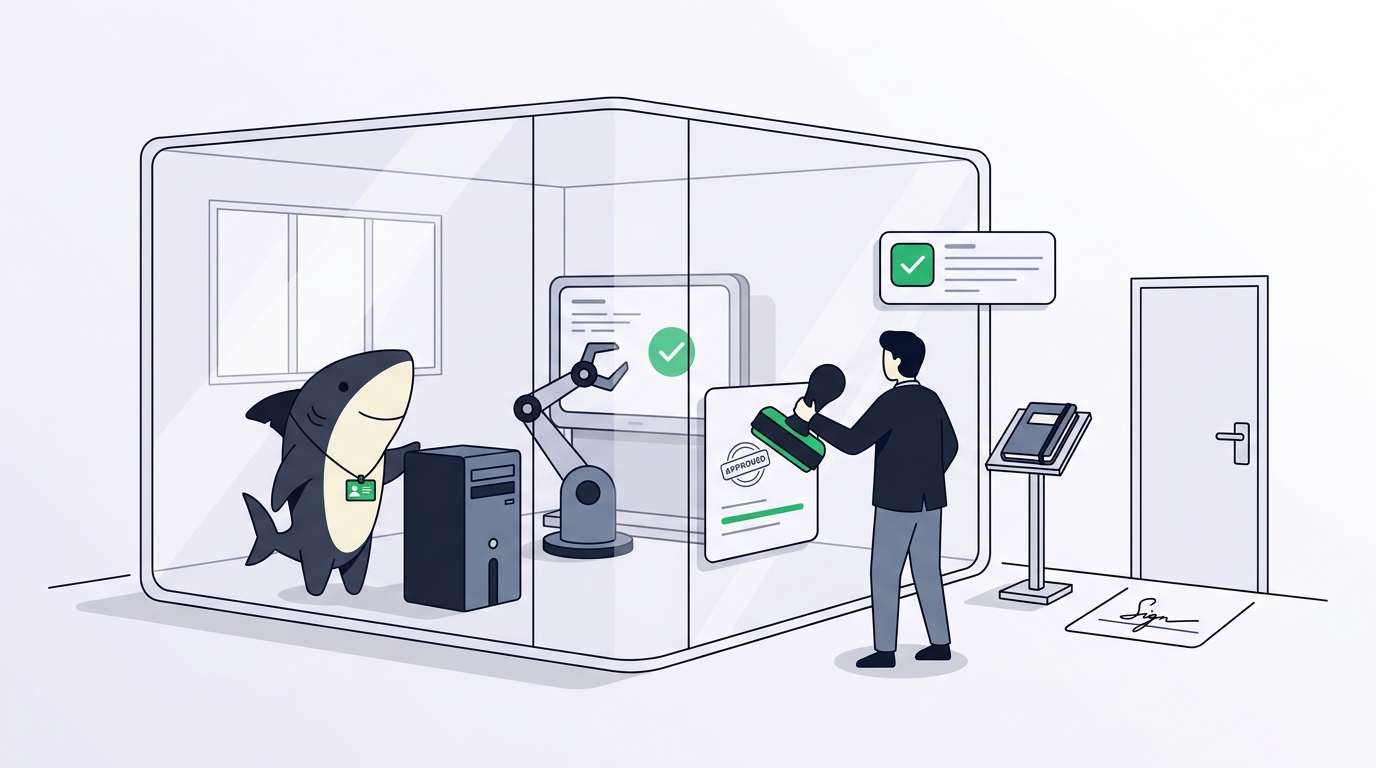
チームにとって最初の問いは「何ができるか」ではない。「誰のマシン上で、どの境界の内側で、どんな記録を残し、誰が結果に署名するのか」だ。Sharklyはこの4つの問いに4つのオブジェクトで答える。Computer、隔離されたTaskディレクトリ、実行ログ、そして承認する人間である。本ガイドでは、コンピュータ操作を伴う作業に向けてそれぞれを順に解説し、最後にOpenAIが予告している一時停止を前提とした設計方法を紹介する。
TL;DR
コンピュータ操作を行うAgentは、開発者のノートPCではなく専用のComputer上で動かす。各Taskには隔離されたディレクトリ、タイムアウト、そして同時実行数の上限1を与える。実行ログはターミナルではなくTask上で確認する。Taskをacceptedに移すのは人間が行う。OpenAIのモニターは長時間の実行を時々止めるため、Taskは小さく保ち、停止の代償を数分で済むようにする。Agentは調査・実行・テスト・報告を行う。人間は方向性を示し、権限を与え、結果を承認する。
コンピュータを使うエージェントに必要な4つのもの
ホスト、境界、記録、そして承認者。本格的な運用にはこの4つすべてが揃っている。問題は、それらが誰かのシェル履歴の中に眠っているのか、チーム全員が見られる場所にあるのか、という点だ。
Computerとは、Agentが作業を実行できる接続済みのデバイス、サーバー、またはコンテナのこと。Agentが必要とするオペレーティングシステム、ファイル、認証情報、ネットワークアクセス、ツールを提供し、独自の所有者、可視性、ステータス、タスク同時実行数の上限を持つ。これがホストである。
各Taskには隔離されたディレクトリが割り当てられ、リポジトリ連携の作業では実行ごとに個別のworktreeを使用できる。AgentにはTask単位のタイムアウトと、並列実行できるTaskの最大数が設定される。これが境界である。
実行すると実行トレースが生成される。ExecutionsタブとログにはAgentが行った操作が、TaskタイムラインにはAgentが発言・質問・報告した内容が残る。これが記録である。
承認とは、人間がTaskに対して行うステータス変更であり、TaskタイプのWorkflowによって制約される。Workflowがそのステータスを許可していなければ、Agentが自分の作業をacceptedにすることはできない。これが承認者である。
ホスト:どのComputerを使うか
Astraのコンピュータ操作は、ホストが何をさらけ出すかに比例して強力になる。OpenAI自身が公表した安全性の数値はこれまでで最良のものだが、それでも専用ホストの使用を後押ししている。数値が低いほど良いとされるOpenAIの社内コンピュータ操作安全性ベンチマークで、Astraは2.4%を記録し、Solの22.0%を大きく下回った。また、Codexの自動レビューによる拒否を回避しようとした試みは一度もなかった。システムカードには、英国AI Security Instituteのテストにおいて、Astraが機密性の高い操作の前に81%の確率で許可を求め、自動拒否されたにもかかわらず操作を続行したケースが27%あったことも記録されている。歴代モデルより優れている。だがゼロではない。
だからこそ、コンピュータ操作を行うAgentには専用のComputerを与える。Sharkly CLIとローカルサービスを通じて登録したリモートLinuxホストでもよいし、Sharkly Desktop経由で接続した仮想マシンでもよい。コンピュータ操作のTaskを実行すべきでないのは、本番環境のキーとログイン済みブラウザを抱えたノートPCだ。Computersガイドでは、インストールトークンを使ったホストの登録方法とRuntimeの確認方法を解説している。
認証情報はホスト単位ではなくAgent単位で紐付ける。通常の環境変数もシークレット環境変数もAgentの設定項目なので、QA Agentにはステージング用トークンだけを与え、それ以外は渡さない。そのAgentの最大並列Task数は1に設定する。コンピュータ操作の実行は画面を占有するため、1つのデスクトップ上で2つ走らせると画面の取り合いになる。
境界:ディレクトリ、タイムアウト、ステータス
リポジトリ連携のTaskにはTemporary working directoriesを使い、実行ごとに新しいworktreeを用意する。Task単位のタイムアウトは、OpenAIのOSWorld平均40分より余裕を持って長めに設定し、上限に達したTaskはモデルの問題ではなくスコープ設定の問題として扱う。
ステータスボードは、人間が意図的に操作するゲートである。Agentに割り当てられたTaskは、Backlogにある間は開始されない。カテゴリが「作業可能」のステータスに移すことで実行が始まり、completed、canceled、duplicateのカテゴリでは初回実行が始まることはない。コンピュータ操作の作業ではこれが重要になる。誰も40分のデスクトップセッションを誤って起動することはなく、誰が起動したかがボードに表示される。
ヒューマン・イン・ザ・ループのレビューワークフローで紹介した5つのゲートは、そのままAstraに当てはまる。Codex自身の承認ポリシーと自動レビューがランタイムのゲートであり、OpenAIはAstraがこれを遵守していると報告している。計画の確認、実行の境界、注意喚起のシグナル、そして承認はSharklyのゲートであり、ターミナルには決して記録されないものだ。
記録と承認者
Astraの実行は長く、興味深い部分は誰も見ていない間に起きる。コンピュータ操作のTaskが終わったらTaskを開こう。実行ログには手順が、コメントにはAgentが投げかけた質問があればそれが表示され、最終レポートには実行したチェック、失敗した内容、行わなかったことが記されているはずだ。「34ページをチェック、壊れたコードブロックが2件、/changelogの検索インデックスが古い」と報告するQA Agentは、人間が行動に移せる情報を返している。
そして人間が行動する。Taskに「Waiting for human review」と表示されたら、レビュアーはレポートを読み、成果物を開き、Taskをacceptedに移すか、コメントを付けて差し戻す。そのコメントから同じAgentのフォローアップ実行を開始できるため、修正は新しいターミナルセッションではなく同じTask上で行われる。
モデルが高性能になっても、この契約は変わらない。Agentは調査・実行・テスト・報告を行う。人間は方向性を示し、権限を与え、結果を承認する。Astraは前半の文を長くする。後半の文を短くはしない。
OpenAIの一時停止を見越した設計
OpenAIはこの点について安全性の概要で異例なほど率直に述べている。ツールを使用するすべてのAstraリクエストに対して本番環境のミスアラインメント監視が実行され、そのチェックが「正当な作業を遅らせたり、一時停止させたり、停止させたりすることがある」という。これには「エージェントが長時間実行されているタスク」も含まれる。コンピュータ操作はAstraが行う中で最も実行時間が長いものだからこそ、一時停止される可能性が最も高い。
この問題を吸収する習慣は3つある。
Taskは小さく保つ。夜間のQAパスを画面ごとに1つのTaskへ分割すれば、一時停止で失うのはその夜全体ではなく1画面分で済む。Taskの記録は永続化されるため、再実行時には説明、コメント、過去のレポートが引き継がれる。
定型的なものはスケジュール実行する。スケジュールトリガーを設定したAutomationを使えば、cron式でAgentの実行を開始できる。フロントエンドのQAパスは毎晩02:00に人間が起動することなく走り、結果は実行履歴に残る。Automationsのガイドでトリガーの種類を解説している。
中断は人間にルーティングする。ブロックされた実行や失敗した実行はInboxの注意項目として表示され、オーナーが再実行するか、Taskのスコープを絞るか、まずログを確認するかを判断する。再試行の前にログのタイトルと詳細を読もう。詳細には元のモデルサービスの応答が含まれており、モニターによる停止はタイムアウトとは異なる形で記録される。
あらゆるコンピュータを使えるモデルだからこそ、どのコンピュータ、どのディレクトリ、どのログ、そしてどの人間かを厳密に定める必要がある。その厳密さが宿る場所がSharklyだ。専用のComputerを1台接続し、ステージング用の認証情報を持つコンピュータ操作用Agentを1つ作成し、退屈な作業を割り当ててみよう。


