
OpenAI は9月22日に GPT-6 Luna をリリースしました。価格は入力100万トークンあたり $0.10、出力100万トークンあたり $0.50、API ID は gpt-6-luna、コンテキストウィンドウは 1M です。この価格帯になると、面白い問いは「このモデルは抽象的には十分優れているか」ではなくなります。代わりに問われるのは、ボード上のどのレーンをこのモデルに任せるか、そして安価なレーンと高価なレーンを同じ Computer 上でどう運用し、どのレーンがその結果を生んだのか誰も見失わないようにするか、ということです。
これはモデルの問題である前に、設定の問題です。Luna をあらゆる場面にバインドするチームは、浮いたコストをレビューで使い果たしてしまいます。逆にまったくバインドしないチームは、テストファイルの名前を Agent に変えさせるためだけに割増料金を払い続けることになります。本ガイドは最小限の実用的な道筋をたどります。gpt-6-luna を1台の Computer に載せ、専用のレーンに隔離し、実際の Task を1つ割り当て、チームが見える場所でその結果を確認する、という流れです。
TL;DR
接続済みの Computer 上で、Runtime のデフォルトモデルとして gpt-6-luna をバインドし、その Runtime が Sharkly で Available と表示されることを確認します。高価な Agent を使い回すのではなく Luna 専用の Agent を用意し、長時間の実行を信頼する前に Task ごとのタイムアウトを延ばしておきます。そして Luna には、人間が1分以内に出力を確認できる作業を任せます。Sharkly はモデル名を表示しません。表示するのは実行、ログ、質問、そして Task 上の結果です。Agent は調査・実行・テスト・報告を行い、人間は方向性を示し、権限を与え、結果を受け入れます。
モデル設定はどこにあるのか
Sharkly はモデルを選びません。Agents のドキュメントには明記されています。「Agent は Runtime のデフォルトモデルに従います。特定のモデル名を保証したり表示したりすることはありません。モデルの変更は Agent 上ではなく、Runtime または Computer のツール設定で行ってください。」
つまり、Agent にはモデルのドロップダウンも、思考の深さ(thinking depth)の設定もありません。4つの役割が、それぞれ1つの仕事を担います。Agent は作業の扱い方を定義します。Computer はホストとローカルリソースを提供します。Runtime は実際のエージェントセッションを実行します。Task はチーム共有の記録であり続けます。この構成の詳しい手順は GPT-6 Sol ガイド で解説しています。本記事では、安価なモデルをボードに載せることに固有の部分を扱います。
ステップ1:Computer に gpt-6-luna をバインドする
実行に使う Computer 上でエージェントツールを更新し、Luna にアクセスできるアカウントまたは API キーでサインインします。OpenAI は Luna を ChatGPT Work と Codex(Plus、Pro、Business、Enterprise、Edu プラン)で利用可能にし、Free および Go ユーザーにはデスクトップアプリで Luna を提供しましたが、Chat にはまだ投入していません。そのホストの通常のターミナルで codex -m gpt-6-luna がセッションを開始できれば、Sharkly から利用できます。
次に、その Runtime 上の実行がこれを拾うようにデフォルトを設定します。
# ~/.codex/config.toml
model = "gpt-6-luna"
model_provider = "openai"
model_reasoning_effort = "high"
このスニペットには注意点が2つあります。reasoning-effort のキー名は Codex のバージョンによって異なるため、その Computer にインストールされているビルドのサンプル設定と照らし合わせて確認してください。また、high はデフォルト値としてではなく、意図的に記載しています。以下に挙げる公開済みの Luna の結果はすべて high または max effort で測定されたもので、安価なモデルをさらに安くするために選ぶような設定でのものではないからです。[VERIFY]
Sharkly に戻り、Computer の詳細を開いて再スキャンまたは接続テストを実行します。Runtime が Available と表示されれば OK です。Computer が online と表示されるだけでは、そのローカルサービスがハートビートを送っているにすぎません。実行を開始できるかどうかを示すのは、Runtime のケイパビリティステータスです。
ステップ2:安価なレーンを目に見える形で分離する
1台の Computer は1つ以上の Runtime を公開でき、それぞれが独自の接続状態を報告します。また、Computer の詳細からカスタム ACP Runtime を、独自の名前と起動コマンド付きで追加できます。ここで使う価値のあるレバーはこれです。Luna のレーンに専用の Runtime エントリと専用の Agent を用意し、モデル名ではなくレーン名を付けておけば、誰かが実行ログを読まなくても、ボード上でその Task がどのレーンで実行されたかが分かります。
これは見た目だけの話ではありません。Sharkly は Runtime が実際に使用しているモデルを確実に読み取ることができません。だからこそ Agent は Runtime のデフォルトに従い、モデル名を表示しないのです。誰かが設定ファイルを編集したせいで、ある Agent が火曜日と木曜日の間でこっそりモデルを変えたとしたら、Task 上では同じに見える2回の実行は同じではありません。コスト帯ごとにレーンを分けておけば、チームがすでに見ているその場所で、それが可視化されます。Runtime がどのように検出・テストされるかは Sharkly の Computers をご覧ください。
2つのレーンは維持にコストがかかるので、判断のペアを示します。その Computer 上で複数の人が作業を割り当てており、$0.10 の実行と $10 の実行の差が誰かにとって重要なら、Runtime を分割しましょう。1人のエンジニアが週に数件の Task を実行するだけなら、分割しない方がよいです。Runtime を1つにして Task ごとに判断する方が覚えておくことが少なくて済みますし、worktree の分離によって実行同士が衝突することはすでに防げています。
ステップ3:起動の遅いモデルに合わせて実行を設計する
安いことは速いことと同じではありません。そして、これが最初に多くの人が間違える設定です。どちらのベンダーでもない第三者の Artificial Analysis は、GPT-6 Luna の max reasoning バリアントについて、出力 153.9 トークン/秒、最初のトークンまで 124.23 秒という測定結果を出しています。これは、多くの人がプロセスがハングしたと判断して待つのをやめるよりも長い時間です。
ですから、Task ごとのタイムアウトは意識的に設定し、作業ディレクトリは Temporary モードにしておいてください。こうすると各 Task が独立したディレクトリと新しい worktree を取得します。同じリポジトリ上で2つの Luna 実行が互いを上書きすることはなくなり、考えている最中の実行と死んでしまった実行も見分けられます。Task はステータスを持ちますが、ターミナルのスクロールバックは持たないからです。
Crew の中で安価な Runtime をどこに配置するか
Crew とは、1人のリーダー Agent によって調整される、People と Agent の再利用可能なグループです。OpenAI 自身の数値から導かれる配置ルールは、Luna はトップではなくメンバーの中に置くべき、というものです。
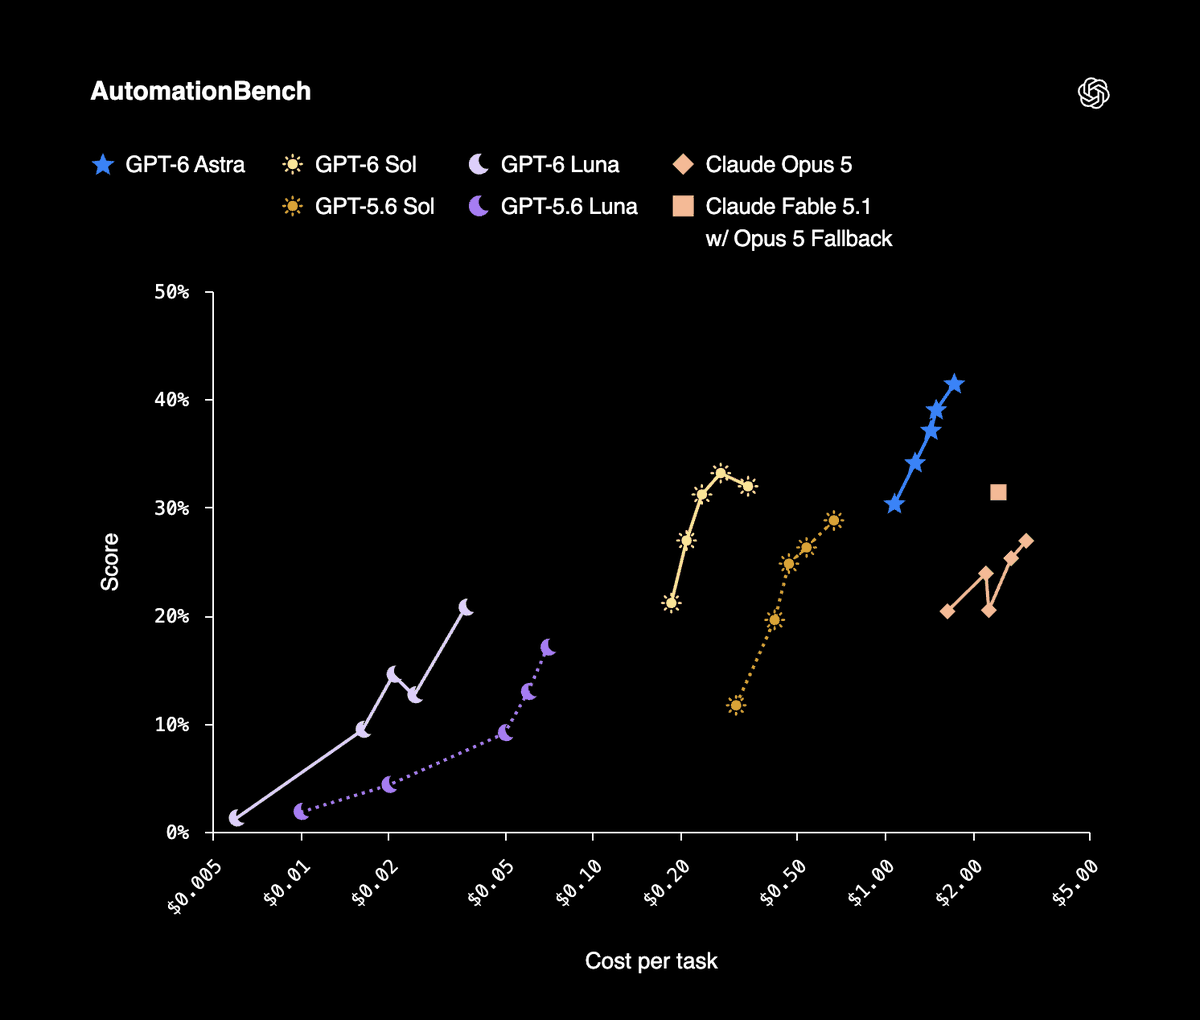
メンバーとしての根拠は強力です。DeepSWE 1.1 では、OpenAI によれば max effort の Luna が 66.6% を記録し、medium effort の Claude Opus 5 や Fable 5 に匹敵しつつ、タスクあたりのコストは Opus 5 より93%、Fable 5 より96%低いとされています。OSWorld 2.0 offline では、max の Luna が medium の GPT-5.6 Sol を10分の1のコストで上回ります。AutomationBench 1.0.6 では、high の Luna が前世代より5.4ポイント高いスコアを、タスクあたり58%低いコストで達成し、factuality では、より高い effort の Luna が GPT-5.6 Sol に約100分の1のコストで並びます。OpenAI はまた、Sol と Luna は GPT-5.6 のプロモーション価格より50%安いと述べていますが、この但し書きは OpenAI 自身によるもので、比較対象は定価ではなくプロモーション価格です。
リーダーとしての根拠は弱く、それはベンチマークのせいではありません。リーダーは目標を解釈し、メンバーが何をするかを決め、その結果を1つの Task にまとめ上げます。トップでの解釈ミスは、1回の失敗した実行ではなく、すべてのメンバーの実行が間違った方向に向けられることを意味します。リーダーのトークン代の節約など、それに比べれば誤差のようなものです。Crew リーダーガイドでは、価格表の反対側の端で同じ議論を展開しています。
| 作業 | レーン | 理由 |
|---|---|---|
| トリアージ、ラベリング、バックログの整理 | Luna | 量が多く、人間が数秒で判定を確認できる |
| テストの足場づくり、一次レビューのメモ | Luna(high effort) | 公開されている優位性は high または max でのもので、より低い設定ではない |
| 出荷されるコードへの変更 | GPT-6 Sol($2 / $10) | AutomationBench 33.2%、タスクあたり $0.27 |
| Crew にとって曖昧な目標の解釈 | GPT-6 Sol、または Astra($10 / $50) | リーダーのミスはすべてのメンバーに波及する |
これは習慣ではなくルールとして書き留めておきましょう。どのコーディングタスクにどのモデルを使うかで、このルーティングの問いを詳しく扱っています。
OpenAI のコスト差を読むうえでの注意点が1つあります。ローンチ記事は Claude Opus 5 をベンチマーク対象にしていますが、Anthropic は同じ日の数時間後に Opus 5 を Opus 5.5 に置き換えました。上記の Luna の比較は、名前を挙げているモデルの前世代に対して測定されたものです。
安価な Runtime でも安くならないもの
Luna は変更を生み出す価格を下げますが、変更を受け入れる価格には何の影響も与えません。安価な実行を10回行えば、10個の diff、10組のテスト出力、そして人間にしか下せない10個の判断が生まれます。OpenAI 自身の支出データは安心材料ではなく警告です。同社は、コーディングエージェントに1日あたり中央値で $600 以上、90パーセンタイルでは $7,000 を費やしている研究者がいると報告しています。タスクあたりが安いことが、こうした請求額を積み上げていくのです。
では、正直なところをお伝えします。安価な Runtime は、引き受ける作業が人間にとって素早く検証できるものである場合にバインドする価値があります。逆に、レビュー担当者の前の行列を増やすだけなら、それは見せかけの節約です。コンテキスト、進捗、ブロッカー、結果、そして人間によるレビューを、依頼からリリースまで見える状態に保ち、レーンの判断はレビュー時ではなく割り当て時に行いましょう。人間によるレビューこそがボトルネックでは、そのスケジューリング面を扱っています。
すでに複数のコーディングエージェントを動かしているなら、Computer を1台接続し、安価なレーンに Agent を1つ作成し、退屈な作業を割り当ててみてください。


