
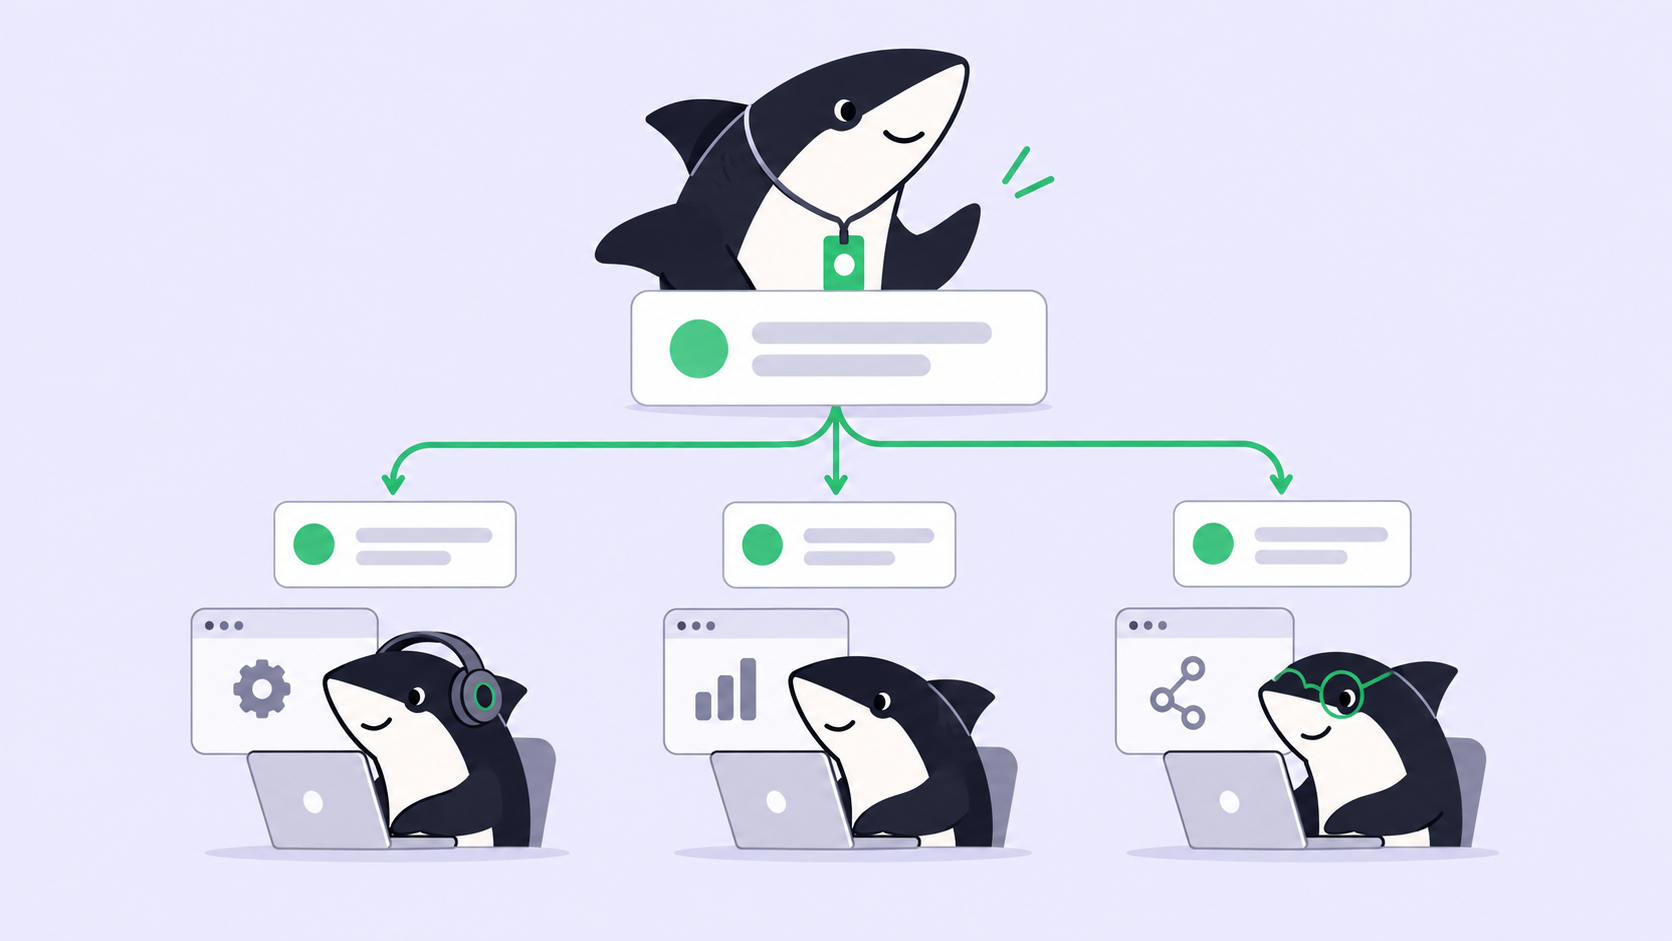
Crewリーダーはほとんどコードを書きません。タスクを読み、誰が動くべきかを判断し、必要なメンバーにメンションし、待ち、返ってきた内容を読み、それを統合するか差し戻すかします。GPT-6 Astraでは、入力100万トークンあたり$10、出力100万トークンあたり$50で、最もコードを書かないエージェントがCrew内で最も高い単価を担っていました。
OpenAIは2026-09-22にGPT-6 Solを投入しました。入力$2、出力$10、API idはgpt-6-solで、Astraの単価の両側とも5分の1です。だからといって、Solが利用可能な中で最も賢いモデルというわけではありません。そうではなく、調整役の席を、運用するあらゆるCrewに配置できるほど安くしたのです。
Astraを支持する論拠はCrewリーダーとしてのGPT-6 Astraで展開しました。チームで最も優れた判断力を持つ者に意思決定の席を与えれば、メンバーは平凡でよいというものです。その論は今も有効です。変わったのは、それを実行に移す際のコストです。変わらなかったのは、人が承認するのを待っている完成済みタスクの行列です。
TL;DR
Crewとは、1人のリーダーエージェントによって調整される、再利用可能な人とエージェントのグループであり、実行はリーダー優先です。メンバーが動き出す前に、リーダーがタスクのコンテキストとCrewの指示を読みます。この席は入力が重く、タスクごとに1回よりも多く実行されるため、その請求額は書き込みではなく読み込みに比例します。Solは$2 / $10、キャッシュされた入力の読み込みで90%割引により、すべてのCrewにリーダーを置くことが手頃になります。要件自体が曖昧な場合は、AstraやClaude Opus 5.5を席に残してください。エージェントは調査し、実行し、テストし、報告します。人は方向性を定め、権限を付与し、結果を承認します。
リーダーの席が実際に費やすもの
Sharklyのドキュメントでは、Crewの実行を固定された順序として説明しています。タスクが実行可能なステータスにあり、リーダーの準備ができていれば、リーダーエージェントが最初に起動します。リーダーはタスクのコンテキストとCrewの指示を読み、その後、自ら作業を処理するか、特定の貢献のために適格なエージェントメンバーにメンションします。メンバーの結果はタスクに戻り、リーダーが返ってきたものを統合します。
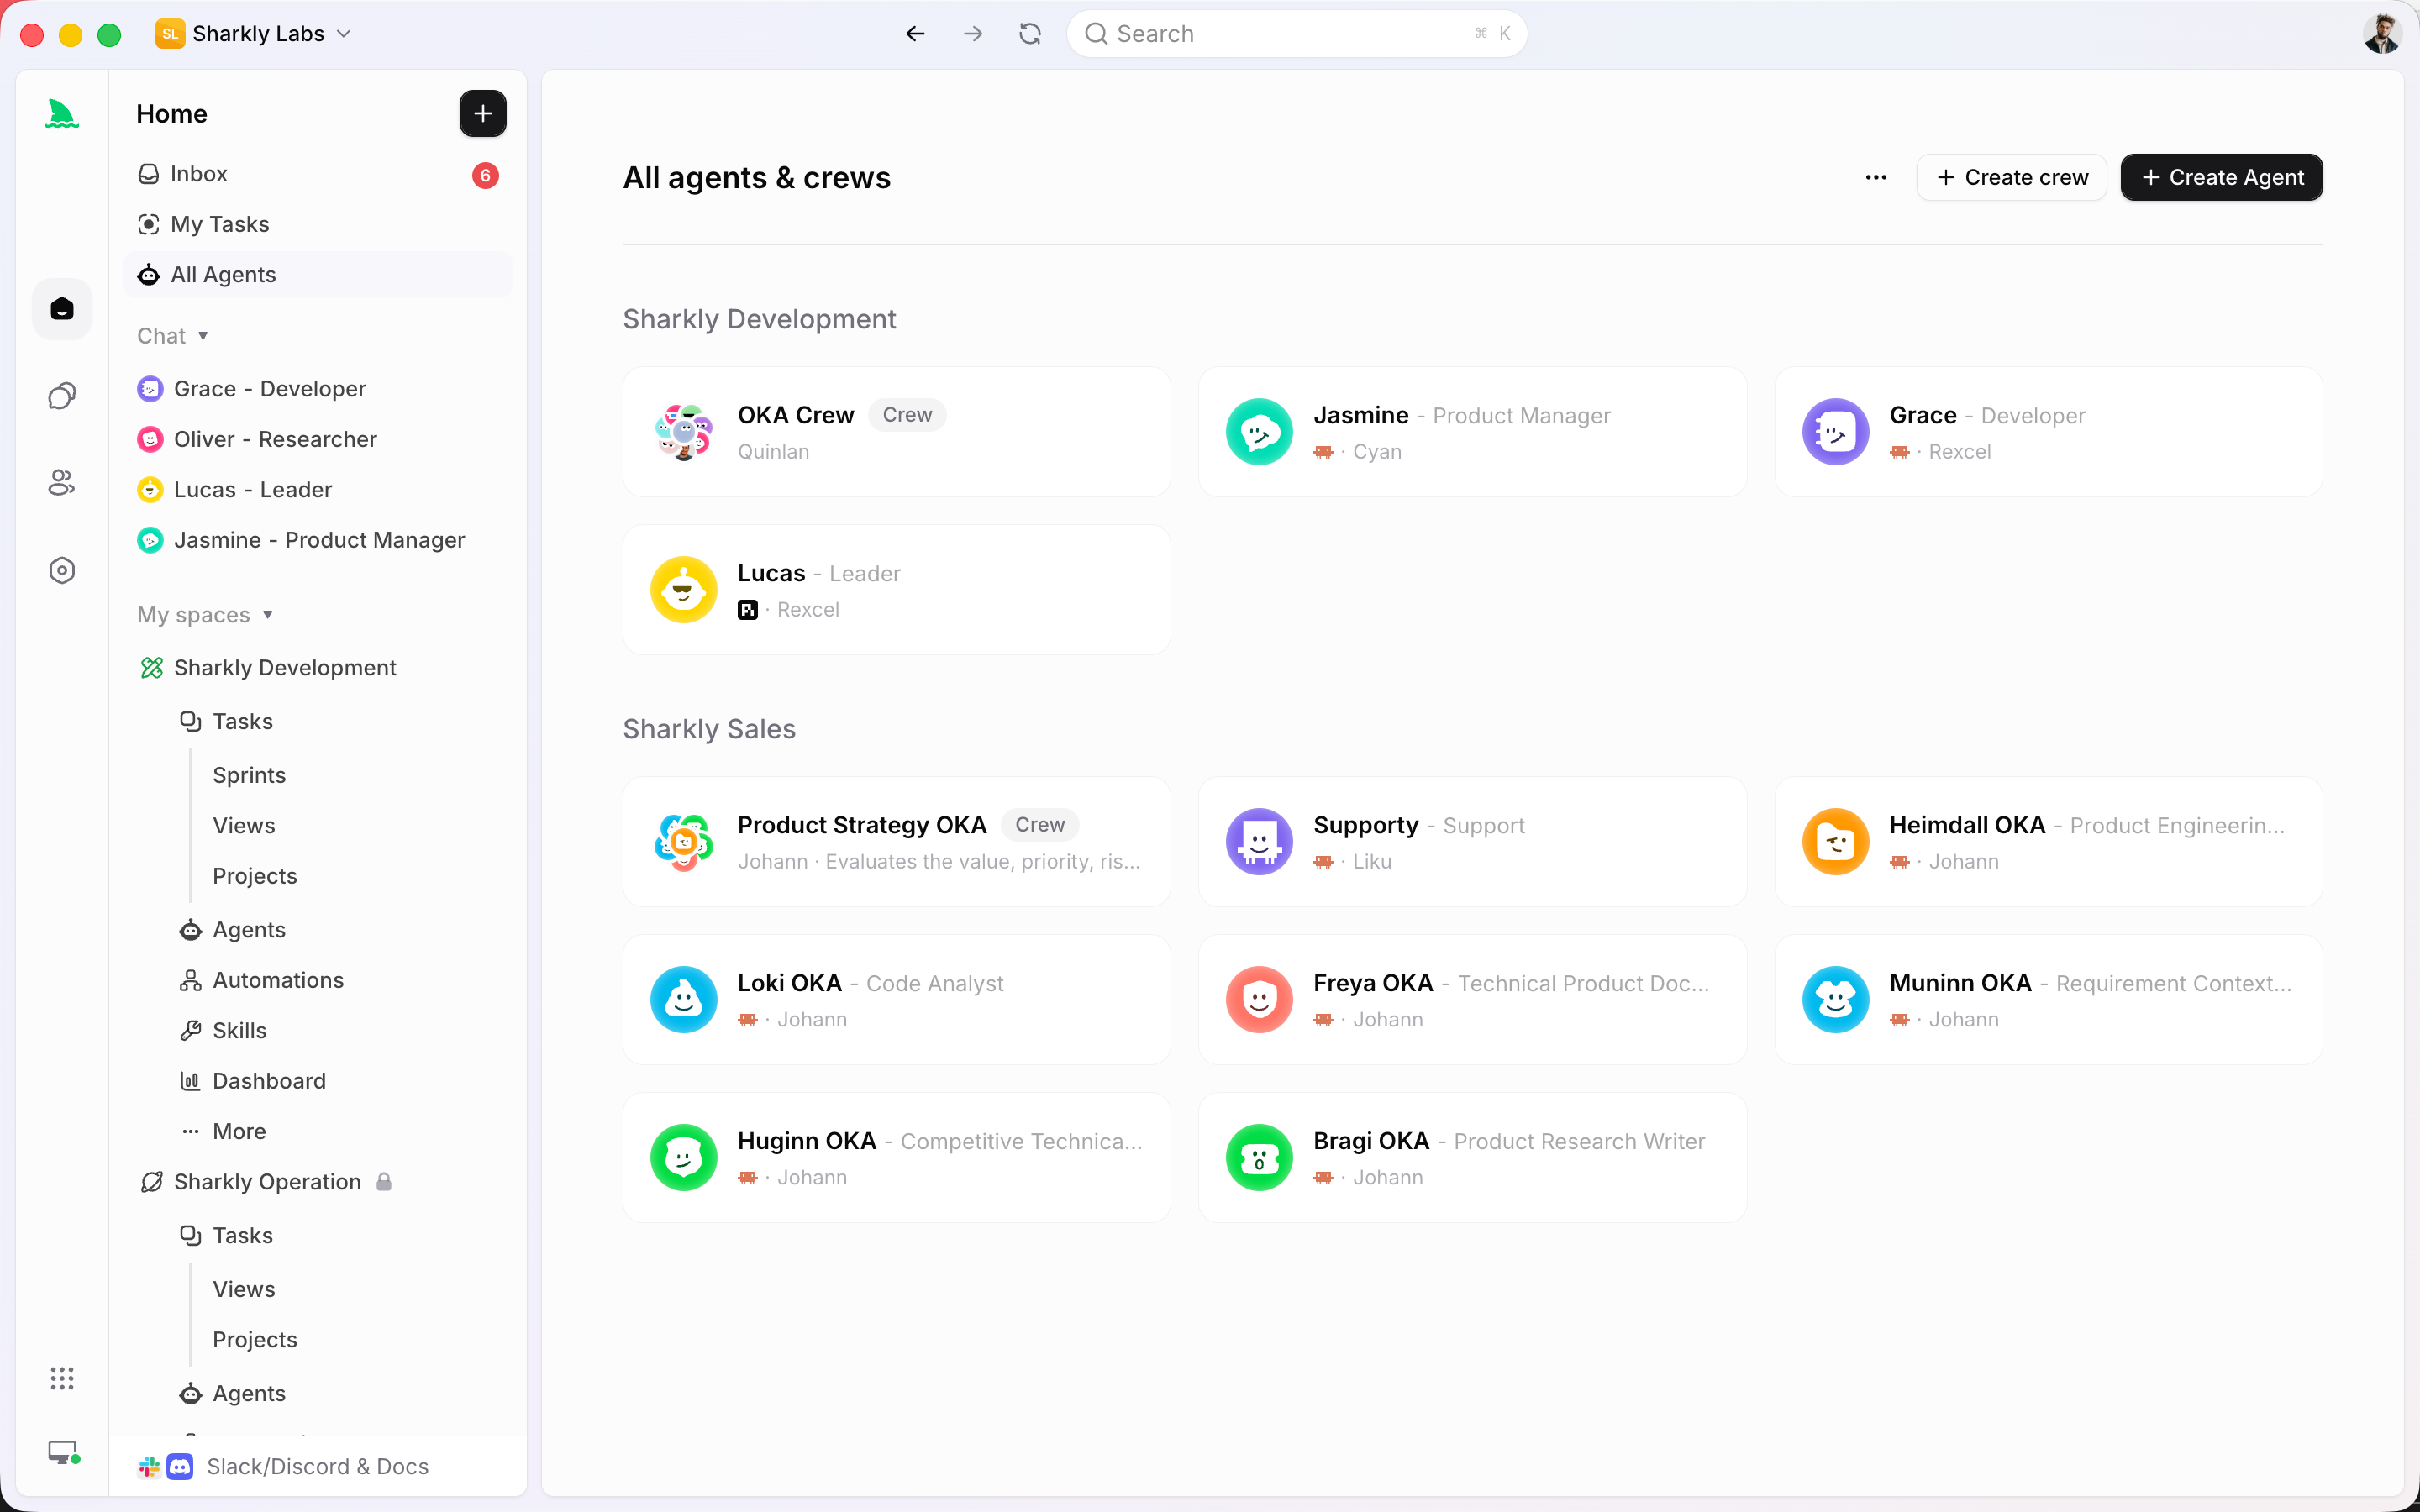
これを請求の形として捉えてください。リーダーの各ターンは読み込みから始まります。説明、前回以降のコメント、Crewの指示、利用可能なロール、そしてメンバーがすでに投稿したものすべてです。そして短い決定かメンションを書いて終わります。入力が重く、出力が軽く、それが繰り返されます。
しかもこの席は、多くのチームが予想するより忙しいのです。リーダーはタスクごとに1回だけ実行されるわけではないからです。Crewに割り当てられたタスクでは、メンバーからの適格な通常のコメントがCrewリーダーを起動させることがあり、これは他の実行と同じ可用性要件のもとで行われます。活発な議論が交わされているタスクは、リーダーがそのスレッドを何度も読んだタスクなのです。
| リーダーの席の候補 | API id | 1Mあたりの入力 / 出力 | キャッシュ入力 |
|---|---|---|---|
| GPT-6 Astra | 記載なし | $10 / $50 | 記載なし |
| Claude Opus 5.5 | claude-opus-5-5 |
$4 / $20 | 読み込み$0.20、書き込み$5 |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | 読み込み90%オフ |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | 読み込み90%オフ |
これらはベンダーのAPI料金であり、請求書のためというより比率を示すためにここに記載しています。モデルの利用は、コーディングツールに設定されたサブスクリプションやAPIキーを通じて継続されるため、チームが支払う金額は接続するプランによって決まります。
トークンあたりのコストではなく、タスクあたりのコスト
要件を読み間違えるリーダーは、メンバーの1日分の実行を無駄にします。したがって、料金表はこれを判断するのに適した場所ではありません。OpenAIはスコアとともにタスクあたりのコストを公開しており、こちらのほうが本当の問いに近いです。
| AutomationBench 1.0.6(OpenAI公開値) | スコア | タスクあたりのコスト |
|---|---|---|
| GPT-6 Sol、extra-high effort | 33.2% | $0.27 |
| GPT-6 Astra、low effort | 30.3% | Solの3.9倍 |
| Claude Opus 5、max effort | 26.9% | Solの11.1倍 |
Agents’ Last Exam V1では、max effortのSolが56.4%を記録し、Opus 5の最高結果を上回り、タスクあたりのコストは60%低くなっています。
その表を根拠に何かにお金を使う前に、正直に3つの注意点を挙げます。これらはエージェント全体のベンチマーク実行であり、リーダーの実行ではありません。調整コストの数値を公開している人はおらず、リーダーの実際の請求額はタスクのやり取りがどれだけ多いかによって変わります。Astraの行はlow reasoning effortでの結果であり、これはOpenAI自身が選んだ比較ポイントであって、Astraが全力を出したものではありません。またOpenAIは、Astraが「引き続きあらゆる面で当社最高のモデルである」と明言しています。一方、第三者機関のArtificial Analysisは、Solのインテリジェンス指数を48、Claude Opus 5.5を58としています。Solは、その席に置ける最も強力なモデルではありません。すべてのCrewでその席に座らせ続けられる最も強力なモデルなのです。
キャッシュは特にリーダーの席の割引になる
GPT-6はデフォルトでキャッシュヒット率を高め、キャッシュされた入力の読み込みを90%割引します。メンバーよりもリーダーにとって重要な変更が2つあります。reasoning effortや利用可能なツールのセットを変更してもキャッシュが無効化されなくなり、明示的なブレークポイントでキャッシュされたプレフィックスの終わりを選べるようになりました。OpenAIは、GitHubが数十億件のリクエストを通じて、新たな処理を必要とするプロンプトトークンが50%以上減少したと述べています。
Crew内でコンテキストを再送する最大の原因はリーダーです。リーダーは毎ターン、同じCrewの指示、同じリポジトリの規約、そして成長し続けるタスクスレッドを読み込み、そのプレフィックスはほぼ毎回同一です。これはまさに、キャッシュされたプレフィックスが想定する形です。設定はエージェント上ではなく、Computer上のRuntimeにあります。SharklyでGPT-6 Solエージェントを実行する方法で、どこに設定するかを説明しています。
AstraやOpus 5.5が席を維持すべきとき
Crewが1日に多くの範囲の明確なタスクを処理し、ロールが安定しており、判断のほとんどを実行ごとに導き直すのではなくCrewの指示に書き下せる場合は、Solをリーダーとして使ってください。要件自体が曖昧な場合、誤った解釈が3人のメンバーを間違った道へ送り込む場合、またはタスクが多くの短い作業ではなく1つの長い作業である場合は、より高価なモデルを席に残してください。
リーダーが安くなったからといって、単一のエージェントでできる作業にCrewを投入する理由にはなりません。ドキュメントはこの点をはっきり述べています。小さく明確に定義された作業には、タスクを1つのエージェントに直接割り当ててください。リーダーが目標を解釈し、他のエージェントメンバーを巻き込み、その結果を1つのタスクにまとめる必要がある場合にCrewを使います。1ファイルの修正をCrew経由で行うと、必要のなかった調整の実行に対して、どんな料金であれコストを払うことになります。
リーダーのモデルを変えても、オーナーシップは何も変わりません。オーナーがCrewを管理し、リーダーが実行を調整します。
判断を書き下すことが、より安い席を実用的にするのです。
You lead this Crew. Read the Task and the comments added since your
last turn, then pick the smallest set of members that can finish it.
Mention @backend for API and job changes, @tests for coverage,
@docs for user-facing pages.
Ask a person only when two readings of the requirement would produce
different designs. Otherwise state your assumption and proceed.
Combine member results into one summary: what changed, what you ran,
what failed, what you did not cover. Leave acceptance to a person.
長時間のリーダーターンを信頼する前に、運用上の注意点を1つ。Artificial Analysisは、GPT-6 Solのmax reasoning版で最初のトークンまで102.15秒を計測しています。これはベンダーではなく第三者による、maximum-effort構成の数値です。[VERIFY] Crew全体がリーダーの最初のターンを待つため、考え中のリーダーとハングしたリーダーは、ステータスが示すまで同じに見えます。
動かなかった請求
OpenAIによると、中央値の研究者はコーディングエージェントに1日$600以上を費やし、90パーセンタイルは$7,000を費やしています。Solの料金では、Crewの実行を制限していたチームでも数倍多く実行できるようになりますが、そのすべてが、人が読まなければならない結果で終わります。
これこそ、値下げが改善ではなく悪化させる制約です。安くなった調整は、より多くの並行作業、より多くのdiff、より多くの週あたりの意思決定をもたらしますが、それに対するレビュー能力は人間の時間で測られ、2026-09-22に変わったわけではありません。エージェントは調査し、実行し、テストし、報告します。人は方向性を定め、権限を付与し、結果を承認します。自動化は、チームの判断が必要とされる場所で止まります。
だからこそ、リーダーの出力はその料金よりも重要なのです。スクロールバックで終わるリーダーの実行は、$0.27でも$3でも価値がありません。計画、メンバーの結果、チェック、失敗、そして未解決の問いを1つのタスクに返すリーダーの実行こそが、人が作業を再構築するのではなく数分で承認できるようにするものです。コンテキスト、進捗、ブロッカー、結果、そして人のレビューを、リクエストからリリースまで可視化し続ければ、安い席はバックログではなくスループットになります。
今週変えるべきこと
- リーダーが高価なCrewを1つ選び、そのComputer上のRuntimeを
gpt-6-solに向けます。 - リーダーに即興で判断させて対価を払っていた部分を、Crewの指示に文章で移します。
- 1回のスプリントを実行し、前回と2つの数値を比較します。完了したタスク数と、レビュー後に差し戻されたタスク数です。差し戻しが増えたなら、以前の席はあなたが思っていた以上に多くのことをしていたのです。
すでに複数のエージェントを運用しているなら、Sharklyはそれらのタスクと結果を管理する1つの場所を提供します。


