
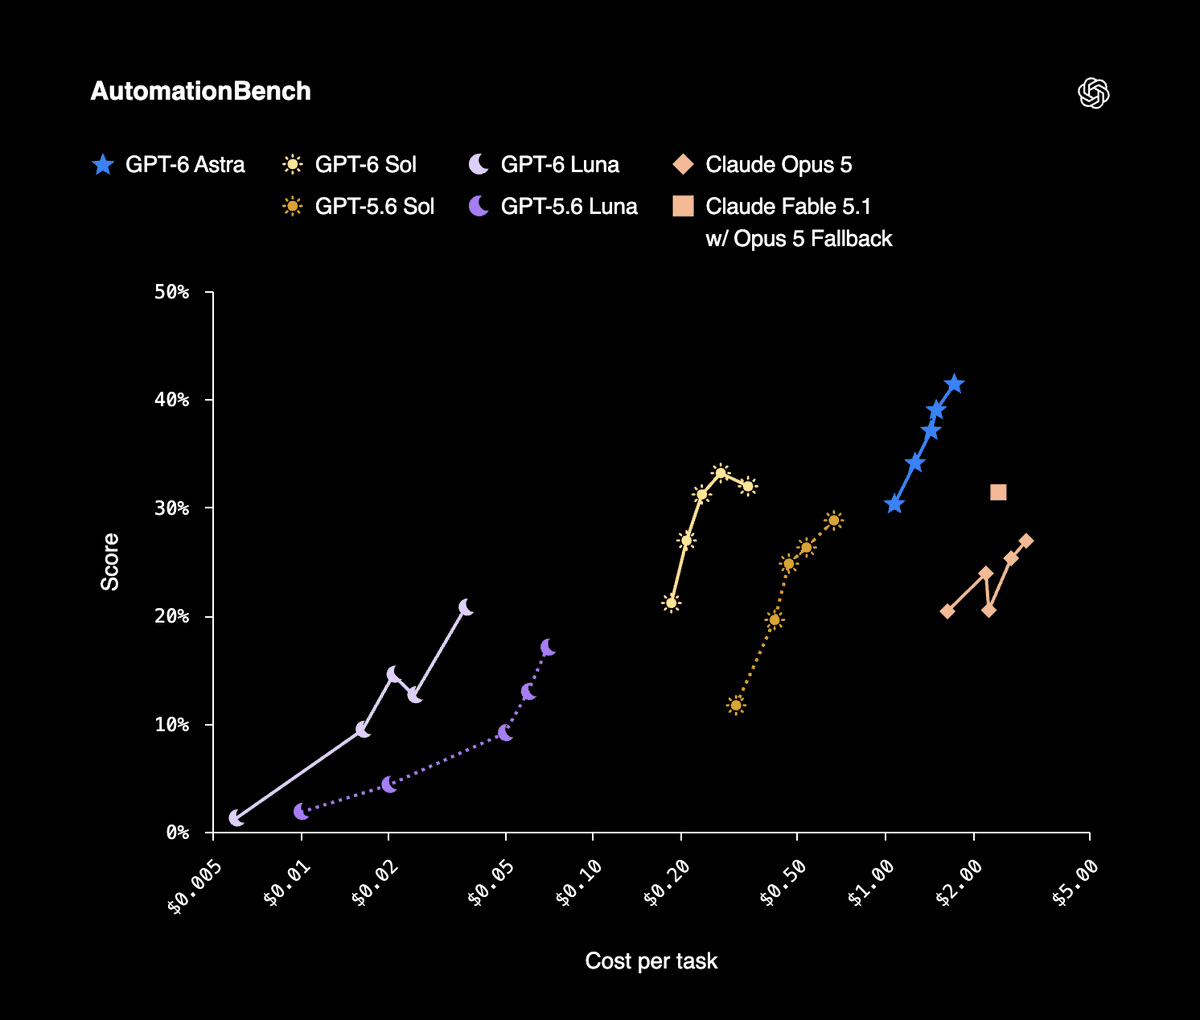
OpenAIは9月22日にGPT-6 Solをリリースしました。価格は入力100万トークンあたり2ドル、出力100万トークンあたり10ドルで、API IDはgpt-6-sol、コンテキストウィンドウは872kです。あなたのボードの景色を変えるはずの数字は、トークン単価ではありません。それは「完了したタスク1件あたりのコスト」です。OpenAIのAutomationBench 1.0.6の結果では、reasoning effortをxhighにしたSolがタスク1件あたり0.27ドルで33.2%を記録する一方、max effortのClaude Opus 5はタスク1件あたりのコストがSolの11.1倍で26.9%にとどまっています。
これはリーダーボードではなく、予算の話として読んでください。1回の実行が高くつくためにチームがエージェントの実行回数を絞ってきたなら、その制約はちょうど動きました。次に立ちはだかるのは、誰もお金では解決できない制約です。つまり、人がdiffを読み、その成果を承認しなければならないということです。このガイドでは、セットアップのうち最小限かつ実用的な道筋を示し、その後、値下げでは解決できない部分について正直に説明します。1台のComputerでCodexにSolを設定し、Agentを1つ作成し、実際のTaskを1つ割り当ててください。
TL;DR
接続済みのComputerでCodexにmodel = "gpt-6-sol"を設定し、Sharkly上でCodex RuntimeがAvailableと表示されることを確認し、Agentの作業ディレクトリはTemporaryモードのままにし、最初の長時間実行を信頼する前にTaskごとのタイムアウトを延ばし、Taskを1つ割り当てます。Sharklyはモデル名を表示しません。表示するのは、実行、ログ、質問、そしてTask上の結果です。Agentは調査し、実行し、テストし、報告します。人は方向性を定め、権限を与え、結果を承認します。
モデル設定はどこにあるのか
Sharklyはモデルを選びません。Agentsのドキュメントにはこう明記されています。「AgentはRuntimeのデフォルトモデルに従います。特定のモデル名を約束したり表示したりはしません。モデルの変更はRuntimeまたはComputerのツール設定で行い、Agent上では行いません。」
Agentにモデルのドロップダウンはなく、思考深度(thinking depth)のコントロールもありません。探しに行かないでください。役割は4つ、それぞれに1つの仕事があります。Agentは作業の進め方を定義します。Computerはホストとローカルリソースを提供します。Runtimeは実際のエージェントセッションを実行し、ここではCodexがRuntimeです。Taskはチーム共有の記録であり続けます。
ステップ1: Computer上のCodexにGPT-6 Solを設定する
実行を担うComputer上でCodexを更新し、Solへのアクセス権を持つアカウントまたはAPIキーでサインインします。OpenAIはSolをChatGPT Workと、Plus、Pro、Business、Enterprise、EduプランのCodexで利用可能にしており、まだChatでは使えません。そのホストの通常のターミナルでcodex -m gpt-6-solがセッションを開始できれば、Sharklyからも利用できます。
次に、このComputer上のすべての実行がそれを使うようデフォルトを設定します:
# ~/.codex/config.toml
model = "gpt-6-sol"
model_provider = "openai"
model_reasoning_effort = "xhigh"
このスニペットには2点の注意があります。reasoning-effortのキー名はCodexのバージョンによって異なるため、そのComputer上のCodexビルドのサンプル設定と照らし合わせて確認してください。そしてeffortレベルはコストの判断であり、最大のままにしておく品質のダイヤルではありません。OpenAI自身が公開した結果でもベンチマークごとに異なるeffortレベルが使われており、上記のタスク1件あたり0.27ドルという数字はxhighの行のものです。[VERIFY]
Sharklyに戻り、Computerの詳細を開いて再スキャンまたは接続テストを実行します。Codex RuntimeがAvailableと表示されるはずです。Computerがonlineと表示されるだけでは、そのローカルサービスがハートビートを送っているにすぎません。実行を開始できるかどうかを示すのは、Runtimeの機能ステータスです。
ステップ2: Crewを拡大する前にキャッシュを設定する
これは、複数のAgentが同じリポジトリで作業するようになると最も重要になるGPT-6の変更点であり、そしてほとんどのチームが飛ばしてしまうものです。
OpenAIによると、GPT-6ではデフォルトでキャッシュヒット率が高くなり、キャッシュされた入力の読み取りは90%割引、プロンプトキャッシュのダッシュボードと診断ツールが用意され、さらにエージェント作業にとって重要な点として、reasoning effortやツールの利用可否を変更してもキャッシュが無効化されなくなりました。明示的なブレークポイントを使えば、キャッシュされたプレフィックスがどこで終わるかを選べます。OpenAIは、GitHubが数十億件のリクエストにわたって、新たな処理を必要とするプロンプトトークンが50%以上減ったと述べています。
Crewにとっての実用的な形はこうです。同じリポジトリ上でのAgent実行は毎回、リポジトリの構成、ハウスルール、テストコマンド、規約といった、ほぼ同一の大きなプレフィックスを再送します。そのプレフィックスこそがキャッシュの目的であり、エージェント群が最初の1体よりも実行あたりのコストをはるかに安くできる理由でもあります。
これはタダの作業ではないので、判断は2つに分かれます。複数のAgentが1つのコードベースに対して繰り返し実行し、Skillと指示テキストが固まっているなら、安定したプレフィックスを固定し、明示的なブレークポイントを設定します。Agentが週に数回しか実行されない場合や、指示が毎週のように変わる場合は、手間をかける必要はありません。境界を維持するために、節約できる以上の時間を費やすことになるからです。
ステップ3: 起動が遅い実行を前提にAgentを設計する
Agentsを開き、New Agentを選び、ComputerとCodex Runtimeを選択してから、3つの項目を設定します。
Taskごとのタイムアウト。これは意識して設定してください。高いreasoningモードでのSolの実行は、忙しく動き出す前に死んでいるように見えることがあります。どちらのベンダーでもない第三者であるArtificial Analysisは、GPT-6 Solのmax reasoningバリアントで最初のトークンまで102.15秒かかると計測しました。これは、多くの人が何かがハングしたと判断するまでに待つ時間より長く、共有ボード上のステータスが防げてターミナルが防げない、まさにその失敗です。考えている実行とクラッシュした実行は、スクロールバックでは同じに見えます。ステータスが読むに値するために何を伝える必要があるかは、コーディングエージェントの可観測性を参照してください。
作業ディレクトリ。Temporaryモードです。各Taskは分離されたディレクトリを持ち、リポジトリを使う実行では新しいworktreeが用意されるため、同じリポジトリ上での2つのSol実行が互いを上書きすることはありません。Temporaryディレクトリのデフォルト同時実行数はComputerの上限の50%です。そのComputerが実際の実行をいくつかこなすまでは、そのままにしておいてください。同時実行数を上げると、CPU、メモリ、ディスク、プロバイダーの容量を一度に消費します。
指示。短く、安定したものにします:
Read the Task description and recent comments before editing.
Keep changes limited to the requested behavior.
Ask a question only when different interpretations would
materially change the result; otherwise proceed with a stated
assumption and record it in your report.
Run the closest relevant checks and report failures without hiding them.
Stop and ask before anything destructive or outside the repositories
attached to this Agent.
ステップ4: Taskを1つ割り当て、Crewがその価値に見合うか判断する
明確な受け入れ基準を持つTaskを選びます。Agentを担当者(Assignee)に指定し、TaskをBacklogから、カテゴリが作業可能なステータスへ移動します。Backlogで割り当てられたTaskは待機したままです。実行はqueued、dispatched、runningと進み、Executionsタブがログをストリーミングします。Agentが判断を必要とする場合、質問はコメントとしてTaskに戻り、Taskは「人の返信待ち」を表示し、それがあなたのInboxにルーティングされます。
範囲の限定された変更であれば、Agentは1つが正解で、可動部はゼロのままです。Crewは、1人のリーダーAgentによって調整される、PeopleとAgentsの再利用可能なグループです。リーダーがゴールを解釈し、複数メンバーの結果を1つのTaskにまとめ上げる必要があるときに、その存在価値が生まれます。
Solはその計算を変えます。リーダーは主に読み、計画し、割り当て、レビューするからです。そしてそれは、価格表の一番上では最も正当化しづらい仕事でした:
| Runtimeモデル | API ID | 入力 / 出力(100万あたり) | Crewでの役割 |
|---|---|---|---|
| GPT-6 Astra | 記載なし | $10 / $50 | 計画そのものが難しいときのリーダー |
| GPT-6 Sol | gpt-6-sol |
$2 / $10 | リーダー、および実際の変更を担うメンバー |
| GPT-6 Luna | gpt-6-luna |
$0.10 / $0.50 | 大量処理を担うメンバー: トリアージ、ラベリング、スキャフォールディング |
Astraについても同じセットアップをGPT-6 AstraをCrewリーダーとして動かすで書きました。そこでの論旨は今も有効で、その下にある価格だけが動きました。
値下げでは買えないもの
OpenAIはSolを、GPT-5.6のプロモーション価格より50%安いと説明しています。この但し書きはOpenAI自身によるもので、重要です。比較の基準が定価ではなくプロモーション価格だからです。同じページに書くべき注意点があと2つあります。OpenAIのローンチ時のベンチマークはClaude Opus 5と比較していますが、Anthropicは同じ日の数時間後にそれをOpus 5.5へ置き換えました。したがって、これらの差は前世代と比較したものとして読んでください。そしてeffortレベルが効いてきます。Solがmax effortでDeepSWE 1.1で68.8%、Agents’ Last Exam V1で56.4%に達するのは、日常的なタスクでつけっぱなしにする設定ではありません。
次に、モデルとはまったく関係のない部分です。OpenAIによると、同社の中央値の研究者はコーディングエージェントに1日600ドル以上を費やしており、90パーセンタイルでは7,000ドルを超えます。タスクあたりが安くなることは、そのような請求額が積み上がる仕組みであり、避けられる仕組みではありません。どの実行も、人が読み、疑問を投げかけ、承認しなければならない変更を生み出し、そのキューが今週11倍安くなったわけではありません。モデルの選択ではなくレビュー能力を軸に計画し、ルーティングは好みではなくルールとして書き下し、割り当て、進捗、ブロッカー、結果、人によるレビューを、要望からリリースまで1か所に保ちましょう。
すでに複数のコーディングエージェントを動かしているなら、Computerを1つ接続し、Agentを1つ作成し、退屈な作業を割り当ててみてください。


