
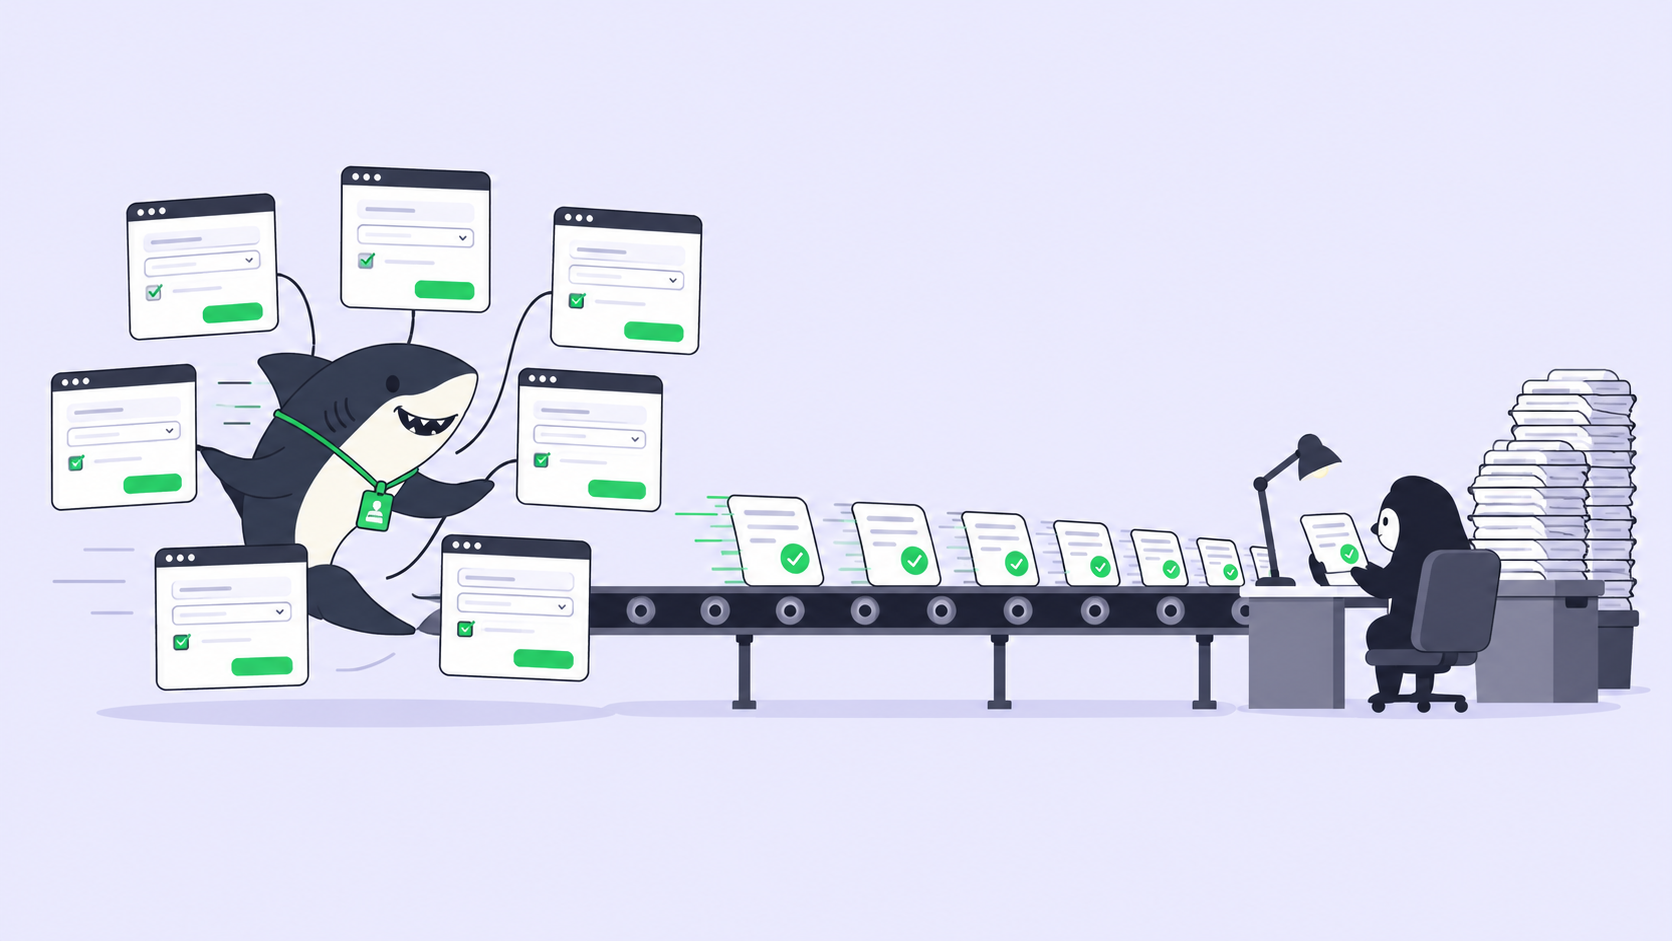
Anthropicは10月7日にClaude Haiku 5.5をリリースし、ブラウザ作業向けモデルとして前面に打ち出しました。公開告知の記事では、「リアルタイムのカスタマーサポートやブラウザ操作など、処理速度が重視されるタスク」に最適と位置づけられており、製品ページにはフォーム入力、データ入力、アプリ間の情報移動などが用途として挙げられています。また同リリースにより、AnthropicのPythonおよびTypeScript SDKにComputer UseとBrowser Useがベータ版として追加されました。Anthropicが公表したComputer Useのベンチマーク「OSWorld 2.1」において、Haiku 5.5は最大エフォート(max effort)時に1試行あたり約0.61ドルで72.4%、デフォルトのミディアムエフォート(medium effort)時には約0.13ドルで53.3%のスコアを記録しています。
しかし、大きく報じられているこの数値は部分点(partial-credit)によるスコアです。システムカードを確認すると、同じテストにおける厳格な合格率(strict pass rate)は37.1%にとどまっています。つまり、Haiku 5.5をブラウザ自動化レーンに組み込んだチームが得られるのは、わずか数セントで実行できる一方で、往々にして作業が中途半端に終わった結果です。実行コストは大幅に下がりましたが、レビューにかかるコストは下がっていません。複数のエージェントを運用しているチームにとっては、ブラウザ自動化の実質的なコストが「結果を確認する担当者」へと転嫁されることになります。
要点まとめ(TL;DR)
AnthropicによるOSWorld 2.1のオフラインサブセットにおいて、Haiku 5.5の部分点平均は72.4%であるものの、試行を完全にパスできたのは37.1%にすぎません。Sonnet 5.5やOpus 5.5も、より高価格でありながら同様に34〜35ポイントのギャップを抱えています。そのため、確認が完了するまでは、すべてのブラウザ実行を「中途半端な状態」として扱う必要があります。Taskに厳格な受け入れ確認条件を明記し、送信(submit)アクションの直前でAgentを停止させ、「完了事項」「未完了事項」「証拠」を報告させ、人間がAgentを@メンションするコメントによって最終ステップの実行を許可するようにしましょう。実行自体は安価なため、エフォートを高めに設定してレビュー時間を削減すべきです。エージェントは調査、実行、テスト、報告を行い、人間は方針決定、権限付与、結果の承認を担います。
「部分点」は「完了」ではない
AnthropicはOSWorld 2.1の108タスク中82タスクを対象に、1080p解像度、最大500ステップ/試行、最大エフォートの設定で5回の試行平均を測定しました。モデルごとに2つの数値が公表されていますが、レビュアーが現場で直面するのは後者の数値です。
| モデル(最大エフォート) | 部分点(Partial credit) | 完全合格(Strict pass) | 差分 | 試行あたりのコスト | 完全合格あたりのコスト(当社試算) |
|---|---|---|---|---|---|
| Haiku 5.5 | 72.4% | 37.1% | 35.3ポイント | $0.61 | 約1.65ドル |
| Sonnet 5.5 | 83.9% | 48.8% | 35.1ポイント | $5.73 | 約11.75ドル |
| Opus 5.5 | 87.2% | 53.2% | 34.0ポイント | 未掲載 | 未掲載 |
第一に、このギャップはHaiku特有の問題ではありません。同シリーズのどのモデルでも、「大半のステップが実行された」状態と「タスクが完全に完了した」状態との間には約35ポイントの開きがあり、最上位のOpus 5.5ですら完全合格は約半数にとどまります。このベンチマークが示す通り、Computer Useによる試行の大部分は「中途半端な完了」で終わってしまいます。第二に、Haiku 5.5の登場によって、中途半端な作業が極めて低コストで生成されるようになった点です。完全合格1回あたりのコストはSonnet 5.5の約7分の1、試行1回あたりでは約9分の1に抑えられます。
ブラウザ作業において、この「中途半端な完了」こそが最も危険な状態です。完全に失敗した実行であれば、システムに何も残りません。しかし、40件中31件のレコードをCRMに移行した実行や、税金入力欄の直前まで埋められたベンダーの登録フォームなどは、一見すると完了しているかのような状態を外部アプリケーションに残してしまいます。レビュー担当者は不足している9件のレコードを自力で探し出さなければならず、画面上のどこにもその手掛かりは表示されません。
実行コストが数セントになったとき、費用はどこへ向かうのか
ブラウザレーンの実行コストが安くなると、注視すべき予算項目が変わります。1回の試行が0.13ドルであれば、フォーム入力の実行を100回行っても、モデル利用料の請求書上では誤差のような金額です。しかし、入力内容を確認するために毎回人間の目が必要な場合、その100回の実行の確認作業は担当者の丸1日分の労力を奪いかねません。Haiku 5.5は10万トークン以下のプロンプトにおいてHaiku 4.5より90%安くなっていますが、人間のレビュアーの費用は90%安くはならないのです。
また、料金体系にも注意すべき点があります。Haiku 5.5は、10万トークン以下のプロンプトでは入力100万トークンあたり0.10ドル、出力100万トークンあたり0.50ドルですが、10万トークンを超えるとそれぞれ0.50ドル、2.50ドルに跳ね上がります。ブラウザセッションが長期化するとプロンプトがこの閾値を超え、それ以降のリクエストには割高なレートが適用されます。これもまた、ブラウザTaskを短く保つべき理由のひとつです。「1つのフォーム、1つのレコードバッチにつき、1つのTask」にとどめるのが賢明です。
過去の記事『人間のレビューこそがボトルネックである』や『人間の稼働日あたりのエージェント稼働日数』でもこの点を指摘してきました。Haiku 5.5が変えたのはその比率です。1回の実行が0.13ドルとなると実行費用はほとんど意識されなくなりますが、レビュー待ちのキューを考慮すると『安価なモデルの方が結果的に高くつく』という状況が生じ得ます。残された唯一の打開策は、確認作業そのものを高速化することです。
Computer Useエージェントのレビュー:Taskに何を含めるべきか
ブラウザエージェントのTaskが「レビュー可能」であるとは、内容を確認する時間が最初からやり直す時間よりも短い状態を指します。これには、Agentが実行後に後付けで作成できない3つの要素が不可欠です。すなわち、実行前に定義された厳格な受け入れ確認条件、完了事項と未完了事項を明確に分けたレポート、そしてセッションを再生しなくても人間が直接確認できる証拠です。
Sharklyでは、Taskがすでにチーム共通の共有レコードとして機能しています。Taskには説明、コメント、添付ファイル、アクティビティが保持され、Agentからチームへの報告テキストは実行に紐づくコメントとして保存され、実行ログにはツール呼び出しやRuntimeイベントが記録されます。したがって、レビューの設計は2つの要素で成り立ちます。Taskの説明で「何をもって完了とするか」を定義し、Agentへの指示で「レポートに何を含めるべきか」を指定することです。ブラウザ入力エージェントに対する指示のベースとなるテンプレートは以下のとおりです。
Restate the acceptance check from the Task description before you start.
Work up to, but not including, any submit, send, publish, pay, or delete action.
Then stop and report, in this order:
  Done: every record or field you completed, by its identifier.
  Not done: everything you skipped or could not complete, and why.
  Check: the acceptance check, and whether your own count meets it.
  Evidence: the paths of the screenshots you saved in the task directory.
Leave the Task waiting for human review. Do not take the final action
until a person @ mentions you in a comment on this Task to release it.
受け入れ確認条件は、「スプレッドシートをインポートすること」のような曖昧な表現ではなく、「CRMに40行が登録され、それぞれに一致するメールアドレスが存在すること」といった数値化・計数可能な形で記述してください。「未完了(Not done)」リストは、部分点評価では覆い隠されてしまう部分を可視化します。スキップされた項目を明記することで、単なる「72%の出来の実行」を「残りの作業が把握できている72%の実行」へと変えることができます。レポート形式の詳細については、ガイド記事『タスクレベルのエビデンスを用いてエージェントの作業をレビューする方法』を参照してください。
SharklyのAgentに関するドキュメントによると、AgentはRuntimeのデフォルトモデルに従います。変更する場合は、AgentまたはRuntimeのCustom arguments(Claude Codeの場合はclaude-haiku-5-5)でモデルを指定します。モデル選択用のドロップダウンメニューはありません。セットアップ手順は『SharklyでClaude Haiku 5.5エージェントを実行する方法』に記載されています。
送信(Submit)の直前で停止させる
下書きの段階であれば部分的な完成でも許容されますが、送信済みのフォームでは許されません。モデルが正しく処理してくれることを期待するのではなく、取り消しのつかないステップを実行フローから切り離しましょう。
このパターンは、Sharklyが既に備えている仕組みを活用しています。Agentは最後のアクションの手前まで作業を進めた後、Taskを「人間のレビュー待ち」状態にし、これがレビュアーの受信トレイ(Inbox)に表示されます。レビュアーはレポートとスクリーンショットを確認し、修正または却下を判断した上で、Task上のコメントでAgentを@メンションして最終処理を許可します。通常のコメントではAgentは起動しません。メンションされることでTask上での対話が開始または継続され、Agentの返答はその実行に紐づく新たなコメントとして記録されます。送信処理は、人間が承認を出した後に、同一のTaskかつ同一の記録のもとで実行されます。停止ポイントを配置すべきその他の箇所については、『コーディングエージェントのための承認ゲート:危険な操作の前にエージェントを止めるべき場所』で解説しています。
この承認ゲートは、ブラウザ操作特有のもうひとつのリスクを抑え込む役目も果たします。ブラウザエージェントは、自身が作成したのではないページを読み取ります。Anthropicのシステムカードによると、Haiku 5.5は以前のどのHaikuよりもプロンプトインジェクションに対する耐性が向上しており、Computer Use環境下での適応型攻撃者に対しても同社の最先端モデルに匹敵する性能を示しています。しかし、これはあくまでベンチマーク上の結果であり、各社の利用するベンダーポータルでの安全性を保証するものではありません。人間のコメントなしでは送信ボタンにアクセスできない仕組みにしておけば、仮に指示がインジェクションされたとしても、被害を最小限に抑えることができます。ホスト側の境界設計(専用Computer、暗号化環境変数を介してAgentごとに紐づけられた認証情報、1回につき1つのブラウザ実行のみを許可)は、『Computer Useガードレールガイド』で解説しているものと同様であり、その他の詳細については『プロンプトインジェクションとエージェントガードレール』で網羅しています。
この運用レーンにおける判断基準はシンプルです。実行結果を件数やリストと照合して1分未満で確認でき、かつ最終アクションが取り消し可能であるか、あるいはコメントによるゲートで保護されている場合は、Haiku 5.5のブラウザAgentを採用してください。一方で、確認作業が最初からのやり直しと同義になるようなケースでは、人間が直接行うか、同様のゲートを設けた大規模モデルに任せるべきです。そのような場面では、37%の完全合格率など二度手間を生むだけで何の意味も持たないからです。
エフォートにコストをかけ、レビューの手間を削減する
Haiku 5.5は、Haikuシリーズとして初めてエフォート(努力量)設定に対応したモデルであり、デフォルトは「medium」に設定されています。OSWorldでは、わずかなコストの追加で部分点スコアが大幅に向上することが示されています。
| エフォート(Effort) | 部分点(Partial credit) | 試行あたりのコスト |
|---|---|---|
| Low | 42.0% | $0.07 |
| Medium(デフォルト) | 53.3% | $0.13 |
| High | 61.3% | $0.18 |
| Xhigh | 67.6% | $0.28 |
| Max | 72.4% | $0.61 |
設定をmediumからmaxに引き上げると、試行1回あたりのコストは約0.49ドル増加し、部分点スコアは19ポイント向上します。このスコアの上昇によってレビュー時間がわずかでも短縮されるのであれば、人間が確認を行うあらゆるブラウザTaskにおいて、maxを選択する方が実質的には安上がりになります。システムカードではエフォート別の完全合格率がグラフで示されているものの、具体的な数値が明記されているのはmaxのみです。そのため、低いレベルを選択する前に、自身のTaskで厳格な合格率を測定することをお勧めします。エフォートの設定はComputer上のClaude Codeで行います。Agent側にはモデル選択機能や思考の深さ(thinking-depth)の制御項目は用意されていません。『退屈な8割の作業をLunaで自動化する』で論じたように、誰も出力を確認しないような処理であれば格安レーンを安価に運用すればよいですが、ブラウザレーンはそうはいきません。
他社のシステムへの書き込みを伴うブラウザ作業は、誰かが承認を行う必要があるため、大規模な実行フローの一部に組み込むのではなく、独立したTaskとして切り出すべきです。この一般的なルールについては、『Haiku 5.5:サブエージェントとして使うか、単独のエージェントとして使うか』で解説しています。
ブラウザエージェントが安価になるほど実行回数は増え、実行回数が増えるほど、誰かの確認を待つ「中途半端に完了した結果」が積み上がっていきます。複数のエージェントをすでに運用しているなら、Sharklyを使えば、そのすべてのタスクと結果を一元的に管理できます。


