
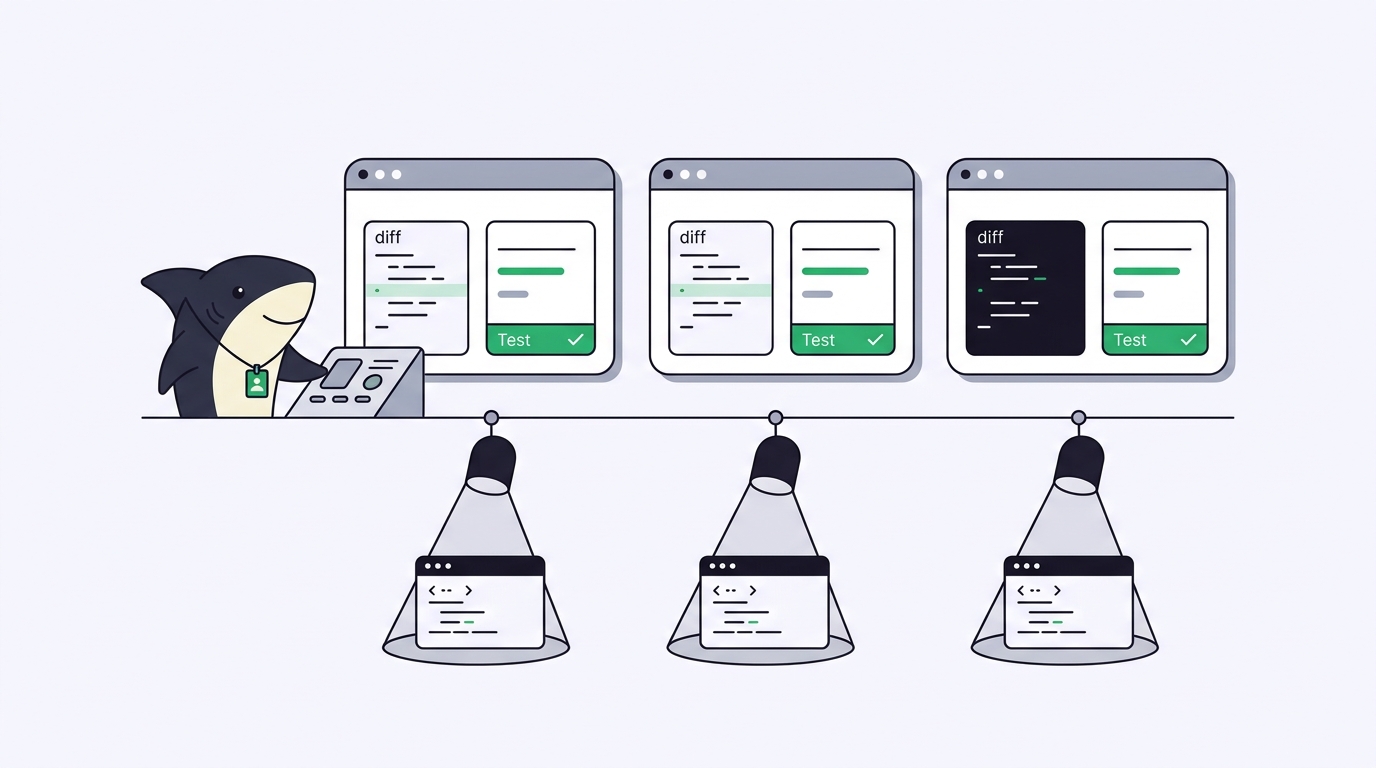
実際の仕事をどのコーディングエージェントに任せるか——Claude Code、Codex、Gemini CLI、OpenCode、あるいはそのうち2つを同時に——を決めようとしている。そこでベンチマークのスコアを読む。あるエージェントは公開タスクセットの68%を解決し、別のエージェントは71%。その数字から選べというわけだ。ところが、そのエージェントを自分のリポジトリに入れた途端、公開データセットが一度も見たことのないビルド手順でつまずく。
ベンチマークが測るのは、固定された共通の問題セットだ。あなたのコードベースは、あなただけの問題セットである。あなたの規約、あなたのモノレポ構成、誰もが無視しているあの不安定なテスト、たった1人しか理解していないデプロイスクリプト。あなたの1週間を決めるスコアは、そのコード上で自分が生成したスコアであって、ラボが公開したスコアではない。本ガイドでは、実際にリリースするソフトウェアでコーディングエージェントを比較する方法と、エージェント同士を隔離するために5つのターミナルを開くことなくその比較を実行する方法を解説する。
Sharkly は、その手法が行き着く先だ。Sharkly はオールインワンの Agent コマンド&マネジメントプラットフォームである。自分の Computer を接続し、同じ Task を複数の Agent に割り当てると、各実行の diff、テスト出力、レビューが1か所に返ってくる。これが公平な比較を可能にする。測りたい変数はエージェントであって、3つの実行が互いに干渉しないようにターミナルをやりくりする手間ではない。
ベンチマークスコアが測っているのはデータセットであり、あなたのリポジトリではない
コーディングエージェントのベンチマークとは、固定された公開テストセットであり、誰に対しても同じ方法で採点される。だからこそモデルを開発するラボにとっては有用であり、だからこそあなたにとっては弱い予測指標になる。
SWE-bench のような公開ベンチマークは、よく知られたオープンソースプロジェクトからタスクを集め、調整済みのハーネスと厳選された受け入れチェックを備えている。そのどれも、あなたの火曜日を表してはいない。あるエージェントがあなたのコードでどう振る舞うかを決める要素は、公開データセットが決して含み得ないものだ。モデルが一度も読んだことのない社内ライブラリ、あなたの lint 設定、サービスが実際にどう起動するかを説明する400行のコンテキストファイル、テストが1つもないあのモジュール。
高いベンチマークスコアは、エージェントがあなたのリポジトリでどう振る舞うかを予測しない。予測するのは、他人のリポジトリでの振る舞いだ。リーダーボードは、どのエージェントをテストする価値があるかの大まかなフィルターとして扱い、本当に意味のあるテストは自分で行おう。各エージェントにどのモデルを向けるかでまだ迷っているなら、生のスコアよりもエージェントの役割ごとにモデルを選ぶことのほうが出発点として良い問いだ。
おもちゃのプロンプトではなく、実際のタスクを1つ選ぶ
最も小さくて役に立つ比較から始めよう。「ToDoアプリを作る」でエージェントをベンチマークしてはいけない。バックログから実際の要件を1つ選ぶ。範囲の限定されたバグ、単一モジュールの小さな機能、どうせやるつもりだったマイグレーション。実行できる受け入れテストがあり、数分で読める diff があるものだ。
そして、すべてのエージェントに同一の入力を与える。同じタスク説明、同じ開始コミット、同じ受け入れ基準。トラッカーに書くように書き出そう。SH-312: fix the timezone drift in the invoice export のようなタスクだ。あるエージェントだけにより豊富なプロンプトを与えたら、あなたはエージェントではなく自分のプロンプトを測っていることになる。
既存のコードをどう読み、境界線の内側にとどまるかを見たいときはバグ修正を使う。新しいコードをどう構成し、自分でテストを書くかを見たいときは小さな機能を使う。両方を継続的に回そう。1つのタスクから分かるのは、1つのタスクのことだけだ。
どのエージェントも最良の状態で比較する。最悪の状態で比べてはいけない
各エージェントには、最も力を発揮するセットアップがある。適切なモデル、適切なコンテキストファイル、実際に必要な権限だ。Claude Code には CLAUDE.md を、Codex にはその設定を、各 Runtime にはドキュメントが推奨する環境を与えよう。十分に設定されたエージェントと、素のままのエージェントを比べても、どちらをわざわざセットアップしたかしか分からない。
それらを最良の状態で並べて実行する——ここでターミナル方式は破綻する。Sharkly では、同じ Task を各 Agent に割り当てると、各 Agent は接続された Computer 上の隔離された worktree で実行されるので、3つのエージェントが同じリポジトリを編集していても、互いのファイルには一切触れない。共有のワークツリーと手作業で解きほぐさなければならないマージの代わりに、同じ問題への3つのきれいな試行が得られる。これを手作業でやってきたなら、複数のエージェントを同時に実行することこそ、Sharkly があなたの手から取り除くために作られた部分だ。
エージェントを1つだけ使い、ターミナルで暮らしているなら、worktree 内の1つのよく調整された Claude Code セッションで十分であり、こうした仕組みのすべては必要ないかもしれない。方程式が変わるのは、2つ以上のエージェントを、複数のタスクにわたって比較し、その結果を実際に並べて読める形で得たいと思った瞬間だ。
実際の業務で優劣を決める5つの基準
ベンチマークは1つの数字を採点する。タスクが通ったかどうかだ。実際の業務は、その数字が省いてしまった5つの要素で決まる。
| 基準 | その基準が答える問い |
|---|---|
| 並列実行 | 同じタスクで複数のエージェントを、互いに干渉させず、隔離された状態で同時に実行できるか? |
| チームでの可視性 | 自分以外の誰かが、各エージェントが何を、なぜ行ったかを確認できるか? |
| レビューフロー | diff、テスト、既知の限界をどれだけ素早く読み、承認または却下できるか? |
| 自分のマシン上での実行 | エージェントは自分の Computer 上で、実際の環境とシークレットに対して実行されるか? |
| 連携 | 結果は、すでに使っているトラッカー、リポジトリ、レビューツールに届くか? |
最初の4つこそ、ベンチマークではほとんどのエージェントが同じに見えるのに、あなたのコードではまったく違う振る舞いをする部分だ。特に自分のマシン上での実行は、公開テストからは見えない。実際のツールチェーン、ローカルのデータベース、本物の CI フックに対して実行するエージェントは、それに似せたサンドボックスではなく、あなたがリリースするものの上でテストされている。
エージェントは調査し、実行し、テストし、報告する。あなたは方向性を示し、権限を与え、結果を受け入れる。このすべてを、スクロールバックから再構成することなく、すべてのエージェントについて見られて初めて、比較は誠実になる。
エージェントの主張ではなく、返ってきたものを評価する
「完了」と出力するエージェントは、通る変更と同じではない。各実行は、エージェントが主張することではなく、返ってきたもので評価しよう。すべての試行について、役に立つ証拠は同じ短いリストだ。diff、型チェックとテストの結果、変更サマリー、そしてエージェントが認める限界。Sharkly はコンテキスト、進捗、ブロッカー、結果、人間によるレビューを、リクエストからリリースまで可視化するので、比較は記憶を頼りにする5つのターミナルではなく、成果の表のように読める。
ここで本当のボトルネックも明らかになる。2つのエージェントがどちらも20分でタスクを「終え」ても、それぞれのレビューに1時間かかることがある。エージェントの出力のレビューは、しばしばチームが吸収できる並列作業量の真の上限であり、どのエージェントを選ぶかにおいて重く見るべきだ。何を重視するかは、誰が選ぶかによって変わる。
| 選ぶ主体 | 最も重視すべき項目 |
|---|---|
| 個人開発者 | レビューフローと自分のマシン上での実行。レビュアーは自分だけだ |
| 小規模チーム | 並列実行とチームでの可視性。複数の人が同じ実行を確認する必要がある |
| プラットフォームチーム | 連携と可視性。ワークフローは次に現れる最高のエージェントにも耐えなければならない |
最後の行こそ、比較すること自体の意味だ。今日最高のエージェントが、次の四半期にも最高のエージェントであるとは限らない。そしてリーダーが変わるたびにワークフローを作り直すのは、それ自体が税金のようなものだ。Sharkly はコーディングエージェントでもベンチマークハーネスでもない。エージェントをあなた自身のコードに対してテストし続けることを、そのたびにプロセスを作り直すことなく可能にするレイヤーだ。
1つのエコシステムにコミットするのではなく、複数のコーディングエージェントを使い続けたいなら、それこそ Sharkly が解決するために設計された問題だ。Sharkly をダウンロードし、1つの Computer を接続し、同じ実際のタスクを2つのエージェントに割り当ててみよう。返ってくる比較はあなたのコードベースについてのものであり、それだけがあなたの1週間を予測する。


