
9つのファイルにまたがる340行の変更を含むプルリクエストが、レビュー待ちの行列に届く。書いたのはコーディングエージェントだ。しかしdiffを見ても、エージェントが何を求められていたのか、どの手法を試しては捨てたのか、変更が機能すると確信するために何を実行したのか、どこで手を抜いたと自覚しているのかは分からない。そこで取れる行動は2つに1つ。ざっと目を通して承認するか、変更全体を一から組み立て直すかだ。前者は悪いコードが出荷される道であり、後者はエージェントが何も楽にしてくれなかったということになる。
AIが生成したコードをうまくレビューするのは、同僚のPRをレビューするのとは別の仕事だ。作者が隣に座って思考の道筋を説明してくれるわけではないからだ。解決策は、diffとそのエビデンスをセットでレビューすることにある。エビデンスとは、ゴール、実行されたチェック、エージェントがすでに申告した制約のことだ。Sharklyはそれを中心に作られている。Sharklyはコーディングエージェント(Claude Code、Codex、Geminiなど)の上に位置し、ゴール、変更、検証結果、そして各実行に対する人間のレビューを、ターミナルやPRの説明に散らばらせるのではなく、1つのタスクにまとめる。
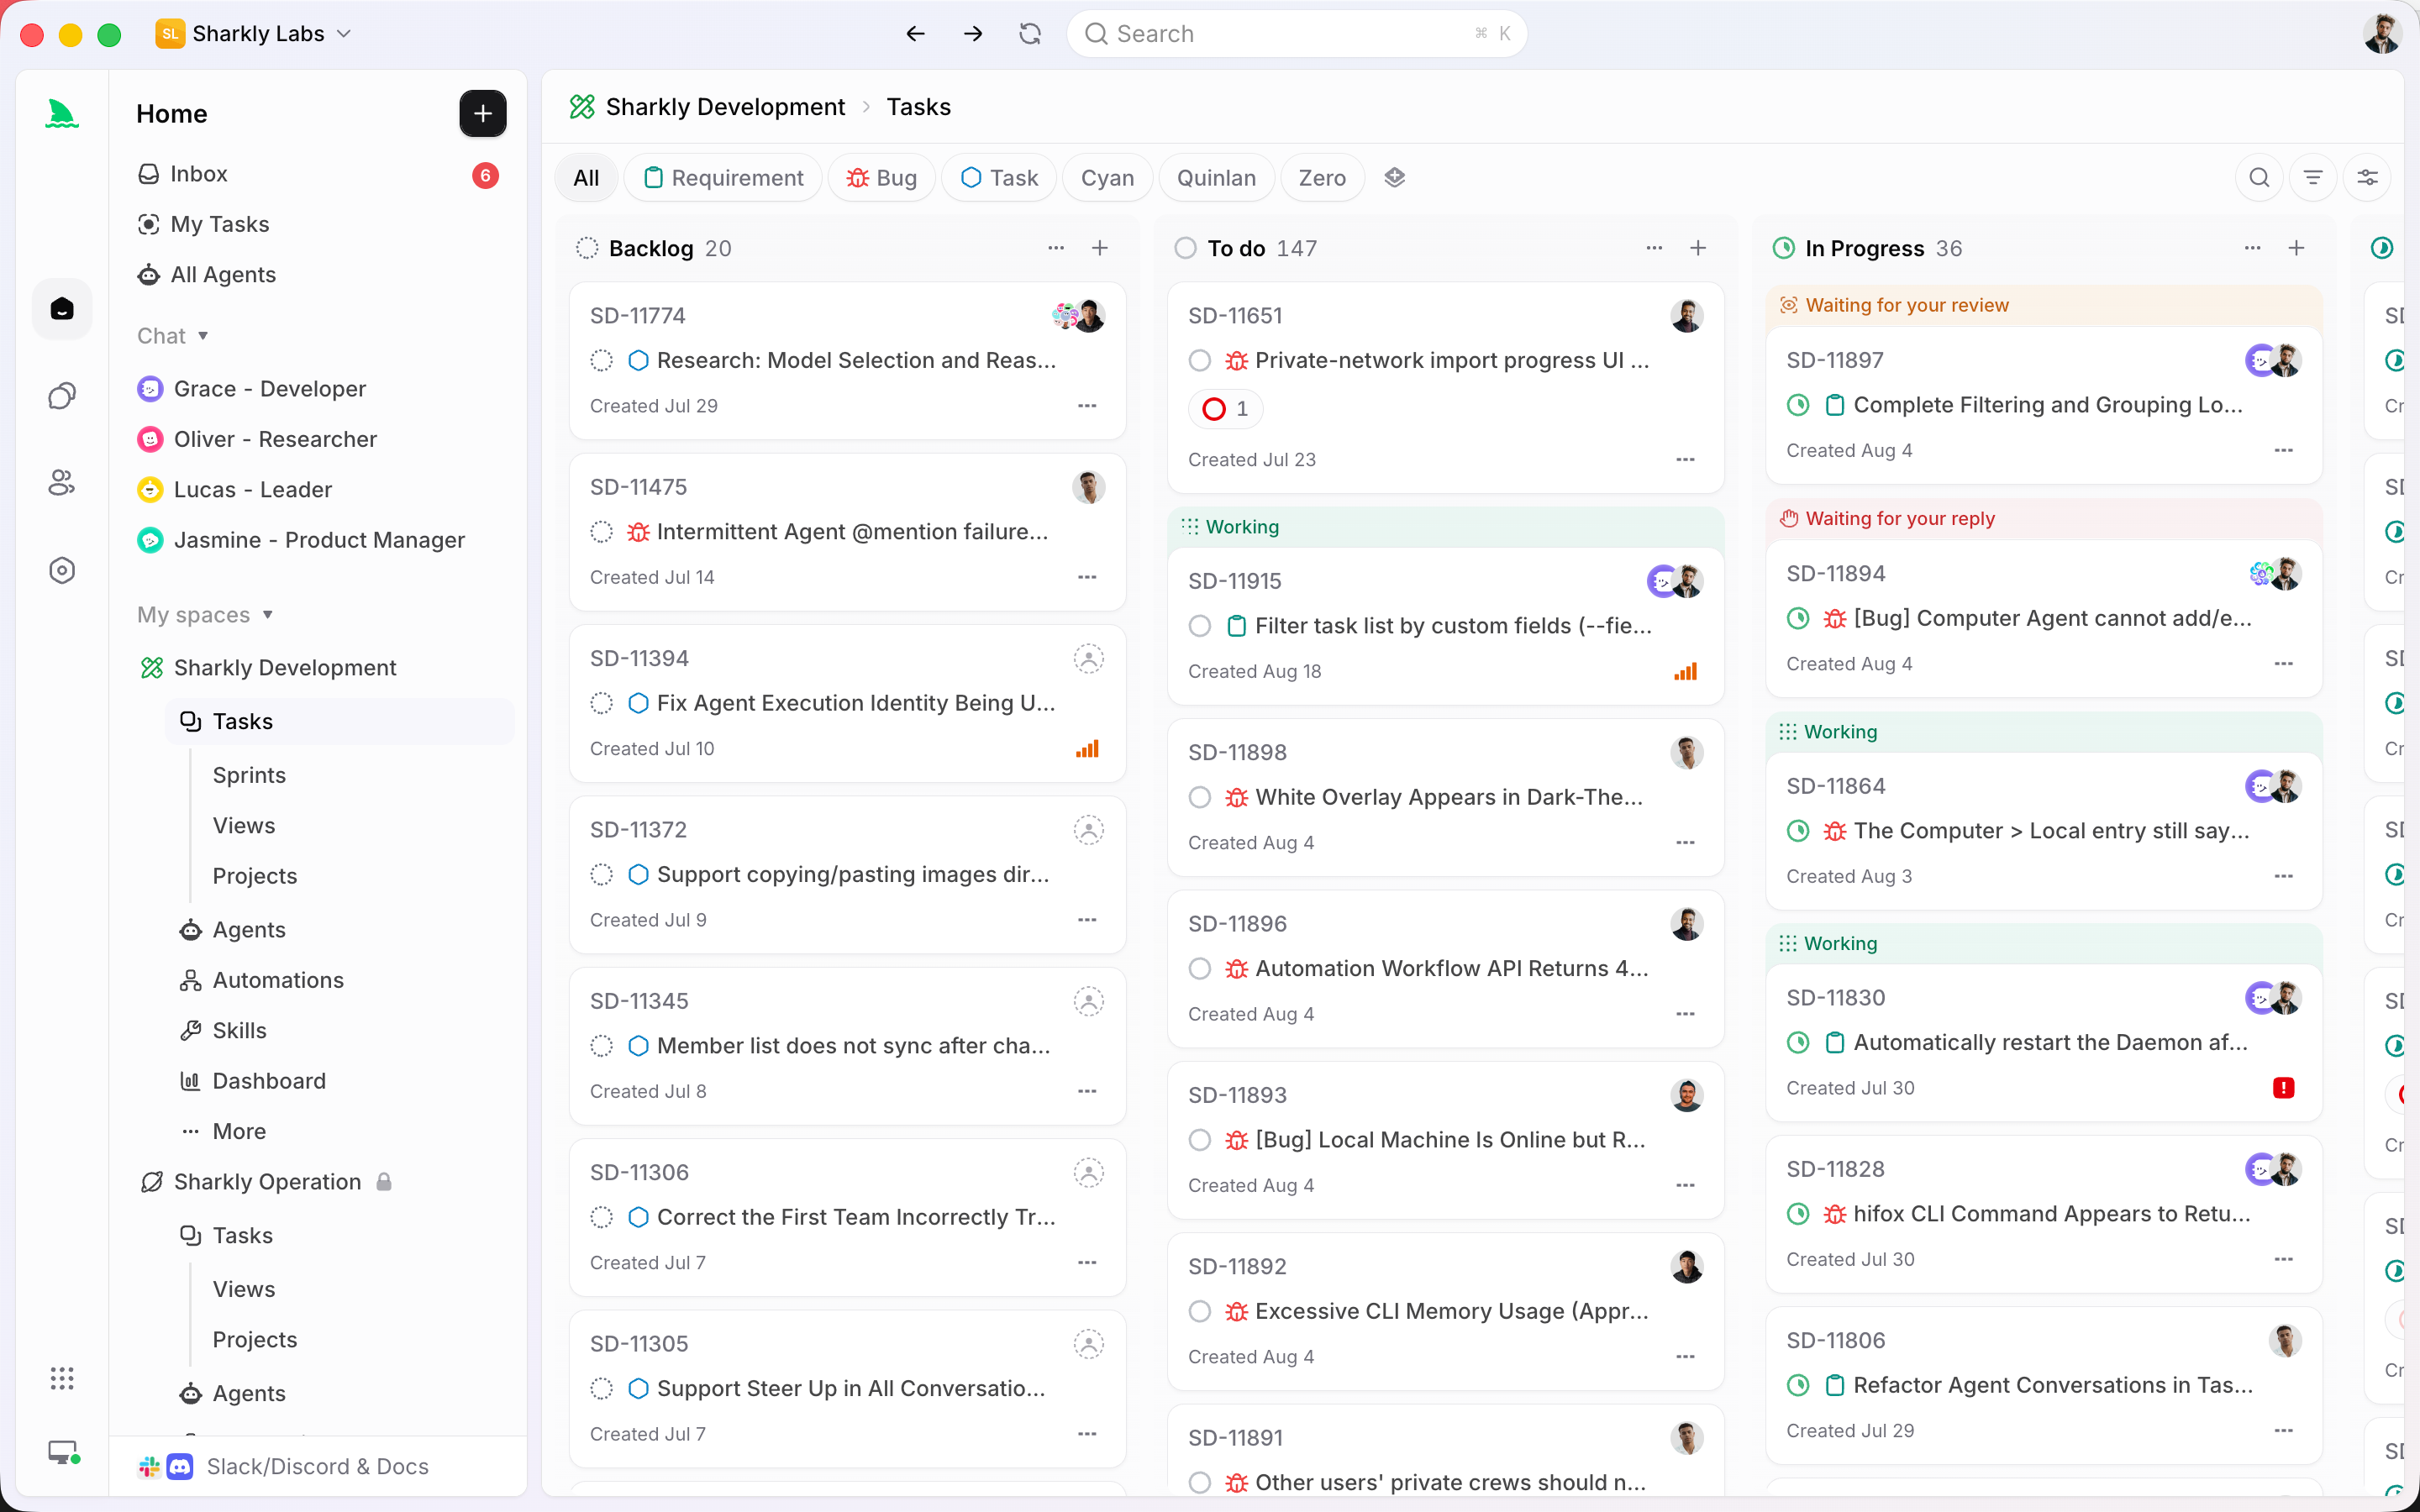
本ガイドでは、その背後にある運用モデルを順に解説する。誰が作業を割り当て、誰が実行し、誰がレビューし、誰が受け入れるのか。エージェントの仕事と人間の仕事を分けるステータスとゲート、そしてチケットからPRのマージまでの具体的な実例を1つ取り上げる。
要点
AIが生成したコードは、diffレベルではなくタスクレベルでレビューする。エージェントに、変更サマリー、実行した型チェック/テスト/ビルドの結果、既知の制約を共有タスクに添付させ、そのタスクをレビュー用ステータスへ移す。人間はdiffと並べてエビデンスを読み、変更を依頼するか承認し、マージを判断する。エージェントは成果物を作り検証する。人間が受け入れる。
diffだけをレビューすると失敗する理由
コードは書くよりも読むほうが難しい。コードレビューについて広く知られている現実として、レビュアーは作者よりも文脈を持っていない。そして作者がエージェントであれば、その差は埋めようがない。GitHubのdiffは到達点を見せるだけで、経路は決して見せてくれない。エージェントが最初にキャッシュ層を試し、競合状態にぶつかって元に戻したことなど分からない。テストスイートを実行し、変更とは無関係なフレーキーなテストが1つ失敗したことも分からない。
その文脈がなければ、レビューは2つの失敗パターンに陥る。ろくに確認せず承認すれば、もっともらしく見えるものの、エージェントが考慮しなかったエッジケースを静かに壊すコードが通ってしまう。完全に再構築しようとすれば、思考の道筋を自分で組み立て直すことになり、その時点でエージェントのスピード優位は消える。3つのエージェントが同時にPRを開く状況では、どちらもスケールしない。突破口は、エージェントの成果物だけでなく、その仕事ぶりそのものをレビュー可能にすることだ。
タスクレベルのエビデンスとは実際に何を指すのか
タスクレベルのエビデンスとは、エージェントがタスクに添付する記録のこと。取り組んだゴール、生み出した変更、実行したチェック、把握している制約が含まれる。裸のdiffではなく、来歴をたどれるdiffが手に入るのだ。
実際のエビデンスの束は、4つの要素で構成される。
- ゴールと受け入れ基準。タスクの説明に記載されるので、レビューは「もっともらしく見えるか」ではなく「何を求められたか」を基準に測られる。
- 変更サマリー。エージェント自身の言葉で、何に手を入れ、なぜそうしたのかを記す。
- 検証結果。引き渡す前にエージェントが実行した型チェック、テスト、ビルドの出力。
- 既知の制約。エージェントが隠さず申告したエッジケース、前提、フォローアップ事項。
そのすべてがタスクに戻ってくる。実行、ブロッカー、結果、フォローアップの議論が1つのタイムライン上に並ぶので、レビュアーはPR、Slackのスレッド、うろ覚えのプロンプトをつなぎ合わせるのではなく、1つの記録を開くだけで済む。これが要件からコードまでを追跡可能にするワークフローを支える規律であり、エビデンスは成果物の一部なのだ。
運用モデル:誰が割り当て、誰が実行し、誰がレビューし、誰が受け入れるか
優れたレビューは役割の明確さにかかっている。契約はシンプルだ。エージェントは調査し、実行し、テストし、報告する。人間は方向性を示し、権限を与え、結果を受け入れる。自動化はチームの判断が必要なところで止まる。
| 役割 | 担当 | 職務 |
|---|---|---|
| 割り当て担当 | 人間(通常はタスクオーナー) | ニーズを記述し、受け入れ基準を設定し、タスクを割り当てる |
| 実行担当 | 接続されたコンピューター上で、ランタイムを介して動くエージェント | タスクを引き受け、隔離されたワークツリーで実行し、エビデンスを添付する |
| レビュアー | 人間 | diffをエビデンスと照らし合わせて読み、変更を依頼するか承認する |
| 受け入れ担当 | 人間(オーナーまたは指名された承認者) | 最終的な受け入れとマージ/リリースの判断を下す |
SharklyはClaude CodeやCodex、その他の実行ツールの代替ではない。チームがすでに使っているツールの周囲に、共有されたタスク、コンピューター、コンテキスト、レビュー層を追加するものだ。コードを書くのはランタイムであり、Sharklyはレビューが誰の待ち行列に届くか、人間が目を通す前にどのエビデンスが揃っている必要があるかを決める。割り当て側をより詳しく知りたい場合は、エージェントの作業を誰が割り当て誰が受け入れるかを参照してほしい。
ステータスとレビューゲート:エージェントは「Ready for review」まで、人間が「Done」にする
レビューゲートはステータスの境界線だ。Sharklyでは、すべてのタスクステータスがシステム上の意味を持つ固定カテゴリに属する。Backlog(保留)、Unstarted(準備完了、未着手)、Started(進行中)、Completed(終端)だ。複数の表示上のステータスが同じカテゴリを共有できるため、あるタスクタイプのワークフローでは、DevelopmentとReady for reviewを2つの異なるStartedステータスとして運用し、その後にCompletedへ到達させることができる。
この構造がゲートを実効的なものにする。エージェントはタスクをDevelopmentからReady for reviewへ進め、人間のレビュー待ちにすることができる。しかし、タスクを自力でCompletedステータスへ移すことはできない。受け入れは設計上、人間による遷移なのだ。
| ステータス | カテゴリ | ここへ移す担当 |
|---|---|---|
| Backlog | Backlog | 作業を保留するときの人間 |
| Todo | Unstarted | タスクの準備が整ったときの人間 |
| Development | Started | タスクを引き受けて作業するときのエージェント |
| Ready for review | Started | エビデンスを添付したときのエージェント |
| Done | Completed | 受け入れた後の人間 |
Completedステータスへの遷移に人間を必須とするようワークフローを設定すれば、エージェントの生産速度が人間の監視を上回っても機能するレビューゲートが手に入る。これはコーディングエージェントに人間を介在させる仕組みを機械的に実現したものであり、エージェントをマージ前にどこで止めるかを決める場所でもある。
実例:チケットからPRのマージまで
SH-312を例に取ろう。「公開検索エンドポイントにレート制限を追加する。APIキーあたり毎分60リクエスト」というものだ。
- 人間がそのゴールと2つの受け入れ基準を添えてSH-312を起票する。制限を超えたリクエストはHTTP 429を返すこと、制限はIP単位ではなくキー単位であること。タスクはTodoで始まる。
- エージェントがそれを引き受け、Developmentへ移し、隔離されたワークツリーで実行する。こうすることで、そのチェックアウトが同じリポジトリで作業する他のエージェントと衝突しない。(ワークツリーがあるから並列実行がクリーンに保たれる。タスクごとに1つのチェックアウトを参照。)
- エージェントはトークンバケット方式のリミッターを実装し、PRを開き、SH-312にエビデンスを添付する。変更サマリー、成功した型チェックとユニットテスト、ビルド結果、そして1つの既知の制約:「バケットはプロセスメモリ上にあるため、デプロイで制限がリセットされ、インスタンス間で共有されない」。
- エージェントはSH-312をReady for reviewへ移す。diffとエビデンスが一緒に、人間の待ち行列へ届く。
- レビュアーはまず既知の制約のメモを読み、インメモリのバケットは今のところ問題ないと判断し、1点の変更を依頼する。429の際に
Retry-Afterヘッダーを返すこと。エージェントは変更を加え、更新したテスト出力を再添付する。 - レビュアーは承認し、PRをマージし、SH-312をDoneへ移す。共有リミッター用のフォローアップチケットはすでにリンクされている。
レビューは数分で終わった。レビュアーが変更を組み立て直すことは一度もなく、その作業はエビデンスが担ったからだ。これはイシューからレビューまでのClaude Codeプロジェクト管理と同じループであり、エビデンスの束がレビューをボトルネックではなく高速なものにする。
エビデンスを素早くレビューする方法と、軽く済ませるべき場面
すべての変更に完全なレビューが必要なわけではない。判断基準を使おう。
変更が認証、課金、データ移行、公開API、あるいはロールバックが難しいものに触れる場合は、重めにレビューする。diffを1行ずつ読み、自分でテストを再実行し、既知の制約のメモを自分が想定するエッジケースと照らし合わせる。変更がコピーの微修正、十分にテストされた内部リファクタリング、チェックが通った依存関係の更新であれば軽く済ませる。サマリーを読み、diffをざっと見て、検証が通ったことを確認し、承認する。
ヘビーレビューを素早く行うチェックリスト:
- diffはハッピーパスだけでなく、すべての受け入れ基準を満たしているか?
- エージェントは実際にチェックを実行したのか、それとも実行したと主張しただけか?添付された出力を確認する。
- 既知の制約のメモを読む。フォローアップではなくブロッカーに当たる制約はないか?
- 変更は依頼の範囲に収まっているか、それともエージェントが無関係なファイルにまで手を入れたか?
すでに複数のコーディングエージェントを動かしているなら、これはSharklyが1か所で管理できるようにするワークフローだ。タスクを割り当て、エージェントにエビデンスを添付させ、ゲートでレビューする。ワークツリー、PRテンプレート、ステータスボードで各部を手作業で組み上げることもできるし、Sharklyをダウンロードすればタスク、エビデンス、ゲートを1つのシステムとして手に入れられる。
よくある質問
AIが生成したコードにおけるタスクレベルのエビデンスとは何か? エージェントがdiffと一緒にタスクへ添付する記録のことだ。ゴール、変更サマリー、実行した型チェック/テスト/ビルドの結果、既知の制約が含まれる。その束をレビューするほうが、diffだけをレビューするより速く安全だ。
AIエージェントは自分のコードを承認できるのか? いいえ、それがレビューゲートの目的だ。エージェントはタスクをReady for reviewへ移せるが、Completedステータスへの遷移は人間の判断だ。エージェントは成果物を作り検証し、人間が受け入れる。
ろくに確認せず承認するのを避けつつ、AIコードを素早くレビューするにはどうすればいいか? リスクに応じて工数を合わせる。すべての変更でエビデンスは読むが、1行ずつのレビューとテストの再実行は認証や移行といった高リスク領域に限定する。エージェントが人間を上回る速度で作業するときにレビュー容量がどうスケールするかを参照してほしい。
プルリクエストは引き続き使うのか? はい。エージェントはGitHub上で実際のプルリクエストを開く。タスク層はその周囲にエビデンスとゲートを追加し、PRが唯一のコンテキスト置き場にならないようにする。


