
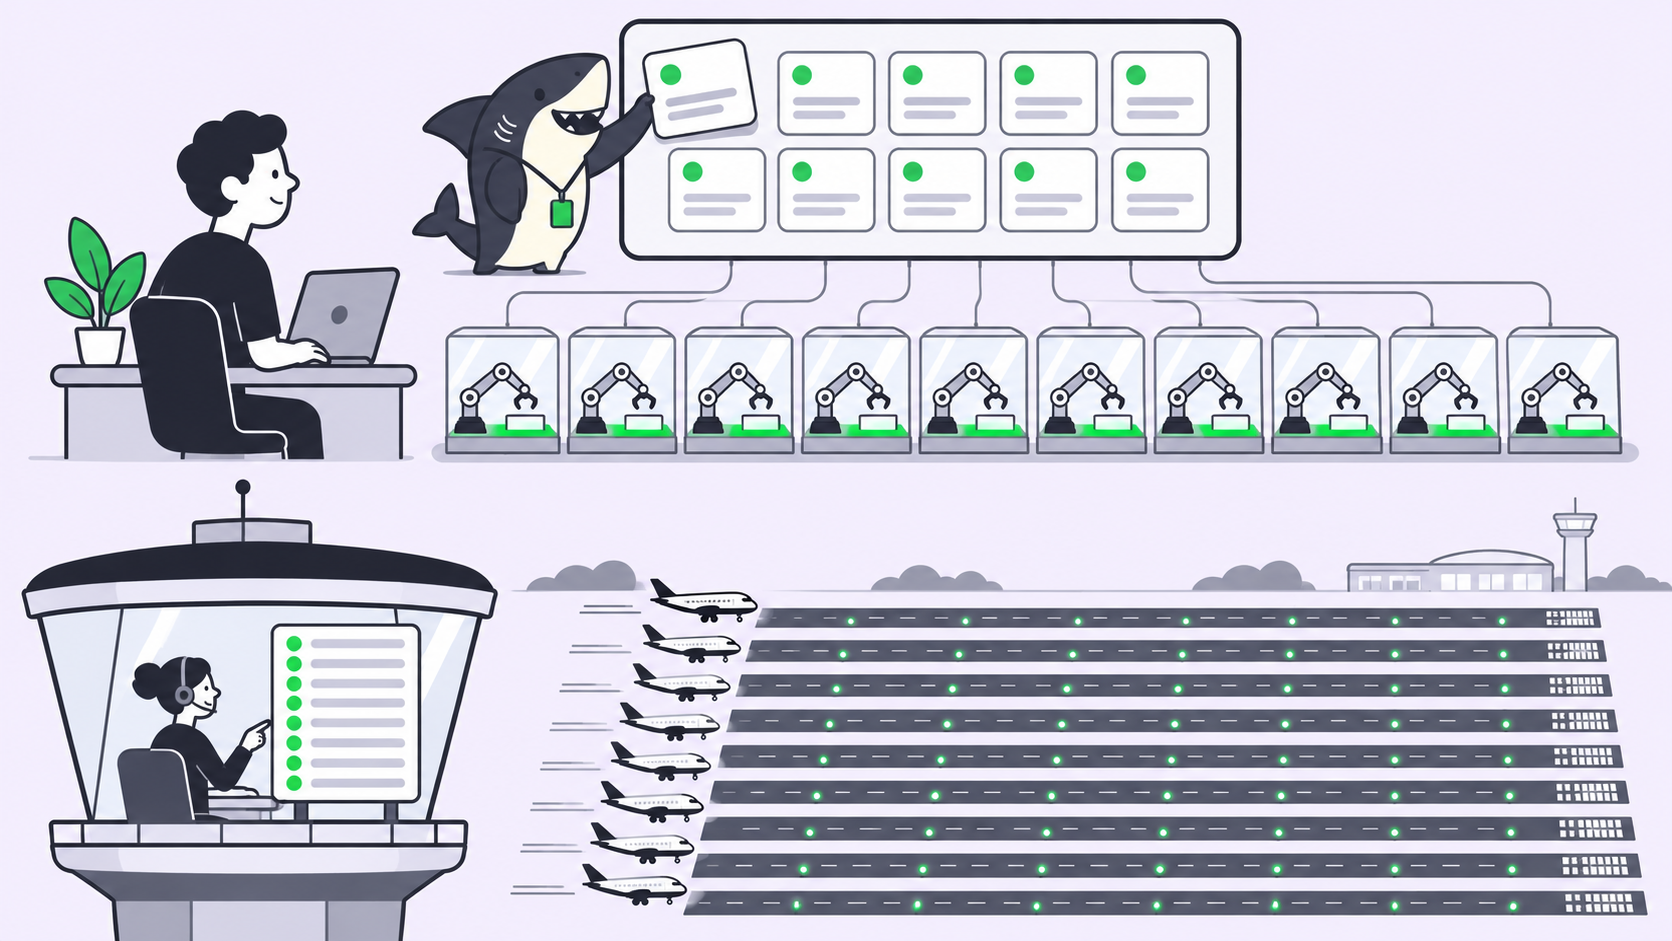
TL;DR: 10台のAIコーディングエージェントを同時に動かすには、エージェントを監視対象のターミナルとして扱うのをやめることです。作業を個別のタスクに分割し、接続されたComputer上の分離されたworktreeでタスクごとにエージェントを実行し、追加のやり取りはタスクのコメントとして記録し、反復作業はイベントトリガーに任せます。監視すべきはセッションではなく、結果です。
ターミナルのタブを10個開かなくても、10台のAIコーディングエージェントを同時に稼働させることは可能です。そして最初に直面する限界は、モデルの性能ではありません。DeepSeek Harnessチームは、その論考「Exploring Super-agent Design」の中で明快に指摘しています。人間が同時に把握できるアクティブなセッションは通常3〜5個程度であり、それ以上になると人間自身がボトルネックになってしまいます。
彼らが出した答えが「スーパーエージェント(super-agent)」です。1つのコーディネーターが人間と対話しながら、作業を複数の独立したワーカーに振り分けます。この論考で示されているのはアーキテクチャの概念であり、提供されている完成品ではありません。本ガイドでは、すでにお使いのClaude CodeやCodexの環境を活用し、Sharklyのボード上で今すぐチームが実践できるシンプル化された運用モデルを紹介します。
一点だけ決定的な違いがあります。DeepSeekのコーディネーターはLLM自身が誰に何を割り振るかを判断しますが、タスクボード形式では人間がその判断を下し、すべての決定が履歴として残ります。
なぜ10個のターミナルでは破綻するのか
手動で管理する場合、2〜3台のエージェントなら問題なく動きます。しかし10台になると、4つの問題が同時に押し寄せてきます。
- 人間がルーターになってしまう。 すべてのプロンプト、「continue」の指示、追加のやり取りがすべて人間を経由します。
- コンテキストが混ざってしまう。 認証ブランチ向けの修正が請求セッションに紛れ込んだり、2台のエージェントが同じチェックアウト環境を同時に編集して競合・上書きしてしまったりします。
- ノートPCがサーバーになってしまう。 画面を閉じると、すべてのセッションが一時停止します。長時間の実行には、スリープしないホストマシンが必要です。
- ログが記録に残らない。 実行が失敗したとき、その履歴はすでに閉じてしまったターミナルのスクロールバックバッファの中に消えてしまいます。
このコストについては、Too Many Terminalsでも取り上げました。解決策はシンプルです。頭の中で行っている調整作業を、状態を保持できる仕組みへと移行することです。
DeepSeekのスーパーエージェントをボード上にマッピングする
DeepSeekが設計した各コンポーネントは、タスクボード上の要素と綺麗に対応付けることができます。
| DeepSeekの構成要素 | 論考内での役割 | Sharklyボード上での対応 |
|---|---|---|
| Router | 長期間常駐する1つのセッション。人間と対話してタスクを振り分けるが、自身は実行しない。軽量モデルで十分 | ボード、およびタスクを割り振る人間 |
| Workers | タスクごとに1つの隔離されたセッション。最高性能のモデルを使用し、人間とは直接対話しない | タスクごとに専用のworktreeで実行される1回のエージェント実行 |
| Threads | 同一のPRやチャットトピックに関する追加のやり取りを、割り当てられたWorkerへ直接伝達 | タスクへのコメントが、担当エージェントを再度起動 |
| Triggers | まずコード(許可リスト)でフィルタリングし、続いてモデル(プロンプトとしてのポリシー)でフィルタリングするイベント | ステータス変更、コメント内の特定フレーズ、Webhook、またはスケジュールによるAutomation |
| BYOM (bring your own hardware) | エージェントのループ処理はクラウド側で実行し、軽量デーモン経由で手元のハードウェア上に環境を構築 | Sharkly DesktopまたはSharkly CLI経由で接続されたComputer |
| Watchdog | ループや目的からの逸脱に陥ったWorkerを検知する外部セッション | 定期チェック、実行履歴、および人間によるレビューゲート |
この2段階のトリガーフィルターは、そのまま真似する価値があります。まずコード側で弾けるもの(無関係なリポジトリ、無関係なステータスなど)を除外し、その通過分のみをモデルが読み取ります。ボード上では、トリガーがコード側のフィルターとして機能し、Automationの指示(プロンプト)がポリシーフィルターとして機能します。
Sharklyボード上で10台のAIコーディングエージェントを運用する方法
最初から10台で始める必要はありません。まずは3台からスタートして運用サイクルを確立し、そこから徐々に増やしていきましょう。
ステップ1: Computerを接続し、並行数を低めに設定する
Computerとは、エージェントを実行するホスト環境のことです。ノートPCならSharkly Desktopをインストールします。リモートホストやLinuxマシンの場合は、Sharkly CLIとそのローカルサービスを使用します。
# リモートホスト側で、Computersページから取得したインストールトークンを使って実行
sharkly computer register --install-token <install-token>
sharkly daemon status
ローカルサービスはClaude CodeやCodexなどのインストール済みツールを自動検出し、それぞれをRuntimeとして報告します。
各Computerには並行タスク数の上限があります。Computersのドキュメントによると、一時ディレクトリでの実行はデフォルトでその上限の50%に設定されており、キャパシティが埋まると追加のタスクはキューに入ります。最初は思っているよりも低めに設定してください。まずは1台のComputer上で3並列の実行を試してみるのが手頃なテストになります。
コードを扱う作業には一時ディレクトリモードを使用します。実行ごとに独立したディレクトリが割り当てられ、リポジトリの実行では新規のgit worktreeを取得できるため、2台のエージェントが同一のチェックアウト環境に書き込んでしまう心配がありません。worktreeに馴染みがない方は、まずAIコーディングエージェントでgit worktreeを活用する方法をご覧ください。
ステップ2: 明確な役割を持つ2〜3種類のエージェントを作成する
10台のエージェントを動かすからといって、10種類の人格が必要なわけではありません。いくつかの役割を定義し、それぞれに複数のタスクを処理させます。
- Builder: コードの変更を実装します。DeepSeekのWorkerと同様に、最も強力なモデルを割り当てます。
- Reviewer: diffとタスクの受け入れ条件を確認し、コメントを投稿します。
- Fixer: 失敗したテストやレビューコメントへの対応を担当します。
Agent、Crew、Computerはシート(ユーザー枠)を消費しないため、役割を自由に追加しても追加のシート費用はかかりません。
ステップ3: 単独で実行可能なタスクを作成する
並列化のセットアップの多くは、ここで失敗します。まだマージされていない他のタスクのコードに依存しているタスクは、処理が止まるかコンフリクトを起こしてしまいます。
各タスクには、「明確な成果物を1つ」「担当するファイルまたはモジュール」「誰でも実行可能な検証手順」の3つを必ず記載してください。「/api/uploadにレートリミットを追加する。npm test -- uploadがパスすること」は機能します。「APIを改善する」では機能しません。
2つのタスクが同一ファイルを編集する場合は、並列ではなく順次実行してください。
ステップ4: タスクを割り当て、以後のやり取りはタスク上に集約する
各タスクをエージェントに割り当てます。Backlog以外のステータスにあるタスクはすぐに実行を開始できます。Backlogにあるタスクは、準備完了ステータスへ移動するまで待機します。
その後のやり取りは、個別のダイレクトチャットではなく、必ずタスクのコメント欄で行います。エージェントが割り当てられたタスクにメンバーがコメントすると、追加の実行がキューに入ります。Sharklyは短時間の連続コメントを自動で1つにまとめるため、保留中の実行が無駄に重複することはありません。これはDeepSeekのThreadの考え方と同じであり、対話ログは常に作業単位に紐付いた状態で保持されます。
/reviseのような定型フレーズに変更内容を添えてコメントするようにすると、追加指示を簡単に識別できます。
ステップ5: 反復イベントをAutomation化する
Automationは、指示内容(プロンプト)をエージェントまたはCrew、そして1つ以上のトリガーと組み合わせたものです。Automationsのドキュメントにある通り、手動の「今すぐ実行」に加えて4種類のトリガーが利用できます。
- Schedule: 5フィールドのcron式とタイムゾーン。
- Task status: タスクが指定されたステータスに移動したときに起動。
- Comment phrase: コメントに特定のフレーズが含まれていたときに起動(大文字・小文字は区別なし)。
- Webhook: POSTリクエストを受け付けるシークレットURL(任意でリクエスト署名も可能)。
ドキュメントにある注意点として、現在のところステータスおよびコメントのマッチングは特定のSpaceに限定されず、組織全体に適用されます。そのため、エージェントが最初に対象タスク(タイトル接頭辞や属しているSpaceなど)を確認し、該当しない場合は処理を停止するように指示を記述してください。これがプロンプトとして実装するDeepSeekの第2段階フィルターになります。
ステップ6: 監視役(Watchdog)と人間によるレビューゲートを設ける
DeepSeekでは、ループやドリフトに陥ったWorkerを検知するために独立したWatchdogを稼働させています。これに近い仕組みは、通常の実行時間を大幅に超過したタスクを検知する定期実行のAutomationで再現できます。判定にはSharklyが記録している実行ステータス(queued、running、completed、failed、canceled)を使用します。
そして最終工程には必ず人間を配置します。マージ前に人間がdiffを承認するレビューステータスを設けてください。人間のレビュー処理能力が全体の現実的な上限を決めることになります。5台以上のスケールを検討する前に、ぜひHuman Review Is the Bottleneckを一読してください。実行中の監視ポイントについては、並行稼働するコーディングエージェントの監視方法で解説しています。
10台を運用するためのコスト
費用は大きく2つに分かれます。モデルのトークン費用と、調整レイヤーの利用料です。
トークン費用: Sharklyはトークンの再販を行っていません。実行にかかる費用は、各Runtimeに直接紐付いているClaude Code、Codex、または各種APIプランに対して課金されます。その理由については、Why an Agent Platform Should Not Sell You Tokensで詳しく説明しています。
並行処理に伴うトークン消費: DeepSeek自身によるベンチマークが参考になります。彼らは約300件のメッセージ、約20件の作業リクエスト(コーディングシミュレーション)を用い、それぞれ5回ずつ実行して検証を行いました(結果はあくまで指標値とされています)。
| 構成(DeepSeekの測定値) | タスク所要時間 (p50) | タスク所要時間 (p95) | 1実行あたりのキャッシュ読み取りトークン数 |
|---|---|---|---|
| スーパーエージェント | 12.4分 | 15.7分 | 23.2M |
| 単一セッション + サブエージェント(中立プロンプト) | 20.4分 | 29.5分 | 6.1M |
| 単一セッション + サブエージェント(委譲優先プロンプト) | 13.8分 | 29.0分 | 10.8M |
中立プロンプトのセッションでは、5回の実行の中で一度もサブエージェントへの委譲が行われませんでした。トークン消費量は増えるものの、タスクの完了時間が短く安定するというトレードオフ関係にあります。なお、当社ではこれらのテストの再検証は行っていません。
プラットフォーム費用: 2026年11月4日現在のSharklyの料金プランでは、5人までの組織であれば無料で利用できます。Teamプランは1人あたり月額7ドル(年払い)です。課金対象となるシートは人間のみに適用されます。
このパターンが適しているケース
- バックログの一括消化: 互いに依存しない20件の小さなイシューを個別のタスクにし、BuilderとReviewerを割り当てて消化する。
- ライブラリアップグレード後のテスト修正: 失敗しているパッケージごとに1つのタスクを作成し、それぞれ専用のworktreeで対応する。
- コードとドキュメントの同期: 機能開発タスクがレビューステータスに移行したタイミングでステータストリガーを発火させ、ドキュメント更新エージェントを自動起動する。
- 夜間のバッチ処理キュー: 24時間稼働のリモートComputerにタスクを投入しておき、翌朝まとめてレビューする。
エージェントをそもそもどこで実行すべきか迷っている方は、Codex Cloud vs your own Computersをご参照ください。
まずは3台から始めよう
10並列でのエージェント運用は、運用の結果であってスタート地点ではありません。まずは1台のComputerを接続し、BuilderとReviewerを作成し、検証可能な成果物を持つタスクを3つ書いて割り当ててみましょう。「実行、コメント、追加指示、レビュー」という一連のサイクルを一度最後まで見届けます。その流れが当たり前のルーチンになったら、並行数を2つ増やし、Automationを1つ追加してみてください。
よくある質問
1人の人間が管理できるAIコーディングエージェントは何台までですか?
DeepSeekのチームによると、人間が各セッションを直接目で追う場合、アクティブなセッション数は3〜5個が限界とされています。作業を検証可能な成果物を持つ「タスク」として管理すれば、セッションの経過を監視する代わりに成果物だけをレビューすれば済むため、より多くのエージェントを運用できます。
同一リポジトリに対して複数のClaude Codeエージェントを同時に実行できますか?
はい。各実行が独立したディレクトリで作業していれば可能です。一時ディレクトリモードを使用すると各タスクに個別のディレクトリが割り当てられ、リポジトリ実行では新規のgit worktreeが利用できるため、並行して動くエージェント同士が互いの変更を上書きすることはありません。
Computerの処理上限を超えるタスクを割り当てるとどうなりますか?
上限を超えたタスクはキューに蓄積されます。各Computerには並行タスク数の上限が設定されており、空きができ次第順次実行が開始されます。また、Computerがオフラインの場合や対応するRuntimeが利用できない場合も、実行はキューで待機します。
エージェントを並行稼働させるにはクラウドサーバーが必要ですか?
いいえ、必要ありません。Sharkly Desktopを使えば、手元のノートPCをそのままComputerとして利用できます。長時間の実行や夜間処理を行いたい場合は、Sharkly CLIをセットアップしたリモートサーバーやLinuxマシンを接続しておけば、ノートPCがスリープしても処理を継続できます。
タスクボードによる運用はDeepSeekの「スーパーエージェント」と同じものですか?
完全に同じではありません。DeepSeekのRouterはLLM自身が自動的に振り分けを行いますが、ボード運用では人間がタスクを割り当て、反復イベントの処理をAutomationが担います。


