
4つのコーディングエージェントが同じ1時間のうちに作業を終え、4つのプルリクエストを開いた。1つは課金のリトライ処理に触れ、1つはテストヘルパーの名前を変更し、1つはマイグレーションを追加し、1つはREADMEのタイポを修正している。ボトルネックはコードでもテストでもない。人がdiffを1行も読む前に答える問い、つまり「このうちどれを先に見るべきか」だ。エージェントが並列で動くようになると人によるレビューがボトルネックになることは以前も指摘した。本記事ではその問題の機械的な部分、すなわちキューの順序付けと、Jevのような意思決定モデルがレビューそのものを奪うことなく、どうやってレビュアーの手からこの負担を取り除けるかを扱う。
Jevとは何か
JevはTypeSafe AIのSystem Oneモデルだ。ある状態と型付きの質問群を送ると、各質問に対して較正された確率付きの回答を返す。自由記述は返さない。名前について誤解のないように言っておくと、これはTypeSafeのモデルであるJevであり、あのYouTuberでも日本脳炎ワクチンでもない。TypeSafeのローンチ記事はこれを「非構造化された状態を入力し、型付きの確率的な意思決定を出力する」と説明している。APIはエンドポイントが1つだけで、POST https://api.typesafe.ai/v1/systemone、Bearerキー、モデルはjev-latest、質問タイプは3種類:noul(はい/いいえの確率)、choice(最大255個の選択肢から1つを選ぶ)、score(2〜10段階のルーブリック上の位置)。テキストのみ、1リクエストあたり64kトークン(うち状態に32k)、入力トークン100万あたり$0.042、出力は課金なし。姉妹記事のコーディングエージェントの意思決定レイヤーとしてのJevではモデル全般を扱っているが、本記事では1つの用途に絞って使う。
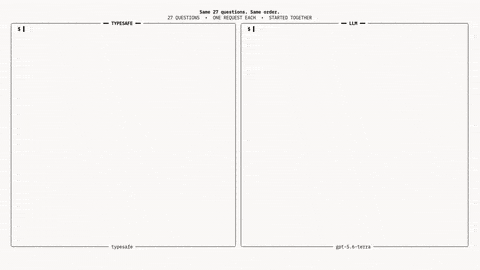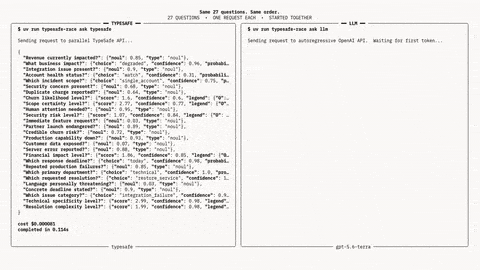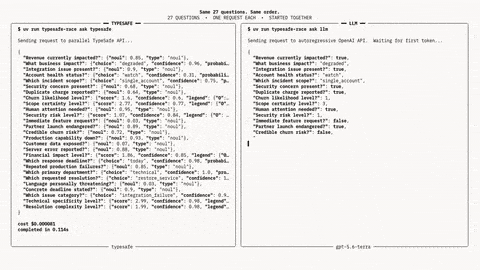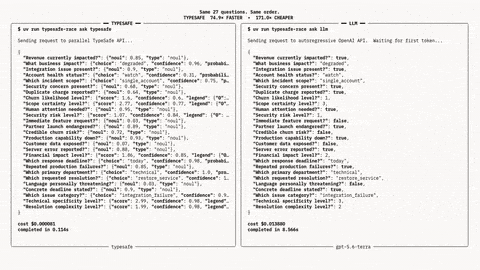
レビューにおける3つの問い
コーディングエージェントが開くPRはどれも同じ3つの問いを提起し、それぞれが1つのプリミティブに対応する。3つすべてで状態は同じだ。diffの要約、テスト結果、そして触れたパス。完全なdiffではない。要約にしておけば、呼び出しを予算内に収められ、モデルがコードを再レビューするのではなく、ルーティングの問いに答えるようになる。
マージ前に人の確認が必要か? これはnoul。これがフィルターとなる。PRがそもそも人のキューに入るのか、低優先度のレーンで待つのかを決める。
どのレビュアー、あるいはどのキューか? チームが実際に運用しているキューの集合に対するchoice。回答には選択結果と完全な分布が含まれるので、2つのキューの間で0.48 / 0.44に割れていれば、そのPRがオーナーシップの境界をまたいでいることが分かる。それ自体、知っておく価値のある情報だ。
どの程度のリスクを伴うか? 順序付けられたルーブリック上のscore。結果は確率で重み付けされた位置になるので、「テストでカバーされたロジック変更」と「認証・課金・データに触れる」の間の2.6に着地することもある。この数値がキューのソートキーになる。
1回のリクエストで3つすべてに答える:
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
レスポンスは同じキーの下に3つの型付き回答として返る。SH-418なら、needs_humanは0.9付近、queueはpaymentsを選択、riskはルーブリックのほぼ最上位になると予想される。テストが通った課金リトライの修正であっても、paymentsキューの先頭に送られる。テストが通っていることは「これを人が読むべきか」への答えにはならないからだ。
しきい値と各バンドの動作
確率は、コードがそれを行動に変えて初めて役に立つ。以下のバンドは出発点であり、あなたのリポジトリに対する推奨ではない。1週間動かした後に調整してほしい。
needs_human |
アクション |
|---|---|
| 0.85以上 | 人のキューの先頭。riskの降順でソート |
| 0.15〜0.85 | 人のキュー。riskでソートし、上のバンドの後ろに配置 |
| 0.15未満 | 低優先度レーン。ただし人が自分のタイミングでマージする |
2つのルールがこれを誠実に保つ。第一に、ルーブリック最上位のriskは、needs_humanが何と言おうと、常にそのPRを最前バンドへ引き上げる。スキーママイグレーションにレビューが必要だとモデルが0.12の確信度しか示していないなら、それはきれいに整ったdiffの要約を見ただけであり、プロダクションを見たわけではない。第二に、上位2つの選択肢が0.1以内に収まるchoiceは、どちらか一方のキューではなく、両方のキューにルーティングする。オーナーシップの曖昧さは、2人がその変更に目を通す理由であって、誰も見ない理由ではない。
どのバンドでも人に残るものに注目してほしい。それはマージだ。バンドが変えるのは読む順番と読む深さだけであり、誰が決めるかは決して変わらない。
キューにはJevを使い、判定には使わない
Jevを使うのは、問いに対する答えの集合が固定されており、状態が忠実な要約であり、人の注意をより良い順序で配分したいときだ。誰がこれを読むのか、どれくらい急ぐのか、どのキューなのか。こうした問いはすべてのPRで発生し、この価格なら毎回の実行で尋ねても十分に安い。
人を使う、あるいは推論を提示できる言語モデルを使うのは、その変更が正しいかどうかが問いであるときだ。変更にレビューが必要だという確率は、レビューではない。Jevにはコンパイラもテストランナーもなく、採点対象のファイルにもアクセスできない。あるのは送った要約だけだ。「マージしても安全」の0.96は、そのPRを誰かのリストの先頭に置く強い理由にはなるが、その誰かを飛ばす理由には決してならない。承認ゲートはモデルの後に位置し、モデルがそれを開く手段はない。
コミュニティが作ったもの
ローンチから数日のうちに、ある開発者がjev-reviewを公開した。READMEには「TypeSafe Jevで作られた小さなコードレビューワークフロー」と書かれている。Gitのdiffまたはコードベース全体をレビューし、正確性、セキュリティ、信頼性、互換性、テストカバレッジの観点でスクリーニングし、影響度をスコアリングする前にコード領域を選択し、しきい値とワークフローポリシーをコードで適用し、結果をローカルダッシュボードに表示する。READMEは適用範囲について慎重だ。このプロジェクトを「高速な型付き判断をレビューワークフローに組み合わせる実験」と呼び、「コンパイラの診断、静的解析ツール、リポジトリのインデックス作成、生成された説明はまだ統合していない」と述べている。
この設計で真似する価値がある点は2つある。オーケストレーションはコード側に置き、Jevには境界の定まった問いにだけ答えさせること。そして作業を段階に分け、diff全体に対して1つの巨大な問いを投げるのではなく、まず領域を選び、それからスコアリングすることだ。JevはVercel AI Gatewayでもtypesafe-ai/jevとして、AI SDK 7のexperimental_evaluate経由で利用できる。Gatewayのドキュメントによれば、これはAI SDK経由でのみ利用可能だ。
Sharklyとの関係
Sharklyがあなたに代わってJevを呼び出すことはなく、Sharkly自体は意思決定モデルではない。Sharklyは、チームがすでに動かしているコーディングエージェントを取り巻く、共有タスク、Computer、コンテキスト、レビューのレイヤーだ。順位付けされたキューがこのレイヤーに求めるのは、実行する場所と結果が着地する場所である。
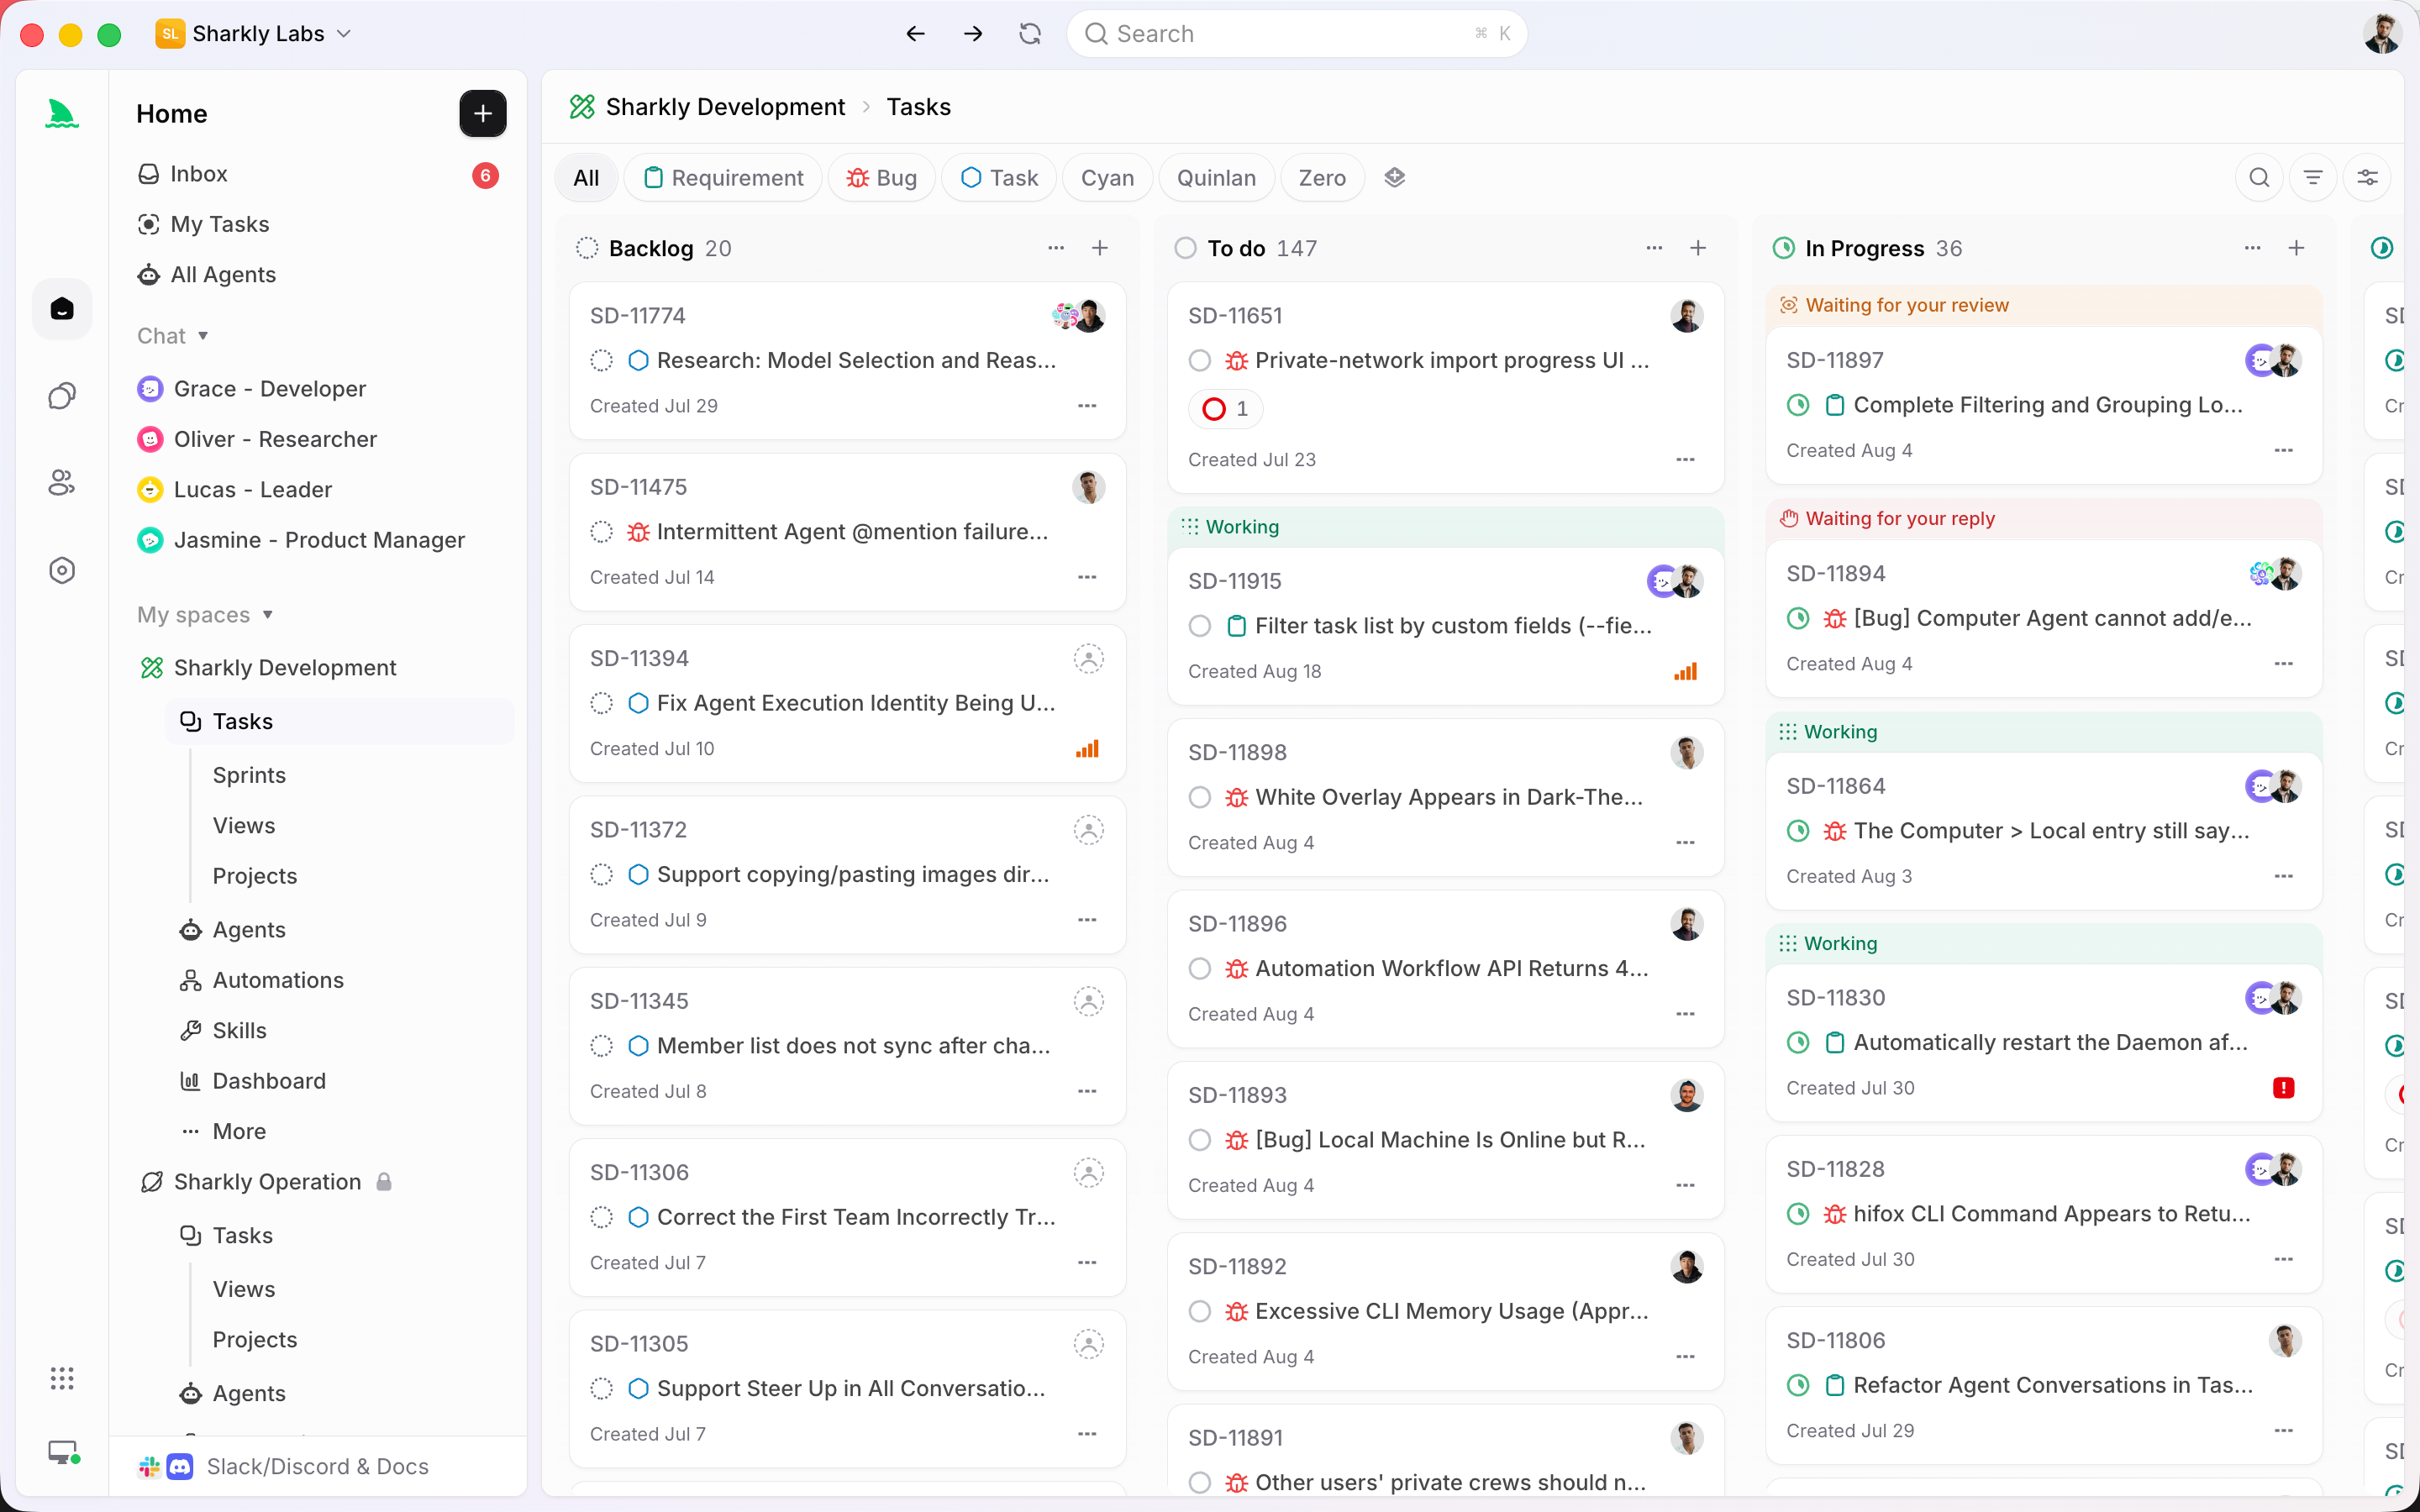
実行する場所はオートメーションだ。これはSpaceが所有するルールで、トリガーに応じて一連の指示とともにエージェントを起動する。トリガーの1つは、タスクが指定したステータスに移動すること。これを、PRが開いたときにエージェントが到達するステータスに設定すれば、指示はこうなる。タスクのdiff要約、テスト結果、触れたパスを読み、3つの問いでJevを呼び出し、回答とバンドをタスクへのコメントとして書き戻し、キューのラベルを設定する。ドキュメントは、実行が完了しても「下流のビジネス上の成果がすべて正しかったことを約束するものではない」と明記している。これはレビューのバンドが引く境界と同じだ。
着地する場所はタスクそのものだ。バンド、キュー、リスクスコアは、レビュアーがすでに見ているタスクに戻ってくる。実行の変更サマリーと検証結果の隣だ。人はリスクでソートされたボードを開き、各PRがなぜその位置にあるのかを確認できる。エージェントはプルリクエストを開き、テストを実行し、報告する。人はキューが示す順番で読み、承認するか却下するかする。順番は確率から生まれたが、判断はそうではない。
すでに複数のエージェントを動かしていて、レビューキューが痛手になっているなら、それはSharklyをはじめようが用意するワークフローだ。1つのComputer、1つのエージェント、そして順位付けに必要なエビデンスを備えた1つのタスク。
よくある質問
Jevは要約ではなくdiff全体を読めるか?
状態として最大32kトークンまで受け取れるので、小さなdiffなら収まる。それでも要約を送るべきだ。エージェントのdiffはあっという間に予算を超えるし、要約にしておけば問いをルーティングのレベルに保てる。完全なdiffは人が読むもので、その横にはタスクレベルのエビデンスが並ぶ。
エージェント自身がdiffの要約を書いた場合は?
その場合、要約がエージェントに都合よく誤っている可能性があり、順位付けはその影響を受ける。別のステップでdiffから生成した要約を使うのが望ましく、また最上位のriskスコアには常に低いneeds_humanを上書きさせるべきだ。ここではAIコードレビューの限界が当てはまる。モデルは提示されたものを順位付けできるが、提示されていないものを検証することはできない。
低いバンドはPRが自動でマージされることを意味するか?
いいえ。低いバンドは、人がキューで先に読むことなく、自分のタイミングで後からマージするという意味だ。マージのオーナーシップ、そしてエージェントが生み出した作業のオーナーシップは、どのバンドでも名指しされた人に残る。
Sharkly経由でJevは無料か?
SharklyはJevやその他のモデルを再販していない。TypeSafeまたはGatewayのキーはご自身で用意する。実行がランタイムに紐づいたサブスクリプションに対して課金されるのと同じ仕組みだ。Sharkly自体は現在、5人までの組織であれば無料で利用できる。


