
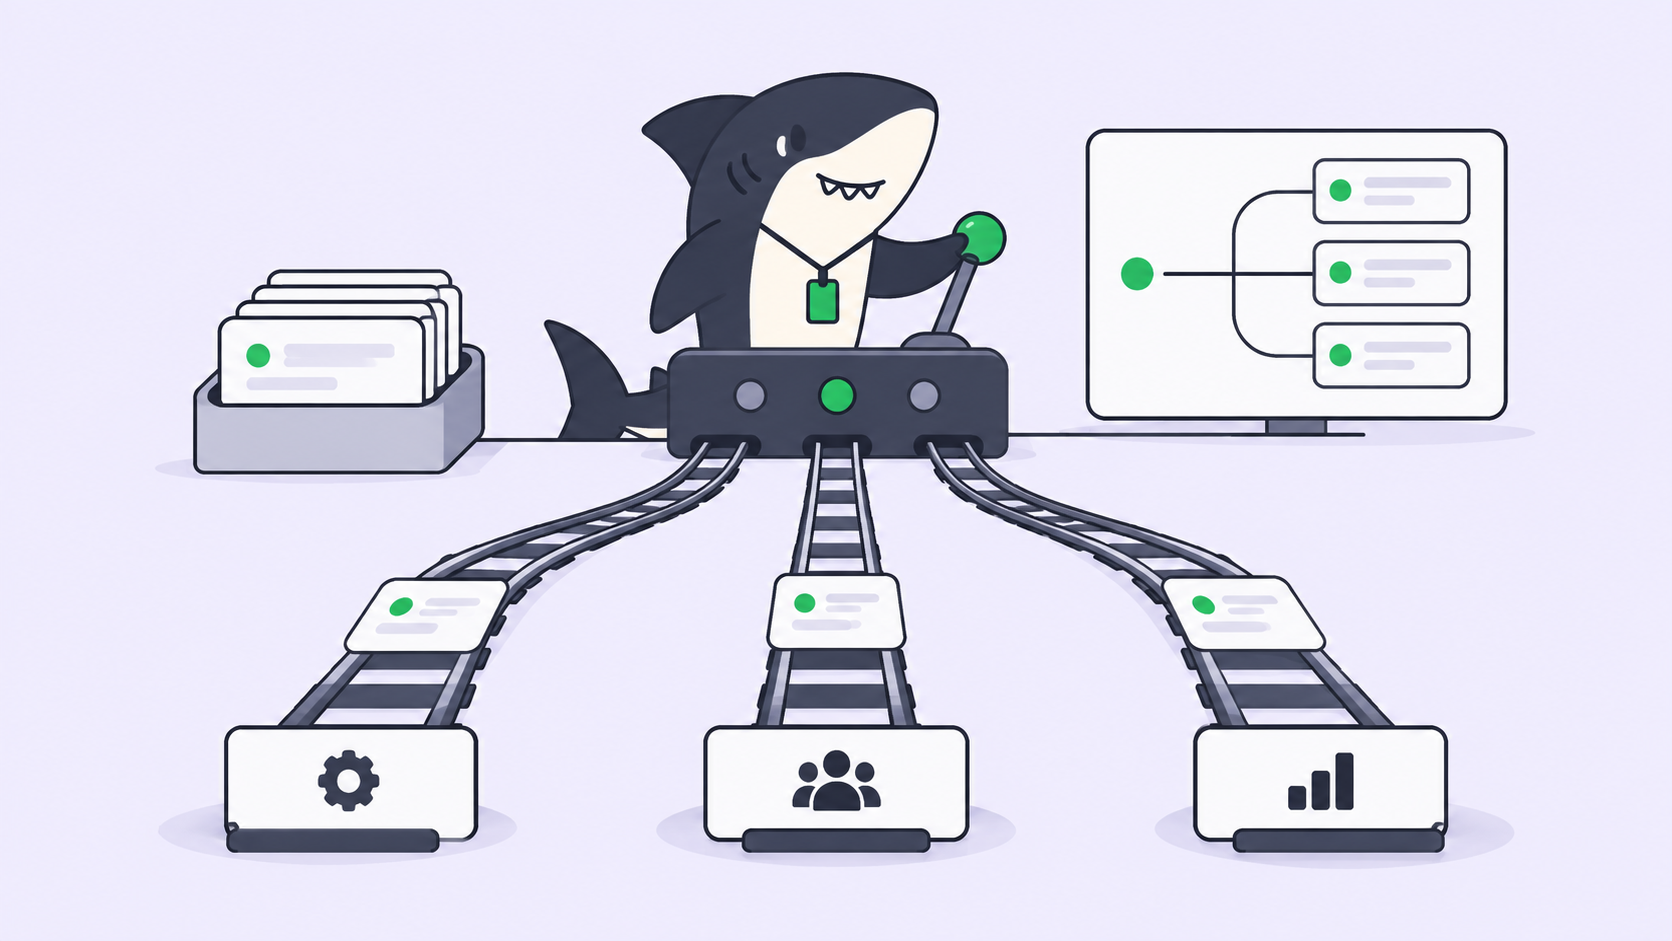
あなたのチームはすでにモデル間で作業を振り分けている。ただ、それは各人の頭の中で行われているだけだ。あるエンジニアは失敗が少ないという理由で、すべてを高価なティアで実行している。別のエンジニアは先月、安価なティアに切り替えて、誰にも言わなかった。三人目はインストール時にツールのデフォルトだったものを使い続けている。一人が一つのエージェントを動かしているうちは、それでも何とかなる。しかし、5つのAgentが並行して実行されるようになった瞬間、それは破綻する——ドキュメント文字列のために必要の40倍を費やしているのはどれなのか、そもそも耐えられない仕事を静かに失敗させているのはどれなのか、誰も言えなくなるからだ。
2026年9月22日、ティア間の差は無視できないほどに広がった。AnthropicはClaude Opus 5.5を出荷した。OpenAIはGPT-6 SolとGPT-6 Lunaを出荷した。この三つのうち最も安いものと最も高いものの差は、入力トークンで40倍であり、しかもそのどれもが本物のTaskを任せるのに十分な性能を持っている。
ルーティングルールは好みではなく、明文化された取り決めである
ルーティングルールとは、どのクラスのTaskをどのRuntimeで実行するかを明文化したものであり、たまたまその実行を開始した人ではなく、作業を実行するAgentに紐づけられる。
これが核心であり、重要なのは「明文化された」という部分だ。好みは一人のターミナルの中に存在し、その人が休暇を取った時点で失効する。ルールはAgentのそばに存在するため、Taskを引き継いだAssigneeはそれを継承し、レビュアーは自分が読んでいるdiffをどのティアが生成したかを確認でき、次の四半期に方針を変えるのは六つの会話ではなく一つの編集で済む。
ルーティングルールはモデルのランキングではない。どのモデルが優れているかを主張せず、そうする必要もない。それぞれの種類の作業がデフォルトでどこへ行くのか、そしてそのデフォルトが間違っていたと判明したときに何が起きるのかを定めるものだ。
三つのティアのコスト
| Claude Opus 5.5 | GPT-6 Sol | GPT-6 Luna | |
|---|---|---|---|
| API id | claude-opus-5-5 |
gpt-6-sol |
gpt-6-luna |
| 入力 / 出力 100万トークンあたり | $4 / $20 | $2 / $10 | $0.10 / $0.50 |
| キャッシュ入力 | 読み取り $0.20、書き込み $5 | 読み取り 90% オフ | 読み取り 90% オフ |
| コンテキスト | 1M | 872k | 1M |
参考までに:Claude Opus 5は$5 / $25、GPT-6 Astraは$10 / $50である。OpenAIはSolとLunaについて、GPT-5.6のプロモーション価格より50%安いと説明している。「プロモーション」という言葉はOpenAI自身が使ったもので、これが意味を変える:その見出しの基準は定価ではなく割引価格だ。またOpenAIは、Astraは「あらゆる面で引き続き当社の最高モデルである」とも述べており、これはSolがある意味で自社ファミリー内のバリューティアであり、フラッグシップではないことを思い出させてくれる。
ルールにティアを書き込む前に、実用的な確認を一つ。OpenAIはSolとLunaをChatGPT WorkおよびCodexのPlus、Pro、Business、Enterprise、Eduで提供し、FreeとGoにはデスクトップアプリでLunaを提供すると述べており、どちらもChatにはまだ入っていないとしている。可用性は価格と同じくらいルーティングルールを左右する。なぜなら、Crewの半分がアクセスできないティアはティアではないからだ。
トークン単価ではなく、完了したタスクあたりのコストで振り分ける
トークン単価は、実際に支払う金額の代理指標にすぎない。単価が五分の一でも、4回の試行と人間による救助を要するモデルは安くはない。OpenAIはこのローンチに合わせてスコアと並んでタスクあたりのコストを公表しており、これは異例なほど直接的で、ルーティング判断にとって正しい形の証拠である。
| ベンチマーク(OpenAIの公表どおり) | 結果 | タスクあたりコスト(相対) |
|---|---|---|
| AutomationBench 1.0.6、Solをextra-highで | 33.2% | タスクあたり$0.27 |
| AutomationBench 1.0.6、GPT-6 Astraをlowで | 30.3% | Solの3.9倍 |
| AutomationBench 1.0.6、Claude Opus 5をmaxで | 26.9% | Solの11.1倍 |
| AutomationBench 1.0.6、Fable 5.1とOpus 5フォールバックをmaxで | 31.4% | Solの8.9倍超 |
| Agents’ Last Exam V1、Solをmaxで | 56.4%、Opus 5の最高スコアを上回る | Opus 5より60%低い |
| OSWorld 2.0 オフライン、Solをextra-highで | 60.5%、Opus 5のmediumでの60.3%に対して | 約80%安い |
| DeepSWE 1.1、Lunaをmaxで | 66.6% | Opus 5より93%安い |
| DeepSWE 1.1、Solをmaxで | 68.8%、Fable 5のextra-highでのスコアと1.1pp差以内 | 約80%安い |
この表については、二つのことが同時に当てはまる。差は大きく、そしてそれはClaude Opus 5を基準に測定されたものであって、Opus 5.5ではない——Opus 5.5はOpenAIの記事が書かれた時点では存在せず、その数時間後に、Anthropic自身の説明によればOpus 5より実行コストが40%低い状態で出荷された。この比較をやり直した者はいない。各行は最後に公表された数値として扱い、そこから示唆されるランキングは自社リポジトリで検証すべき仮説として扱うべきだ。
その留保を生き延びるのは「形」であり、まさにその形こそがルーティングルールに必要なものだ。安価なティアは、限定的で反復可能な作業において、ごくわずかなコストで十分に健闘する。AnthropicのOpus 5.5に関する主張は、タスクあたりの価格についてはまったく触れていない:Opus 5より実行コストが40%低く、出力は約30%高速で、最大出力は128k、そして18時間以上タスクに留まり続ける。これらは、長く厄介な作業に向けるモデルを描写しており、百件の小さなジョブに向けるモデルではない。
ルールを書き出す
これが成果物だ。意図的に退屈に作られており、チームが読む場所に置かれるべきものであって、誰か一人のノートPC上のプライベートな設定ファイルに置くものではない。
ROUTING RULE  (owner: platform, review: end of Sprint)

Tier 1  Runtime: Codex on gpt-6-luna
  Triage, labelling, changelog and release notes, first-pass review
  comments, test scaffolding, dependency bumps, doc edits.
  Rule of thumb: if a wrong answer costs a reviewer one minute, route here.

Tier 2  Runtime: Codex on gpt-6-sol           <- default
  Bounded feature work, bug fixes with a reproduction, refactors inside
  one module, anything repeated many times a day and cheap to retry.

Tier 3  Runtime: Claude Code on claude-opus-5-5
  Migrations, cross-cutting refactors, work that must hold context for
  hours, anything where stopping halfway costs more than the tokens.

ESCALATION
  A Tier 1 or Tier 2 Task that fails twice returns to the Task with its
  log and does NOT silently re-run on Tier 3. A person moves it.

EXCEPTIONS
  Named on the Task, with a reason, by the Assignee. Not in a DM.
実質的な仕事をしているのは三行だ。デフォルトのティアが名指しされているため、誰も深く考えなかったTaskもどこか妥当な場所に落ち着く。エスカレーションが明示されているため、安価な失敗が気づかれないまま高価な失敗へと連鎖することはない。例外はTask上に記録される——これがルールと提案の違いだ。
エスカレーションはチームが飛ばしがちな半分である
上記の表の節約は、1回の試行あたりでは確かに本物だ。しかし、安価な試行が日常的に「高価な再試行+人間による救助」になってしまえば、それらは消え去る。両方の実行と、その割り込みの分を支払うことになるからだ。これは自動フォールバックチェーンの典型的な失敗モードだ:安価なティアのコストを高価なティアの請求書の中に隠してしまい、誰もその交換レートを見られなくなる。
だから、エスカレーションは手動かつ可視的にしよう。失敗した実行は、そのログ、そこまでのdiff、そして引っかかった疑問点とともにTaskに戻ってくる。人間が、それを一つ上のティアに再ルーティングするか、分割するか、明確化するかを判断する。Agentは調査し、実行し、テストし、報告する。人は方向性を定め、権限を与え、結果を受け入れる。もしエスカレーション経路が再試行ループになっているなら、本来人間が必要だったまさにその判断を自動化してしまっている。
レイテンシに敏感な作業を下位ティアに振り分ける前に、もう一つ注目に値することがある。どちらのベンダーでもない第三者であるArtificial Analysisは、「max」推論バリアントを計測し、Solで毎秒115.2出力トークン、初回トークンまで102.15秒、Lunaで毎秒153.9トークン、初回トークンまで124.23秒だったと報告している。これらに依拠する前に、現在のリスティングで確認されたい。[要確認]大事なのはその形だ:最大推論努力の状態では、安価なモデルは起動が速いモデルではない。そして、百秒間考え込んでいるAgentは、ハングしたAgentとまったく同じに見える。どのティアに振り分けるにせよ、Runtimeが進捗と失敗をどう通知するかが、誰かがその違いに気づくかどうかを決める。
ルーティングルールを書くべきでない場合
一つのリポジトリで一つのエージェントしか動かしていないなら、こうしたことは一切やらなくていい。自分の作業に合ったティアを選んで先に進めばよい。ルーティングは、維持すべき文書と話し合うべき議論を要し、複数のAgentが同時に動き、そのコストや失敗パターンが異なるときに初めて元が取れる。
おおよその閾値はこうだ:二人以上が実行を開始できるとき、あるいは一つの予算が複数の同時実行Agentをカバーするときに、ルールを書く。それ以下では、ルールはオーバーヘッドでしかない。それ以上では、ルールの不在こそが、先月の請求書を誰も説明できない理由になる。
動かない数字
完了したタスクあたりのコストは、今回のローンチの両サイドで大きく下落した。規模感として、OpenAIはコーディングエージェントに費やす研究員の中央値が1日$600超、90パーセンタイルが$7,000だと報告している。この線より下のチームは、同じ予算で数倍多くの完了したエージェント作業を手に入れたことになる。これは請求書単位ではなくRuntime単位で追跡する価値がある。
しかしレビュアーの工数は一切増えていない。ルーティングはコストのレバーであり信頼性のレバーだが、スループットのレバーではない。なぜなら人間が受け入れるのを待つ作業の行列は変わらないからだ。ルーティングにできるのは、その行列を見えるようにすることだ:このdiffを生成したのはどのティアか、いくらかかったか、何回試行したか、そして二度失敗したTaskが誰かのInboxに居座っているのか、それともどこにもないのか。目標、実行、コスト、ブロッカー、レビューを、要求からリリースまでTask上に保っておけば、ルーティングルールは、六人が内々に抱える習慣ではなく、チームが編集する設定になる。
Sharklyはモデルを実行しないし、あなたの代わりに選びもしない。Sharklyはそれを実行するツール群を取り巻く、共有されたTask、Computer、コンテキスト、レビューのレイヤーであり、ルーティングルールがそれを書いた人より長く生き残るためには、まさにそこに存在しなければならない。すでに複数のコーディングエージェントを動かしているなら、どのモデルがどのタスクを担うかとどのエージェントがそれを担うかは、同じ判断を二つの側面から見たものだ。一つのComputerを接続し、ティアごとに一つのAgentを作成し、安価な方に退屈な仕事を一つ任せてみよう。


