
Metaが公開したMuse Wonderのリリース告知記事では、「Active Focus」と呼ばれる振る舞いが紹介されています。これは、モデルが困難な目標に向かって粘り強く取り組み、別のアプローチを試し、障害を自力で突破しつつ、Metaの表現を借りれば「必要に応じて確認を求め、重要なアクションの前にチェックイン(事前確認)を行う」というものです。またMetaは、影響の大きいアクションを実行する前に人間による承認を挟むことを推奨しており、同社のコーディングエージェントガイドでは、初回実行時から承認機能とサンドボックスが有効になった状態でMuse Codeが提供されています。
これは極めて理にかなった設計です。しかし同時に、複数のエージェントを並行稼働させているチームなら誰もが直面する疑問も生じさせます。「モデルが手を止めて確認を求めてきたとき、誰が、どれくらい迅速に、どのようなコンテキストを持って応答するのか?」という点です。誰も見ていないターミナルに出力されたチェックインは、プロセスの停滞でしかありません。一方、元のタスクに紐づいた状態で共有の受信トレイ(Inbox)に届くチェックインは、適切なレビューステップとして機能します。本記事では、後者のような仕組みをどう構築するかについて解説します。
Active Focusがもたらすもの
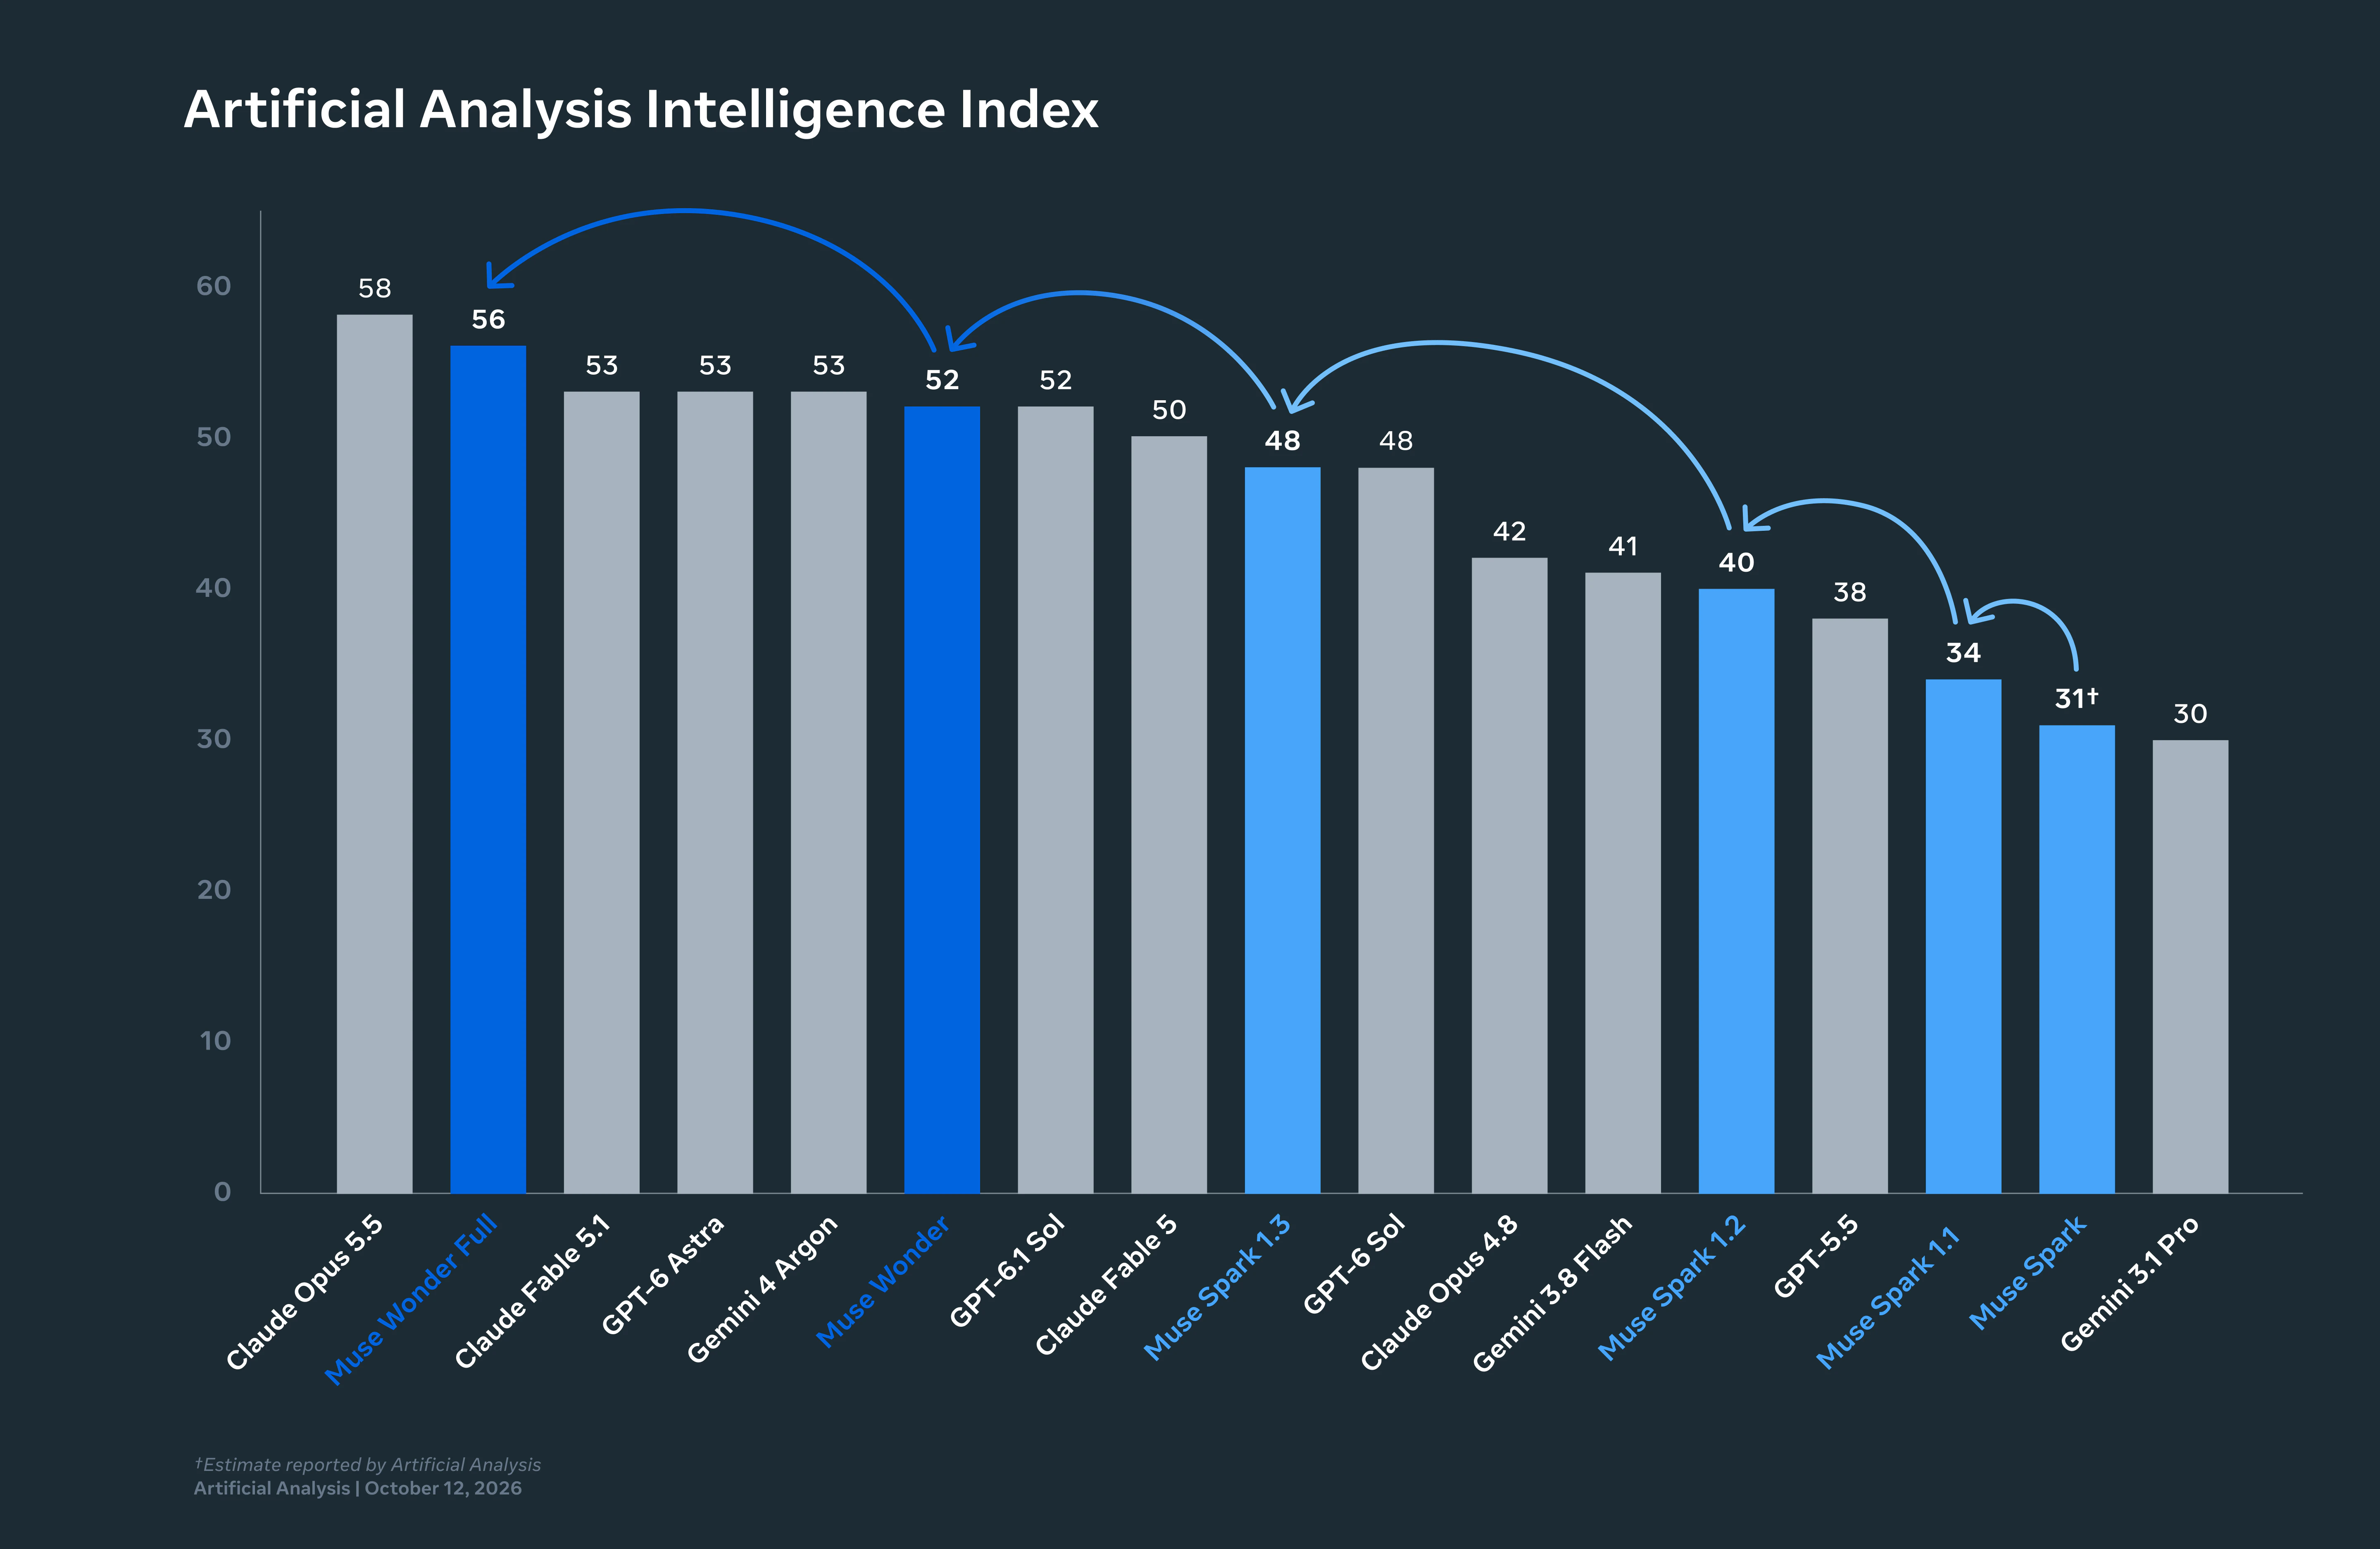
Metaは3つの振る舞いをターゲットにトレーニングを行い、独自の社内ベンチマーク「FocusBench」で評価しています。FocusBenchではMuse Wonder Fullが54.2%でトップに立ち、API提供版のWonderは44.9%で、GPT-6 AstraやClaude Opus 5.5に続くスコアとなっています。ただしスコアそのものはさておき、タスク管理ボード上で重要になるのはその振る舞いの中身です。
- 粘り強さ(Persistence):失敗しても諦めずに処理を続行します。長時間のコーディングベンチマークであるSWE-Marathonにおいて、WonderはOpus 5.5の46.3に対して53.1というスコアを記録しました。実行時間が延び、試行回数が増えるということは、それだけレビューすべき対象も増えることを意味します。
- 明確化の要求(Clarification):タスクの指示が曖昧な場合、推測で進めるのではなく質問します。タスク管理ボード上ではタスクへのコメントとして現れますが、ターミナルではキー入力を待つプロンプトとなります。
- チェックイン(Check-ins):重要だと判断したアクションの直前で一時停止します。Meta自身のガイドラインでも、重大な影響を及ぼす可能性のある処理には人間による確認を義務付けるよう推奨されています。
これらの振る舞いは、それぞれレビューキューのあり方を変化させます。「粘り強さ」はタスクあたりの確認量を増やし、「明確化」は割り込みを発生させ、「チェックイン」は誰かが判断を下すまで実行をブロックする意思決定ポイントを生み出します。
チェックインがどこに届くのか
Muse Codeでは、サブスクライバーのターミナルに承認プロンプトが表示され、処理が一時停止します。ヘッドレス実行(muse exec)には対話型プロンプトが存在しないため、Metaのドキュメントには、無人でも完了できるポリシーを選択するか、保留されたアクションが未解決のまま残ることを想定しておくよう記載されています。これは率直なトレードオフと言えます。人間がキーボードの前に常駐するか、承認を無効にしてモデルを動かすか、あるいはアクションが永遠に待たされ続けるかのいずれかです。
Sharklyのボード上では、実行プロセスはコンピューター(Computer)上のエージェント(Agent)に割り当てられたタスク(Task)として扱われます。エージェントが手を止めて質問を投げかけると、その質問はタスクへのコメントとして反映され、受信トレイ(Inbox)へとルーティングされます。このタスクには、何が尋ねられたのか、エージェントがこれまでに何を実行したのか、ツール呼び出しやRuntimeイベントの実行ログといったコンテキストがすべて保持されています。対応可能な担当者がタスク上で回答すれば、エージェントは中断した箇所から処理を再開できます。チェックインが人間による意思決定であることに変わりはありませんが、記録が残り、キューで管理され、複数人の誰でも対応できる意思決定へと変わるのです。
これこそが、「安全対策(セーフガード)」として機能するか「作業の停滞(ストール)」に終わるかの違いです。モデル自体の振る舞いは同じでも、それを取り巻くシステムによって、1回のチェックインにかかる時間が1分で済むのか、丸1日無駄になるのかが決まります。
実用的なチェックインを行わせるためのエージェント設計
チェックインの価値は、投げかけられる問いの質で決まります。適切なチェックインを行わせるための基準を、エージェントのプロンプト(指示文)に明記しておきましょう。
Stop and ask before anything destructive, anything that sends data outside the
attached repositories, any payment or external account action, and any change
to CI, deploy or access configuration.
When you ask, state in one comment: what you are about to do, why the Task needs
it, what you considered instead, and what happens if the answer is no.
Do not ask about reversible edits inside the repository. Make them, test them,
and report.
If you have waited for an answer and the Task has a deadline, say so in a second
comment rather than proceeding.
1つ目のルールは境界線を明確にします。Metaのモデルは重要度を自己判断しますが、指示を与えることでチームとして何を重視するのかを定義できます。2つ目のルールにより、実行ログを最初から追っていなかった人でも、30秒で回答できるコメントが生成されます。3つ目のルールは、モデルが些細なことまで手当たり次第に質問するのを防ぎます。何でも質問してしまうのは、「慎重なエージェント」が「煩わしいエージェント」に成り下がってしまう典型的な失敗パターンです。Opus 5.5のガードレールに関する記事でも、プロンプトインジェクションの観点から同様の境界線について解説しています。モデルが何を約束しようと、実質的な制御権を持つのはレビューゲートなのです。
キューの規模を見積もる
粘り強さが増すということは、タスクあたりのレビュー負担が減るのではなく、むしろ増えることを意味します。あらかじめその前提で計画を立てておく必要があります。
| レーン | 典型的な実行パターン | キューに届く内容 |
|---|---|---|
| 長時間タスクにおけるMuse Wonder | 多数のステップ、複数回のアプローチ巻き戻し | 長大な差分、膨大なログ、0〜3回のチェックイン |
| 同一タスクにおけるOpus 5.5 | より少ないステップ、高い決断力 | 短い差分、または中途半端な状態で返却されたタスク |
| 夜間の無人実行(任意のモデル) | 設定されたポリシーで許可された範囲の処理 | 保留されたアクション、または誰も確認しなかったアクション |
キューの滞留を防ぎ、スムーズに循環させるためのプラクティスが3つあります。1つ目は、チェックインの通知をチーム全体ではなくレーンごとの指名レビュアーにルーティングし、グループ内で放置されるのを防ぐこと。2つ目は、エージェントのタスクごとのタイムアウトを設定し、チェックイン待ちでブロックされた実行が何時間も「実行中」のまま放置されず、明確に失敗(タイムアウト)として検知できるようにすること。3つ目は、Wonderの実行結果を確認する際、コード差分(diff)だけでなくログにも目を通すことです。3つの失敗したアプローチを経て辿り着いたプロセスこそが粘り強いモデル特有の付加価値であり、同時に見落としがちな微妙なバグが潜む場所でもあります。夜間実行のケースについては「不在時のコーディングエージェント運用」で、またモデルが高性能になってもレビューコストが下がらない理由については「ボトルネックは人間によるレビューにある」で詳しく解説しています。
ボード上での理想的なチェックインの例
上記の指示文によって生成される、レビュアーがスマートフォンからでも即座に判断を下せるタスクコメントの例がこちらです。
Check-in before action.
About to: drop the legacy `orders_v1` table in the migration.
Why: the Task says remove v1 read paths; the table is the last reference.
Considered: keeping the table and removing only the code. Rejected because
the nightly job still writes to it and would fail silently.
If no: I will leave the table, remove the code paths, and note the job in
the report for a follow-up Task.
わずか4行で、下すべき判断は1つ、そして承認・却下いずれの分岐の対応もすでに計画されています。レビュアーがタスク上で「yes」あるいは「no, keep it」と入力するだけで処理が再開され、誰が決断したかがログに記録されます。直前の40ステップを見ていなかった人に対してAllow? [y/N]とだけ突きつけてくるターミナルプロンプトと比べれば、その差は歴然です。
レーンを1週間ほど運用した後に適用すべき改善点が2つあります。1つは、特定のレビュアーにチェックインの回答が集中している場合、そのレーンのエージェントに2人目の指名レビュアーを追加して、午後のミーティングで長時間の実行がすべて停止してしまうのを防ぐことです。もう1つは、エージェントが同じ種類のアクションについて何度も質問してくる場合、そのアクションを毎回キューに送るのではなく、プロンプトの指示内で「常時許可(yes)」または「常時禁止(no)」としてルール化することです。
Computer Use(PC操作)の場合
MetaはWonderの機能の1つとして、ブラウザ、デスクトップ、モバイルアプリを操作する「Computer Use」を挙げています。これこそがチェックインが最も重要であり、ターミナルプロンプトが最も役に立たない領域です。なぜなら、そのアクションはレビュアーの目に見えない画面上の「クリック」だからです。AstraのComputer Useに関する記事で挙げた原則がここでも当てはまります。すなわち、チームが指定した環境(Computer)上でエージェントを動かし、チェックイン時に画面名とアクションを明記させ、確認する人間がタスクの実行ログを把握した上で承認できるようにすることです。「Submit」ボタンを押す許可を求めてくるモデルであっても、その「Submit」が何をもたらすかを把握できなければ、安全とは言えません。
誤解してはならないこと
Active Focusはあくまでモデルの振る舞い(ビヘイビア)であり、安全を保証するものではありません。Meta自身のモデルカードにも、不慣れなマルチステップタスクにおいてモデルが誤りを犯す可能性があると記されており、完全な安全性レポートはまだ公開されていません。チェックインは優れたレビューシステムをさらに強化するための機能であり、レビューシステムそのものを代替するものではないのです。「重要なアクションの前にチェックインを行う」という記述を、完全無人で運用してよい免罪符だと受け取るのは誤解です。すべてのチェックインにタスク、レビュアー、そしてタイムアウトを割り当てるチームこそが、この機能が本来意図していたシステムを構築できていると言えます。
これらの一連の処理によってSharklyの請求額が加算されることはありません。モデルの利用料金は、コンピューター上に設定されたMetaのAPIキーを通じて直接課金されます。モデルは10月12日に刷新されましたが、リクエストからリリースに至るまでのコンテキスト、進捗、障害、成果物、そして人間によるレビューの可視性は一貫して保たれています。この仕組みはGitのworktree等を使って自前で構築することもできますし、Sharklyを導入してワークフロー全体を効率的に管理することも可能です。


