
Metaは10月12日、Muse Wonderの提供を開始しました。価格は入力100万トークンあたり4ドル、出力100万トークンあたり20ドルで、100万トークンのコンテキストウィンドウに対応し、OpenAI Responses、Chat Completions、Anthropic Messagesという3種類の仕様(ダイアレクト)に対応したAPIを備えています。この最後の仕様こそが、現時点でSharklyのボードから利用できる決め手となっています。Metaのcoding-agents guideには、CodexやClaude Codeのエンドポイントをapi.meta.aiに設定してmuse-wonder-1.0上で動かす手順が記載されており、これらはどちらもSharklyのComputerで公開できるRuntimeです。なお、Metaが主要なベンチマークでアピールしているモデル「Muse Wonder Full」はAPI経由では提供されておらず、Runtimeのモデルとして利用することはできません(詳細は後述します)。
本ガイドでは、Codex Runtimeを使用して既存のSharkly Computer上にMuse Wonder用のレーンを設定し、どのレーンにTaskが割り当てられたかをボード上で判別できるようにAgentにモデル名を明記します。また、MetaやArtificial Analysisによる検証データが示す、このモデルの最大の強みである「長時間の自律エージェントタスク(long agentic runs)」に合わせたタスクの切り出し方についても解説します。
要約(TL;DR)
Computer上の~/.codex/config.tomlでMeta向けのCodexプロバイダーを設定し、model = "muse-wonder-1.0"、wire_api = "responses"を指定して、ローカルサービスの環境変数MODEL_API_KEYからキーを読み込むようにします。Codex Runtimeのステータスが「Available」になるまで再スキャンを実行してください。そのRuntime上にAgentを作成し、Custom argumentsでモデルを指定した上で、多段階にわたるリファクタリング、マイグレーション、レビューと修正の反復ループといった長時間のTaskを割り当てます。知識集約型やターミナル操作主体の作業は、引き続きOpus 5.5やAstraのAgentに任せましょう。Agentは調査、実行、テスト、レポートを行い、Taskがその結果を保持します。
モデル設定の管理場所
Sharkly自体がモデルを選択することはありません。Agentのドキュメントに記載されているとおり、AgentはRuntimeのデフォルトモデルに従い、モデル名は表示されません。モデルを変更するには、AgentまたはRuntimeのCustom arguments(例:specify model: model-name)で指定する必要があります。Sharkly側でRuntimeがどのモデルを使用したかを確実に判別できないため、モデルのドロップダウンメニューや思考深度(thinking-depth)の調整機能は用意されていません。
Metaのモデルを利用する場合、設定は2つのレイヤーに分かれます。Runtimeがapi.meta.aiとそのキーを参照するためのプロバイダー設定は、Computer上のRuntime固有の設定ファイルに記述します。一方、使用するモデルの選択はAgent側で設定します。これにより、1台のComputer上で異なるRuntimeを介してMuse Wonder AgentとOpus 5.5 Agentを共存させることができ、レビュー担当者からも使用モデルが明確に把握できるようになります。
ステップ1:Computer上のCodexにMetaプロバイダーを設定する
MetaのガイドにCodexの設定内容が記載されています。Computer上の~/.codex/config.tomlに以下を設定します。
model = "muse-wonder-1.0"
model_provider = "meta"
model_reasoning_effort = "high"
model_context_window = 1048576

[model_providers.meta]
name = "Meta Model API"
base_url = "https://api.meta.ai/v1"
env_key = "MODEL_API_KEY"
wire_api = "responses"
Metaから2点注意点があります。まず、Codexで事前にOpenAIからログアウトしておいてください。そうしないとOpenAIプロバイダーが使われ続けてしまいます。また、wire_api = "responses"の指定も重要です。Responses APIは複数ターンにわたって推論コンテキストを引き継ぐため、長時間の処理でも一貫性を維持できます。
APIキーは、Codexを起動するプロセスの環境変数に設定します。Sharkly Computerの場合はローカルサービスがこれに該当します。このサービスが環境変数を読み込む場所にMODEL_API_KEYを設定し、サービスを再起動してください。キーをSharklyの管理画面上に入力してはいけません。Computerのドキュメントでも明記されているように、パスワード、トークン、APIキーをRuntimeの実行可能ファイル(executable)、引数(arguments)、環境変数(environment)フィールドに配置することは禁止されています。これらのフィールドはデフォルト設定のためのものであり、機密情報を保持する場所ではありません。
ボードを操作する前に、該当ホストの標準ターミナルでテストを実行します。
codex "Say which model you are and stop."
Codexがmuse-wonder-1.0からの応答を返せば、Sharklyから利用できる状態です。Computerの詳細画面を開き、再スキャンまたは接続テストを実行してください。Codex Runtimeのステータスが「Available」になれば完了です。Computerが「online」と表示されていても、それはローカルサービスからハートビートが届いていることを示しているに過ぎず、タスクの実行を開始できるかどうかはRuntimeのステータスで判断されます。
RuntimeとしてClaude Codeを使用したい場合、Metaのガイドに従ってモデルスロットをマッピングします。ANTHROPIC_BASE_URL="https://api.meta.ai"、ANTHROPIC_AUTH_TOKEN="$MODEL_API_KEY"、ANTHROPIC_MODEL="muse-wonder-1.0"を設定し、OpusスロットをWonderに、SonnetおよびHaikuスロットとCLAUDE_CODE_SUBAGENT_MODELをmuse-spark-1.3に割り当てます。また、MCPツールが引き続き読み込まれるようにENABLE_TOOL_SEARCH="true"を指定します。すべてのスロットにMetaのモデルを割り当てておかないと、Plan ModeやサブエージェントがMeta側で提供されていないClaudeモデルを呼び出そうとしてしまいます。ここでも同じルールが適用されます。APIキーはSharklyの入力フィールドではなく、必ずホストの環境変数に設定してください。
ステップ2:自身が使用しているモデルを明記するAgentを作成する
「Agents」画面を開き、「New Agent」を選択して、先ほどのComputerとCodex Runtimeを指定します。Agentの名前には「Muse」のようなモデル名ではなく、レーンの役割を表す「Long-run worker」といった名前を付けます。Custom argumentsには、テストで確認したものと同じモデル名muse-wonder-1.0を指定します。各Taskが隔離された環境で実行されるよう、作業ディレクトリ(working directory)には「Create temporary directory」を設定し、タスクごとのタイムアウトは通常の安価なレーンよりも長めに設定しておきます。長時間粘り強くタスクを継続できることこそがMetaによるこのモデルの最大のアピールポイントであり、SWE-Marathonベンチマークでもまさにその点が評価されています。
SharklyのUI上には使用モデルが表示されないため、Agentへの指示(instructions)でモデル名を明記させるようにします。
You are the long-run lane. State the model id you ran on at the top of your report.
Take the Task as written. Plan before you edit, and keep a running list of what
you tried and why, so a reviewer can follow the path, not only the diff.
Run the closest relevant check before reporting done. Report failures as failures.
If you need a fact you are not sure of, look it up in the repository or say you
could not confirm it. Do not fill gaps from memory.
Stop and ask before anything destructive, anything that sends data outside the
attached repositories, or any action you would want a person to confirm.
4つ目の指示項目を設けているのには理由があります。Artificial Analysisのナレッジ指標において、Opus 5.5のスコアが46であるのに対し、Wonderは25にとどまり、ハルシネーション率は27%に達しています。このモデルは実務作業に長けている反面、百科事典的な知識力には欠けています。上記の指示は、実務作業に専念するよう役割を明確にするためのものです。
ステップ3:長時間のTaskをこのレーンにルーティングする
Metaのモデルカードおよび外部による独自検証からわかる、このレーンに適した作業領域は以下のとおりです。
| 評価指標 | Muse Wonder | Claude Opus 5.5 |
|---|---|---|
| SWE-Marathon(長時間コーディング) | 53.1 | 46.3 |
| DeepSWE 1.1 | 78.8 | 74.2 |
| Terminal-Bench 4.0 | 52.0 | 59.6 |
| AA-Omniscience(知識) | 25 | 46 |
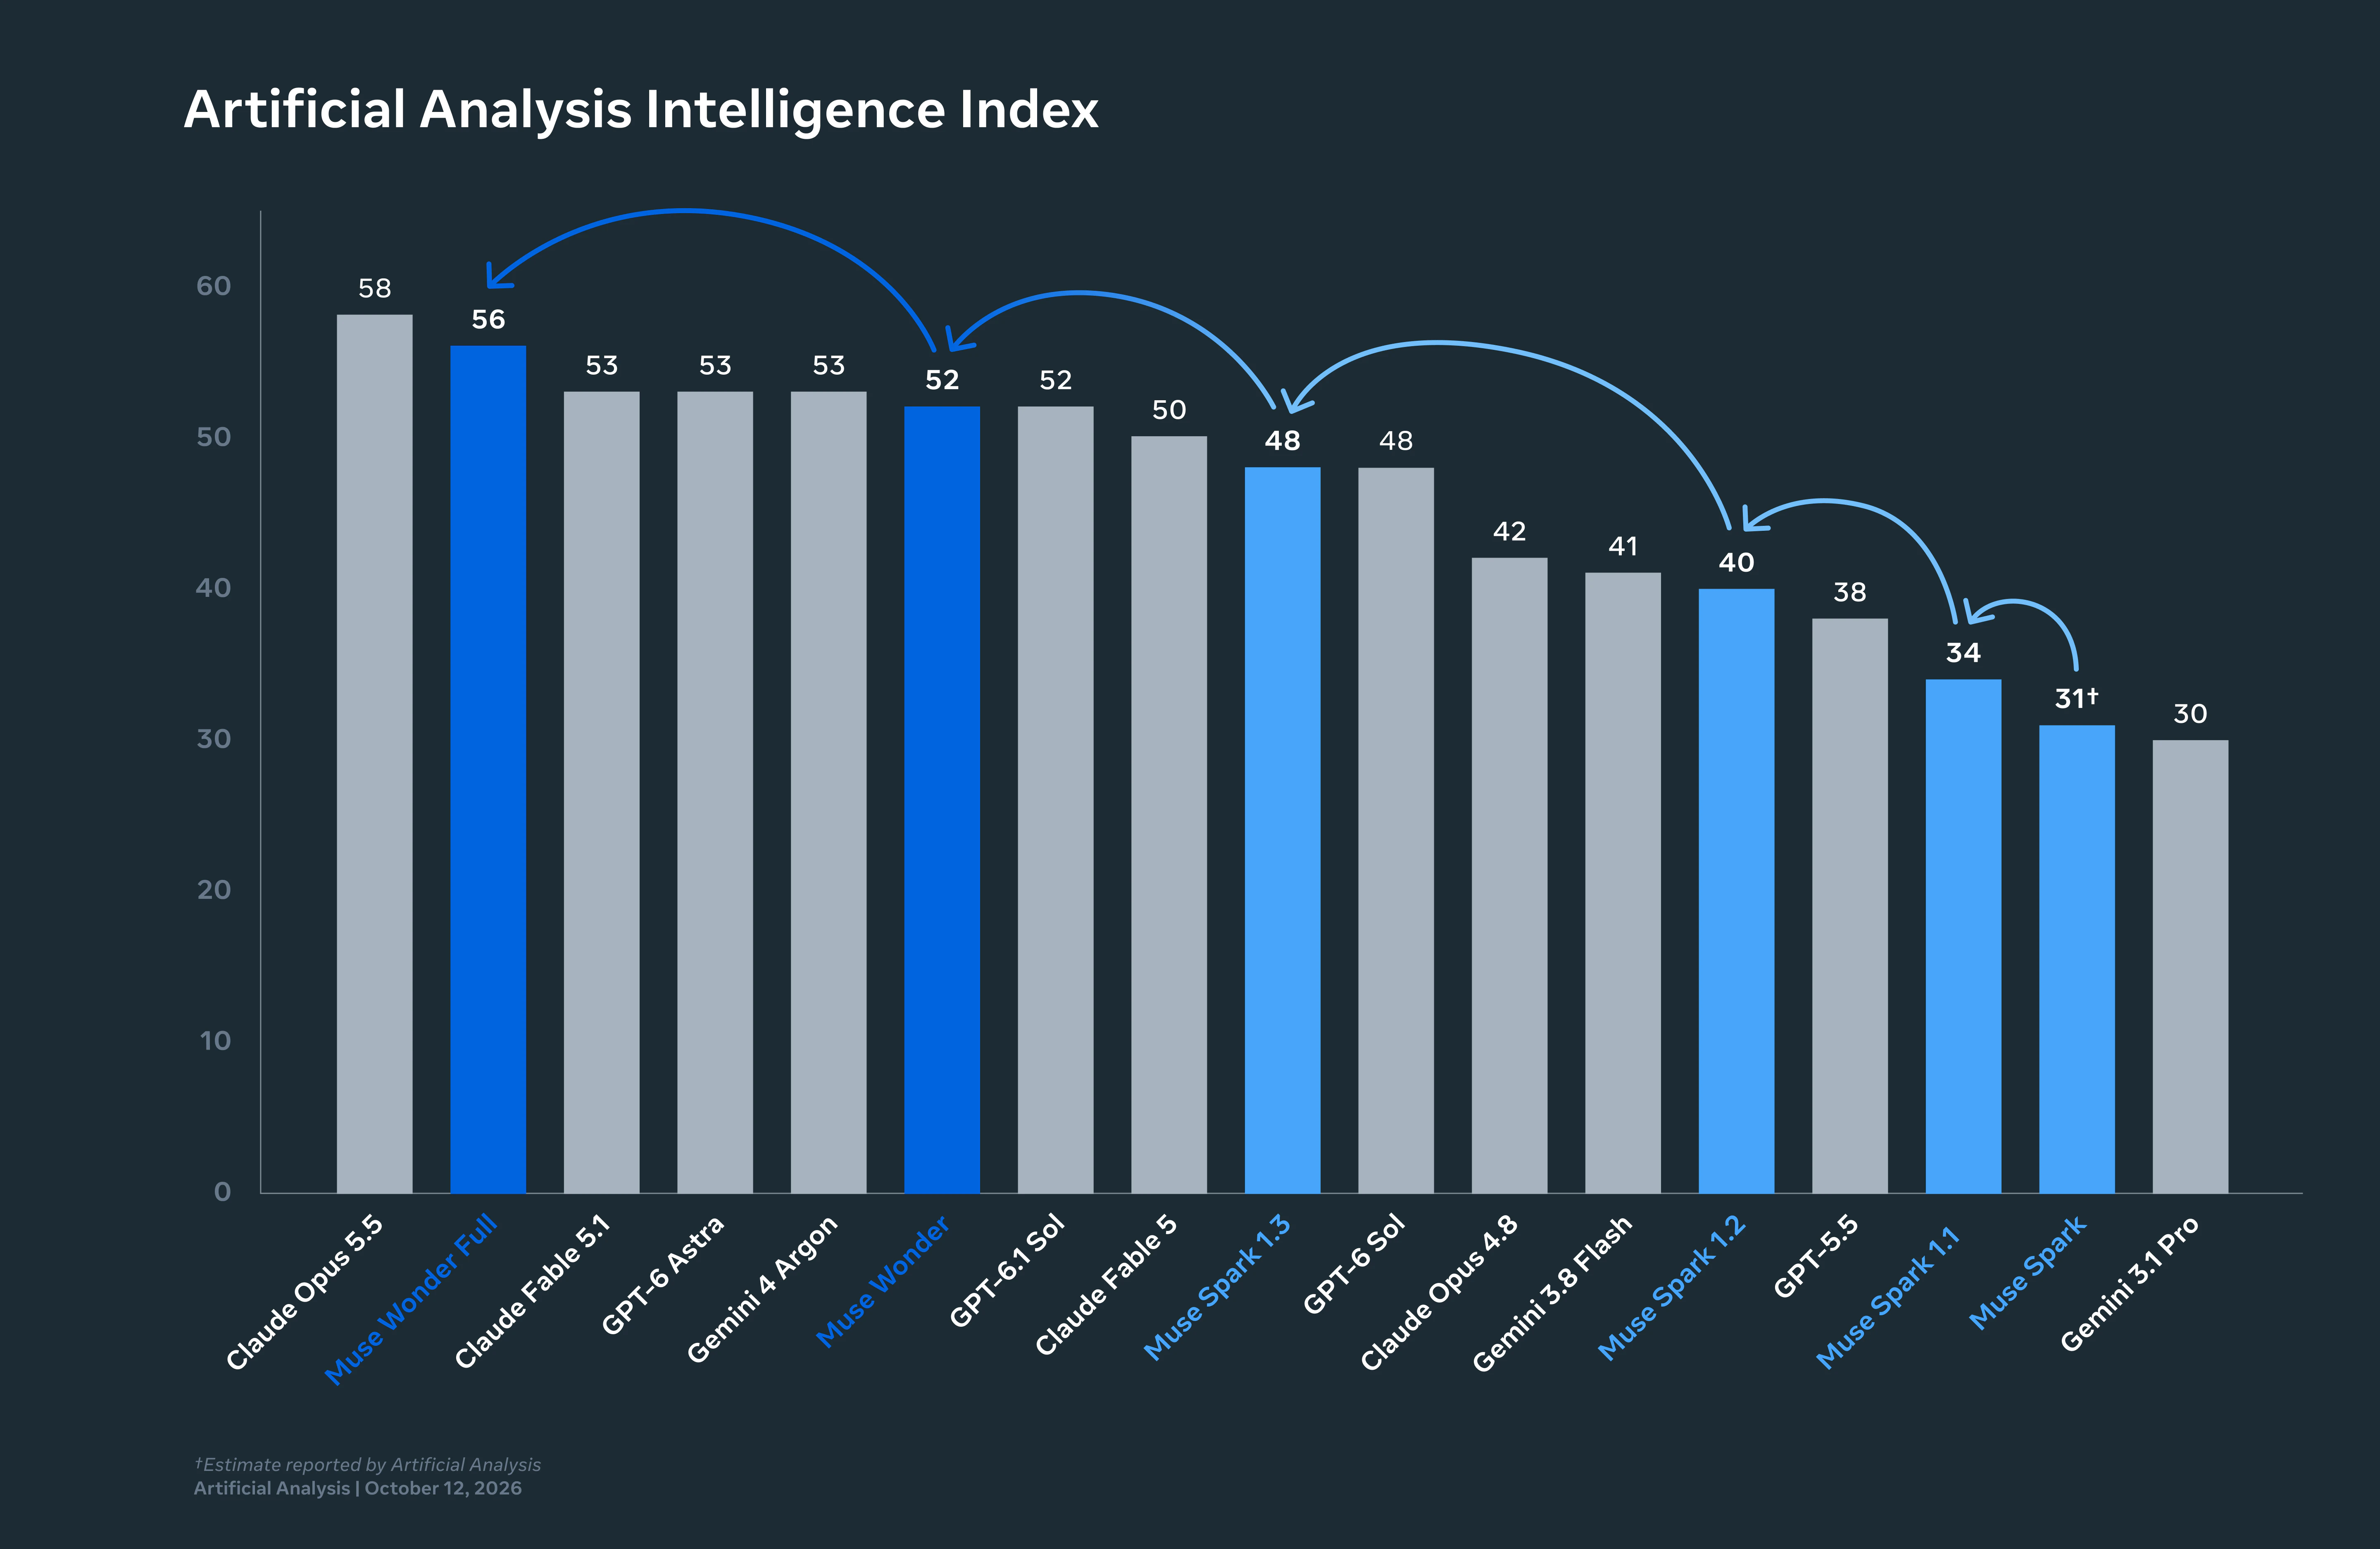
| Intelligence Index(総合知能指数) | 52 | 58 |
| 100万トークンあたりの価格(入力 / 出力) | $4 / $20 | $4 / $20 |
価格帯は同じでも、得意とする領域は異なります。これに基づくCrewのルーティングルールは極めて明確です。
- Muse Wonder Agentに割り当てるケース:複数ファイルにまたがるリファクタリング、失敗したテストの原因究明を伴う依存関係のマイグレーション、不安定なテストスイートに対する修正・検証ループなど、多数のステップを含み、途中で障害に遭遇することが予想される長時間のTask。
- Opus 5.5またはAstraに任せるケース:ターミナル操作が中心となる作業、広範な事実知識が必要なタスク、あるいは最高精度のレビューが求められるTask。Which agent gets the Task(どのエージェントにタスクを割り当てるべきか)では、一般的な使い分けのルールを解説しています。
設定が完了したら、明確な受入基準が定められたTaskを選び、AssigneeとしてMuse Wonder Agentを指定した上で、Backlogから着手可能なステータスへと移動します。タスクの実行は「queued(キュー待ち)」、「dispatched(配信済み)」、「running(実行中)」へと遷移し、実行ログにはツールの呼び出しやRuntimeイベントが記録されます。Agentが処理を一時停止して質問を行うと、その質問はTaskへのコメントとして反映され、Inboxへとルーティングされます。MetaはWonderに対し、重要なアクションを実行する前に確認を取るようトレーニングしており、Sharklyのボード上ではその確認通知を適切に受け取ることができます。この通知への対応方法については、Active Focus and the review queueで詳しく解説しています。
実行できないモデル:Muse Wonder Fullについて
上位モデルのMuse Wonder Fullは、Wonderの52に対して56のスコアを記録し、Coding Agents IndexではSonnet 5.5搭載のClaude Codeと並ぶ68をマークしています。しかし、このモデルは月額50ドルのPowerプランおよび月額200ドルのMaximumプランにおけるMuse Code内でのみ提供されています。API用のモデルIDが存在しないため、CodexやClaude Codeから接続することはできず、さらにMuse CodeはSharklyのローカルサービスが自動検出するRuntimeの対象外です。Sharklyは検出されないツール向けにカスタムACP Runtimeを提供していますが、MetaのドキュメントにはMuse CodeがACPに対応しているかどうかの記述がないため、現時点では未検証として扱う必要があります。チーム運用において、Fullは個々のエンジニアがターミナルで利用するモデルであり、ボード上で自動割り当てできるモデルではありません。この制約が意味する詳細については、Muse Wonder Full is subscription-onlyを参照してください。
コストとデータの取り扱い
これらの利用料金がSharklyから請求されることはありません。モデルの利用料はComputerに設定されたMetaのAPIキーを通じて直接請求され、Metaの料金体系が適用されます。価格は100万トークンあたり入力4ドル/出力20ドル/キャッシュ時0.20ドルで、ロングコンテキストによる追加料金はなく、チーム全体で毎分3,000リクエスト、400万トークンの制限が適用されます。長時間の処理ではターンごとにコンテキストが再送信されるため、Muse Wonderレーンは必然的にキャッシュを多用する特性を持ちます。Artificial Analysisの測定では、Opus 5.5の1タスクあたり5.98ドルに対し、Wonderは4.52ドルにとどまりました。これは主にWonderの出力トークン単価が安価であることに起因しています。
MetaのStandardモードにおけるAPI通信のデータは、モデルの学習には使用されません。これは、デフォルトでContributorモードが適用されるMuse Codeのサブスクリプションとは異なる点です。Computer上のRuntimeはAPI経由で通信を行うため、設定を変更しなくても、チームのコードがMetaの学習データセットに取り込まれる心配はありません。
今週、新たなモデルが登場しました。しかし、依頼からリリースに至るまで、コンテキスト、進捗状況、障害要因、実行結果、そして人間によるレビューが一貫して可視化されていることの重要性は変わりません。Gitのワークツリーなどを用いて手動でこの仕組みを構築することも可能ですが、Sharklyを活用すればワークフロー全体を効率的に管理できます。


