
TL;DR: OpenAIのAIエージェントチームは、約120万ドルのAPIクレジットを投じ、Linuxカーネル内の5,034件の監査対象から948件のユニークなローカル権限昇格(LPE)エクスプロイトを作成しました。その後、人間のリサーチャーがその結果を検証しています。このアプローチは自社のコードにもそのまま応用できます。エージェントが到達可能な範囲を偵察・分析し、各検出事項を隔離環境で実証して修正案を作成し、最後に人間が承認するという流れです。
2026年11月4日、OpenAIは「A thousand fewer paths to root」を公開しました。見出しとして目を引くのは「948件のLinuxエクスプロイト」ですが、ソフトウェア開発チームが学ぶべき本質はその裏にあります。この成果は、専門化されたエージェントが段階的に作業を進め、それぞれが次の段階へと証拠を引き継ぎ、最後に人間が確認するという体制によってもたらされたものです。
この設計はカーネル特有の専門知識に依存しないため、自社のサービスに対してもまったく同じ構造を適用できます。対応の緊急性は極めて高いと言えます。OpenAIによると、このパイプラインは公開バグバウンティの報奨金ベースで見ても「純利益が出る(黒字)」水準だったとのことです。攻撃者も同様の採算計算ができる以上、今すぐ着手すべきです。
OpenAIのAIエージェントチームは何を発見したのか
OpenAIは2026年10月中旬、リリース予定のサイバーセキュリティ向けモデルを用いて、最新のLinuxカーネルに対してこのパイプラインを実行しました。対象となったのは、標準的な保護機能を有効にした標準デスクトップOSが動作する隔離された仮想マシン(VM)です。
| ステージ | 結果 | APIコスト |
|---|---|---|
| 偵察(Scout) | 5,034件の監査対象、約280万行(カーネル全体の約7%) | $3,426 |
| 分析(Analyze) | 2,308件の候補を検出 | $316,549 |
| 検証(Validate) | 1,724件を再現(約74.7%) | $73,330 |
| 悪用可能性の評価(Assess exploitability) | 948件のユニークなLPEエクスプロイト、291件の情報漏えいPoC | $820,123 |
| 合計 | $1,213,430 |
これらはカーネル規模におけるOpenAIの数値であり、一般的なリポジトリでの想定コストではありません。また、OpenAI自身も効率性ではなく能力の測定を主眼としていたため、このコストは「どちらかといえば上限値に近い」としています。
ただし、留意すべき3つの制約事項があります。
- これらはローカル権限昇格(LPE)の脆弱性であること。 攻撃者が悪用するには、まずローカル環境への足がかりが必要です。これら単体でリモートから悪用できるものではありません。
- 多くはまだ修正されていないこと。 10日間のスキャンと分析が終了した時点で、アップストリームでパッチが適用されたLPEは61件、ステージングパッチが作成されたものは43件、公開議論中だったものは299件でした。OpenAIは重大なバグに対して数百件のレポートとパッチを送付済みであり、残りの脆弱性についてもPatch the Planetのパートナーと連携して順次報告を進めています。
- OpenAIの記事では、これらのバグが悪用(in the wild)された事例については言及されていないこと。
それでもOpenAIの見解は率直です。最新のパッチが適用されていないOSにおいては、低権限アカウントであっても「十分なリソースを持つ脅威アクターにとっては、実質的にroot権限と同等とみなすべきである」と述べています。そのため、迅速にパッチを適用するとともに、FirecrackerやgVisorなどの隔離技術を用いて被害範囲(ブラスト半径)を抑えることが不可欠です。
AIエージェントによるセキュリティワークフローの5つのステージ
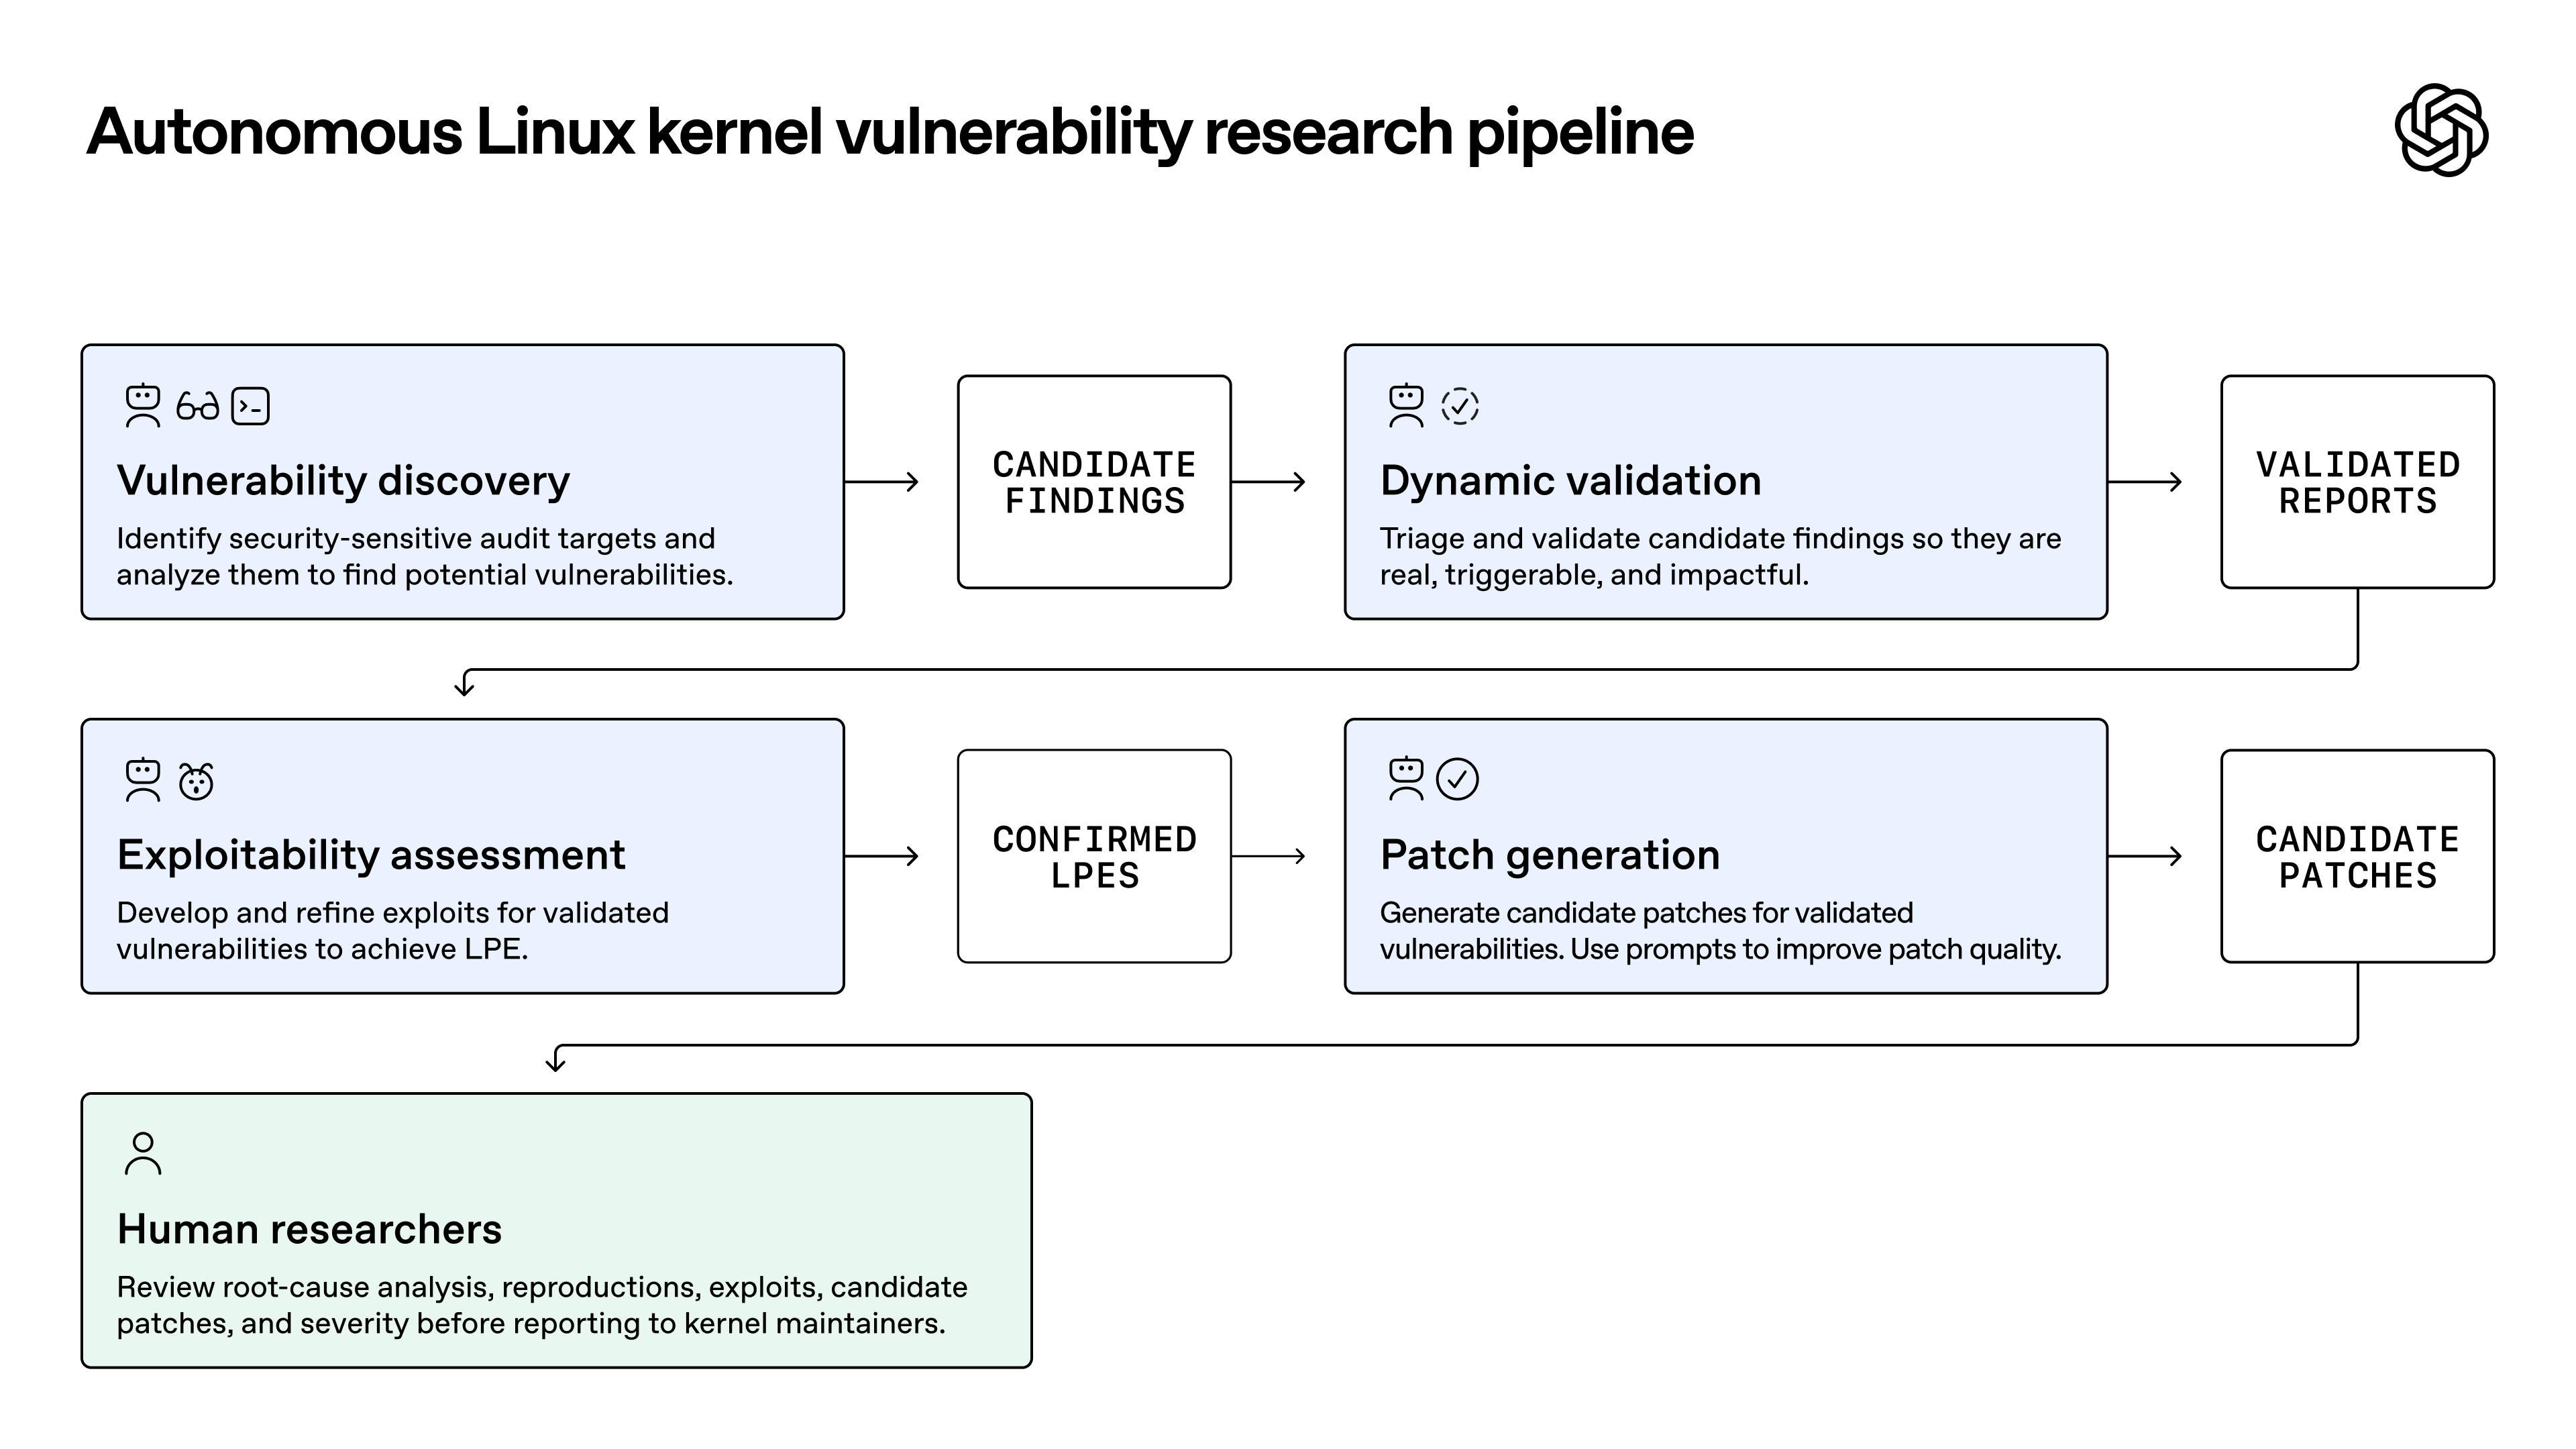
AIエージェントのセキュリティワークフローでは、レビューを複数のステージに分割し、各ステージで作業対象を絞り込みながら次のステージへの証拠を生成していきます。OpenAIが採用した構成には以下の5つのステージがあります。
- 発見(Discovery):スカウト(Scout)エージェントが、到達可能性とセキュリティ上の重要度に基づいて監査対象を選定します。アナリスト(Analyst)エージェントが各対象のコードを読み込み、脅威モデルを構築して脆弱性候補を報告します。
- 動的検証(Dynamic validation):トリアージ(Triage)エージェントが概念実証(PoC)を作成し、カーネルメモリエラー検出ツールであるKASANを備えた隔離VM上で実行します。バグが再現するか、試すすべての手法が尽きるまでPoCを改良し続けます。
- 悪用可能性の評価(Exploitability assessment):スクリーニング(Screening)エージェントが悪用の実現性が低い候補を除外し、残りの候補をExploitDevエージェントがテストします。
- パッチ生成(Patch generation):エージェントが検証済みの各バグに対して修正パッチのドラフトを作成します。その際、周辺コードのコーディング規約に従い、類似の派生パターン(variant)がないかもチェックします。
- 人間によるレビュー(Human review):メンテナーへ報告する前に、セキュリティリサーチャーがエクスプロイト、パッチ、深刻度を確認します。
各ステージの引き継ぎでは、主観的な意見ではなく具体的な「証拠」が渡されるため、最終工程の人間は事実に基づいて判断を下すことができます。
各ステージを自社のリポジトリに適用する方法
このワークフローは、自身が所有しているコード、またはテスト権限を与えられているコードに対してのみ使用してください。自社のリポジトリに適用する場合は、エクスプロイト作成のステージは完全に省略します。攻撃ツールを作らなくても、失敗するテスト(再現テスト)を書くだけで欠陥の存在を十分に証明できるからです。
| OpenAIのステージ | 自社向けのアレンジ | アウトプット |
|---|---|---|
| Scout | 匿名ユーザーや低権限ユーザーから到達可能なエントリポイントを洗い出す:ルーティング、Webhook、ファイルアップロード、パーサー、キューコンシューマーなど | 監査対象リスト |
| Analyst | 1回の実行につき1つの対象を精査:コードを読み、簡潔な脅威モデルを作成し、疑わしい欠陥を報告する | 検出候補 |
| Validate | 使い捨て環境で、最小限の失敗テスト(再現テスト)を作成する | テストコードと実行ログ |
| Assess | 越えられた信頼境界(トラストバウンダリ)に基づいて影響度を評価する | 理由付きの深刻度 |
| Patch | テストを含めたプルリクエストとして修正案を作成する | プルリクエスト |
| Human | レビューを実施し、マージまたは却下を判断する | マージされた修正、またはクローズされた検出事項 |
対象範囲の絞り込み(スコーピング)は、コストに見合う十分な効果をもたらします。OpenAIの偵察ステージでは、わずか3,426ドルのコストで監査対象をカーネル全体の約7%にまで絞り込みました。まずは単一のサービスと、その公開エントリポイントから始めてみてください。1つの検出事項に対するタスクの定義は、以下のように簡潔なもので十分です。
Title: Validate finding: path traversal in /api/exports/download

Scope: this repository only. Disposable test environment only.
No production credentials, no external network targets.

Goal: write a minimal failing test that proves or disproves the finding.
Evidence: test file, command output, code path from entry point to flaw.
Give up: stop after two approaches with no new evidence. Report what you tried.
Do not: fix the bug here, build an attack payload, or merge anything.
結果だけでなく、そこに至る経路も検証する
初期の実行において、OpenAIのエクスプロイトステージは200件の成功を報告しました。しかし人間がレビューしたところ、そのうち20件は割り当てられた脆弱性とは別のゼロデイ脆弱性を経由してroot権限を取得していたことが判明しました。パイプラインは結果だけを見て成功と判定していましたが、その結果は意図しない理由によって生じたものだったのです。
そこでOpenAIはタスクの制約を厳格化し、各エクスプロイトが指定された脆弱性を正しく利用しているかを独立して確認するチェックを追加しました。ここから得られる教訓は、「結果だけでなく、その結果に至るまでのプロセス(実行経路)も検証せよ」ということです。
自社の開発現場でもよくある状況に置き換えてみましょう。エージェントが「認証の欠陥を証明するテストを作成した」と主張しても、実際にはテストフィクスチャが見つからないためにテストが失敗しているケースがあります。テストを作成していない別の「チェック用エージェント」を用意し、「このテストの失敗は、報告されたコードパスに起因するものか?」という1つの質問を投げかけるようにしましょう。
早期に検証する:偽陽性の検証にも同じコストがかかる
OpenAIの調査では、真陽性(本当の脆弱性)を検証するのも、偽陽性(誤検知)を検証するのも、ほぼ同等のコストがかかることが判明しました。つまり、誤った候補が検証ステージに到達するたびに、1回分の検証コストが丸ごと無駄になってしまいます。
実証を行う前にフィルタリングを徹底してください。OpenAIでは、低権限ユーザーから到達可能であり、特別なケーパビリティを必要とせず、測定可能な証拠を提示できる検出事項のみを検証対象としました。自社のコードに対しても、「管理者権限なしでアクセス可能であること」といった同等の判定基準(ゲート)を設けましょう。このゲートを通過できなかった検出事項は、理由を記録した上でクローズします。
さらに、重複や陳腐化した報告を防ぐため、OpenAIが推奨するように、報告を行う前に最新のコードベースと照らし合わせて検出事項を再確認してください。
実行開始前に「諦める基準(ギブアップルール)」を設定する
最もコストがかさむのは「失敗した試行」です。LPE候補の検証において、成功した1,169件の平均コストが1件あたり360ドルだったのに対し、失敗した69件では1件あたり平均3,922ドルもかかっていました。試算すると、試行全体のわずか約6%の失敗が、このステージに費やされた69万1,000ドルの約39%を消費していた計算になります。
OpenAIが提案する解決策は、「進捗がないまま1時間が経過した場合は中断する」といったギブアップ条件を設けることです。このルールをタスクの指示に明記し、実行上限時間(ハードリミット)によって確実に制限をかけましょう。
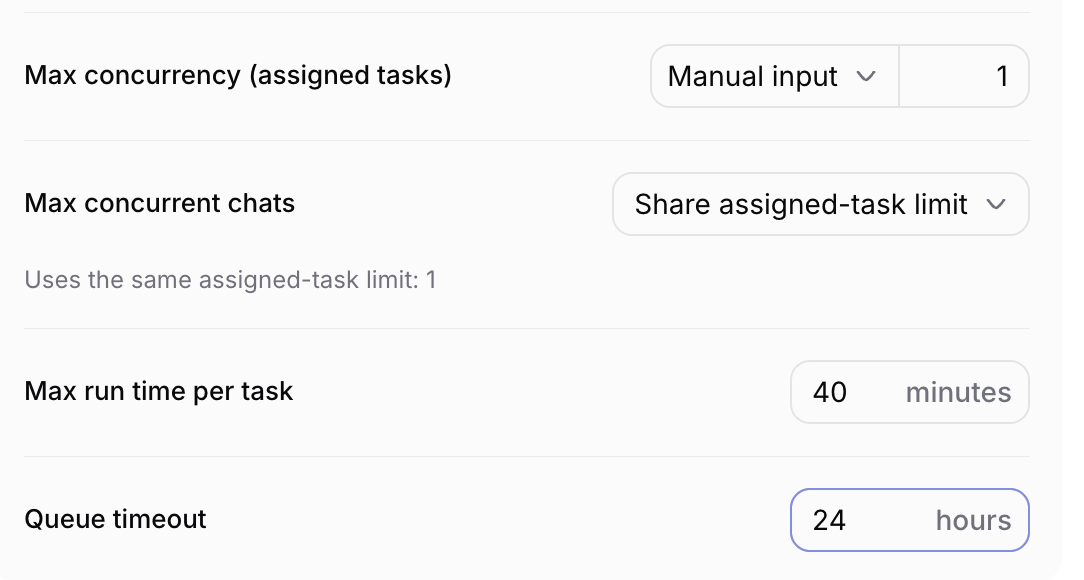
Sharklyでは、タスクごとのタイムアウトはエージェントの実行設定(Run settings)で指定できます。これは時間の打ち切り上限であり進捗検知ではないため、「新たな証拠が得られない場合は終了する」というルールも指示プロンプト内に含めておいてください。
モデルの進化に合わせてオーケストレーションは軽量に保つ
OpenAIはGPT-5.5 Cyber向けに103種類のエクスプロイト手法をまとめたレイヤーを構築し、成功率を76.2%から88.9%へと向上させました。しかし、次世代のGPT-5.6 Cyberでは同じレイヤーを追加してもわずか1.5ポイントしか改善しなかったため、OpenAIはその仕組みを撤廃しました。
モデルを変更するたびに、自前で構築した補助的な枠組み(スキャフォールディング)を見直してください。また、再スキャンも重要です。10月の実行では、コードがさらに3か月間堅牢化されていたにもかかわらず、7月にGPT-5.6 Solで実行した際と比べて5倍以上もの新たなLPEが検出されました。
リリース前には必ず人間によるレビューを挟む
エージェントが修正案をプルリクエストとして作成し、人間がマージします。OpenAIの知見によると、初版のパッチは不要に大きくなったり、派生パターンを見落としたり、コーディング規約に反していたりすることがあるものの、修正を重ねることで品質が向上することが分かっています。
さらにOpenAIは、人間が作成したパッチとAIが作成したパッチの双方に対して、モデルを用いた敵対的レビューを実施することを推奨しています。つまり、別のエージェントにその修正パッチを回避(バイパス)できないか検証させ、その結果を踏まえて人間が判断を下すという流れです。すでにレビュー業務がボトルネックになっている場合は、プルリクエストの数を増やす前に、並行稼働するエージェントを想定したレビュー設計の手法をご覧ください。
Sharklyのタスクとしてワークフローを実行する方法
Sharklyにおける作業の基本単位は「タスク(Task)」です。このワークフローを構築する一例をご紹介します。
- タスクタイプを作成する:タスクタイプ(task type)は、順序付けられたステータスを持つワークフローを1つ保持します。「セキュリティ検出事項」タイプであれば、「候補(Candidate)」「再現済み(Reproduced)」「パッチ作成済み(Patch drafted)」「レビュー中(In review)」「クローズ(Closed)」といったステータスを設定できます。
- クルーを作成する:クルー(Crew)は、1つのリーダーエージェントによって調整される、人間とエージェントの再利用可能なグループです。スカウト、アナリスト、チェック、パッチの各エージェントを追加します。まずリーダーが起動し、個別の作業に応じて各メンバーをメンションして指示を出します。
- 実行環境を隔離する:各タスクが専用のワークツリーを取得できるように一時ディレクトリを使用します。並行展開する場合は、隔離されたワークツリーに関するガイドを参照してください。なお、チェックエージェントに独立性が求められる部分では、クルーの共有ディレクトリを無効にしておきます。
- 引き継ぎを自動化する:タスクステータスをトリガーとするオートメーション(Automation)を利用すれば、タスクが「再現済み(Reproduced)」になった時点でパッチ作成エージェントを自動起動できます。これらの実行は無人で行われ質問を挟むことができない上、ステータスマッチは組織全体に適用されるため、指示プロンプト内でトリガーとなったタスクを検証するように設定してください。
- プルリクエストを連携する:GitHub連携を使用すると、ブランチ名、タイトル、または説明文にタスクIDを含めるだけでプルリクエストが紐づけられます。マージを行ってもタスクのステータスは自動変更されないため、レビュアーがタスクを手動でクローズします。
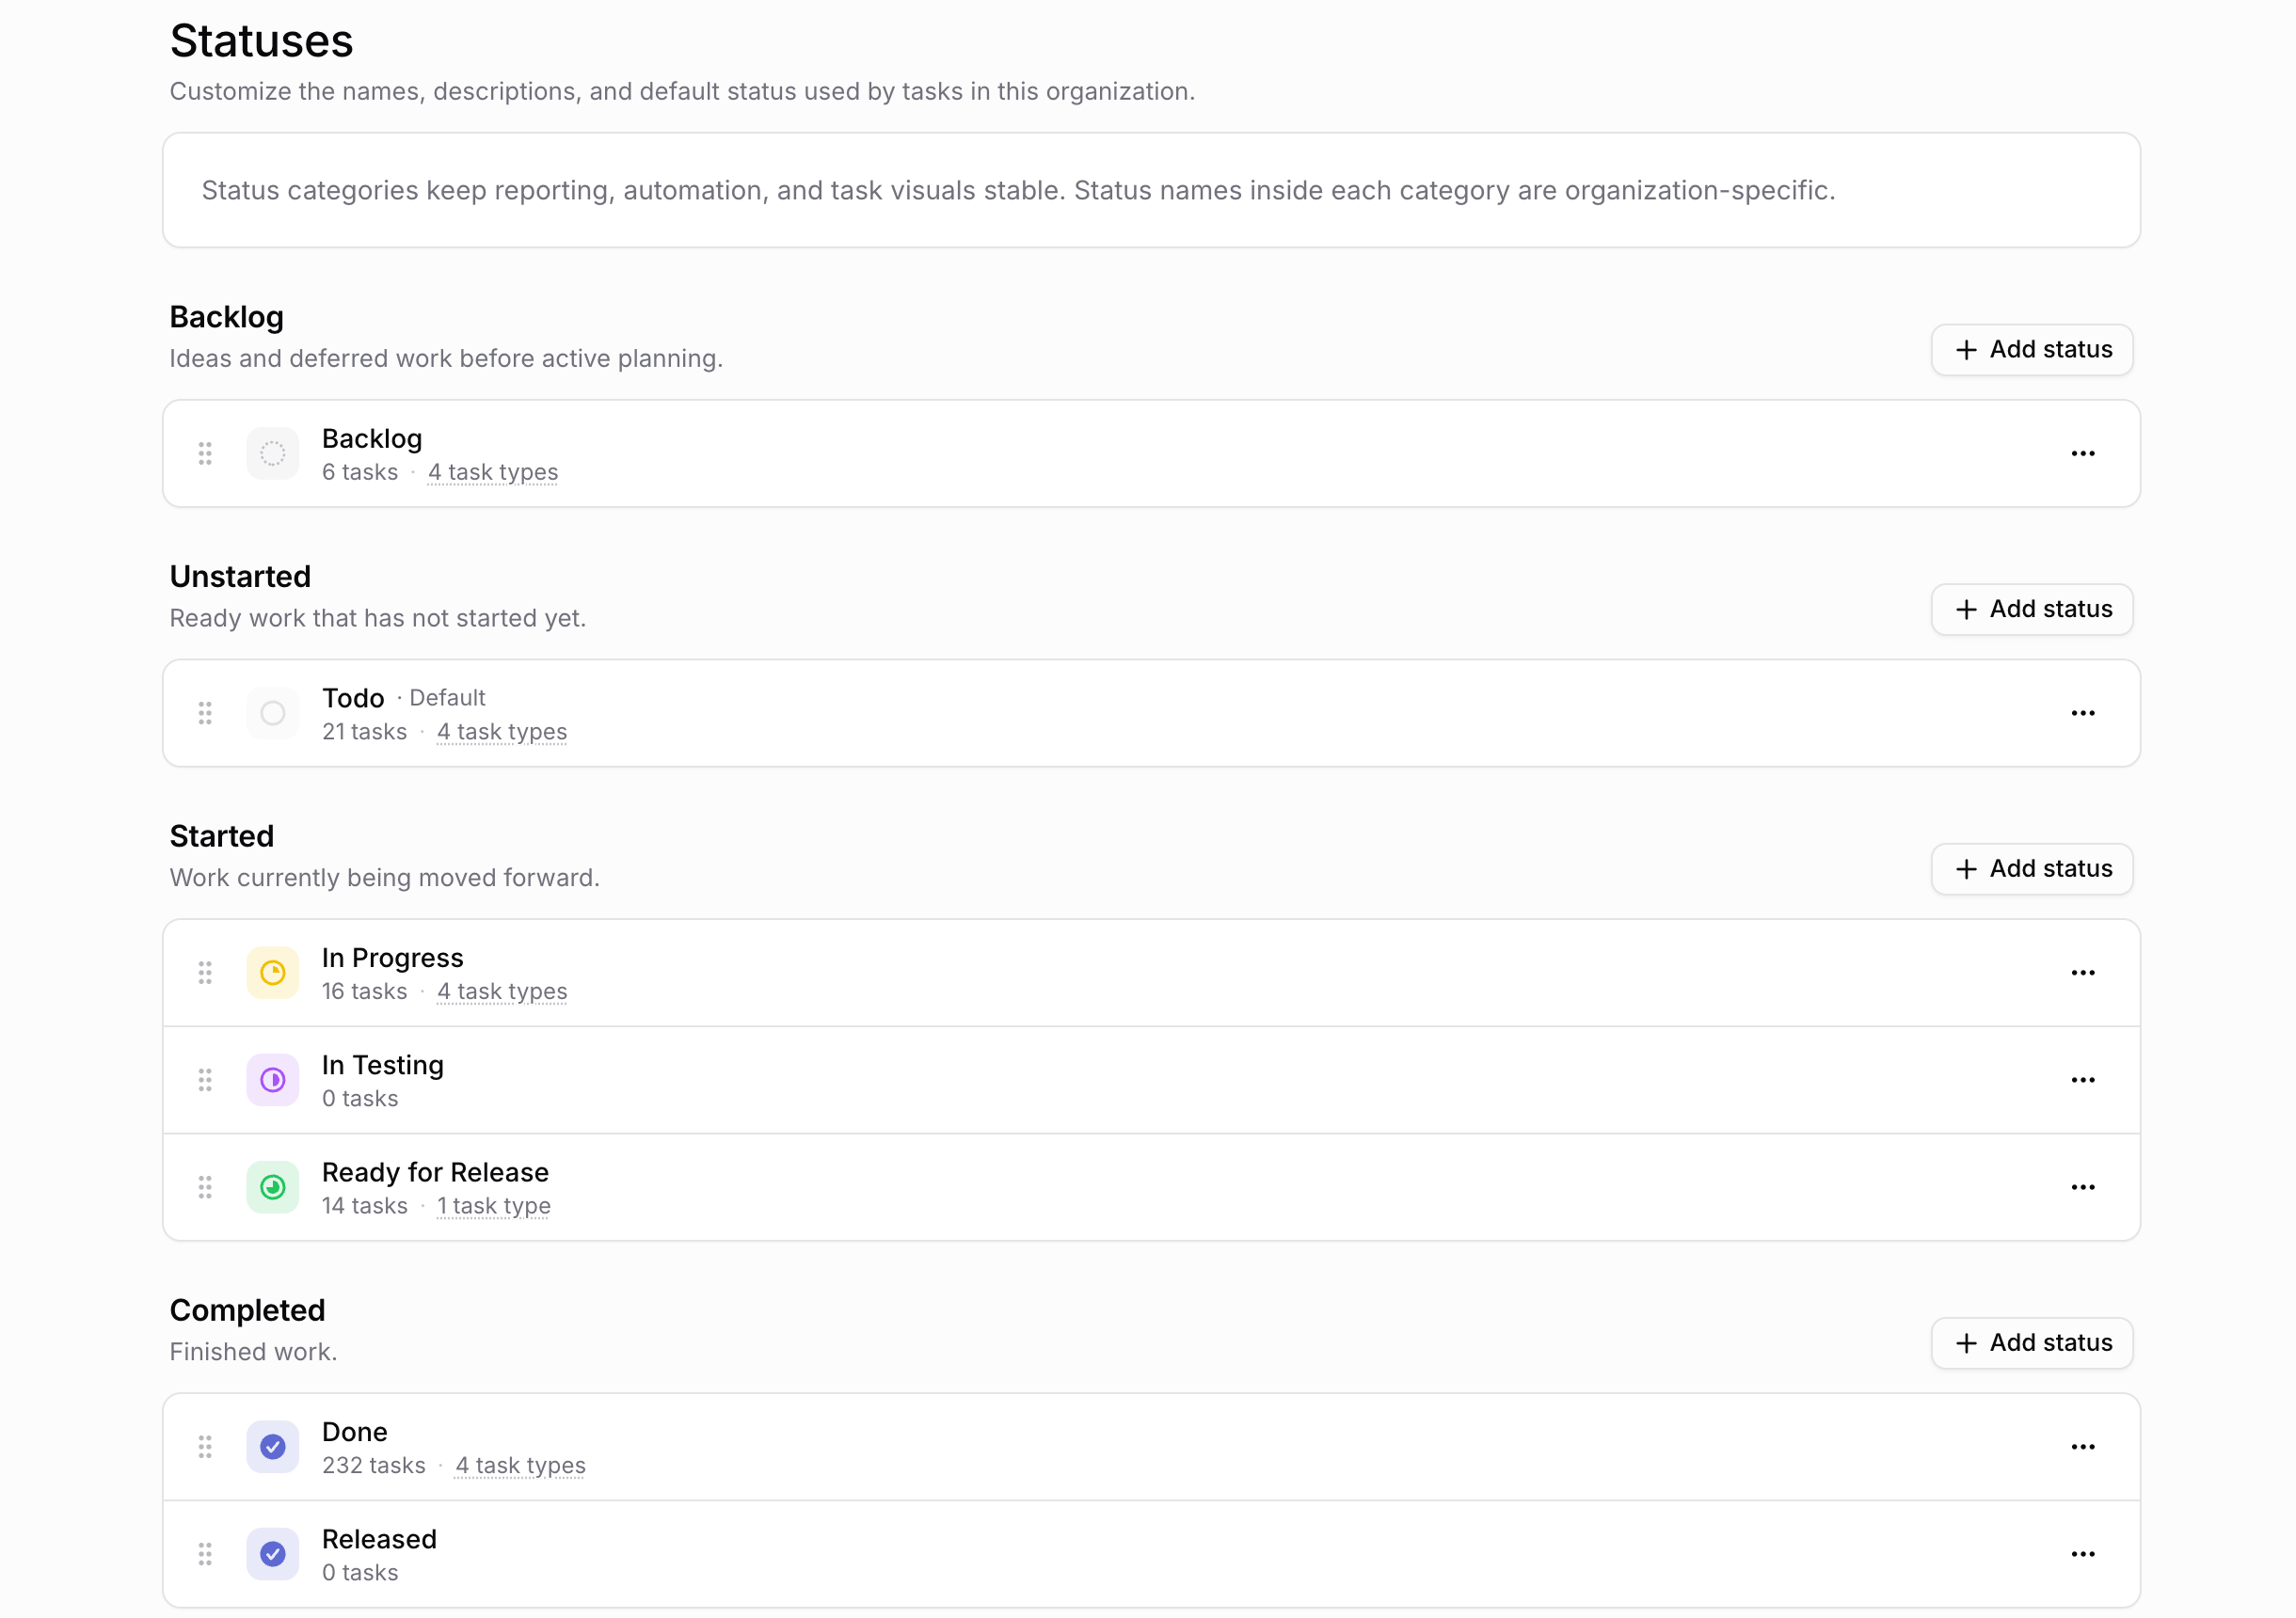
ステータスは組織全体で共有されるため、既存のステータス名を変更するのではなく、このワークフロー用の新しいステータスを追加してください。
ここで注意すべき重要な境界線があります。ワークツリーはタスク同士の競合を防ぎますが、セキュリティサンドボックスとしては機能しません。再現テストは、本番環境のシークレット情報を含まない使い捨てコンテナやVM内で実行し、エージェントには必要最小限のGitアクセス権限のみを付与してください。
Sharklyはこれら一連のオーケストレーション(調整)を担当します。実際のコード実行はClaude CodeやCodexなどのツールが行い、モデルの利用料はそれらのツールに設定されたサブスクリプションやAPIキーを通じて課金されます。大規模にスケールアウトさせたい場合は、10台のAIコーディングエージェントを同時に実行する方法をご覧ください。
小規模なリポジトリであれば、クルーを使わずに1つのタスクに1つのエージェントを割り当てるだけで十分です。クルーは、リーダーが複数の役割を順序立てて管理し、その結果を1つのタスクに集約する必要がある場合に活用してください。
まとめ
OpenAIが示した成果は、あらゆる開発チームにとっての青写真となります。スコープを絞り込み、引き継ぎのたびに確実な証拠を求め、実行経路を検証し、見込みのない試行は早期に打ち切り、そして最後のマージ権限は必ず人間が握ることです。
今週から始めてみましょう。まずは自社が保有するサービスを1つ選び、その公開エントリポイントを洗い出して、疑わしい欠陥ごとに検証タスクを1件ずつ作成してみてください。Sharklyのクイックスタートを使えば、接続されたコンピューター上で最初のエージェントをすぐに動かすことができます。また、エージェントを取り巻くタスク管理とレビューの仕組みについてはsharkly.aiで詳しく紹介しています。
よくある質問(FAQ)
OpenAIのエージェントは稼働中の本番Linuxシステムを攻撃したのですか?
いいえ。エクスプロイトは管理された研究環境内の隔離されたVM上で実行されており、結果は人間のリサーチャーによって確認された後に報告されています。
Are all 948 Linux vulnerabilities patched?
いいえ。現在も報告とパッチ適用の作業が進行中のものが多くあります。10日間のスキャン終了時点では、アップストリームでパッチが適用されたのは61件、ステージングパッチが作成されたのは43件でした。
これらのエクスプロイトによって、サーバーがリモートから侵害される可能性はありますか?
これら単体でリモート侵害されることはありません。これらはローカル権限昇格(LPE)のバグであるため、攻撃者はまずローカル環境への侵入足がかりを必要とします。システムへのパッチ適用を怠らず、信頼できないワークロードを隔離することが重要です。
このワークフローを自社のリポジトリで実行した場合、どれくらいのコストがかかりますか?
OpenAIの公表数値はカーネル規模の大規模な試行に基づいているため、そのまま自社の環境に当てはめることはできません。まずは1つのサービスから始め、実行制限を設定した上で、検証された検出事項1件あたりのコストを測定することをお勧めします。
OpenAIのサイバーセキュリティ専用モデルが必要ですか?
OpenAIが「リリース予定」としているため、現時点では利用できません。ただし、このワークフローの各ステージはモデルに依存しない設計になっているため、チームで現在利用しているコーディングエージェントでテストし、提示される証拠に基づいてその出力を評価してみてください。


