
1つのターミナルで1つのエージェントを動かすのが、これまでの作業単位でした。プロンプトを入力し、待ち、確認し、また指示を出す。エージェントの処理は高速ですが、ボトルネックになるのは人間側です。明らかな解決策は複数のエージェントを同時に走らせることですが、同じワーキングツリーを複数のエージェントが同時に編集すると、互いの変更を壊し合ってしまうという明白な問題が生じます。
Orcaは、この問題をスマートに解決します。Stably社が開発したデスクトップアプリケーションで、それぞれのコーディングエージェントを独立したGit worktree上で並行稼働させることができます。GitHubスター数は58,464件を誇り、MITライセンスで提供されています。個人で開発していて今すぐ作業スループットを高めたいのであれば、Orcaは極めて有力な選択肢であり、本記事でもその利用を強く後押しします。ただし、Orcaには作業内容をチーム全体に可視化する機能はありません。それは別のレイヤーが担うべき役割だからです。
要約
この記事は、コーディングエージェントを拡張するオープンソースツールのまとめ記事からお届けする、5つの徹底解説シリーズの1つです。
Orcaを使えば、Codex、Claude Code、OpenCode、Cursor CLIをはじめ、事実上あらゆるCLIエージェントを既存のサブスクリプションのまま、独立したGit worktreeで並行して動作させられます。さらに、ターミナル分割、差分(diff)へのアノテーション、SSH越しのリモートworktree、Chromiumデザインモード、GitHub/Linearの閲覧、モバイル連携アプリなどの機能も備えています。個人の開発者にとっては申し分のないツールです。しかしチーム開発の場合、作業ログは単一マシンのターミナルのスクロールバックに残るだけです。ここにこそ、チーム向けの共有ワークシステムが必要となる境界線が存在します。
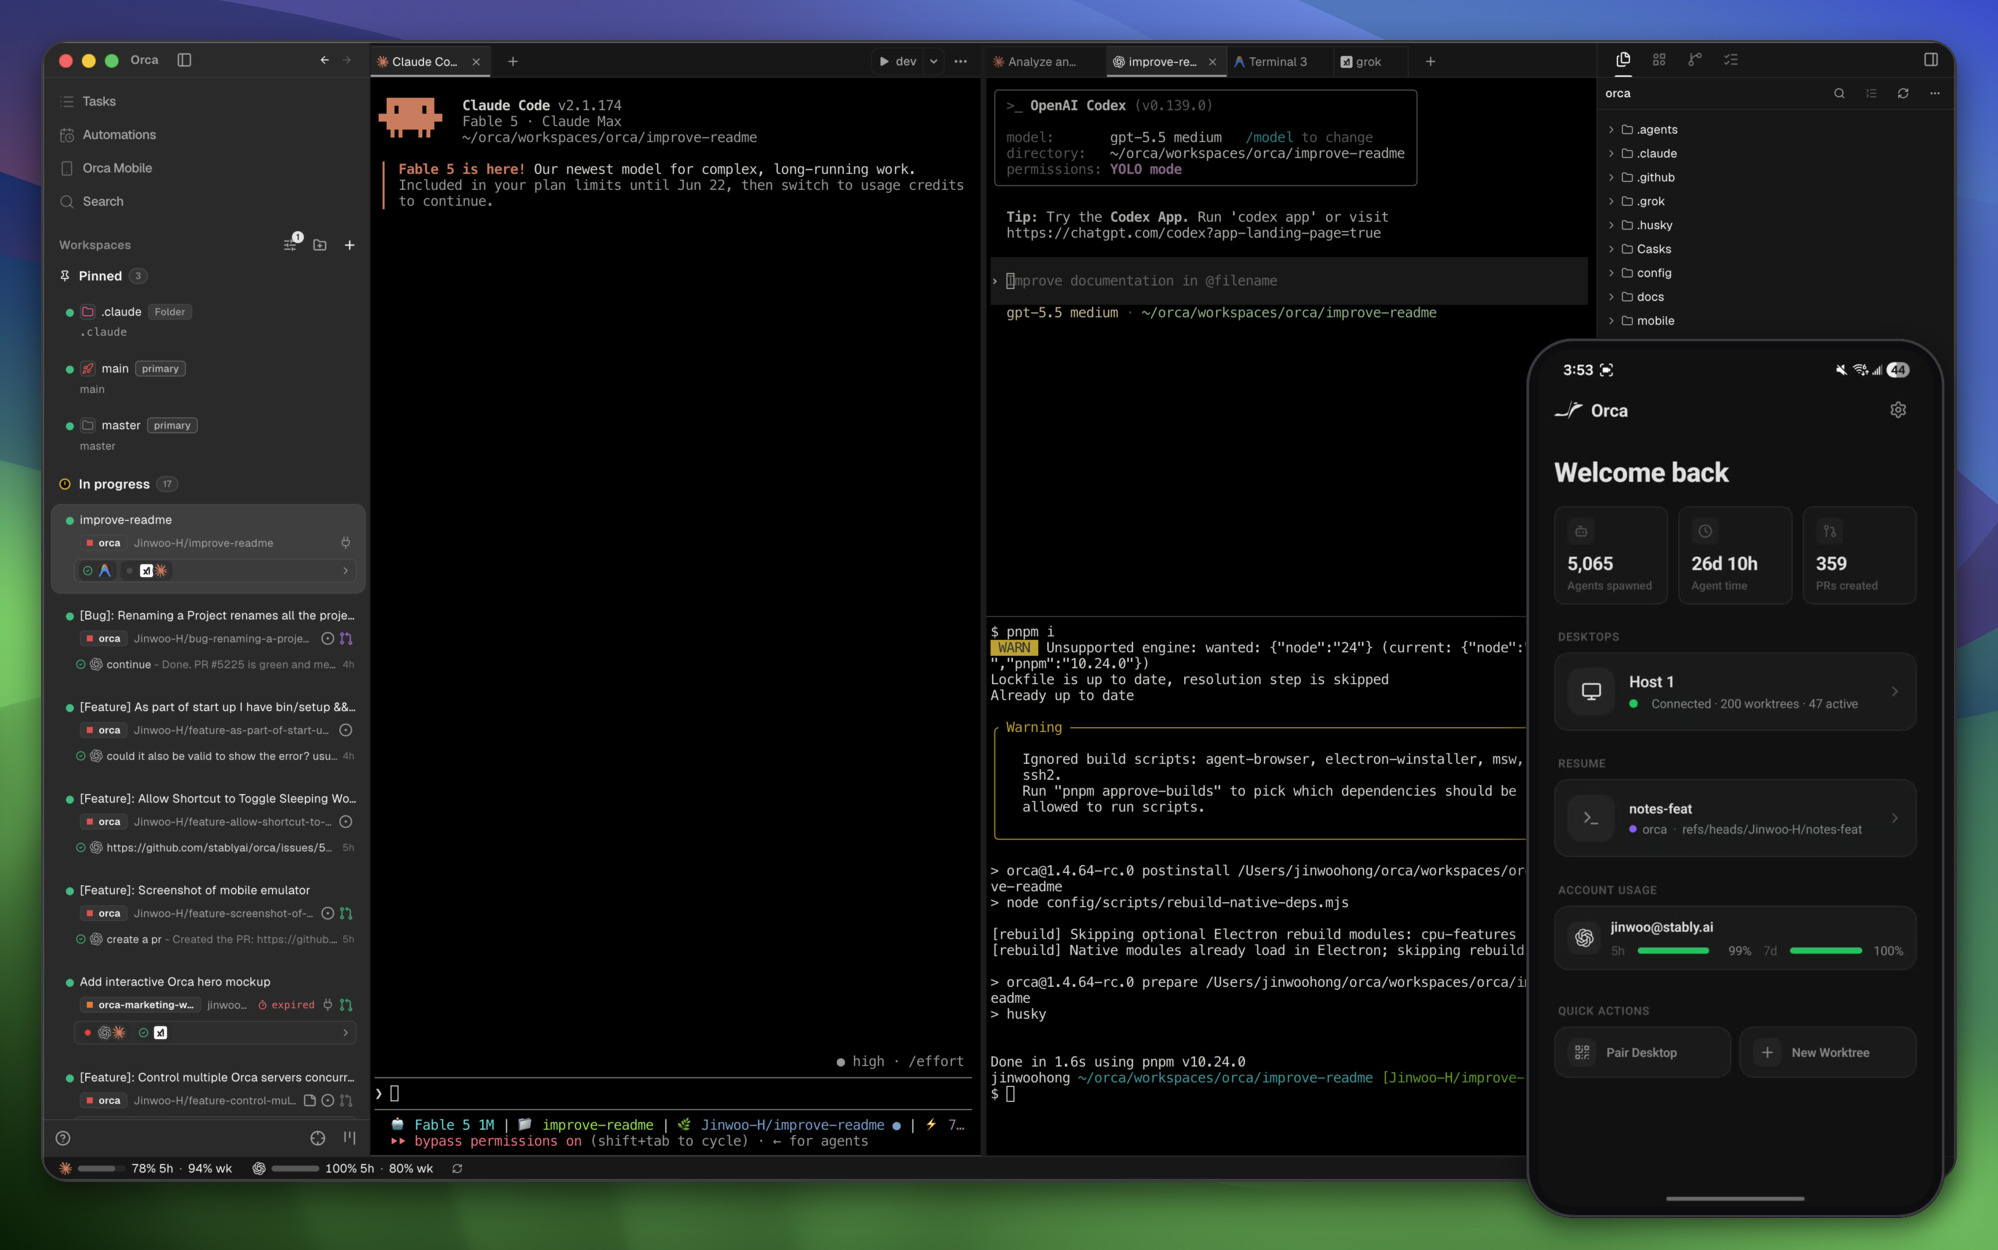
Orcaの主な機能と特徴
Orcaの核となる仕組みは「エージェントごとに1つのworktreeを割り当てる」ことです。Git worktreeを利用すると、1つのリポジトリから複数の作業ディレクトリを同時にチェックアウトできるため、5つのエージェントが互いのファイルに干渉することなく同一リポジトリで作業できます。これは並列実行のための独立したworktree環境と同じ仕組みであり、極めて理にかなったアプローチです。
これによって可能になるのが「ファンアウト」と呼ばれるパターンです。1つのプロンプトを複数のエージェントに送信し、得られた結果を比較して最も優れたものをマージします。解決策が一筋縄ではいかない複雑な課題において、3つの異なるモデルによる試行がまったく同じ形で失敗することはありません。1つの結果を何度も修正するよりも、3つの候補から最善のものを選択する方がはるかに効率的です。
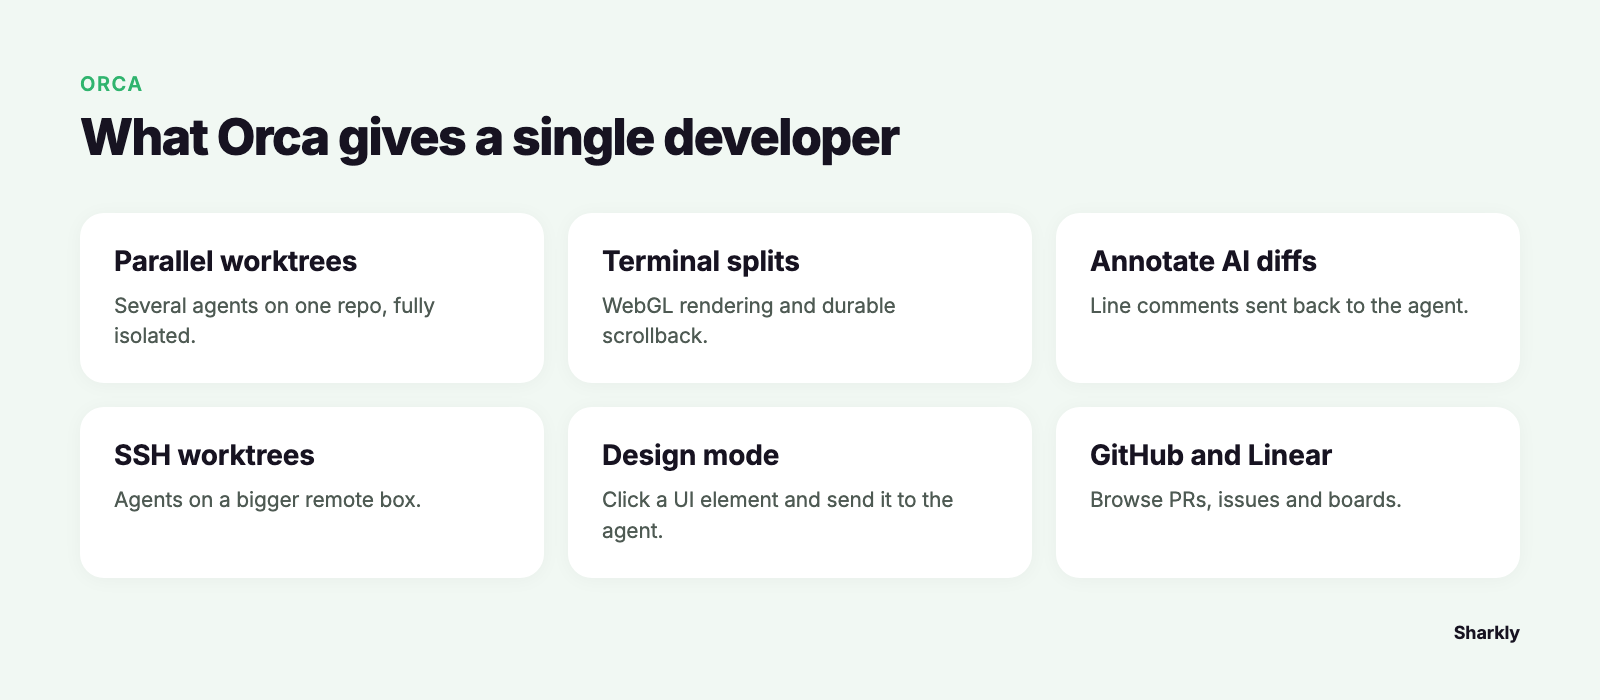
| 機能 | 得られるメリット |
|---|---|
| 並行worktree | 1つのリポジトリで複数のエージェントを完全に分離して実行 |
| ターミナル分割 | WebGLレンダリング、再起動後も保持されるスクロールバック |
| AIの差分へのアノテーション | 行単位のコメントをエージェントに直接フィードバック |
| SSH経由のworktree | より高性能なリモートマシン上でエージェントを実行、自動再接続に対応 |
| デザインモード | UI要素をクリックしてHTML、CSS、スクリーンショットをプロンプトに送信 |
| GitHubおよびLinear連携 | PR、Issue、ボードの閲覧、タスクからのworktree直接作成 |
| 利用状況トラッキング | ClaudeとCodexの利用制限・リセット時間の表示、アカウントのホットスワップ(即時切り替え) |
| モバイル連携アプリ | スマートフォンからの通知受信とフォローアップ指示 |
特に注目すべきはアカウント切り替え機能です。5つのエージェントを並行して動かせば当然レートリミットに達しやすくなりますが、アプリ内でリセット時間を確認できれば、途中で突然停止して立ち往生するのを防ぎ、事前に計画を立てて作業を進められます。
インストール方法は直接ダウンロードのほか、Homebrew caskやAURパッケージが用意されており、ヘッドレスなLinux環境向けには orca serve コマンドも提供されています。
ファンアウト(並行実行)が真価を発揮する場面
並列処理にはコストが伴います。最悪のパターンは、トークン消費量を5倍に増やしたにもかかわらず、本質的に同じ回答が5つ返ってくるだけに終わることです。
ファンアウトを活用すべきなのは、アプローチの選択肢が複数考えられるタスクです。例えば、状態管理のリファクタリング、使い慣れていないライブラリの統合、ボトルネックが特定できていないパフォーマンスの改善などが挙げられます。導き出された回答の「多様性と広がり」にこそ価値があります。
仕様が明確に定まっているタスクには、1つのエージェントだけを実行してください。エンドポイントにフィールドを1つ追加する作業や、既存の4つのハンドラーに合わせたハンドラーを新規作成する作業では、ほぼ同じ差分が5つ生成され、利用料が無駄になるだけです。
同一モデルを複数回実行するのではなく、異なるモデル間でファンアウトを行ってください。同じエージェントを3つ動かしても似通った回答に収束しがちですが、異なるエージェントを3つ使えば大きくアプローチが分かれます。サンプリングのランダム性ではなく、モデル本来の学習データや設計思想の違いから多様性が生まれるためです。
作業を始める前に、必ず受け入れ基準(完了条件)を定義してください。何が正しい回答なのかを事前に定義できていなければ、単なる見た目や好みの良し悪しで採用するコードを選ぶことになってしまいます。
「個人向けモデル」の限界
Orcaは、個人の作業環境(コックピット)として非常に優れています。worktree、セッション、差分、そして再起動後も保持される便利なスクロールバックに至るまで、すべてがローカルマシン上で完結します。1人で開発を進める上では、まさに理想的な設計です。
しかし、2人目の開発者が関わった瞬間に、その仕組みは限界を迎えます。例えば木曜日に5つのエージェントを動かしたとしましょう。翌週の月曜日にチームメンバーから「決済クライアントのリトライ処理が変更された理由は何か」と尋ねられたとします。その答えは、運良く該当のworktreeがまだ開かれていれば、あなたのノートPCのターミナルペインに残っているかもしれません。しかし、そのコードを生成させたプロンプト自体は消えており、手元に残る唯一の確かな記録は、AIモデルが作成したコミットメッセージだけです。
プロンプトは永続的な作業記録にはなりません。また、個人のコックピットはチームのワークシステムではありません。これらはOrcaの欠陥ではなく、単一の作業者向けに設計されたデスクトップアプリケーションが本質的に抱える境界線なのです。
ペイン単位の分離か、Task単位の分離か
SharklyとOrcaは、製品カテゴリの名称から受ける印象以上に多くの設計思想を共有しています。どちらも並行して動くエージェント同士の衝突を防ぐために作業環境を分離します。また、既存の開発ツールを置き換えるのではなくインストール済みのツールをそのまま活用し、それらのツールに設定されたサブスクリプションやAPIキーを通じてモデルを利用する点も共通しています。
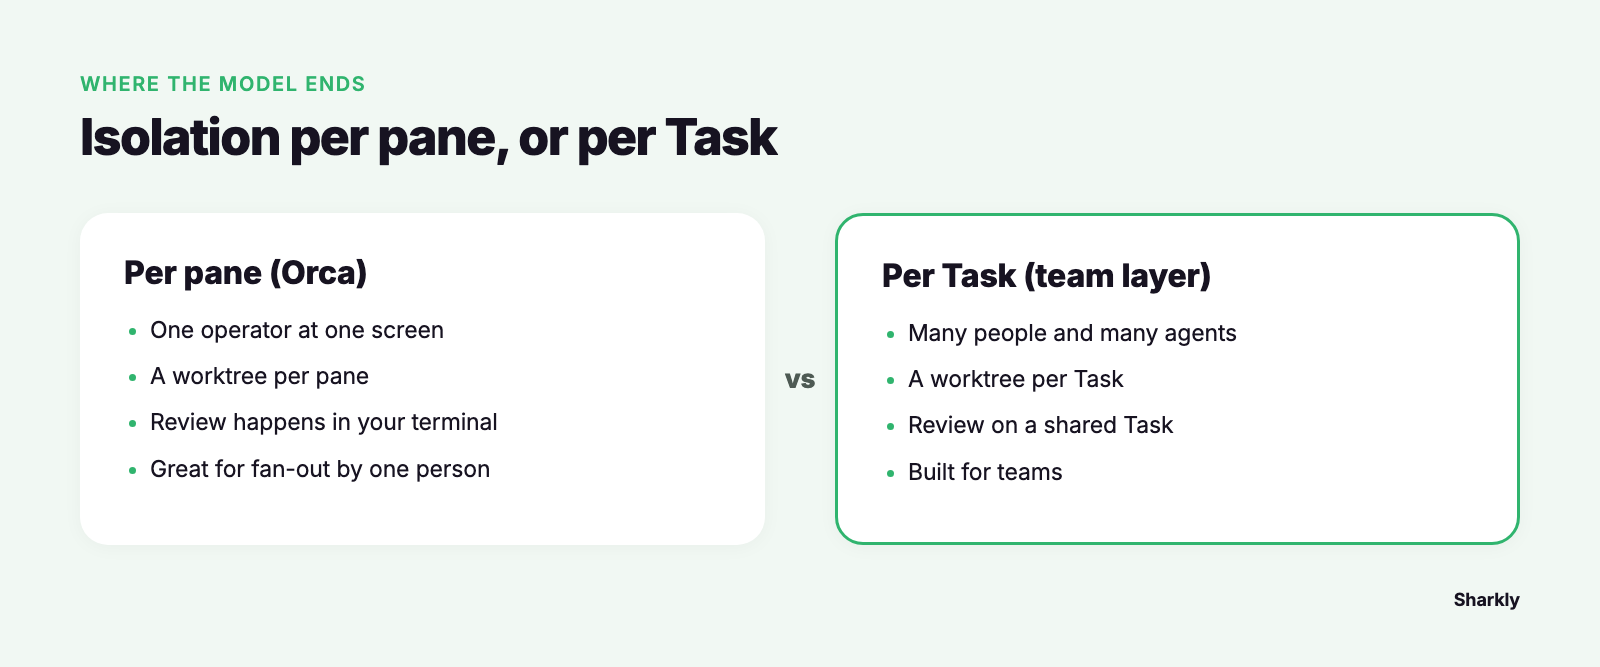
異なるのは「何を単位として分離するか」です。
Sharklyにおける主要な作業単位は「Task」です。リポジトリでの作業はTaskの実行ごとに独立したディレクトリとGit worktreeで実行されるため、Orcaがペイン間を分離しているのと同一の仕組みを用いて、チーム全員が確認できる単位で割り当てられた作業を分離・管理できます。
各コンポーネントには単一の明確な役割が与えられています。Agentは作業の進め方を定義し、Computerはホスト環境とローカルリソースを提供します。Runtimeが実際のエージェントセッションを実行し、Taskがチーム共通の記録として保持されます。
Sharklyは、Claude CodeやCodex、あるいはローカル開発環境としてのOrcaを置き換えるものではありません。チームがすでに活用しているツールの外側に、共有タスク、Computer、コンテキスト、制御、そしてレビューのためのレイヤーを追加するプラットフォームです。
このアーキテクチャにより、個人向けコックピットでは実現できない2つの機能がもたらされます。1つ目は、1つのリーダーAgentによって統括される人間とエージェントの再利用可能なグループであるCrewです。これにより、ファンアウトに「統合(シンセシス)」のステップが加わります。人間が5つの差分を見比べて判定する代わりに、リーダーがゴールを解釈し、必要なメンバーをアサインして、それらの成果を1つのTaskにまとめ上げます。2つ目は、バックログにあるTaskは勝手に実行されないため、コードが実際に実行される前に事前の準備と承認プロセスを挟める点です。
実行ログ、ブロッカー、結果、そしてその後のディスカッションはすべてタスクのタイムラインに集約されます。週明けの月曜日に質問を受けても、画面録画を掘り返すことなく明確な答えを提示できます。
どちらを選ぶべきか
個人で開発しており、最初から最後まで自分1人で作業を完結させ、ボトルネックが「同時に操作できるエージェントの数」にあるなら、Orcaを選びましょう。この用途においてOrcaは最高のデスクトップツールであり、今すぐ導入する価値があります。
エージェントが何を実行したかを他の開発者も把握する必要がある場合、リリース前にレビューを実施しなければならない場合、あるいは3か月後に「何がなぜ変更されたのか」を誰かが確認する可能性がある場合は、共有ワークシステムを選んでください。判断基準はチームの規模ではありません。「作業記録がセッションの終了後も残り続ける必要があるかどうか」です。
多くのチームが両方を併用しており、それらは美しく調和します。エージェントが調査、実行、テスト、報告を行い、人間が方針を決定し、権限を付与し、最終的な成果を承認するのです。
よくある質問(FAQ)
Orcaではどのエージェントを実行できますか? CLI対応のエージェントなら何でも実行可能です。Claude Code、Codex、Cursor CLI、Copilot CLI、OpenCode、Grok、Amp、Pi、Devin、Goose、Cline、Continue、Kimi、Qwen Codeなどが公式に明記されています。
並行してエージェントを動かすために追加のサブスクリプションが必要ですか? 不要です。Orcaはお手持ちのアカウントをそのまま使用します。ただし複数同時に実行するとプランのレートリミットに達しやすくなりますが、これはツールの問題ではなく契約プランに依存する問題です。
1つのリポジトリで5つのエージェントを動かしても安全ですか? ファイルに関しては安全です。それぞれに独立したworktreeが割り当てられるためです。ただし、データベース、開発サーバー、ポート番号など、リポジトリ外部の共有状態の管理は依然として開発者自身で行う必要があります。
生成された複数の差分からどのように選べばよいですか? すべての差分に対して同じテストスイートを実行し、合否を判定させてください。テストで候補の優劣を判断できないのであれば、ファンアウトの並列数を増やす前にテストを改善すべきです。
OrcaとSharklyのどちらを選ぶべきですか? 両者は役割のレイヤーが異なり、組み合わせて利用できます。Orcaは個人がその場でエージェントを直感的に操作するためのツールであり、Sharklyは人々の間で作業を割り当て、追跡し、レビューするためのツールです。個人開発であればOrcaだけで十分な場合もあります。より詳しい比較については、並列AIコーディングエージェント管理ツールをご覧ください。
まとめ
Orcaは、個人の開発者が抱えるスループットの課題に対する現時点で最も強力なソリューションです。並行worktree、本格的なターミナル機能、差分へのアノテーション、リモート実行、モバイル連携などが統合された本格派ツールであり、手持ちのサブスクリプションをそのまま利用できる点も理にかなっています。
Orcaが生み出すのは、1時間あたりにより多くの解決策の候補です。それらを適切に取捨選択でき、かつ何が起きたかを自分自身で把握し続けられるのであれば、開発は大いに前進します。しかし、それらの判断や記憶に他の誰かが関わる必要があるなら、作業には「Task」という単位が不可欠になります。Sharklyは同じworktreeの分離機構をチーム全体に見える単位に適用し、そのレイヤーをしっかりと支えます。


