
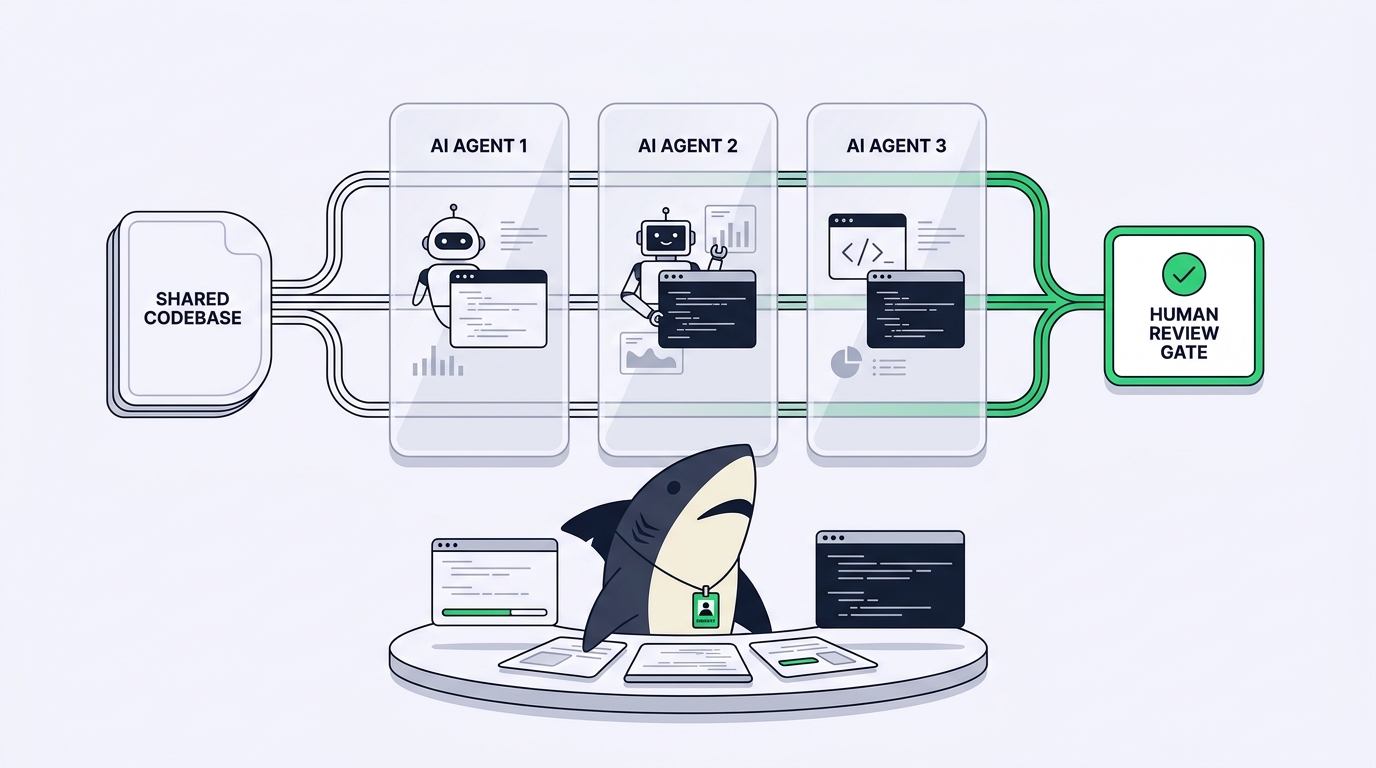
同じチェックアウトでコーディングエージェントを 2 体走らせれば、1 時間も経たないうちにその失敗の形に直面する。片方のエージェントが編集中にもう片方がブランチを切り替える。ステージ済みの変更が、本来属さないコミットに紛れ込んで消える。もう一方のエージェントが半分書き換えたファイルに対してテストが通ってしまう。どれもモデルのせいではない。git のワーキングツリーは共有された可変状態であり、調整なしに共有状態を書き換える 2 つのプロセスは、いずれそれを壊す。
定番の解決策はよく知られている。エージェントごとに専用のワーキングツリーを与えるのだ。Git worktree を使えば、1 つのリポジトリが複数のチェックアウト済みディレクトリを同時に提供できるため、並行するブランチがディスク上の同じファイルに触れることはない。多くのチームがこれを手作業でスクリプト化しており、AI コーディングエージェントで git worktree を使うためのガイドで、その DIY セットアップを順を追って説明している。
本記事で扱うのはもう一方の道、つまり分離、ディレクトリの準備、並行数の上限、クリーンアップをシェルスクリプトではなくプラットフォームが担ったらどうなるか、という話だ。
TL;DR
Sharkly は、接続されたコンピューター上でタスクの実行ごとに専用の分離ディレクトリを与えることで、マージコンフリクトなしに AI エージェントを並行実行する。そのコンピューター上のローカルサービスが、キューに入った各実行を受け取り、タスクディレクトリを準備し(リポジトリを使う作業では実行ごとに別々の git worktree)、選択されたランタイムを起動して、進捗・トレースイベント・結果をタスクへストリーミングで返す。エージェントとコンピューターの並行数制限が同時に実行される数を抑え、何かが自動でマージされることはない。結果はタスクに戻り、そこで人が変更をレビューしてマージとリリースの段階を判断する。エージェントがワーキングツリーを共有することはないため、並行するタスク同士がお互いの変更を上書きすることはない。
Sharkly が防ぐために設計された失敗パターン
エージェントがチェックアウトを共有すると何が壊れるのかを正確に見ておくと役に立つ。症状のそれぞれが、修正のどの部分に対応するのかが見えてくるからだ。
ブランチの状態はワーキングツリーごとにグローバルなので、エージェント A が自分のブランチをチェックアウトすると、実行の途中でエージェント B のファイルが変わる。インデックスも同様にグローバルであるため、git add と git commit が異なるタスクの作業を混ぜ合わせてしまう。追跡されていない状態も衝突する。ある実行のビルド成果物や依存関係のインストールが、別の実行のテスト結果を汚染する。そしてクリーンアップの負債が積み上がる。最初の 3 つの問題を避けるために作られた場当たり的なリポジトリのコピーは、誰かがその存在を思い出すまでディスク上に残り続けるからだ。
共有ディレクトリ 1 つでは、安全に走らせられるエージェントは常に 1 つだけだ。これを tmux のペインと根性で回しているなら、複数の Claude Code エージェントを並行実行するという記事で、なぜその上限がこれほど早く訪れるのかを説明している。
実行スタック:エージェント、コンピューター、ランタイム、タスク
Sharkly は Claude Code や Codex などの実行ツールを置き換えるものではない。チームがすでに使っているツールの周りに、共有されたタスク、コンピューター、コンテキスト、コントロール、レビューの層を追加する。この「層」という位置づけが並行実行の仕組みを形づくる。Sharkly の役割はコードを書くことではなく、実行を調整することだからだ。
4 つの役割が作業を分担し、それぞれの仕事は 1 つだけだ。
- エージェントは作業をどう扱うかを定義する。指示、スキル、リポジトリ、実行設定などだ。エージェントは実行ホストではない。
- コンピューターはホストとローカルリソースを提供する。ローカルマシン、リモートサーバー、コンテナ、対応するクラウドホストなどだ。接続方法については姉妹記事のSharkly のコンピューターで扱っている。
- ランタイムは実際のエージェントセッションを実行する。そのコンピューターにインストールされた具体的なツールであり、Claude Code、Codex、Gemini CLI などが該当する。
- タスクはチームの共有記録であり続ける。ゴール、ステータス、ディスカッション、実行トレース、結果が集まる場所だ。
これらをつなぐのが、コンピューター上で動く小さなローカルサービスだ。コンピューターを登録し、インストール済みのランタイムを検出し、キューに入った実行を受け取り、実行ごとにタスクディレクトリを準備し、ランタイムを起動して結果を報告する。接続はこのサービス側からサーバーへ張られるため、一般的な構成では受信ポートを開ける必要はない。
この分離があるからこそ、並行実行が扱いやすくなる。作業ディレクトリはエージェントが選ぶのではなく、実行ごとにローカルサービスが準備する。だから 2 つのタスクに割り当てられた 2 つのエージェントが、同じコンピューター上の同じリポジトリを対象にしても、互いのファイルを見ることはない。エージェントの設定方法については、Sharkly のエージェントを参照してほしい。
実行が始まると何が起こるか
タスクをエージェントに割り当ててバックログから移動させると、Sharkly は実行の準備状況を確認し、実行可能なランをキューに入れ、選択されたコンピューターへディスパッチする。そこからはローカルサービスが引き継ぐ。ランタイムが始まる前に、並行実行の空きを待つ、分離された一時ディレクトリを準備するか指定ディレクトリの空きを待つ、設定されたリポジトリを取得する、許可された環境変数を反映する、ランタイムの起動コマンドを組み立てる、といった処理が必要になる場合がある。
そうして初めてランタイムが起動する。実行は明示的な状態をたどる。Queued(キュー済み)、Dispatched(ディスパッチ済み)、Waiting for local directory(ローカルディレクトリ待ち)、Running(実行中)、そして最後に Completed(完了)、Failed(失敗)、Canceled(キャンセル)のいずれかだ。これらの状態はタスクの実行ログに表示されるので、「なぜまだ何も起きていないのか」に対して、推測ではなく確認できる答えが得られる。並行数制限の上限に達して Queued で止まっている実行と、Waiting for local directory で止まっている実行は見分けがつき、その違いがどのつまみを回すべきかを教えてくれる。
ここで、存在しないものに注目してほしい。エージェントがどこで実行するかを決める場面は一切ない。指示を持ってくるのはエージェント、分離を持ってくるのはインフラだ。
分離された worktree:Temporary モードの仕組み
エージェントは作業ディレクトリのモードを 2 つサポートしており、並行作業のために作られたのが Temporary モードだ。各タスクは分離されたディレクトリを取得し、リポジトリを使う作業ではローカルサービスがキャッシュ済みのリポジトリデータから、実行ごとに別々の git worktree を準備できる。
この一文に、コンフリクト防止の話がすべて詰まっている。worktree は基盤となるリポジトリオブジェクトを共有しつつ、実行ごとに独自のチェックアウト済みディレクトリと独自のブランチ状態を与える。先ほどの 4 つの失敗モードは構造上消える。共有されたブランチポインタも、共有されたインデックスも、共有されたビルド成果物もなく、ディレクトリは後からプラットフォームがクリーンアップできる。worktree は新規クローンではなくキャッシュ済みデータから作られるため、起動コストは妥当な範囲に収まる。ただし、実行時にリポジトリを更新するためのネットワークアクセスが必要になることはある。
ドキュメントは使うべき場面をはっきり示している。Temporary モードは並行してコードを変更する場合、そして複数のタスクが同時に同じコードベースを変更する可能性があるあらゆる状況に推奨される。
1 つはっきり言っておくべき境界がある。分離が防ぐのはワーキングツリーの衝突であり、意味的なコンフリクトではない。2 つのタスクが同じ関数を書き換えれば、どちらの実行もそれぞれの worktree で問題なく完了し、重なり合った部分はレビュー時に人が調整する。これに対する答えは、同じ日の午後に同じコードを狙わないようにタスクの範囲を切ることだ。これはインフラの判断ではなく、計画の判断である。
分離が適切でない場合:Specified モード
2 つ目のモードが存在するのは、実行ごとに新しいディレクトリを用意するのが無料ではないからだ。Specified モードでは、エージェントはプール内の設定済み絶対ローカルディレクトリの 1 つの中で実行され、すでにあるリポジトリ、依存関係、キャッシュを再利用する。利用できるのはローカルのコンピューターのみだ。
このトレードオフには避けられない帰結がある。指定ディレクトリは一度に 1 つの実行しか処理できず、すべてのディレクトリが埋まっていれば次の実行は待つ。Specified モードで複数のタスクを同時に実行しなければならないエージェントには、プールに複数のディレクトリが必要だ。
| Temporary モード | Specified モード | |
|---|---|---|
| 実行ごとのディレクトリ | 実行ごとに新しい分離ディレクトリ、リポジトリ作業では worktree | プールから選ばれる設定済みの絶対ディレクトリ 1 つ |
| 並行時の安全性 | 実行同士が互いのファイルに触れることはない | 1 ディレクトリにつき同時に 1 実行 |
| 起動コスト | 実行のたびにキャッシュ済みリポジトリデータからディレクトリを準備 | 既存のコード、依存関係、キャッシュを再利用 |
| 向いている用途 | 並行したコード変更、ほとんどのリポジトリ作業 | 非常に大きなリポジトリ、コストの高いローカル状態、ディレクトリに縛られたツール |
| 利用可能な環境 | 接続されたすべてのコンピューター | ローカルのコンピューターのみ |
分離は準備のコストと引き換えに安全性を買い、再利用は直列化のコストと引き換えに速度を買う。Sharkly はエージェントごとに明示的に選ばせる。壊れたワーキングツリーの中でそのトレードオフに気づくより、ずっと良い。
並行数の制限:並行だが上限あり
無制限の並行実行は、それ自体が 1 つの失敗モードだ。並行実行はそれぞれ CPU、メモリ、ディスク、モデルプロバイダーの容量、リポジトリの帯域を消費する。1 台のラップトップで 8 つのエージェントが奪い合えば、3 つが余裕をもって動くより悪い結果になる。
Sharkly は 2 つのレベルで並行数を制限する。コンピューターはホストとしてタスク並行数の上限を持ち、各エージェントには並行実行できるタスクの最大数とタスクごとのタイムアウトがある。デフォルトは控えめだ。Temporary モードのエージェントはコンピューターの上限の 50 パーセント、Specified モードでは設定されたディレクトリ数と同じになる。ディレクトリ数より大きく設定すると、タスク間で書き込みが衝突する可能性があると製品が警告する。この警告は、本記事の主張を 1 つのダイアログに凝縮したものだ。
上限を引き上げる際のドキュメントの指針は実に堅実で、現在のコンピューターとランタイムが既存のワークロードを安定して処理できるようになってから並行数を上げるべきだ、というものだ。
進捗のストリーミングとマージ前のレビュー
分離が「見えなさ」も意味するなら、それはむしろ足かせになる。5 つのエージェントが 5 つの隠れたディレクトリで動く——まさに作業がプライベートなターミナルの中へ消えていく典型例だ。だから実行が生み出すものはすべて、共有の記録へと流れ戻る。
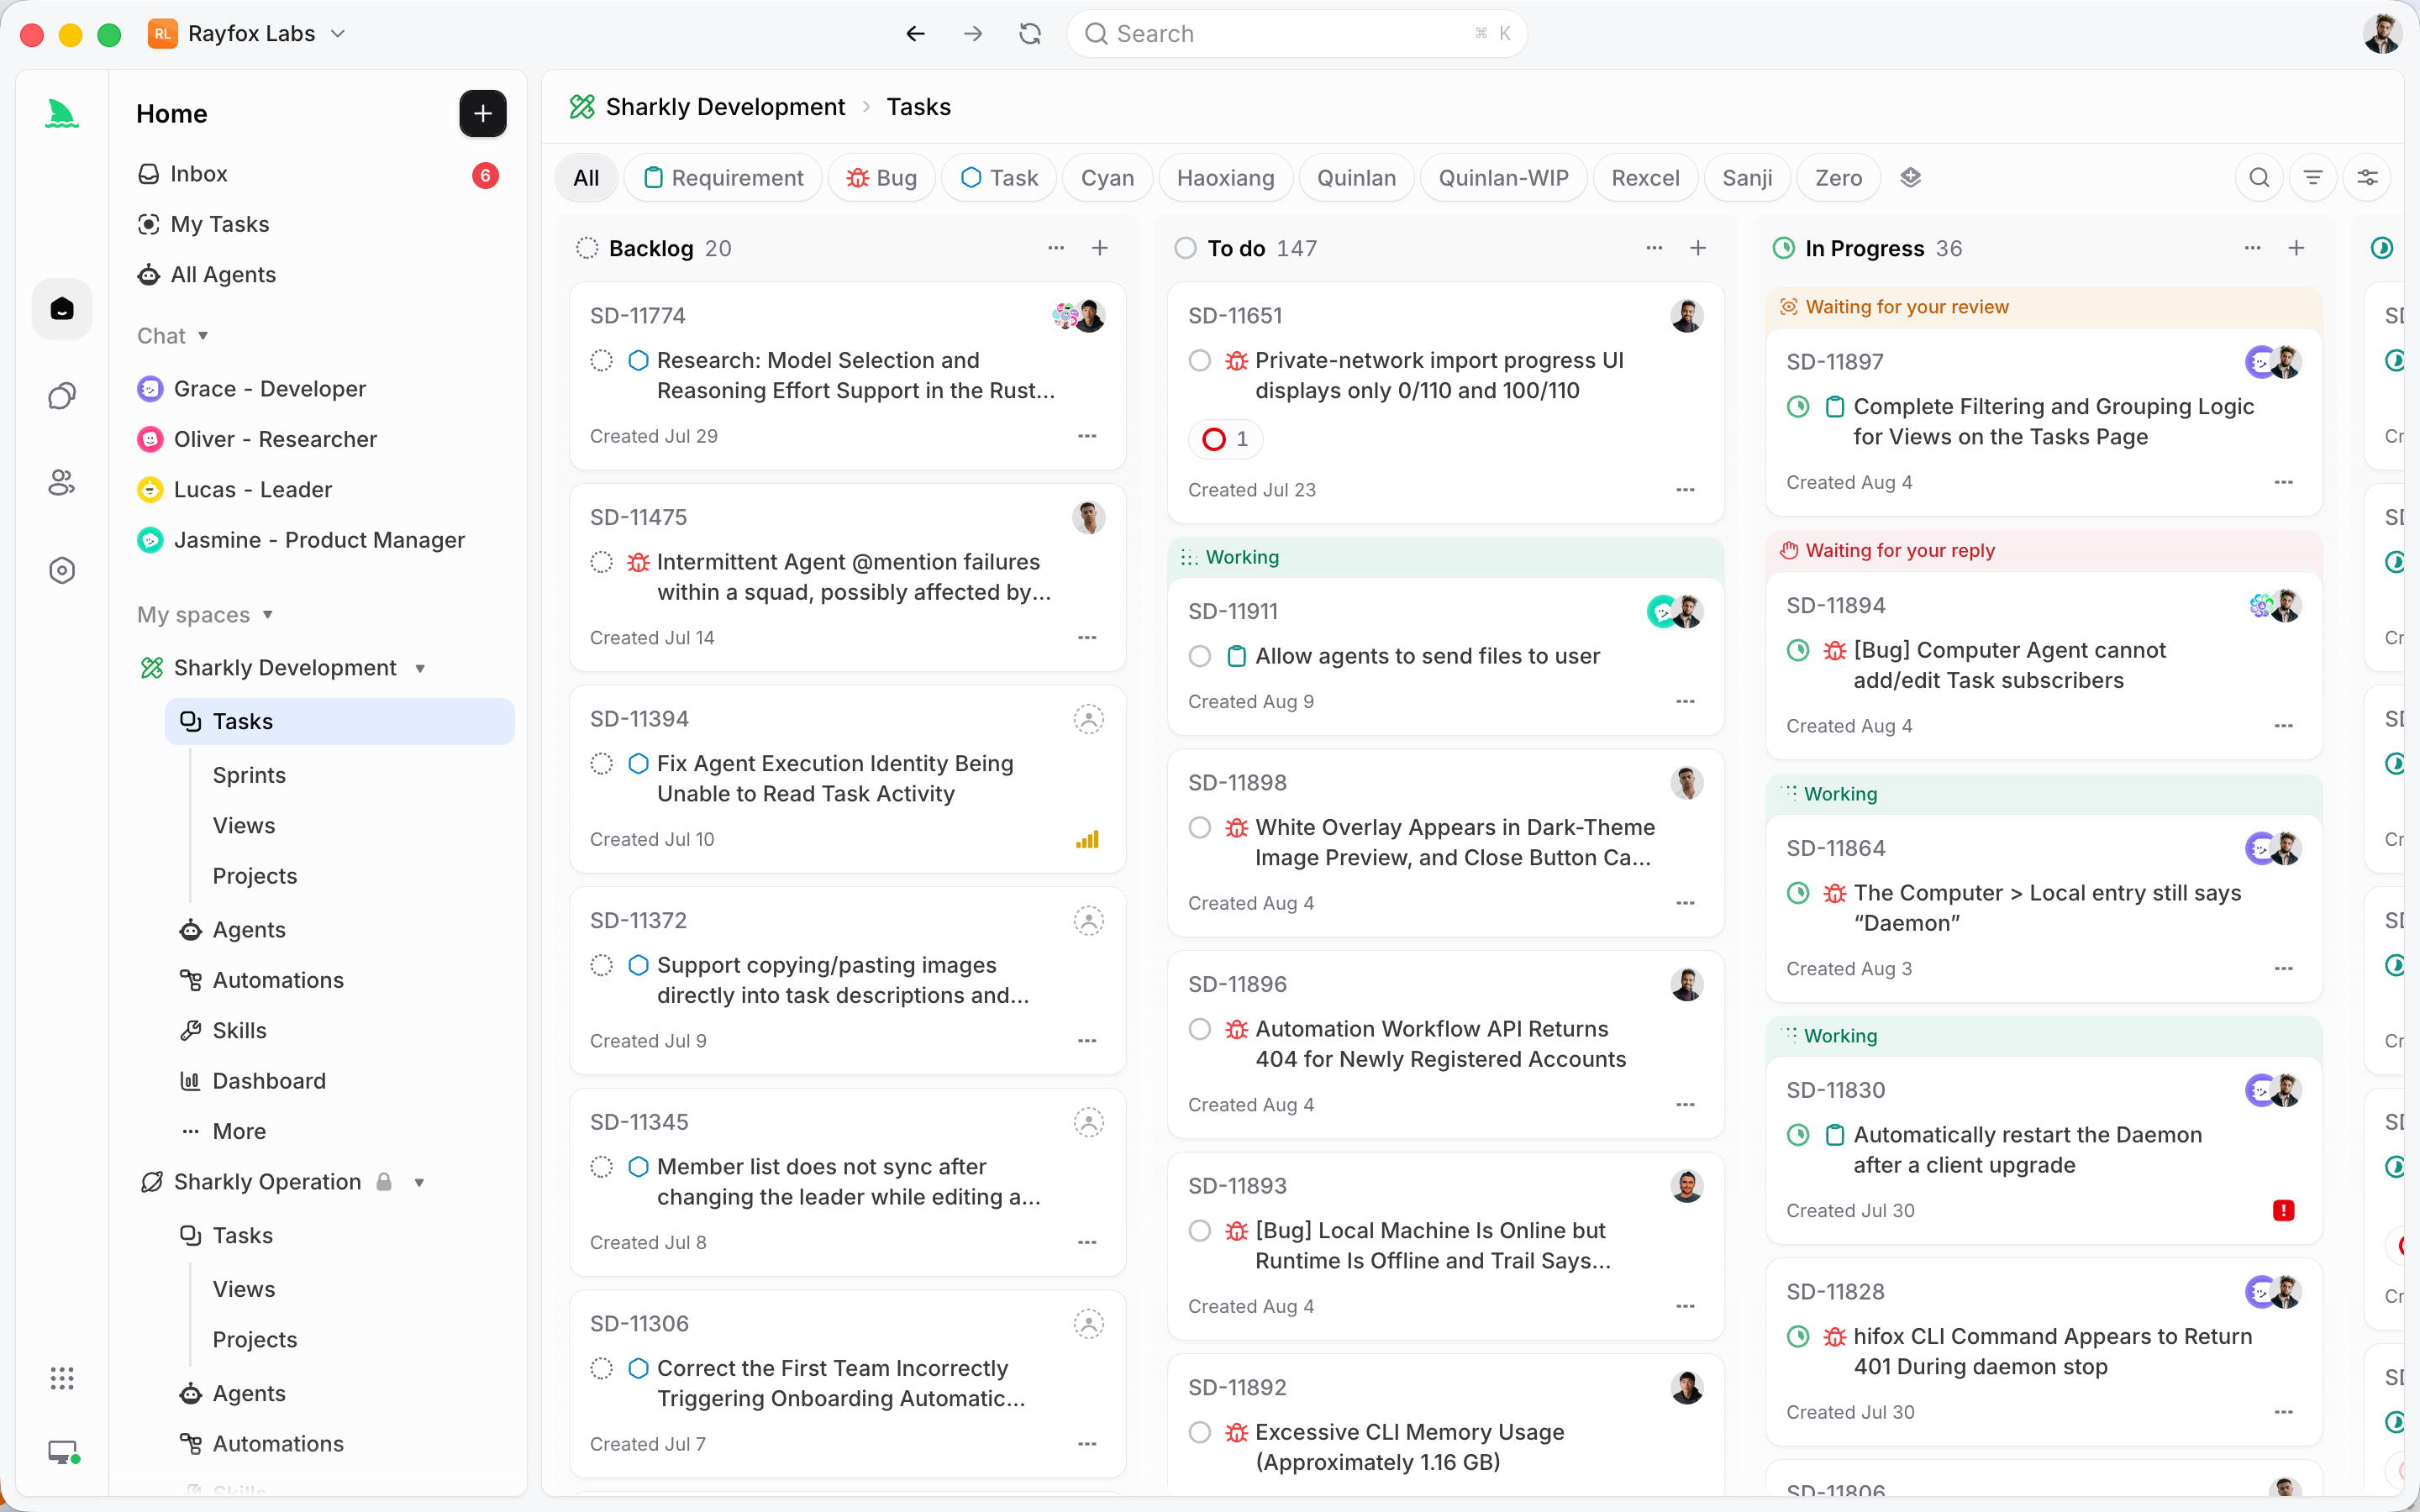
実行中、タスクはその実行状態を表示する。アクティビティにはコメントとタスクの変更がタイムラインとして残る。実行ログには実行の開始と終了、ツール呼び出しとランタイムのイベント、トリガー元、失敗の詳細が記録される。エージェントのレポートは実行トレースに紐づいたコメントとして保存される。ファイルの編集は誰も開かないディレクトリで起きたとしても、コンテキスト、進捗、ブロッカー、結果はリクエストからリリースまで見えるままになる。
そしてゲートがある。ここでは何も自動でマージされない。エージェントは調査し、実行し、テストし、報告する。人は方向性を定め、権限を与え、結果を受け入れる。実行が完了すると、エージェントはタスクを人のレビュー待ちの状態にでき、それは担当者の受信トレイに表示される。分離された worktree が並行実行を安全にし、レビューのゲートがそれを信頼できるものにする。
もう 1 つ、ループを閉じる要素がある。クリーンアップだ。エージェントの実行はコンピューター上に作業ディレクトリと成果物を残す。設定可能なクリーンアップは、保存期間を過ぎた完了済みの実行を回収し、空き容量の最小しきい値を最後の砦として備えている。実行中またはキュー待ちの作業、ピン留めされた実行、まだ調査が必要な失敗した実行には一切触れない。これは DIY 構成がディスクいっぱいになるまで確実に忘れる雑用だ。
Sharkly が自動化する部分と DIY 構成の違い
DIY worktree ガイドを読んでいれば、対応関係は明白だ。エージェントごとにスクリプトで書いていた git worktree add は、実行ごとに分離ディレクトリを準備するローカルサービスになる。「エージェントはいくつから多すぎるのか」という判断は、設定が危険なときに警告を出す明示的な並行数制限になる。忘れてしまう git worktree prune は、保存期間に基づくクリーンアップになる。そしてどのスクリプトも与えてくれない部分、どの実行が何をしたのか、人がそれを受け入れたのかを記録する共有の記録が、タスクそのものだ。
率直なトレードオフの見極めはここでも当てはまる。1 台のマシンで 2 つのエージェントを動かす個人開発者にプラットフォームは必要ないかもしれない。worktree スクリプトと規律でかなり遠くまで行ける。Sharkly に手を伸ばすのは、調整のコストがタイピングのコストを上回ったときだ。複数の人が作業を割り当て、複数のコンピューターがあり、実行のキューイングとレビューが必要になったとき。どちらの道でも、すでに使っているランタイムをそのまま使い続けられる。モデルの利用は、それらのツールに設定したサブスクリプションや API キーを通じて続く。
始め方は意図的に小さく設計されている。コンピューターを 1 つ接続し、Temporary モードでエージェントを 1 つ作成し、リスクの低いタスクを 1 つ割り当てる。はじめかたガイドが最初のループを約 10 分で案内し、Sharkly ドキュメントが各概念を詳しく解説し、Sharkly とは何かが実行をとりまくプラットフォームの全体像を埋めてくれる。
よくある質問
Sharkly は並行するエージェント間のマージコンフリクトをどう防ぎますか?
タスクの実行ごとにコンピューター上の分離されたディレクトリが与えられ、リポジトリを使う実行ではそれぞれ、ローカルサービスが準備した別々の git worktree を取得できる。エージェントがチェックアウトやインデックス、未追跡ファイルを共有することはないため、並行する実行が作業中の内容を上書きすることはない。2 つのタスクが意図的に同じコードを変更するような重なりは、レビュー時に人が調整する。
Sharkly を使うために自分で git worktree をセットアップする必要はありますか?
いいえ。Temporary モードでは、ローカルサービスが実行ごとにタスクディレクトリを準備し、リポジトリを使う作業では worktree も用意する。モードはエージェントに一度設定するだけで、実行ごとに worktree のコマンドをスクリプト化する必要はない。仕組みそのものを理解したい場合は、git worktree のドキュメントを参照してほしい。
1 台のコンピューターで何個のエージェントを並行実行できますか?
コンピューターには独自のタスク並行数制限があり、各エージェントには並行実行できるタスクの最大数がある。デフォルトでは、Temporary モードのエージェントはコンピューターの上限の 50 パーセント、Specified モードでは設定されたディレクトリごとに 1 スロットを取得する。上限を超えた実行はキューで待機する。
Sharkly はエージェントの変更を自動でマージしますか?
いいえ。実行の結果、エビデンス、トレースはタスクに戻り、出荷前に人が変更サマリーをレビューする。レビュー担当者は承認するか、変更を依頼するか、マージとリリースの段階を判断する。自動化はチームの判断が必要なところで止まる。
分離された worktree ではなく Specified モードを使うべきなのはどんなときですか?
実行ごとに新しいディレクトリを準備するのが本当に高コストな場合だ。非常に大きなリポジトリ、生成コストの高い状態やキャッシュ、1 つのローカルパスに縛られたツールなどが該当する。指定ディレクトリは一度に 1 つの実行しか処理できないことを受け入れる必要がある。それ以外の場合は、Temporary モードが推奨のデフォルトだ。


