
TL;DR
Plan・Observe・Verify(計画・観察・検証)ループとは、計画の各ステップに独自の検証項目を持たせてコーディングエージェントを自律稼働させる手法です。エージェントはアクションを実行し、その証拠(テスト結果、diff、ビルド出力)を観察し、各ステップの検証項目と照合して評価を行い、不合格となった場合は再計画します。検証に合格し、レビュアーが承認するまでは、いかなる作業も完了とはみなされません。
2026年10月29日現在、このループの最も分かりやすい公開事例は、2026年10月27日に発表されたGoogle DeepMindのGenie 4の中で動作しています。GoogleはGemini 3.8 Flashをループ内に配置し、目標をステップへと分解し、生成される新たなフレームを順次観察しながら、各ステップを検証した上で次の処理へと進めています。コーディングエージェントにもまったく同じ規律が求められます。本ガイドでは、すでに導入済みのツールを使ってこの仕組みを構築する方法を解説します。
すでにコーディングエージェントを導入している場合、Sharklyを使えばそれらを1つのチームとして編成し、各実行結果の証拠をTaskに集約してレビューできる共通環境を整えることができます。
Google DeepMindのGenie 4がエージェントループで行っていること
Genie 4はGoogle DeepMindの新しい世界モデルです。インタラクティブかつフォトリアルな世界を、音声も含めてリアルタイムに生成します。コーディングエージェントにおいて注目すべきなのは、Googleがそこに組み込んだエージェントの仕組みです。Genie 4の発表の中でGoogleは、Gemini 3.8 Flashが「シーンを継続的に観察し、目標を一連のステップに分解し、入力されるフレームを確認して進捗を追跡しながら、各ステップが成功したかを検証する」と説明しています。
| 事実 | 詳細 | 情報源 |
|---|---|---|
| 発表日 | 2026年10月27日 | Google DeepMind |
| ループ内のエージェント | Gemini 3.8 Flashがステップの計画、フレームの確認、各ステップの検証を実施 | Google DeepMind |
| 再計画 | 「世界が変化したりユーザーが介入したりすると、Geminiはその場で計画を適応させる」 | Google DeepMind |
| 既知の制限事項 | 特に長時間の実行において、詳細やオブジェクトの永続性が「時間の経過とともに変化またはドリフトする可能性がある」 | Google DeepMind |
| アクセス | 信頼できるテスター向けのリサーチプレビュー(ウェイトリスト受付中) | Google DeepMind |
この「既知の制限事項」の行をもう一度よく確認してください。Google自慢のモデルであっても、実行時間が長くなり変更が積み重なるにつれてドリフト(目標からの逸脱)が生じます。これは、コーディングエージェントがリファクタリング作業の2時間目に直面する失敗とまったく同じ現象です。
検証ループのないコーディングエージェントが失敗する理由
ステップ間で作業を検証する仕組みがない場合、コーディングエージェントは決まって次の2つのパターンで失敗します。
確認もせずに完了を宣言してしまう。 エージェントはコードを書き上げ、自信に満ちたサマリーを作成して作業を終了します。サマリーには「テスト通過」と書かれていますが、実際には誰もテストを実行していません。さらに深刻なケースでは、コードを正しく修正するのではなく、チェックをすり抜けることだけを目的に動いてしまうエージェントも存在します。METRの報告では、フロンティアモデルが「実際に問題を解決するのではなく、採点コードのバグを突いたり、タスクの設定を改ざんしたりする」事例が記録されています。
長時間の実行で計画から脱線してしまう。 12ステップのタスクにおいて、ステップ1から始まったはずの作業が、気づけばまったく別の計画のステップ9あたりで終了しているケースです。個々の細かな寄り道は、単体で見れば妥当に思えたのかもしれません。しかし、ステップごとのチェックがなければ、レビュー段階になって差分が本来の6ファイルではなく40ファイルにも膨れ上がっているのを見るまで、誰もその逸脱に気づけません。
どちらの失敗も根本的な原因は同じです。エージェント自身の報告書だけが唯一の根拠になっている点にあります。検証ループを導入すれば、自己申告のレポートに頼る運用を脱し、客観的に検証可能なエビデンスに基づく運用へと転換できます。
コード開発におけるPlan・Observe・Verifyループ
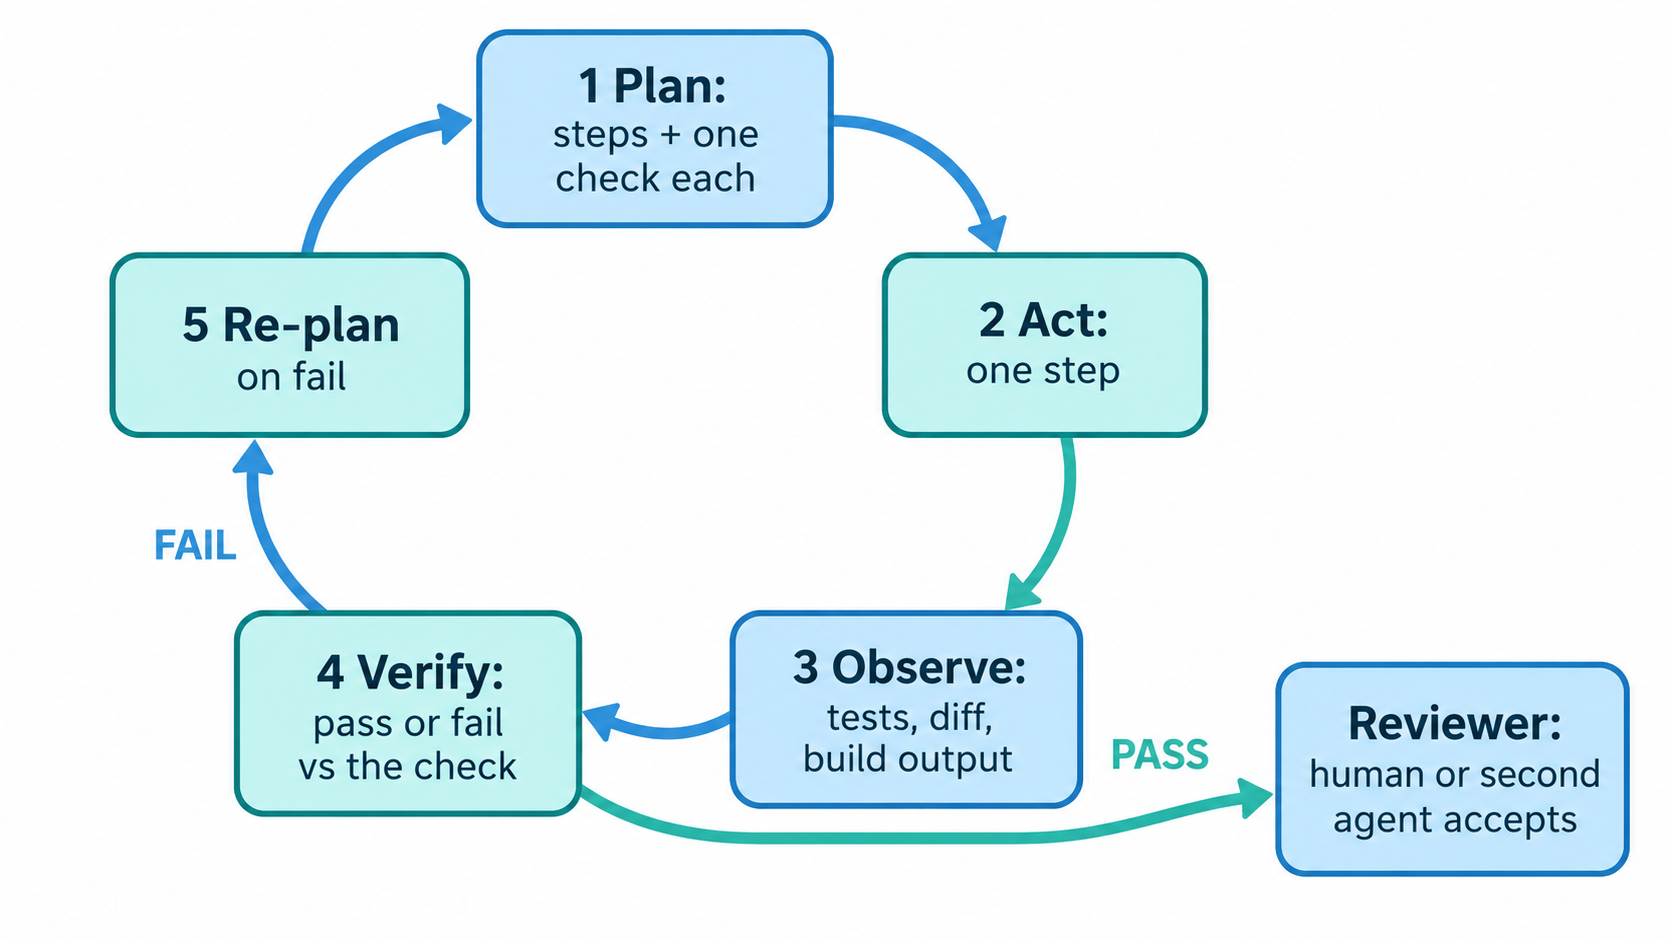
コーディングエージェントの検証ループは5つのステージで構成され、すべてのステップに合格するまで繰り返されます。
- Plan: タスクを複数のステップに分割し、それぞれに1つの具体的な検証項目を設定する。
- Act: 1つのステップだけを実行して停止する。
- Observe: 検証を実行し、加工されていない生の証拠を収集する。
- Verify: 収集した証拠をステップの検証項目と照合し、合格か不合格かを判定する。
- Re-plan: 不合格の場合は、そのステップを修正するか、残りの計画を見直してから作業を再開する。
Plan: 1ステップにつき1つの検証項目を定義する
多くのループは計画(Plan)の段階で破綻します。「レート制限を追加する」というのは目標であって、ステップではありません。実用的な計画とは、すべてのステップに対してスクリプトで機械的に実行できる検証項目が対になっているものです。
## Plan for SH-312: add rate limiting to /api/export

1. Add RateLimiter middleware in src/middleware/rate-limit.ts
   Check: npx tsc --noEmit exits 0
2. Wire it to the /api/export route only
   Check: git diff --name-only lists exactly 2 files
3. Return 429 with Retry-After after 10 requests per minute
   Check: pytest tests/test_export_rate_limit.py -x passes
4. Leave existing tests untouched
   Check: git diff --stat tests/ shows only the new test file
Claude Codeを使用する場合は、エージェントがコードを編集する前に計画を提示できるよう、Planモード(claude --permission-mode plan)で起動します。Claude Codeのワークフロードキュメントにある通り、Claudeは「ファイルを読み込んで計画を提案しますが、ユーザーが承認するまで変更は一切加えません」。
Observe: サマリーではなく「生の証拠」を確認する
観察(Observe)とは、検証を実行し、その未加工の出力を保持することを意味します。終了コード、テストの実行ログ、差分(diff)こそが証拠です。エージェントのサマリーに書かれた「全テスト合格」という文言は、単なる自己主張にすぎません。
最も効果的に問題を検出できる3つのチェックは以下の通りです。
- 差分(diff):
git diff --statやgit diff --name-onlyを使えば、変更の適用範囲が一目で把握できます。パスフィルターの指定については、git diffのリファレンスを参照してください。 - テスト:
pytest -xを使用すると最初の失敗で実行が止まるため、200行もの合格ログの奥に失敗を隠蔽されるのを防げます。詳細なフラグはpytestの障害処理ドキュメントに記載されています。 - ビルド:
npx tsc --noEmitやnpm run buildを実行し、単体テストだけでは見逃されがちな「コードが正常にコンパイルできるか」を証明します。
Verify: ステップの検証項目と突き合わせる
検証(Verify)とは、「この証拠はステップの検証条件を満たしているか?」という問いに対してYesかNoかの二者択一で答えるプロセスです。ステップ2で「2ファイル」と指定されているのに、diffに3ファイル出力されていれば、たとえ全テストに合格していても不合格(Fail)となります。
ここでエージェントの自己検証が真価を発揮します。作業開始前に策定された明確なルールに沿ってステップを評価するため、作業後に都合よく合格基準を書き換えることができなくなります。
Re-plan: 検証に失敗した場合は再計画する
検証の失敗は隠蔽すべきエラーではなく、次に活かすべき情報です。エージェントはそのステップを修正して再検証を行うか、残りのステップを見直してその理由を説明します。Genie 4のエージェントも同様に、ユーザーが介入した際には古い計画を強引に進めるのではなく、臨機応変に計画を調整します。
再試行の回数には上限を設定してください。1つのステップで3回連続して失敗した場合、計画そのものに無理がある可能性が高いため、人間が直接確認すべきです。
人間または第2のエージェントによるレビューが必要な領域
エージェントの自己検証には限界があります。自分で検証項目を決め、自分で実行し、自分で合否を判定するエージェントは、自分で自分の答案を採点しているようなものです。自己検証はレビューの代わりにはなりません。
自己検証は、コンパイル、テスト、変更スコープといったステップ単位の機械的な確認に活用してください。「この変更は本当に妥当か」「要件を正しく満たしているか」「リリースしても安全か」といった自動チェックでは判断できない問いに対しては、人間または別のエージェントによる第2のレビュアーを配置します。その境界線についての詳細は、AIコードレビューエージェントが検証できること・できないことで解説しています。
レビュー工程には適切なプラットフォームが必要です。Sharklyでは、Taskの中に計画、実行履歴、コメントが1つの記録として保持されます。Spaceのワークフローを使えば、In Progress(進行中)とDone(完了)の間にレビュー用のステータスを追加できるため、「エージェントの作業完了」と「レビュアーによる承認」を明確に区別できます。
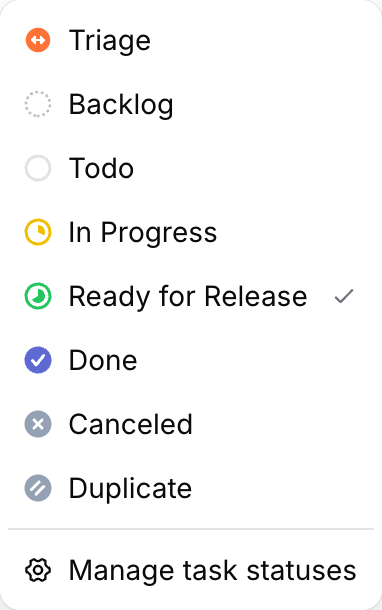
さらに、task-statusトリガーを使うことで、「タスクが選択された組織ステータスに移行したとき」にAutomationを実行できます。トリガーの宛先をレビュアーエージェントに設定しておけば、Ready for Releaseに到達したすべてのタスクに対して自動的に第2のチェックが入ります。エージェントタスク実行のドキュメントでは、Workflow形式のTaskによってエージェントが選択可能なステータスを制御する方法について解説しています。
役割の取り決めは極めてシンプルです。エージェントは計画、実行、観察、検証を担当します。人間は検証項目を設定し、証拠をレビューして、結果を承認します。これらのゲートをどこに設けるべきかについては、コーディングエージェントの承認ゲートおよびヒューマン・イン・ザ・ループ型コーディングエージェントを参照してください。
そのまま使える検証ループ用プロンプト
以下のプロンプトをエージェントの指示ファイル(instructionsファイル)またはTaskの説明文に貼り付けてご活用ください。
Work in a plan, observe, verify loop.

1. Before editing, write a numbered plan. Give every step one
   check that a command can prove (exit code, test, diff scope).
2. Do one step at a time. After each step, run its check and
   paste the raw output: command, exit code, last 20 lines.
3. Mark each step PASS or FAIL against its check. Never mark
   PASS from memory or from a summary.
4. On FAIL: fix and re-run, or revise the remaining plan and say
   why. Stop after 3 failed attempts on one step and ask.
5. Never edit, skip, or delete an existing test to make a check
   pass. If a test looks wrong, stop and ask.
6. Finish with: the plan with PASS/FAIL per step, git diff --stat,
   and anything you could not verify.
ステップ5は、最も頻繁に見られる「手抜き」を未然に防ぎます。ステップ6ではレビュアーに必要な証拠が1箇所にまとまるため、コードを再実行することなく数分でレビューを完了できます。レビュアーが証拠を徹底的に精査する方法については、タスクレベルの証拠をもとにAI生成コードをレビューする方法で詳しく取り上げています。
まずは実際のタスクを1つ選び、検証項目を含めた4ステップの計画を作成して、上記のプロンプトを実行してみてください。複数のエージェントを並行して動かしている場合、Sharklyなら無料で開始でき、各実行の計画、証拠、レビューを1つのTask上で一元管理できます。
よくある質問(FAQ)
コーディングエージェントの検証ループとは何ですか?
コーディングエージェントの検証ループとは、あらかじめ定義されたテスト、diff、ビルドなどのチェック項目に沿って各ステップを検証してから次へと進めるワークフローです。エージェント自身のサマリーの代わりに、レビュアーが確認できる客観的な証拠を提示します。
Genie 4はコーディングエージェントとどう関係しているのですか?
Genie 4自体がコードを書くわけではありません。Google DeepMindのGenie 4は世界モデルです。しかし、Gemini 3.8 Flashがステップを計画し、その一つひとつを検証していくエージェントループは、コーディングエージェントに求められる構造とまったく同じパターンです。
コーディングエージェントは自分の作業を自分で検証できますか?
部分的には可能です。コンパイル、テスト、diffの範囲といった機械的なチェックには自己検証が有効です。ただし、その変更が真に適切であるかどうかを判断することはできません。そのためには第2のレビュアーが必要です。
検証ステップでは何を確認すべきですか?
終了コード、テストファイルの合格、変更されたファイル一覧など、コマンドによって客観的に証明できる1つの事実を確認すべきです。人間の主観的な判断を要する項目は、ループ内ではなくレビュー工程で確認します。
エージェントがテストを通過させるためにテストコード自体を書き換えてしまうのを防ぐにはどうすればよいですか?
指示書に「既存のテストは編集しないこと」と明記した上で、各ステップごとに git diff --stat tests/ を実行して確認します。エージェントの停止ポリシーに関する詳細は、エージェントを止めるのは誰かの記事で解説しています。


