
ArgonかCarbonか?エージェントのタスクの大部分はGemini 4 Argonで実行し、難易度の高いタスクだけをGemini 4 Carbonに任せるのが得策です。これはGoogle自身も明言していることです。大半のソフトウェアエンジニアリング作業にはArgonをデフォルトとし、より難度の高い作業にCarbonを使用することを推奨しています。どちらも2026年11月30日までは100万トークンあたり入力2ドル・出力10ドルと同価格ですが、Carbonの方が1タスクあたりにより多くのトークンを消費します。
TL;DR
- 基本は低コストモデル、確証がある場合のみ上位モデルへ: すべてのタスクは高速・低コストなモデルから開始します。客観的な基準によって難易度が高いと判断できる場合や、すでに1度失敗した場合にのみ上位モデルへ移行します。
- トークン単価が同じでも、タスクあたりのコストは同じではありません: Carbonはより多くを読み込み、より深く推論し、より多くの検証ループを回すため、1タスクあたりに消費するトークン数が多くなります。
- 高難度タスクを見極める4つのシグナル: 長期的なステップ(ロングホライズン)、多数のファイルへの影響、セキュリティへの影響、初回の実行失敗。
- タスクごとに測定すべき2つの指標: コストとレビュー通過率です。ベンチマークのリーダーボードではなく、この2つの数値に基づいてルーティングを判断します。
- モデル選択はプロンプトごとに都度決めるのではなく「設定」にする: Sharklyでは、各エージェントにデフォルトモデルが設定されており、タスクを割り当てる際にその実行回に限りオーバーライドすることが可能です。
なぜ「どのモデルが最高か」という問いは間違っているのか
Gemini 4 Carbonは2026年11月10日にモデルID gemini-4-carbon として一般提供(GA)が開始されました。GoogleのGA発表記事には、新機能のアナウンスとしては珍しい記述があります。大半の作業において最新モデルを使わないよう呼びかけているのです。「ソフトウェアエンジニアリングやナレッジワークの大部分においては、依然としてArgonが理想的な選択肢です」と記されています。
同記事によると、Carbonは「モデルの知能の限界を試すようなタスクのために構築」されており、「徹底的な探索、深い推論、そして広範な検証ループを実行するために、Argonよりも多くのトークンを消費する」と説明されています。
この考え方は、チームでエージェントを運用する際の実態に合致しています。キューには難易度の異なるさまざまなタスクが並んでおり、それぞれのタスクには「レビューを通過できる最も安価なモデル」を割り当てるのが理想です。チーム全体で一律に単一の「最強モデル」を使っていては、簡単なタスクで過剰なコストを払うことになるか、あるいは難関タスクで性能不足に陥るかのどちらかです。
Carbonの全体像を詳しく知りたい方は、概要を解説したコーディングエージェント向けGemini 4 Carbonの記事を、デフォルトモデルについてはGemini 4 Argonガイドをご覧ください。
ルーティングの原則:基本は低コスト、難関タスクのみエスカレーション
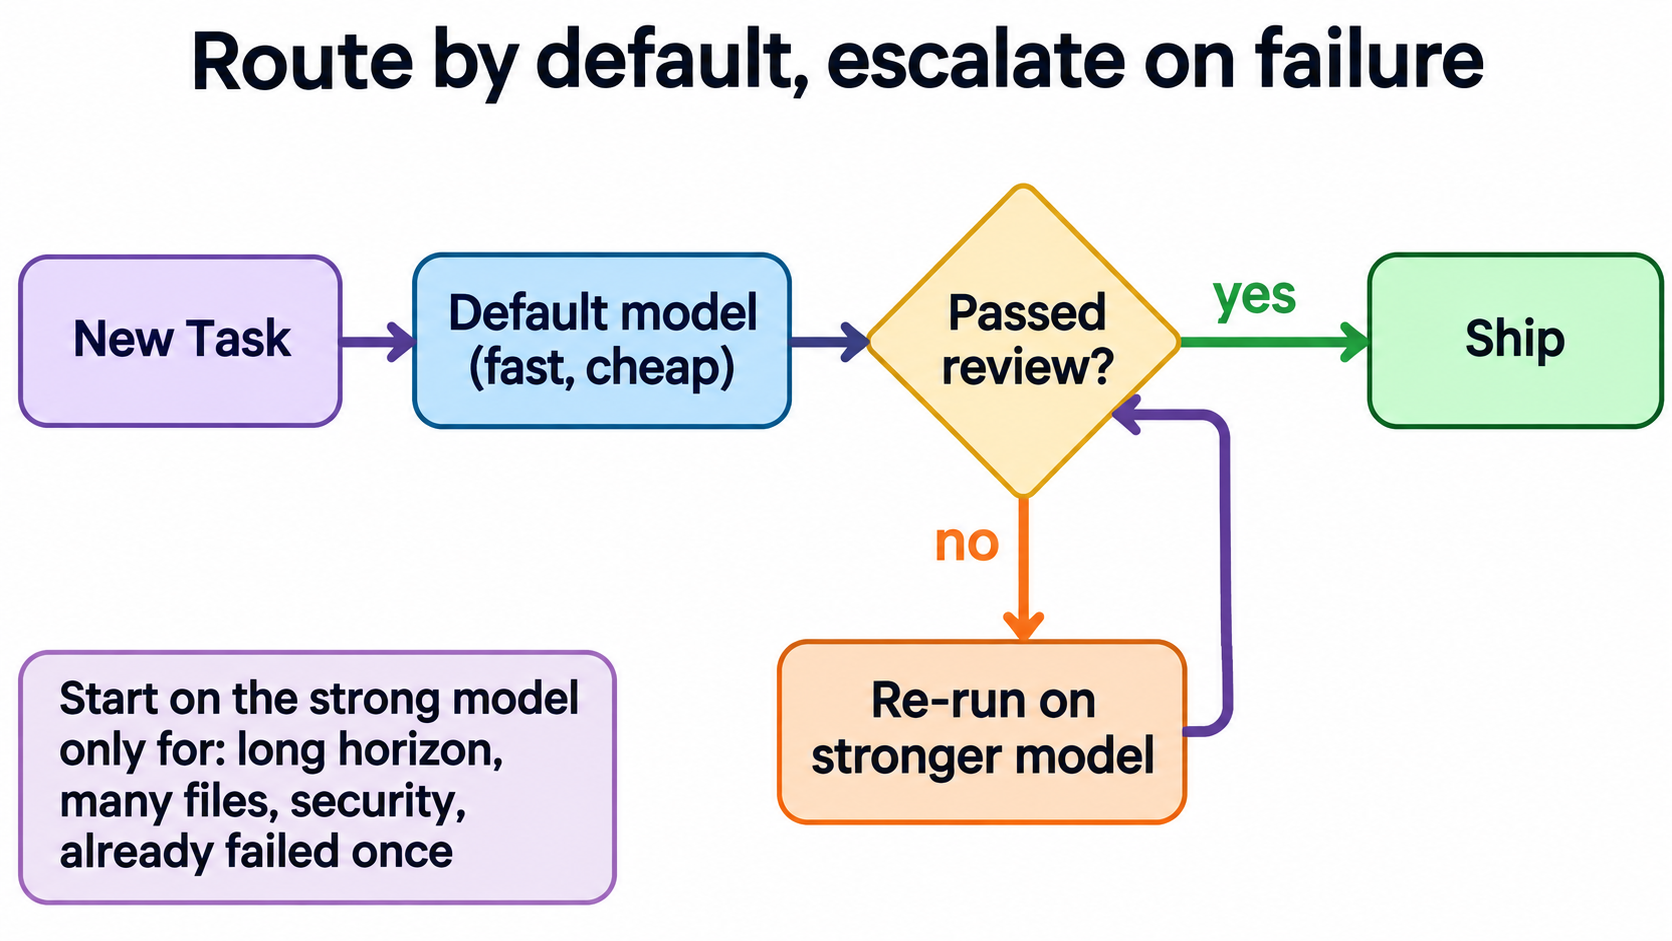
コーディングエージェントのモデルルーティングとは、チーム単位ではなくタスク単位でモデルを選択することを意味します。そのルールは1行で要約できます。すべてのタスクはデフォルトモデルから開始し、事前の明確なシグナルによって難易度が高いと示された場合、またはデフォルトモデルで一度失敗した場合にのみ、より強力なモデルに移行します。
このルールを機能させるには、2つの要素が必要です。
- 大半のタスクに十分対応できる、高速なデフォルトモデル: Geminiを使用するチームにおいては、Google自身の推奨通りArgonがこれに該当します。
- 客観的に検証可能なトリガーを持つエスカレーションパス: 「難しそうに感じた」はトリガーになりませんが、「認証コードに手を加える」は明確なトリガーになります。
タスクの難易度を見極める方法
タスクを実行する前に客観的に判断できるシグナルが必要です。以下の4つでほとんどのケースをカバーできます。
長期的なステップ(ロングホライズン)
10個の依存関係を伴う変更を処理するマイグレーションのように、連続した多数のステップを要するタスクでは、下位モデルほど途中で本来の目的から逸脱(ドリフト)しやすくなります。Carbonの強化された検証ループはまさにこうしたケースを対象としています。シグナル:タスクの説明文に5つ以上のステップが記載されている、あるいは同様の作業の過去の実行で想定時間を超過した実績がある場合。
多数のファイルへの影響
複数の領域を横断するような変更では、モデルが一度にコードベースの広範なコンテキストを把握し続ける必要があります。シグナル:変更が複数のパッケージにまたがっている、または10個以上のファイルに及んでいる場合。
セキュリティへの影響
認証、決済、シークレット情報の取り扱い、パーミッションチェックなどは、もっともらしい誤答が致命的な被害につながる領域です。GoogleのGA発表記事によると、サイバーセキュリティ防御者向けのFairwind Programを通じてアクセスした際、CarbonはSEC-bench ProおよびCWE-bench v1でトップの成績を収めたと報告されています。シグナル:タスクが機密(sensitive)としてマークされたパスに触れる場合。
すでに1度失敗している
これは最もコストがかからず、最も信頼性の高いシグナルです。デフォルトモデルによる実行結果がレビューで不合格となった場合、そのタスクがそのモデルの能力を超えている直接的な証拠になります。レビュアーのコメントを添えて、上位モデルで再実行してください。
すぐに使えるルーティングの目安一覧
まずはこの表を初期設定として利用し、2週間後に自チームの実測通過率に基づいて見直してください。
| タスクの種別 | 開始モデル | エスカレーション先 | 理由 |
|---|---|---|---|
| タイポ、テキスト修正、依存関係のアップデート | 高速ティア(Flashまたはminiモデル) | Argon | 差分が小さく、レビューが容易 |
| 失敗しているテストを伴うバグ修正 | Argon | Carbon | テストにより明確な合否判定が可能 |
| 単一モジュール内の機能実装 | Argon | Carbon | Googleが推奨するエンジニアリングの大半向けデフォルト |
| 多数のファイルにまたがるリファクタリング | Carbon | Fable 5.2 または人間 | ステップ数が多く、関連ファイルが多岐にわたる |
| 認証、決済、パーミッション関連 | Carbon | 必ず人間がレビュー | セキュリティへの影響 |
| レビューで一度失敗した任意のタスク | 1段階上のティア | 人間 | 推測よりも客観的な証拠を優先 |
Claude Fable 5.2の価格は100万トークンあたり入力8ドル・出力40ドルと、Carbonの導入価格の4倍に設定されているため、デフォルトではなくCarbonの上位に位置する最後の自動化ステップとして位置づけられます。Googleの注記によると、Carbon自体の価格も2026年11月30日以降は入力4ドル・出力20ドルへと引き上げられ、価格差は縮小します。予算を設定する前に、Gemini APIの料金ページで最新の数値を確認してください。
事前ルーティングではなく「失敗時のエスカレーション」
チームは往々にして、「難しそう」に見えるタスクを最初からすべて最強のモデルにルーティングしがちです。これは安全策のように思えますが、コストが大幅に跳ね上がります。そうしたタスクの多くは、デフォルトモデルでも十分に合格できるためです。
失敗時エスカレーション方式を採用すれば、すべてのタスクにおいてまずは軽量モデルのコストで済み、上位モデルのコストは必要性が実証されたタスクにのみ支払われます。安価なモデルで1回失敗するコストは、不要な高額モデルを1回走らせるコストよりもはるかに低い場合がほとんどです。
ただし、このルールには2つの例外があり、それらは先ほどの表ですでに網羅しています。1つ目はセキュリティ関連の作業で、初回の実行で質の悪いコードが生成された場合、レビューで見逃されるとマージされてしまうリスクがあるため、最初から上位モデルで実行します。2つ目は多数のファイルにまたがる大規模なリファクタリングで、失敗した場合に失われる時間が数分ではなく1時間に及ぶためです。
また、失敗した実行結果から示唆を得られるのは、レビューで正しくそれを検知できた場合に限られます。モデルがテストを欺くようなコードを書くこともあるため、エスカレーション戦略はテストをごまかすコーディングエージェントを見抜く方法で紹介しているチェック手法と併せて適用してください。
タスクごとのコストと通過率を計測する
数値に基づかないルーティングは、単なる主観の押し付けになってしまいます。すべてのタスクにおいて、次の2項目を追跡してください。
- タスクあたりのコスト: 入力および出力トークン数に対象モデルの単価を掛け、失敗した試行を含むそのタスクに要した全実行回の合計額。
- レビュー通過率: 初回の実行で合格したか、それとも再実行や人間による修正が必要だったか。
そしてこれらを割り算します。ルーティングの最終判断基準となるのは、「承認された変更1件あたりのコスト」です。半分の確率で失敗する安価なモデルは、1回でパスする強力なモデルよりも高くつく場合があります。この点については、安価なモデルの方がコスト高になるケースで詳しく論じています。
サードパーティのデータも同様の傾向を示しています。Artificial Analysisのレポートによると、同社のIntelligence Indexを実行した際のコストは、Gemini 4 Carbon(high)で7.76ドル、Claude Fable 5.2(max)で26.54ドルでした。スコアはCarbonの60に対してFableが65となっています。3.4倍のコストを投じて5ポイントのスコア差を買う価値があるのは、その5ポイントの違いが最終的な成否を左右するタスクに限られます。
シンプルなログを記録するだけでも十分な第一歩になります:
task       model          runs  tokens_in  tokens_out  cost_usd  passed_first
COIN-212   gemini-4-argon    1     48,000      9,500      0.19   yes
COIN-213   gemini-4-argon    2    121,000     22,000      0.46   no
COIN-213   gemini-4-carbon   1    210,000     41,000      0.83   yes
上記の例では、COIN-213はArgonで失敗した後にエスカレーションされ、Carbonで合格しました。このタスクの総コストは1.29ドルとなり、この記録を見ることで、次回同様のタスクが発生した際に最初からCarbonで実行すべきかどうかが判断できます。
タスク管理ボード上でタスクごとに設定する
このルールは言葉にするのは簡単ですが、開発者が各自のターミナルで個別にモデルを選択していると徹底するのは困難です。タスクが集約されている管理画面上でルーティングを設定しましょう。
各エージェントに固定モデルを割り当てる
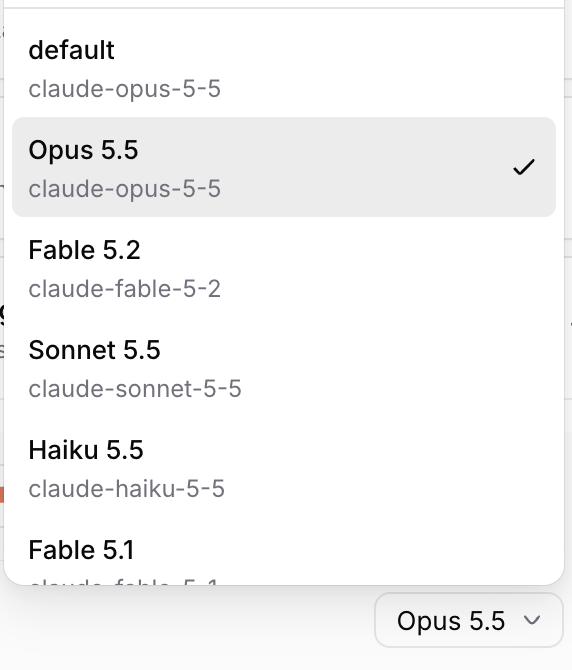
Sharklyでは、エージェントはデフォルトでそのRuntime(ランタイム)のモデルを継承しますが、エージェント設定の「Model」項目から、そのランタイムのカタログに含まれる別のモデルを選択できます。また、モデルがサポートしている場合は思考の深さ(thinking depth)も設定可能です。詳細はエージェントのドキュメントで解説されています。これにより、ティアごとに1つのエージェントを用意できます。つまり、高速モデルを担当するデフォルトエージェントと、強力なモデルを担当するエスカレーション用エージェントです。
単一の実行回のみエスカレーションする
タスクを割り当てる際、その実行回に限りエージェントのデフォルト設定をオーバーライドしてモデルを選択できます。これにより、「失敗時のエスカレーション」をワンステップで実行できます。レビュアーがタスクを差し戻すと、他のメンバーが利用しているエージェントの設定を変えることなく、その再実行のみをCarbonで走らせることができます。
記録を1か所に集約する
すべての実行履歴には実行ログが残るため、コストと通過率のデータは曖昧な記憶ではなく、実際に完了したタスクの実績から得られます。難易度ではなく役割ごとに作業を分担するCrewsについては、エージェントCrew向けのモデルルーティングを参照してください。監視・ガバナンス体制については、エージェントを制御するのは誰かでチーム側で保持すべき統制機能について取り上げています。Sharklyは無料で使い始めることができます。
タスク単位ルーティング以外の選択肢
- すべてのタスクに単一モデルを使用: 個人開発者には適していますが、タスクの難易度に幅が出てくると無駄が生じます。
- 自動ルーターモデルの導入: 軽量モデルがプロンプトごとに分類を行い、最適なモデルを選択します。ただし、判断基準がブラックボックス化しやすく、レビューでの失敗を考慮できません。
- エージェントチーム構成: Antigravityの「/swarm」プレビューでは、計画立案や監査にCarbonを配置し、軽量モデルを並行して作業させます。これは1つのジョブ内での役割分担によるルーティングであり、タスク単位ルーティングを補完する関係にあります。
まとめ
Google自身が発表記事で示したルーティングの指針は明確です。基本はArgon、タスクがそれを必要とする場合にのみCarbonを投入すること。高難度タスクを見極める4つのシグナルを定義し、それ以外はすべて低コストモデルから開始し、レビューで失敗した際にエスカレーションを行い、タスクごとにコストと通過率を記録しましょう。2週間運用すれば、いかなるベンチマークよりも正確な自チーム専用のルーティング基準が手に入るはずです。
次のステップ:Sharklyで2つのエージェント(デフォルトモデル用とエスカレーションモデル用)を設定し、今週のタスクを実際にルーティングしてみましょう。
よくある質問(FAQ)
コーディングエージェントにはGemini 4 CarbonとArgonのどちらを使うべきですか?
大半のタスクにはArgonを使用し、高難度のタスクにのみCarbonを使用してください。GoogleのGA発表記事でも、Argonは「ソフトウェアエンジニアリングの大半において理想的な選択肢であり続ける」とされており、Carbonはモデルの限界を試すようなタスク向けと位置づけられています。
Gemini 4 CarbonはArgonよりも高価ですか?
トークン単価としては同じです。2026年11月30日までは、どちらも100万トークンあたり入力2ドル・出力10ドルです。しかしタスク単位で見ると、通常はCarbonの方が高くなります。Googleによれば、Carbonは探索と検証のために、より多くのトークンを消費するためです。
11月30日以降、Gemini 4 Carbonの料金はどうなりますか?
Googleの注記によると、導入価格は2026年11月30日に終了し、Carbonの料金は100万トークンあたり入力4ドル・出力20ドルへと移行します。
AIエージェントのモデルルーティングとは何ですか?
モデルルーティングとは、承認される変更1件あたりのコストを最小限に抑えることを目指し、難易度に応じてタスクごとに適切なモデルを選択することです。
どのような場合にタスクを上位モデルへエスカレーションすべきですか?
タスクが多数のステップを要する場合(ロングホライズン)、多くのファイルにまたがる場合、セキュリティに関わるコードに触れる場合、あるいはデフォルトモデルでのレビューにすでに失敗した場合にエスカレーションします。
Sharklyではエージェントごとに異なるモデルを設定できますか?
はい、設定可能です。各エージェントの設定にある「Model」項目からランタイムのカタログにあるモデルを選択できるほか、タスクを割り当てる際に単一の実行回に限りモデルをオーバーライドすることもできます。


