
複数のコーディングエージェントを運用しているチームのほとんどは、どこかの時点でモデル費用に月次の上限を設ける。たいていは散々な一週間を過ごした後だ。適当な数字を決め、請求額がそれを下回るまで並列実行数を絞り、次の四半期にまた見直す。2026年9月22日、その数字は静かに、これまでの意味を失った。
OpenAIはGPT-6 Solを投入した。価格は入力100万トークンあたり2ドル、出力100万トークンあたり10ドル、API IDはgpt-6-sol。そしてトークン単価よりもはるかに有用なもの、すなわちタスクあたりコストを公表した。AutomationBench 1.0.6において、推論effortをextra-highに設定したSolはスコア33.2%、タスクあたり0.27ドル。同じハーネスで、max effortのClaude Opus 5はスコア26.9%だが、タスクあたりコストはSolの11.1倍だ。
だから上限を引き上げる前に、今の上限で何が買えるのかを計算しよう。ほとんどのチームにとっての答えは、すでに誰も読み切れないほどの完了済み実行が買えている、ということだ。つまりその上限は、予算を守っていたわけではなかった。偶然にもレビュアーを守っていたのだが、それもまもなく終わる。
TL;DR
受け入れられた変更あたりのコストとは、人が実際に読んで受け入れたdiff 1件ごとに、チームがモデル推論へ費やす金額のことだ。これは出荷された仕事に直結する唯一のエージェントコスト指標である。公表レートで計算すると、レビュアー4人のチームが1か月にレビューできるすべてのスループットは、GPT-6 Solでおよそ136ドルで賄える。制約は請求書から受け入れ工程へ移り、それはどんなモデルのリリースでも変わらない。エージェントは調査し、実行し、テストし、報告する。人は方向性を定め、権限を与え、結果を受け入れる。
OpenAIが実際に公表した数字
OpenAIはスコアとタスクあたりコストを併記している。これは異例なほど誠実で、価格表よりもはるかに役に立つ。
| モデル(OpenAIが使用したeffortレベル) | AutomationBench 1.0.6 | タスクあたりコスト |
|---|---|---|
| GPT-6 Sol, extra-high | 33.2% | $0.27 |
| GPT-6 Astra, low | 30.3% | Solの3.9倍 |
| Claude Opus 5, max | 26.9% | Solの11.1倍 |
| Fable 5.1(Opus 5フォールバックあり), max | 31.4% | Solの8.9倍超 |
OpenAI自身による1行目と3行目のまとめはこうだ。extra-highのSolは、Opus 5のタスクあたりコストの約9%で、maxのOpus 5を上回る。同じパターンは同社の投稿の他の箇所にも見られる。Agents' Last Exam V1では、maxのSolが56.4%を記録してOpus 5の最高スコアを上回り、タスクあたりコストは60%低い。DeepSWE 1.1では、maxのSolが68.8%で、extra-highのFable 5(69.9%)と1.1ポイント差、タスクあたりコストは約80%安い。
ただし、これらの数字には2つの但し書きが付くべきであり、それが一緒に語られることはほとんどない。OpenAIの見出しは、SolとLunaがそれぞれGPT-5.6のプロモーション価格より50%安いというものだが、「プロモーション」はOpenAI自身の言葉であり、つまり比較対象は割引レートだ。そしてOpenAIが比較したのはClaude Opus 5である。というのも、Claude Opus 5.5が数時間後に投入され、Opus 5の100万トークンあたり5ドル/25ドルに対して4ドル/20ドルになったからだ。Opus 5の列は最後に公表された比較であり、現在の比較ではない。
予算を実行回数に換算する
0.27ドルに11.1を掛けると、そのハーネスでのmaxのOpus 5はタスクあたり約3.00ドルになる。この計算はOpenAIの2つの数字から我々が導いたものだ。月次上限をそれぞれで割れば、上限の見え方を変える表が得られる。
| 月次のモデル予算 | Sol(extra-high)でのタスク数 | Astra(low)でのタスク数 | Opus 5(max)でのタスク数 |
|---|---|---|---|
| $250 | 約925 | 約240 | 約83 |
| $1,000 | 約3,700 | 約950 | 約330 |
| $5,000 | 約18,500 | 約4,750 | 約1,660 |
ベンチマークのタスクあたりコストは、あなたのタスクあたりコストではない。AutomationBenchのタスクはベンチマーク向けの形をしている。範囲が限定され、短く、何年もの履歴を持つリポジトリの実際のチケットとは似ても似つかない。自分のタスクでは、10倍あるいは100倍のトークンを消費するかもしれない。ベンチマークとあなたのリポジトリの間で通用するのは、モデル間の比率であって、絶対的なドル額ではない。この表は変化の形として捉え、自分のエージェント横断の実行あたりコストを測定し、それに合わせて換算し直そう。
もう一つ補正があり、こちらは逆方向に効く。タスクあたりコストは試行あたりであって、成功あたりではない。ベンチマーク自身の33.2%という数字では、試行のおよそ3回に2回は失敗する。つまりベンチマークでの成功あたり、Solは約0.81ドル、maxのOpus 5は約11.15ドルかかる。これも我々の計算であり、大まかなものだ。ベンチマークの合格率はチームの受け入れ率ではないからである。重要なのは方向性だ。何かを2回試すコストは今や十分に小さく、リトライ戦略は予算の判断ではなく設計上の選択になった。
上限は今どこにあるのか
レビュー側も同じ土俵に乗せよう。diffをきちんと読み、エージェントが何を選んだかを理解し、結果に責任を持つレビュアーは、1営業日である程度の数の変更をこなせる。ここでは6件としておくが、自分のチームに合わせて調整してほしい。
| レビュアー数 | 月あたりの受け入れ変更数 | Solコスト(0.27ドル) | Opus 5 maxコスト(3.00ドル) |
|---|---|---|---|
| 1 | 約126 | $34 | $378 |
| 2 | 約252 | $68 | $756 |
| 4 | 約504 | $136 | $1,512 |
| 8 | 約1,008 | $272 | $3,024 |
レビュアー1人あたり1日6件の受け入れ変更を21営業日で、というのが我々の前提と計算だ。自分の数字を入れても結論は変わらない。通常のエンジニアリングチームが1か月に実際に受け入れられるものすべては、高コスト側のモデルでも、推論費用にして数百ドルで済む。4人チームの1,000ドル上限は制約ではない。チームが吸収できる量のおよそ7倍のエージェント出力だ。
成果物をレビューするチームにとって、今回の値下げの本質はここにある。あなたのアウトプットを増やしたわけではない。キューが短いことの最後の言い訳を取り除き、常に存在していたボトルネック、すなわち人間によるレビュー工程を可視化したのだ。
OpenAIの社内支出は、矛盾ではなく有益な反例だ。中央値の研究者はAPI価格で1日600ドル超のコーディングエージェント推論を回し、90パーセンタイルでは1日7,000ドルに達する。これらは実数であり、上の表をはるかに凌ぐ。その仕事の形が異なるからだ。膨大なファンアウト、自動スコアリング、そして名前のある担当者が各結果を本番ブランチに受け入れる工程が存在しない。あなたのプロセスにその工程があるなら、モデル費用は小さく留まり、キューはそうはならない。
浮いた余裕で何を買うか
予算が制約にならなくなれば、問いは「何回実行を買うか」から「浮いた分を何に使うか」に変わる。2つの答えは、レビュアーに届く仕事を増やすのではなく、減らす。
買うべきは量ではなく推論effort。推論effortはコストの調整つまみであり、OpenAI自身の表もベンチマークごとに異なるレベルを使っている。0.27ドルという数字はextra-highの行であり、より慎重な実行に対する割増は、すでに代替案の9%という数字の中に含まれている。同じタスク数でそれを支払ってもコストはほとんど変わらず、確認に時間がかからないdiffが得られる。
買うべきはトークンではなくキャッシュ。GPT-6はキャッシュされた入力の読み取りを90%割引し、デフォルトでヒット率を高く保ち、reasoning effortやツールの利用可否を変更してもキャッシュを無効化しなくなった。明示的なブレークポイントを使えば、キャッシュされたプレフィックスがどこで終わるかを自分で決められる。OpenAIは、GitHubで数十億リクエストにわたり、新たに処理が必要なプロンプトトークンが50%以上削減されたと述べている。Crewにとってこれは、あるリポジトリに最初に取り組むAgentと10番目のAgentの違いだ。どちらもレイアウト、ハウスルール、規約というほぼ同じプレフィックスを再送する。そのプレフィックスこそ、キャッシュがまさに役立つ対象である。エージェント群の請求額が実際に生きているのは、リポジトリコンテキストのトークンコストの部分だ。
正直な判断基準は2つある。追加の実行が、人が受け入れる1つの結果に収束するなら、並列実行数を増やしてよい。たとえば1つのマイグレーションに対して3回試行し、テストスイートが勝者を選ぶような場合だ。逆に、各実行がそれぞれ独自のdiff、独自のサマリー、独自の受け入れ判断を生むなら、実行がいかに安くなっていても増やしてはいけない。後者では、うまくスケールしたのは請求書だけである。
新しい上限を数えられるようにする
予算はキャパシティの代理指標としては貧弱だったが、1つだけ長所があった。誰かが監視する数字だったのだ。それを、今や制約となっている数字、つまり人を待っている完了済み実行に置き換えよう。
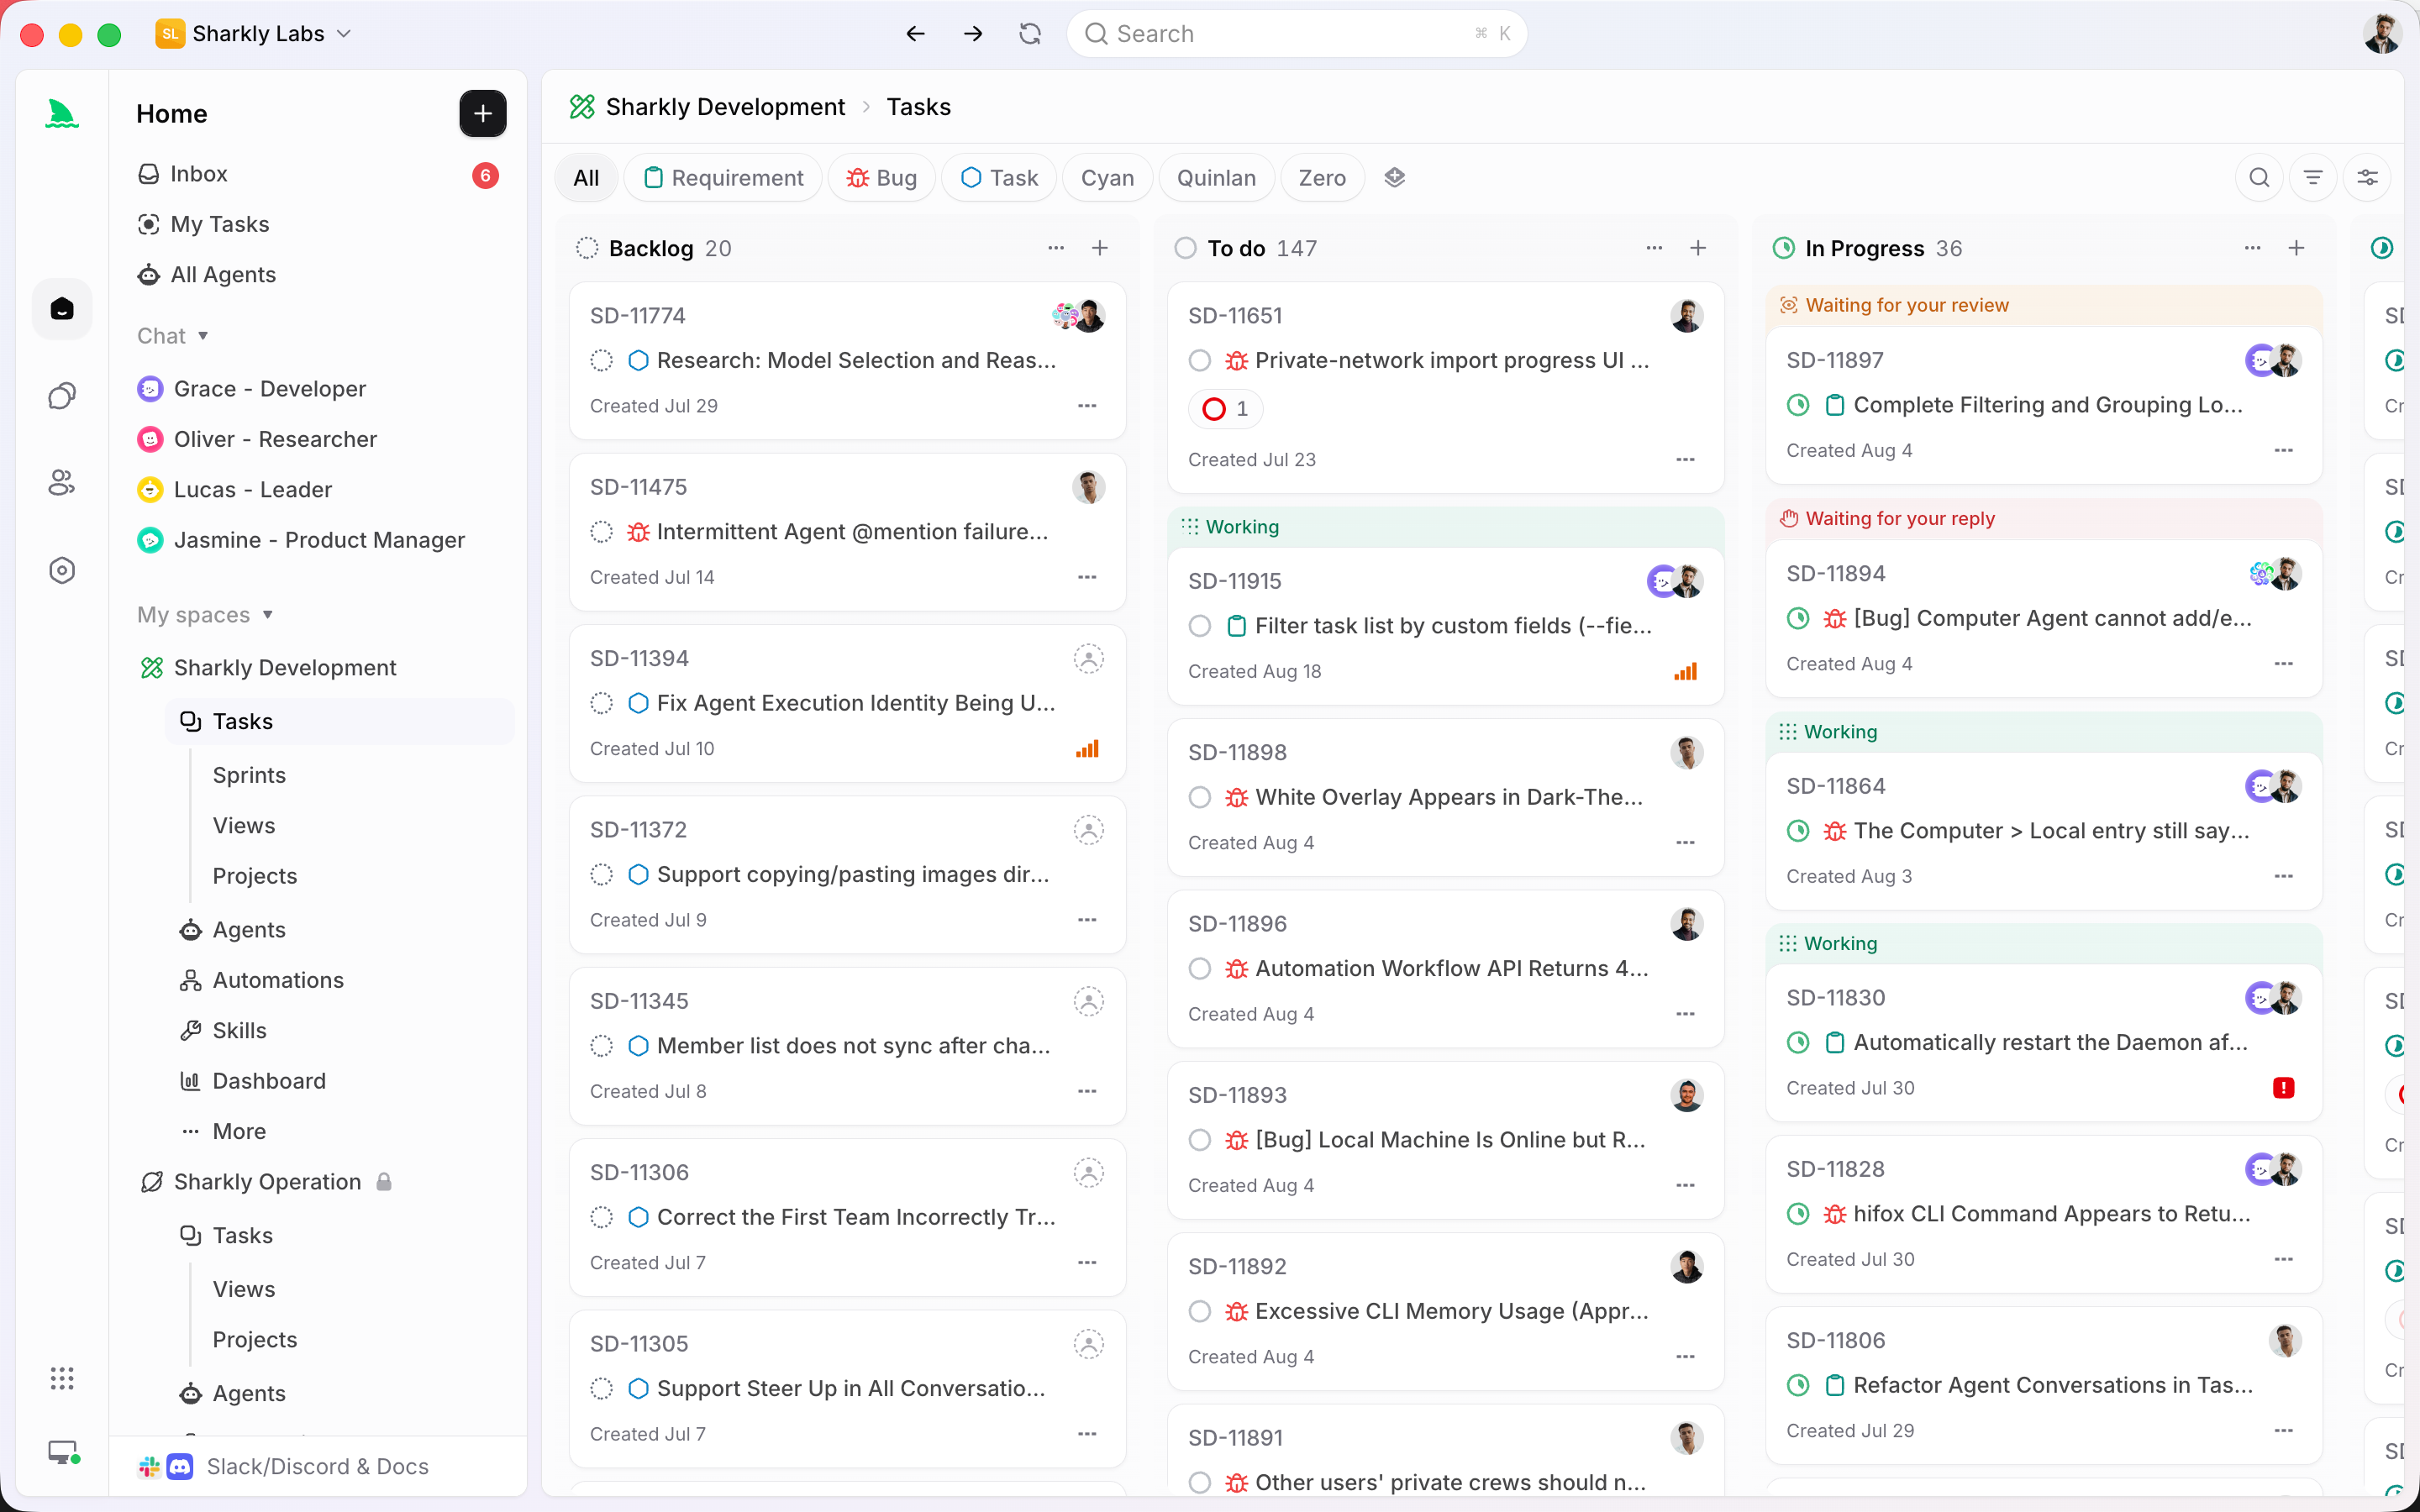
これが測定可能になるのは、実行が個人のターミナルの中に閉じ込められなくなってからだ。SharklyはCodexやClaude Code、その他のこれらのモデルを動かすツールの置き換えではない。それらの周囲にあるレイヤーであり、コンテキスト、進捗、ブロッカー、結果、人間のレビューが、リクエストからリリースまで可視化され続ける場所である。実行とブロッカーはTaskに戻されるので、「人待ち」は、金曜日の午後に感じるもやもやではなく、ボード上で数えられる状態になる。レビューキャパシティの計算は、キューが見えていて初めて機能する。
すでに複数のコーディングエージェントを動かしているなら、今週やるべきことは上限を引き上げることではない。チームが普通の一週間で何件の完了済み実行を受け入れているかを把握し、それに合わせて並列実行数を設定し、余った予算を、より受け入れやすい実行に使うことだ。


