
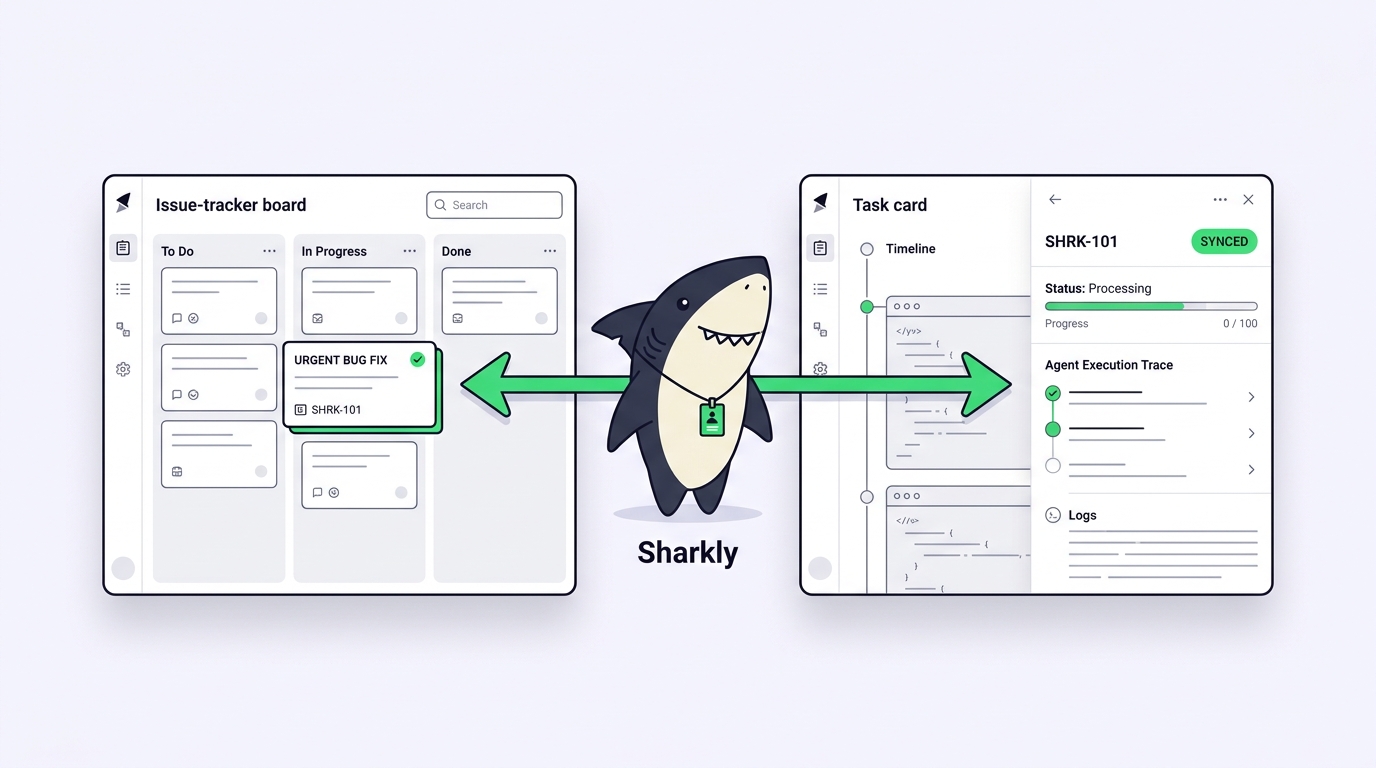
あなたのバックログはJiraの中にある。誰もそれを動かそうとしていない。エピックはそこにあり、スプリントレポートは経営層に届き、他に3つのチームがそのワークアイテムIDに依存している。だから誰かが「AIコーディングエージェントにJIRA-4821を拾わせるべきか」と尋ねたとき、問題は「Jiraを置き換えるべきか」ではない。もっと狭く、もっと実践的だ。エージェントは実際どこで動くのか、その成果物は誰がレビューするのか、そしてそれらはチケットに返ってくるのか。
これが本当の比較だ。Jiraには今エージェントがあり、ちゃんと動く。Sharklyもエージェントを動かすが、それはあなたが接続したコンピュータ上でであり、結果をJiraに同期し返す。このガイドでは、両者の境界線を正直に引く。Sharklyを追加するのが過剰になるケースも含めて。
TL;DR
Jiraはシステム・オブ・レコードであり、そこにエージェント実行が加わった。Sharklyは実行レイヤーであり、あなたのシステム・オブ・レコードに接続する。AtlassianのRovo DevはAtlassianの環境内で計画、コーディング、レビューを処理し、担当者ドロップダウンからワークアイテムをエージェントに割り当てられる。Sharklyはあなたのチームがすでに費用を払っている任意のRuntimeを、あなたが接続したComputer上で動かし、実行トレースを共有Task上に保持し、Jira Cloud、Server、Data Centerと双方向に同期する。エージェントの作業がAtlassianのサポートする環境内で完結するなら、Jiraだけで十分だ。エージェントを自前のマシン、自前のRuntime、自前のレビューゲートで動かす必要があるなら、SharklyはJiraを追い出すことなくそのレイヤーを追加する。
Jiraが得意なこと、率直に言えば
Jiraの最も良い姿を認めよう。正直に語られるその姿は、実際に強力だ。
Jiraは、企業が「どんな作業が存在するか」に合意する場所だ。その合意には実際の価値がある。共有されたID、権限モデル、監査履歴、財務や経営層がすでに読んでいるレポート。チームにそれを捨てろと求めるツールは、高くつくものを求めている。
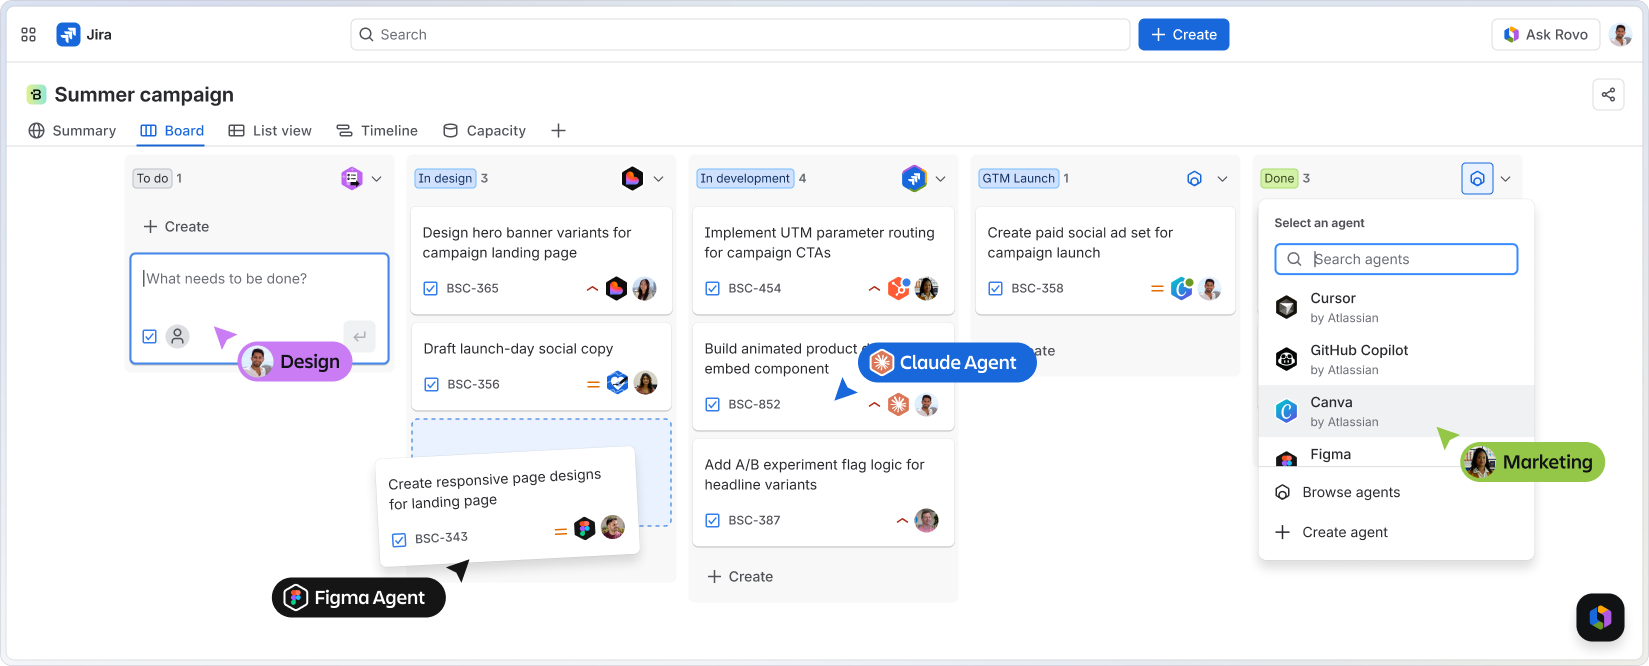
Atlassianもエージェントに関して手をこまねいていたわけではない。AtlassianはRovo Devを「計画、コーディング、レビューを処理し、反復作業を大規模に自動化することでソフトウェア開発ライフサイクルを加速する、コンテキスト対応のAIエージェント」と説明している。これはJiraの受け入れ基準に対してコード変更を検証し、ターミナルCLI、Bitbucket Cloud、GitHub、VS Codeをまたいで動作する。Atlassianによれば、Rovo Dev Standardは新規・既存のすべての顧客が一般利用可能で、Standard、Premium、EnterpriseのCloudプランでは月次クレジットが順次展開されている。
この割り当てモデルは本当によくできている。ワークアイテムの担当者ドロップダウンを開き、同僚を選ぶのと同じようにエージェントを選ぶ。そのリストにはGitHub Copilotコーディングエージェントのようなサードパーティ製エージェントも含まれる。Atlassian自身のエンジニアリングチームは、JiraでRovo Devを使い2週間で120件のPRを納品したという記録を公開している。これはデモの数字ではない。実際の業務におけるスループットをチームが報告したものだ。
つまり出発点は「Jiraは遅れている」ではない。「Jiraには答えがあり、その答えが何をカバーするのかを正確に知るべきだ」ということだ。
Jiraの答えが届かない範囲
その境界は、実行がどこで行われ、どのツールに到達できるかに関わっている。
Jiraネイティブのエージェント実行は、Atlassianがサポートする環境の内部で動く。これは意図的な設計であり、多くのチームにとっては正しい選択だ。同時に、Runtimeに関する問いはあなたに代わって答えられているということでもある。あなたの開発者が特定のSkills構成のClaude Codeに標準化していたり、ChatGPTサブスクリプション経由のCodex、Gemini CLI、OpenCode、あるいは独自プロトコルに対して自作した何かを使っているなら、Jiraネイティブの経路はそれらを、開発者がローカルで動かすようには実行しない。
もうひとつ、ほとんどの比較が認めていない以上に重要な境界がある。それはマシンだ。エージェントの作業は単なるモデル呼び出しではない。チェックアウト、パッケージマネージャ、環境変数、ローカルデータベース、ステージングAPIへのVPNルート、そしてあなたのリポジトリが自分のノートPCではビルドできるのに汎用コンテナではビルドできない原因となる20の小さな事柄が必要だ。チームがこれにぶつかるのは1週目ではなく2週目だ。
そしてレビューの問題もある。エージェントが変更を生み出したとき、有用な成果物はプルリクエストだけではない。トレースだ。エージェントが何を指示され、何を読み、何を試し、どこで止まり、人間がそれについて何を判断したか。その記録には、次の担当者が読める置き場所が必要だ。
どちらを選ぶかという判断基準
Sharkly自身のドキュメントは役割分担について率直であり、ここでも同じ率直さが当てはまる。
Jiraだけで十分なのは、エージェントの作業がAtlassianのサポートする環境内に収まり、リポジトリがBitbucketかGitHubにあり、使いたいエージェントがJiraで既に割り当て可能なものだけである場合だ。システム・オブ・レコードと実行経路を1つの製品で手に入れ、請求も1つで済む。別のレイヤーを追加すれば、不要な複雑さを買うことになる。これは逃げ口上ではなく、本気の推奨だ。
Sharklyを追加すべきなのは、実行があなたの管理するハードウェアとRuntime上で行われる必要がある場合だ。SharklyのComputerはAgent作業の実行ホストを提供し、ローカルコンピュータ、リモートサーバ、コンテナ、またはサポート対象のクラウドホストを利用できる。小さなローカルサービスがそのComputerをSharklyに接続し、利用可能なRuntimeを検出し、作業を受け取り、タスクディレクトリを準備し、選択されたRuntimeを起動し、進捗をストリーミングで返す。これこそJiraが担おうとしていない部分だ。
ここで定義をひとつ。以降の話がこれに依存するからだ。TaskはSharklyにおける作業の基本単位だ。ゴールと説明、担当者、実行を割り当てられたAgentまたはCrew、コメント、実行状態、トレース、結果を保持する。Jiraの課題が「作業が存在する」ことを記録するのに対し、SharklyのTaskは「その作業がどのように、どのエージェントによって、どのマシン上で行われたか」を記録する。
選ぶ必要はない:同期という道
ここが、ほとんどの「Sharkly vs Jira」という構図が間違えている点だ。両者は排他的ではなく、その連携は願望ではなくドキュメント化されている。
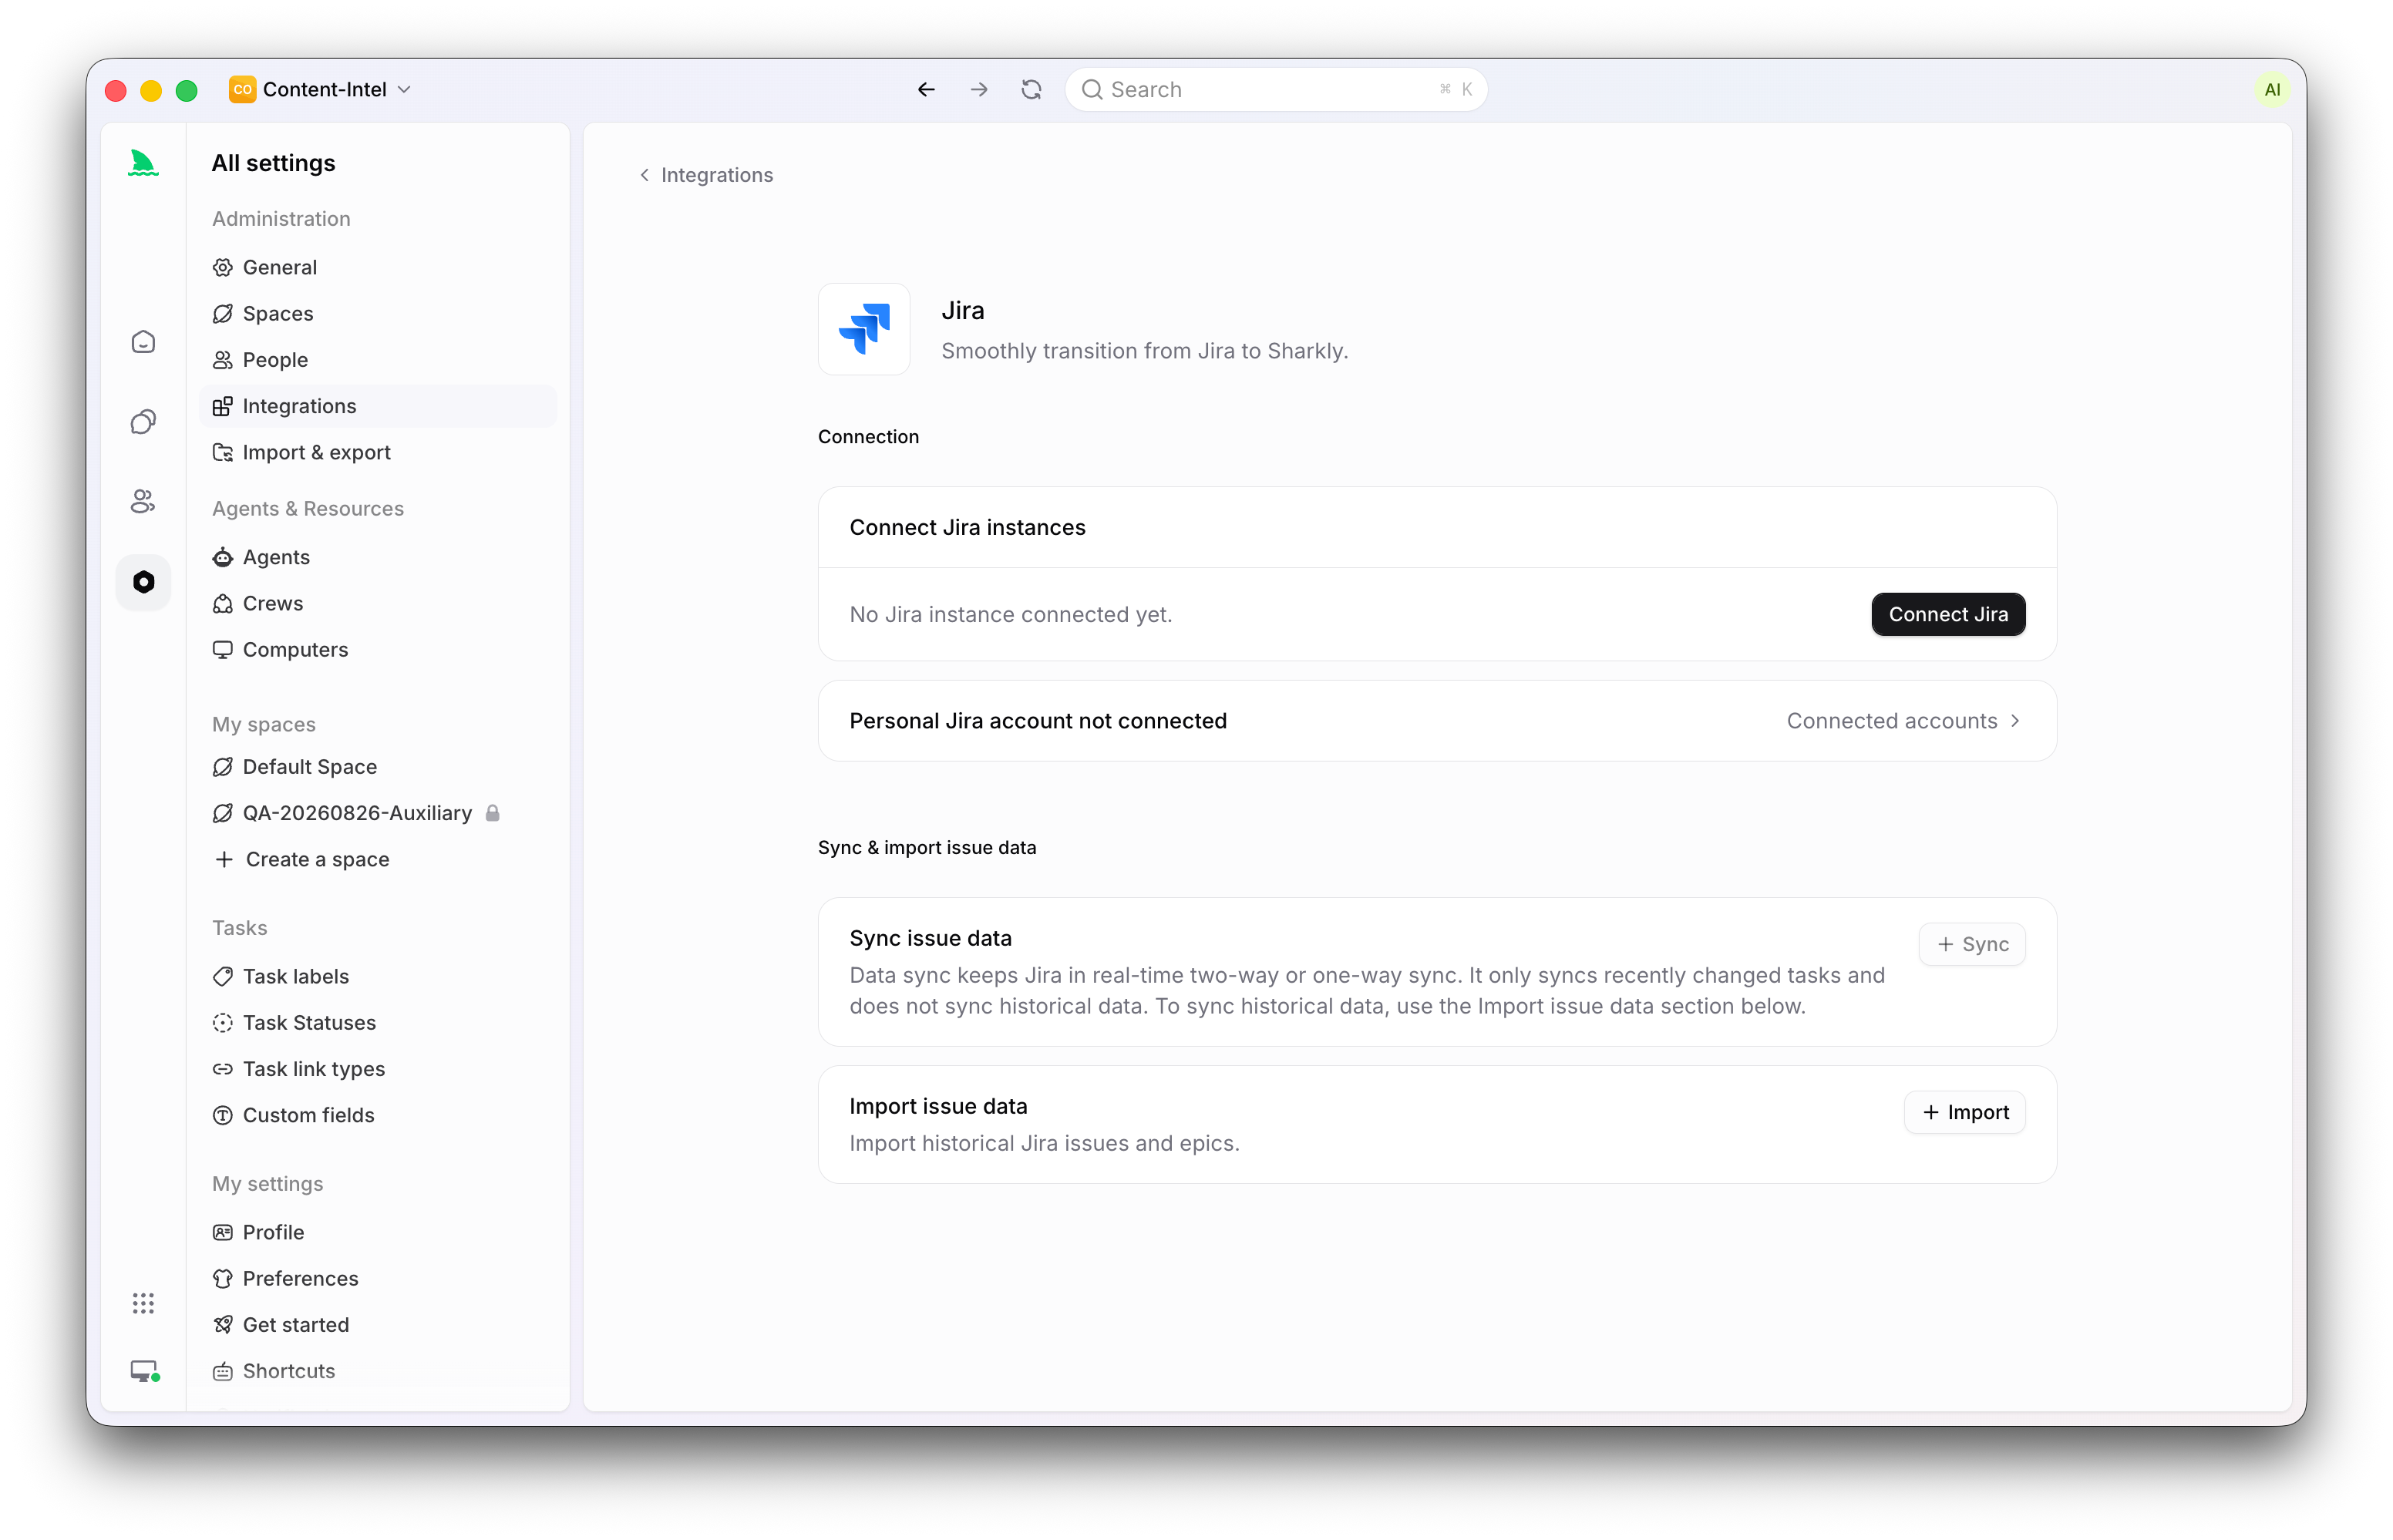
SharklyのJira連携はJira CloudとJira ServerまたはData Centerをサポートし、3つのモードを提供する。
- Importは既存のJiraデータをSharklyにコピーする。過去の作業や管理された移行に使う。
- SyncはJiraプロジェクトをSharklyのSpaceにリンクし、最近の変更を接続された状態に保つ。Sync自体は過去のデータをインポートしない。
- ImportしてからSyncは、選択した履歴を取り込み、ウィザードで既に入力済みの認証情報を使って継続的な同期を有効にできる。
同期リンクは1つのJiraプロジェクトと1つのSharkly Spaceをペアにする。1つのJiraプロジェクトが持てる有効なリンクは1つだけだが、複数のJiraプロジェクトを同じSpaceにリンクすることはできる。双方向モードでは、Jiraの課題とエピックがSharklyのTaskとProjectと双方向に同期し、リンクされたSpace内の新しいTaskとProjectがJiraの課題とエピックを作成できる。Jiraを正としたい場合は、Jira to Sharklyモードが、新しいレコードをSharklyから押し戻すことなく、リンクされたSharklyレコードを作成・更新する。
始める前に知っておく価値のある運用上の注意が2つある。Webhookの自動インストールにはJiraの管理者権限が必要で、Webhookの権限が欠けていても接続自体はブロックされないが、Jira側の変更が届かなくなる。リンクを削除すると、どちらの側のデータも削除せずに今後の同期が停止する。つまり、やらないと決めた場合に元に戻せる。
チケットレベルのワークフローについては、JiraチケットをAIエージェントに割り当てる方法のウォークスルーで、このループを端から端まで解説している。
具体例
ある決済チームが、会社標準としてJiraを運用している。サポートがJIRA-4821を起票する。Webhookのリトライストームにより、少数の顧客に二重請求が発生しているという内容だ。
テックリードがJiraでトリアージし、優先度を設定し、インシデントのエピックにリンクする。リンクされたSpaceは双方向に同期するため、同じ作業が説明と受け入れ基準をそのままにSharklyのTaskとして現れる。
ここからルーティングが具体的になる。Taskはバックエンド修正用に構成されたAgentに渡される。定義された役割、決済リポジトリ、そしてRuntimeとしてのClaude Code。すでにステージングの認証情報とVPNルートを持つ、接続済みのComputer上で動く。2つ目のAgentは隔離されたworktreeでテストカバレッジを担当し、2つが同じファイルに触れることはない。隔離されたworktreeで並列エージェントを動かす方法のガイドでは、複数のエージェントが動くときにこの隔離がなぜ重要になるかを解説している。
エージェントは課題を読み、ローカルリプレイに対してリトライストームを再現し、冪等キーの変更を提案し、テストスイートを実行して報告を返す。読んだもの、試したもの、失敗したもののすべてが、コメントの隣のトレース内に、Task上にある。リードは差分をレビューし、Taskのコメントで追加の質問を1つ投げ、それが次の実行を開始し、そして承認する。
結果はJIRA-4821に返り、Jiraから離れたことのない人々のもとに届く。チケットはクローズし、スプリントレポートは正確になり、サポートはすでに使っているツールで解決を確認できる。誰も引っ越す必要はなかった。
SharklyとJira:公平な比較
| Jira(Rovo Devと割り当て可能なエージェントを含む) | Sharkly | |
|---|---|---|
| 主な役割 | 組織全体の作業のためのシステム・オブ・レコード | PeopleとAgentsのための実行・レビューレイヤー |
| エージェントの割り当て | 担当者ドロップダウン、Rovoエージェントとサポート対象のサードパーティエージェント | AgentまたはCrewに割り当てられたTask |
| エージェントの実行場所 | CLI、Bitbucket Cloud、GitHub、VS Codeを含むAtlassianサポート環境 | あなたが接続するComputer:ローカルマシン、リモートサーバ、コンテナ、またはサポート対象のクラウドホスト |
| Runtimeの選択 | Jiraがサポートするエージェント | そのComputer上で検出されたRuntime。独自に構成したカスタムACP Runtimeも含む |
| モデルの課金 | Atlassianのプランとクレジットを通じて | あなたのツールにすでに構成済みのサブスクリプションまたはAPIキーを通じて |
| 実行記録 | ワークアイテムの履歴とリンクされたPR | 実行状態、トレース、結果、コメントを含むTask |
| クロスプラットフォームのホスト | Atlassianが管理 | CLIとローカルサービス向けのmacOS、Linux、Windowsインストーラー |
| 関係性 | 全員がレポートの基にする記録 | Jiraを置き換えるのではなく、双方向に同期する |
よくある間違い
これを移行だと捉えること。最もよくある誤りは、エージェント実行をJiraを離れる理由として位置づけることだ。財務、サポート、そして他に3つのチームがそのレポートを読んでいる。移行ではなく同期を。
Webhookの話を後回しにすること。JiraリンクがWebhookを自動インストールするには管理者権限が必要だ。権限がない場合は、後で「無音」をデバッグするのではなく、早い段階で必要な設定一式をJira管理者に渡しておこう。
多くのJiraプロジェクトを誤って1つのSpaceに向けてしまうこと。1つのJiraプロジェクトが持てる有効なSpaceリンクは1つだけで、ペアリングは作成後に変更できない。リンクを作成する前にマッピングを決めよう。修正するには削除して作り直す必要があるからだ。
エージェントに適さない作業を割り当てること。「決済のバグを直して」とだけ書かれたチケットは、どのプラットフォームであれ悪い実行結果を生む。違いを生むのは受け入れ基準であり、これは良いチケットに常に求められてきた規律と同じだ。AIエージェントのプロジェクトマネジメントの概要では、担当者が人間でなくなったときに何が変わるかを解説している。
まとめ
Jiraは「どんな作業が存在し、誰がそれを所有するか」に答える。Rovo Devと割り当て可能なエージェントにより、Atlassianがサポートする環境内であれば「誰が作業を行うか」の一部にも答えるようになった。それがあなたのスタックをカバーしているなら、話は終わりだ。比較記事を読むのはやめていい。
Sharklyは別の問いに答える。エージェント実行があなたのマシン、あなたのRuntime、あなたのレビューゲートを必要とするとき、それはどこで行われ、その記録はどうやってチームにとって読める状態に保たれるのか。これはClaude CodeやCodexの代替ではなく、Jiraの代替でもない。チームがすでに使っているツールの周囲に、共有Task、接続されたComputer、コンテキスト、コントロール、レビューレイヤーを加え、その成果を他の全員が読むチケットに同期し返す。
それがあなたの感じているギャップなら、まずSharklyを始め、他に何も触る前に1つのJiraプロジェクトを1つのSpaceに接続してみよう。
FAQ
SharklyはJiraを置き換えますか?いいえ。インポート、一方向同期、双方向同期のいずれかでJiraにリンクします。リンクを削除すると、Jiraの課題、Jiraのエピック、SharklyのTask、SharklyのProjectを削除することなく、今後の同期が停止します。
Jiraを正として維持できますか?はい。Jira to Sharklyの方向では、Sharklyから新しいJiraレコードを作成することなく、リンクされたSharklyレコードを作成・更新します。すでにリンク済みのレコードに対するサポート対象の更新は、引き続き書き戻すことができます。
セルフホストのJiraでも動きますか?Jira CloudとJira ServerまたはData Centerの両方をサポートしています。ServerとData Centerのインストールでは、Jira Cloudには表示されないプライベートネットワークプロキシオプションも利用できます。
モデルのコストはどうなりますか?モデルの利用は、あなたのコーディングツールに構成されたサブスクリプションまたはAPIキーを通じて継続されます。モデルのクォータは、チームが接続するAIコーディングツール、プラン、APIアカウントに依存します。
Jiraがネイティブに割り当てられるエージェントはどれですか?Rovoエージェントに加え、GitHub Copilotコーディングエージェントのようなサポート対象のサードパーティエージェントを、ワークアイテムの担当者ドロップダウンから選択できます。サポート対象リストは変わるため、Atlassianの最新ドキュメントを確認してください。
始めるのに両方のツールが必要ですか?いいえ。まずSharklyを独自のSpaceに対して動かし、後からJiraを接続することもできます。すでにJiraに根を張っているチームは、通常、1つのスクワッドがエージェントループを機能させてからでないと、同期の正当性を感じにくいものです。Jiraがまだ定着していないケースについては、人間とエージェントのチーム向けJira代替の比較記事で扱っています。


