
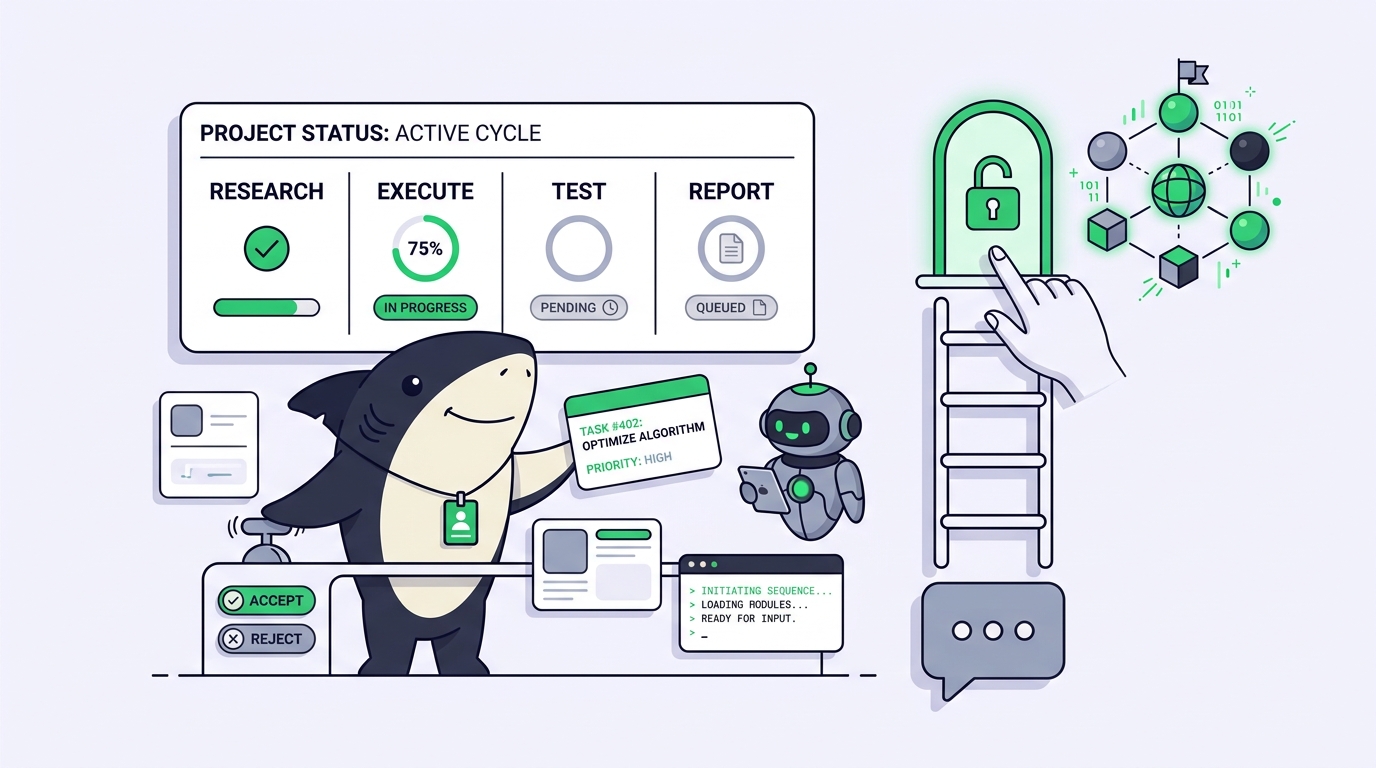
プロンプトを入力し、返ってきた答えを読み、良い部分をエディタにコピーし、モデルが間違えた箇所を直し、テストは自分で実行する。このループのおかげで、コードを書くスピードは上がった。だが、作業を担っているのが誰かは変わっていない。タスク全体を頭の中に抱え、1回のペーストごとに前に進めているのは、依然としてあなた自身だ。
エージェント型コーディングは、そこが変わる地点にある。貼り付ける答えをプロンプトで求めるのではなく、ひとまとまりの作業を割り当てれば、調査・実行・テスト・報告までを終えた結果が返ってくる。開発者の仕事は、1行ずつタイプすることから、方向を示し、権限を与え、返ってきたものを受け入れるか却下するかへと移る。本ガイドでは、実務の開発チームに向けてエージェント型コーディングを定義し、チャットアシスタントからオーケストレーションされた Crew までの成熟度のはしごをたどり、この変化が依って立つ境界線——人間がどこに留まるか——を明確にする。
本記事では一貫して Sharkly をリファレンスワークフローとして使う。エージェント型コーディングで難しいのは、エージェントがコードを書く部分ではない。多数の実行を調整し、コンテキストを1か所に集約し、実際に出荷するものを決めることだ。Sharkly はオールインワンの Agent コマンド&マネジメントプラットフォームであり、チームがすでに運用しているコーディングツールの周囲に、共有タスク、Computer、コンテキスト、コントロール、レビューのレイヤーを追加する。そのレイヤーこそが、「エージェントがコードを書いた」という状態を、チームが信頼できるエージェント型コーディングへと変える。
TL;DR: エージェント型コーディングとは?
エージェント型コーディングとは、単発のプロンプトに答えてもらうのではなく、範囲を定めたひとまとまりの作業を AI コーディング Agent に割り当て、その Agent がコードベースを調査し、変更を加え、テストを実行し、根拠とともに報告するというソフトウェア開発ワークフローだ。開発者は書き手から監督者へと移る。方向を示し、権限を与え、結果を受け入れる立場になる。成熟は4段階をたどる。補完してくれるチャットアシスタントから、単一の実働 Agent、並列 Agent、そして1人のリーダー Agent が統括するオーケストレーションされた Crew へと進んでいく。
プロンプト&ペーストの限界
チャットベースの AI コーディングは、多くのチームが肌で感じていながら、めったに言葉にしない限界に突き当たる。一度に質問できるのは1つだけだ。答えは毎回あなたの膝の上に戻ってきて、それを読み、判断し、実際のコードに組み込み、チェックを走らせることになる。タイピングをするのはモデルで、考えること、統合すること、検証することを担うのはあなた自身だ。これをスプリント全体で掛け算してみれば、アシスタントは小さな一歩には速く、大きな一歩には役に立たないことがわかる。
その痛みは、予測しやすい3か所に現れる。第一に、コンテキストがあなたの頭と個人的なチャット履歴の中にしかないため、エージェントがなぜその選択をしたのか、何をすでに試したのかを同僚が確認できない。第二に、スループットが1人の人間の注意力で頭打ちになる。ターミナルを5つ開き、エージェントセッションを5つ中途半端に走らせても、どれが本当に完了しているのかを示す記録が共有されていない。第三に、何も説明責任を負っていない。エージェントの推論、その差分、テスト出力は、コードがマージされる前に誰もレビューしないチャットウィンドウのあちこちに散らばってしまう。
エージェント型コーディングは、やり取りの単位を変えることでこの3つすべてに答える。メッセージをやり取りするのをやめ、作業を割り当てるようになる。そして作業が単位になれば、それを置く場所、それを所有する人、出荷前のゲートが必要になる。これが本記事の本当のテーマであり、「エージェントがひとりでコードを書くこと」で定義を止めてしまうと、チームにとっては要点を外してしまう理由でもある。同じ話のオーケストレーション側を知りたいなら、AI エージェント・オーケストレーションのガイドが本記事と対になるピラー記事だ。
エージェント型コーディングの実用的な定義
引用する価値のある一文にするとこうなる。エージェント型コーディングとは、人が範囲を定めた Task を AI コーディング Agent に割り当て、Agent が調査・実行・テスト・報告を行い、人は方向性・権限・最終的な受け入れを保持し続ける開発ワークフローである。
この一文の前半と後半が、アイデアのすべてを担っている。Agent の側は動詞のループだ。コードベースと要件を調査し、変更を実行し、テストとビルドを走らせ、要約と検査可能な根拠を添えて報告する。人の側はもっと短いループだ。方向を示し、権限を与え、受け入れるか却下する。Agent は調査・実行・テスト・報告を行い、人は方向性を示し、権限を与え、結果を受け入れる。自動化は、チームの判断が必要とされる地点で止まる。
エージェント型コーディングが何ではないかを述べておくとわかりやすい。開発者をモデルが置き換えることではないし、「AI を監視なしで走らせて祈る」ことでもない。範囲を定め、結果を受け入れる人がいないコーディング Agent は、エージェント型コーディングではなく、所有者のいないプロセスだ。この変化の本質は、人間を取り除くことではない。キーストロークのすべての中心にいた人間を、本当に重要な2つの端——何を作るか、そして出荷できる品質かどうか——へと移すことにある。
この区別は、エージェント型コーディングを「バイブコーディング」からも切り離す。バイブコーディングでは、生成されたコードを読まずに受け入れる。つまり人間が受け入れ側から外れてしまう。エージェント型コーディングはその端を保持し、中間を自動化する。片方は近道であり、もう片方はチームで運用できるワークフローだ。
成熟度のはしご:エージェント型コーディングの4段階
チームが自律型 Agent にいきなり飛びつくことはない。一段ずつ登っていく。段を名づけておけば、自分のチームが今どこにいて、次に踏むべき正直な一歩がどんなものかが見えてくる。
ステージ1:チャットアシスタント
モデルがエディタの中で行を補完し、質問に答え、関数の下書きを書く。すべてのステップをあなたが操縦する。永続的な Task も所有権もレポートもなく、価値はタイピングの速さと素早い調べ物にある。ほとんどの開発者がここから始めた場所であり、1行の修正なら今でも正しい道具だ。ここで Agent に手を伸ばすのは過剰装備になる。
ステージ2:単一の Agent
範囲を定めた1つの Task を1つの Agent に渡し、ループ全体を走らせる。関連ファイルを読み、変更を加え、チェックを実行し、差分と要約を添えて戻ってくる。Agent はまっさらなプロンプトからではなく、コードの現在の状態から作業する。ここがエージェント型コーディングの最初の本当の段である。初めて、メッセージではなく作業が単位になるからだ。始めるなら小さくリスクの低い変更がよい。最初の一歩については、AI コーディング Agent に初めてのタスクを割り当てる方法のウォークスルーがまさにこの段を扱っている。
ステージ3:並列 Agent
ここからは複数の Agent を同時に走らせる。それぞれが自分の Task を持ち、衝突しないようそれぞれが独立した worktree の中で動く。フロントエンドの作業、バックエンドのエンドポイント、バグ修正、テストカバレッジの追加を、すべて同時に進められる。スループットはもはや1人の人間の注意力で頭打ちにならない。ただし罠は調整だ。5つのターミナルに5つの Agent は、速いと同時にカオスでもある。目標、差分、結果を1か所に保つ仕組みがなければ。ここがチームが tmux や場当たり的なスクリプトでは手に負えなくなる段であり、仕組みについては複数の Claude Code Agent を並列で実行する方法を参照してほしい。
ステージ4:オーケストレーションされた Crew
最上段では、1人のリーダー Agent がより大きな目標を解釈し、Tasks に分解し、他の Agent メンバーを招き入れ、それらの結果を統合して1つの Task に返す。Crew とは、1人のリーダー Agent が統括する、再利用可能な People と Agents のグループだ。あなたはもう個々の変更を割り当てているのではなく、成果を割り当てている。これは強力であると同時に、人間の受け入れを省きたくなる誘惑が最も強くなる段でもある。だからこそ、この段では受け入れゲートが最も重要になる。
作業が小さく明確に定義されているなら単一の Agent を使う。リーダーが目標を解釈し、他の Agent メンバーを巻き込み、その結果を1つの Task にまとめ戻す必要があるなら Crew を使う。Agent が何をしたかをレビューする可視性が整う前に、早まって次の段に登ってしまうのが、チームが最もよく痛い目を見るパターンだ。
エージェントのループ:調査・実行・テスト・報告
この動詞のループは、少し立ち止まって考える価値がある。Agent を高機能なオートコンプリートから分かつものだからだ。
調査。コードに触れる前に、有能な Agent はプロダクトのコンテキスト、コードベース、関連する過去の Tasks、チームのルールを読み、スコープと受け入れ基準を完成させる。これはチャットが完全にすっ飛ばすステップだ。プロンプトは何もないところから始まるが、Agent は今日のあなたのリポジトリから始める。
実行。Agent は独立した worktree の中で変更を加えるので、途中まで進んだ実行がメインブランチや他の Agent の作業を汚染することはない。その土台にあるのは地味で実績のある仕組み、Git worktrees だ。これにより、多数のブランチを別々の作業ディレクトリとして同時に存在させられる。
テスト。Agent は型チェック、テストスイート、ビルドを実行し、その結果を添付する。これが「とりあえずコードはここにある」と「通った変更です」の違いだ。根拠のないレポートは、ただの主張にすぎない。
報告。実行内容、ブロッカー、結果、フォローアップの議論は、プライベートなターミナルではなく Task のタイムラインに戻る。変更の要約、検証結果、既知の限界が、レビュアーが読める1か所に並ぶ。作業は常に Task に戻る。
この最後の動詞が、ワークフロー全体の静かな中心だ。結果がチャットウィンドウに消えるのではなく共有された Task に戻れば、エージェント型コーディングは個人の小技ではなくなり、チームが見て、レビューして、信頼できるものになる。
人間が留まる場所:受け入れ契約
エージェント型コーディングで最も重要な一文は、自動化しない部分についてのものだ。Agent は調査・実行・テスト・報告を行う。人は方向性を示し、権限を与え、結果を受け入れる。最終的な受け入れとリリースの判断は人に委ねる。
これを、人間が留まる3つの場所に分解しよう。
- 方向性。人はニーズを書き出し、目標を定める。Agent はスコープを形づくり、受け入れ基準を書くことができるが、意図はあなたから始まる。方向性がゴミであれば、自信に満ち、よくテストされた、間違った問題を解くコードが出来上がる。
- 権限。Agent はあなたが与えた範囲の中で行動する。どのリポジトリに触れてよいか、どの Computer 上で動くか、プルリクエストを開けるのか、それともマージ前に止まるべきか。権限は暗黙ではなく明示的だ。
- 受け入れ。人が変更の要約と根拠をレビューし、受け入れるか、変更を依頼するか、マージとリリースの工程を決める。このゲートは、Agent がどれほど優秀になっても機械に移ることはない。
これが、エージェント型コーディングをチーム規模で安全に運用できるようにする契約だ。自動化はチームの判断が必要な地点で止まり、完全なコンテキストと検査可能な根拠を備えた成果物を返す。この契約は優れた Agent の足を引っ張らないことにも注目してほしい。むしろ、その出力を判断する場所を与える。きれいな差分、グリーンのテスト、明確な要約を出す Agent なら、受け入れは速い。ゲートは摩擦ではなく、根拠に基づいて信頼が勝ち取られるか、保留されるかの分かれ目なのだ。
Sharkly を使ったチームワークフローとしてのエージェント型コーディング
ここまでの話はすべて、開発者1人と Agent 1体なら成り立つ。チームになると、作業・コンテキスト・レビューがどこか共有された場所にない限り破綻する。その隙間を埋めるのが Sharkly だ。
Sharkly は Claude Code や Codex など実行ツールの置き換えではない。チームがすでに使っているツールの周囲に、共有タスク、Computer、コンテキスト、コントロール、レビューのレイヤーを追加する。Claude Code、Codex、その類似ツールが実行を担う。Sharkly はそれらのツールをまたいで、チームレベルの割り当て、接続された Computers、Task のコンテキスト、進捗、ブロッカー、結果、人間によるレビューを管理する。チームがすでに設定しているモデルのサブスクリプションや API キーはそのまま使え、Sharkly が実行を割り当て可能で追跡可能なものにする。
4段のはしごがプロダクトにどう対応するかは次のとおりだ。
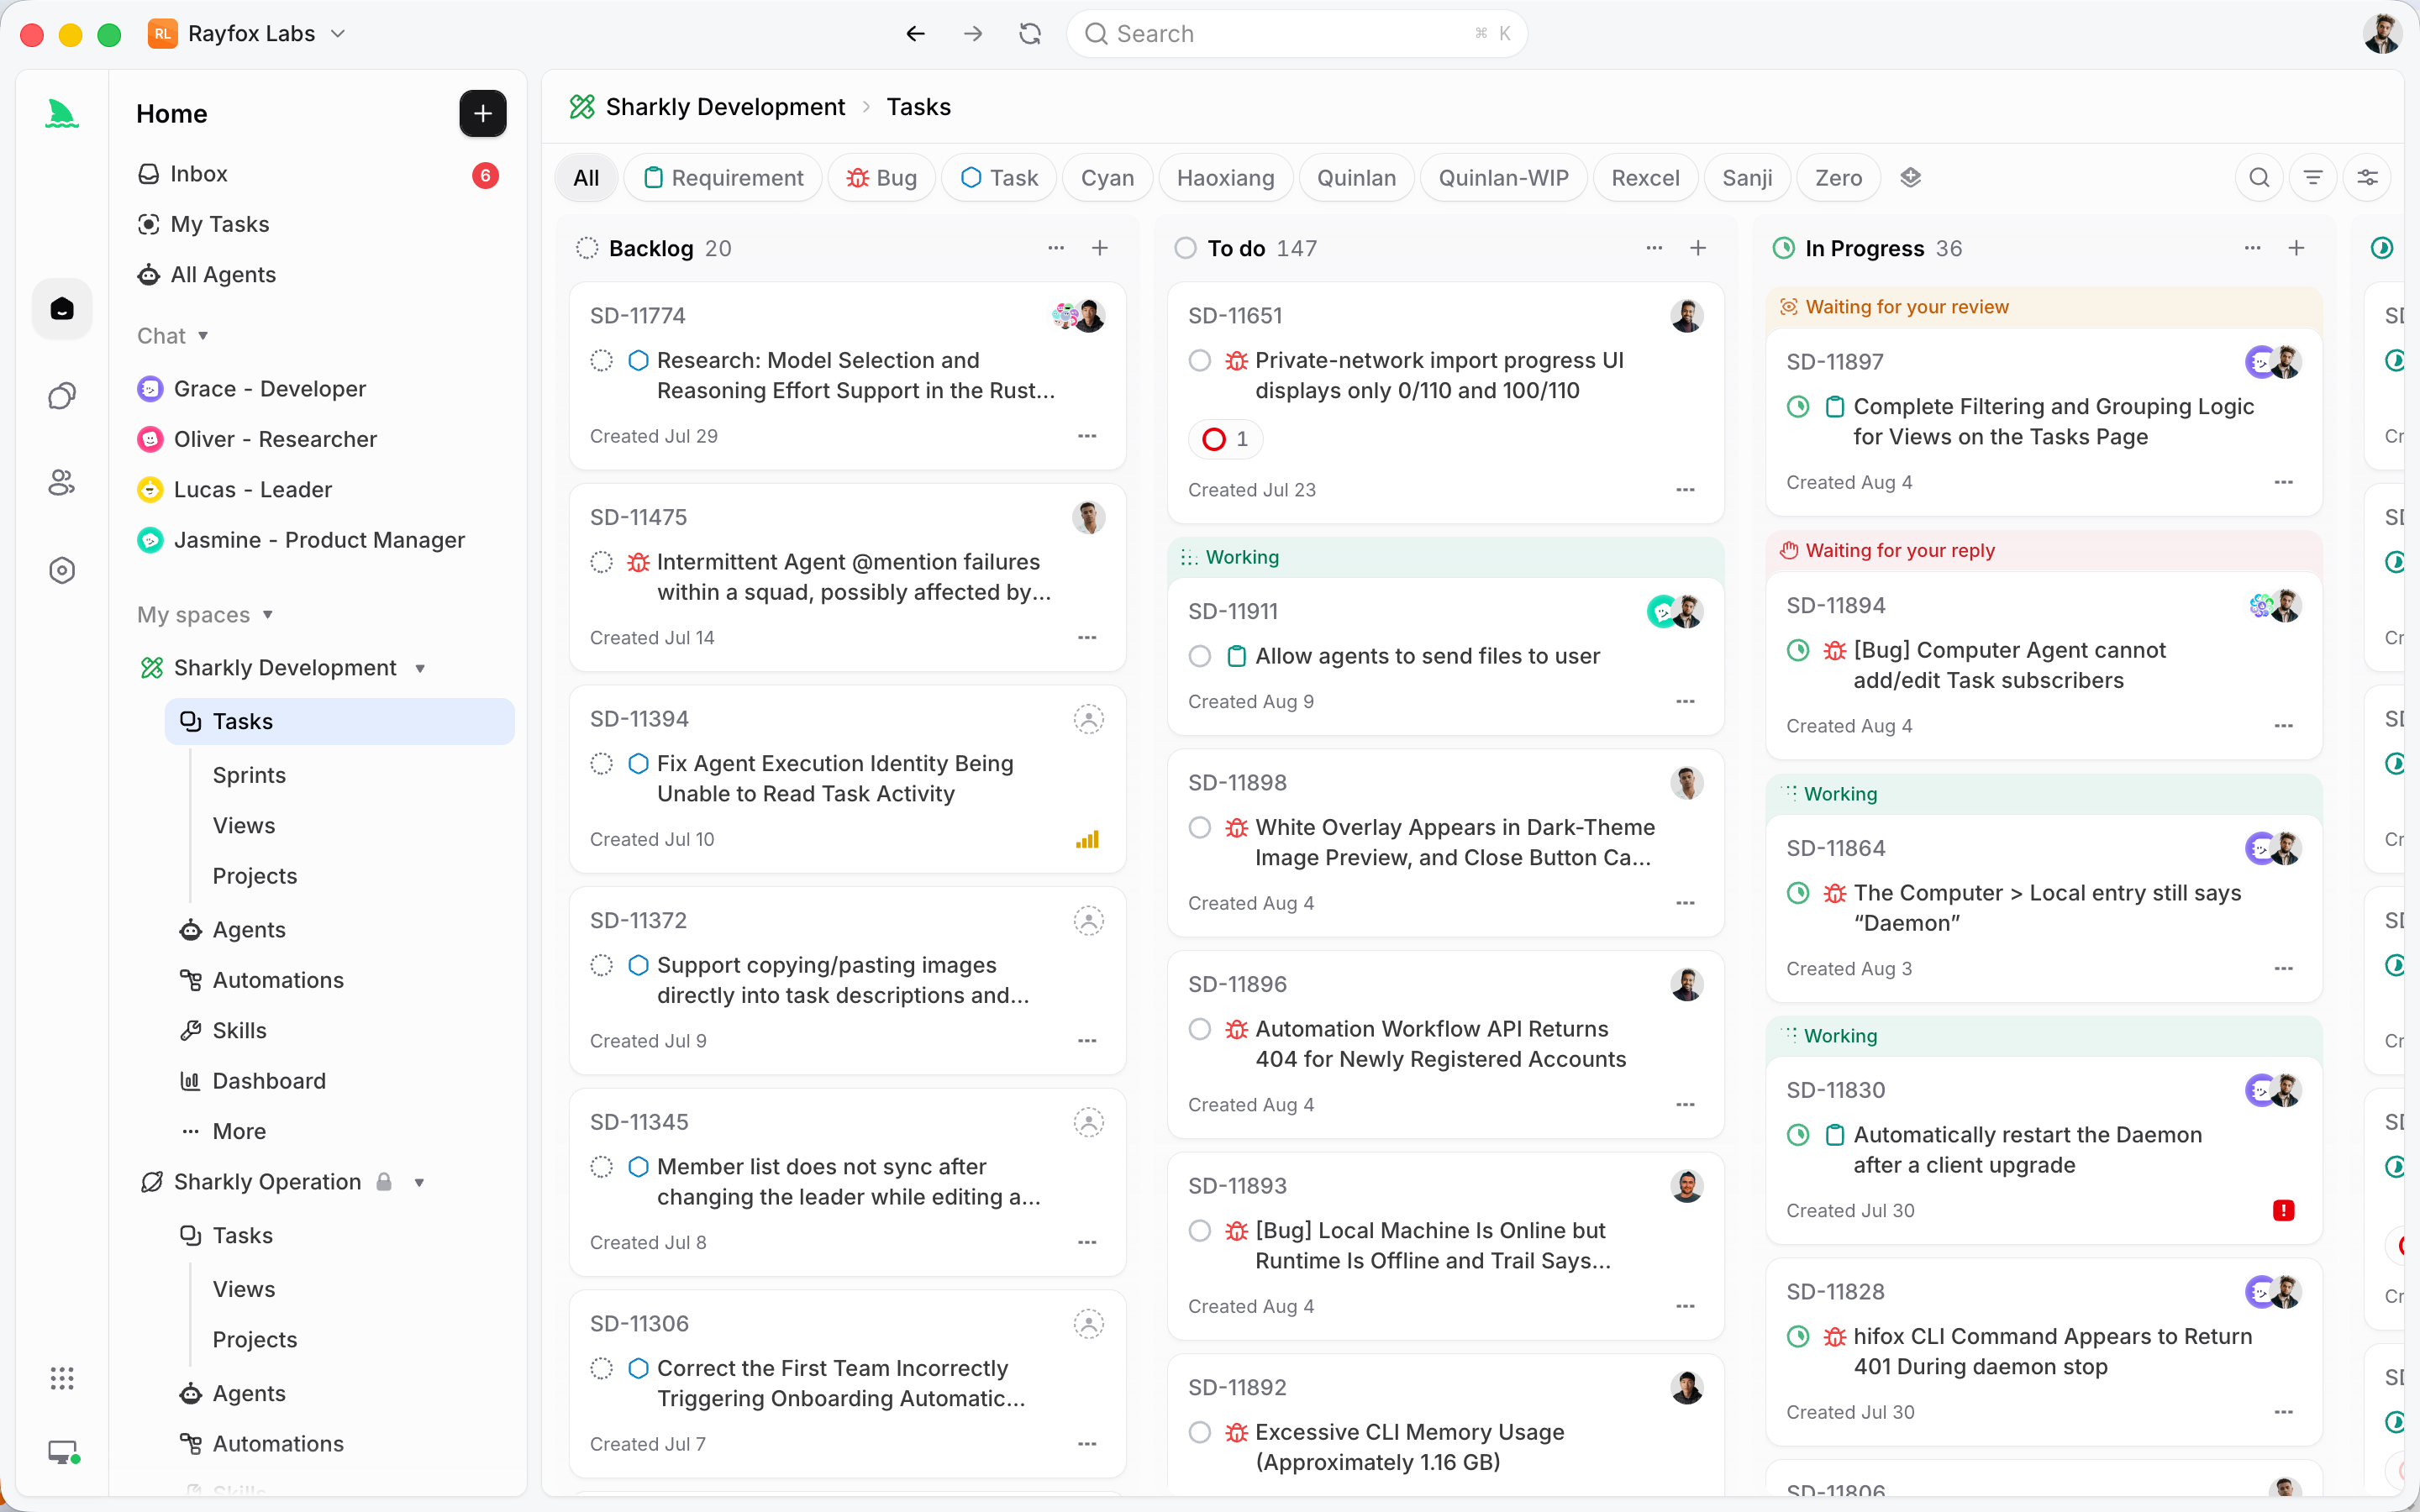
- Task は Sharkly における作業の主要な単位であり、リクエスト、Agent の差分、テスト結果、レビューがすべてここに集まる。チャットには決してなかった共有記録だ。
- Agent は作業をどう扱うべきかを定義し、Computer はホストとローカルリソースを提供し、Runtime は実際のエージェントセッションを実行し、Task はチームの共有記録であり続ける。それぞれの役割は1つの仕事を担う。
- 並列 Agent の実行が安全なのは、それぞれが接続された Computer 上の独立した worktree で動くからだ。同時実行が互いを踏みつけることはない。
- Crew はオーケストレーションの段を担う。1人のリーダー Agent が統括する、再利用可能な People と Agents のグループで、統合された結果は1つの Task に返される。
公式のプロダクト開発フローは、エージェントのループと受け入れ契約を正確になぞる4つの段として読める。人がニーズを書き出すと、Agent が調査して実行可能な Tasks を作成する。Agents が準備できた Tasks を引き受け、並列で開発する。Agent が型チェック、テスト、ビルドを実行して根拠を添え、人が受け入れるか変更を依頼する。チームは完了状況、所有権、依存関係、ブロッカーを共有プランで追跡する。チームのレバレッジは、AI チャットをたくさん開くことからは生まれない。役割、ルール、コンテキスト、ワークフローを共有し、1つの良いセットアップをチームが再利用できる開発能力にすることから生まれる。
実用的な成果は、コンテキスト、進捗、ブロッカー、結果、人間によるレビューが見える状態に保たれるシステムだ。始めるなら、リスクの低い Task を1つ依頼して割り当ててみよう。
エージェント型コーディング導入でよくある失敗
いくつかの失敗パターンは何度も何度も現れる。これらを避ければ、立ち上げはずっとスムーズになる。
- 単一の Agent をレビューできるようになる前に Crew へ登ってしまう。1つの Agent の仕事をきちんと見て受け入れられないなら、5つあれば埋もれてしまう。ステージ4の前にステージ2を極めよう。
- 曖昧な方向性を渡してしまう。「チェックアウトフローを改善して」は Task ではない。スコープを定めるか、Agent にスコープと受け入れ基準を下書きさせ、実行前にそれを確認しよう。
- 納期のプレッシャーで受け入れゲートを飛ばしてしまう。テストが通ったからと、Agent の出力を読まずにマージした瞬間、エージェント型コーディングをバイブコーディングに売り渡したことになる。テストが通ることは必要条件であって、十分条件ではない。
- 分離なしで並列 Agent を走らせてしまう。1つの作業ディレクトリを共有する同時実行の Agent は、互いの変更を壊し合う。Agent ごとに独立した worktree はステージ3では必須だ。
- コンテキストをプライベートチャットの中に置きっぱなしにしてしまう。変更の背景にある推論が Task 上になければ、次の人はレビューもできないし、その上に積み上げることもできない。記録は共有されたままにしておこう。
エージェント型コーディングと関連用語の比較
この領域の用語は混沌としている。エージェント型コーディングが、混同されがちな用語とどう並ぶかを示そう。
| 用語 | 意味 | 人間の立ち位置 |
|---|---|---|
| AI オートコンプリート/チャットアシスタント | モデルがエディタ内でコードを補完し、プロンプトに答える | すべてのステップの中心 |
| AI ペアプログラミング | 人間とモデルが同じコードで交互に作業する | 継続的に操縦している |
| バイブコーディング | 生成されたコードを読まずに受け入れる | 受け入れから外れている |
| エージェント型コーディング | 範囲を定めた Task を割り当て、Agent が調査・実行・テスト・報告する | 方向性と受け入れ |
| AI エージェント・オーケストレーション | チームをまたいで多数の Agents と実行を調整する | ルールを定め、成果をレビューする |
エージェント型コーディングはワークフローだ。オーケストレーションは、それを走らせる Agent が1つではなくなったときに必要になるものだ。両者は同じシステムの2本の柱であり、片方を導入したチームがもう片方もすぐに欲しくなるのはそのためだ。
実際のユースケース
納期が迫ったバックエンドのエンドポイント。開発者が新しいエンドポイント、その入力、受け入れ基準を Task として書き出す。Agent が既存のルートのパターンを調査し、独立した worktree でハンドラとテストを書き、スイートを実行し、グリーンのチェックが付いた差分を返す。開発者はレビューしてマージする。実際に手を動かした時間は、スコープを伝えるメッセージとレビューだけだ。
並列バグバッシュ。テックリードがスタンドアップ前に、無関係なバグの Tasks を6つ起票する。6つの Agents がそれらを引き受け、それぞれが自分の worktree と Computer で作業する。午前中には、各 Task にテストの根拠付きの差分が6つ並び、レビューできる状態になっている。もはや1人の注意力が6件の修正のスループットの上限にはならない。
Crew を使った設定ページ。より大きな目標、たとえばバックエンド・フロントエンド・マイグレーションを伴う設定ページを Crew に渡す。リーダー Agent がそれを Tasks に分解し、メンバーの Agents を巻き込み、統合された結果を1つの Task に返して、受け入れの判断を一度で済ませる。マネージャーはその間ずっと、共有されたスプリントの中で所有権、依存関係、ブロッカーを見ることができる。
まとめ
エージェント型コーディングは、賢くなったオートコンプリートではない。作業の単位が、貼り付けるプロンプトから割り当てる Task へと変わること、そしてそれに対応してあなたの役割が、書き手から監督者へと変わることだ。覚えておく価値のある定義はシンプルだ。
- Agent は調査・実行・テスト・報告を行い、人は方向性を示し、権限を与え、受け入れる。
- 成熟は4段をたどる。チャットアシスタント、単一の Agent、並列 Agents、オーケストレーションされた Crew。
- 受け入れゲートは、Agent がどれほど有能でも機械に移ることはない。
- 並列作業には分離が必要で、チーム作業には結果が戻ってくる共有 Task が必要だ。
- 難しいのは調整とレビューであり、それが Sharkly がすでに運用しているコーディングツールの周囲に追加するレイヤーだ。
役に立つ最も低い段から始めよう。Sharkly をダウンロードし、Computer を1台接続し、Agent を1つ作成して、小さく退屈な作業を割り当ててみる。結果は自分で受け入れる。この1つのループを一度回すだけで、どんな定義——これを含めて——よりもエージェント型コーディングについて多くを教えてくれる。
FAQ
エージェント型コーディングを簡単に言うと何ですか? チャットで1メッセージずつやり取りする代わりに、範囲を定めたひとまとまりの作業を AI コーディング Agent に割り当て、その Agent がコードベースを調査し、変更を加え、テストを実行し、根拠とともに報告するソフトウェアの作り方です。何を作るか、そしてその結果が出荷できる品質かどうかの判断は、あなたが握り続けます。
エージェント型コーディングは、ChatGPT や Copilot でコードを書くのとどう違いますか? チャットアシスタントやオートコンプリートはプロンプトに答えて結果をあなたに返し、統合と検証はあなたが行います。Agent は Task 全体を調査・実行・テスト・報告まで通します。単位がメッセージから作業のひとかたまりに変わり、Agent はまっさらな入力欄ではなく、あなたの実際のリポジトリから始めます。
エージェント型コーディングはバイブコーディングと同じですか? いいえ。バイブコーディングは生成されたコードを読まずに受け入れることで、人間を受け入れのステップから外してしまいます。エージェント型コーディングは受け入れをしっかり人に残し、中間の調査・実行・テストだけを自動化します。片方は近道、もう片方はレビュー可能なワークフローです。
エージェント型コーディングは開発者を置き換えますか? いいえ。開発者を、1行ずつタイプする立場から、方向性を示し、権限を与え、結果を受け入れる立場へと移します。Agent は調査・実行・テスト・報告を行い、何を作るか、出荷するかどうかは人が決めます。最終的な受け入れとリリースは人の手に残ります。
エージェント型コーディングを始めるにはどんなツールが必要ですか? タスクを実行できる AI コーディングツール(Claude Code、Codex など)と、チームをまたいで作業を割り当て、共有コンテキストを保ち、結果をレビューするためのレイヤーです。Sharkly がそのレイヤーにあたり、すでにお持ちの実行ツールとサブスクリプションの上で動きます。概要はSharkly とは何かをご覧ください。
チームは、多くのコーディング Agents をカオスにならずに同時に走らせるにはどうすればいいですか? 各 Agent は独立した worktree の中で自分の Task に取り組み、すべての結果は人がレビューできる共有 Task に戻ります。この組み合わせ——実行のための分離と、レビューのための共有記録——が、並列実行の衝突を防ぎます。セットアップについては複数の Claude Code Agent を並列で実行するガイドで扱っています。
エージェント型コーディングのワークフローで、人間はどこに留まりますか? 3つの地点です。方向性(何を作るか)、権限(Agent が何に触れてよいか)、受け入れ(結果を出荷するかどうか)。この地点の間は自動化できますが、この3つは人の手に残ります。


