
TL;DR: AIエージェントオーケストレーションとは、共通の目標に向けて複数のAIエージェントを連携・調整することです。誰がどのタスクを担当し、どのような順序・コンテキストで進め、最終的に結果をどう統合するかを制御します。大半のシステムは、シーケンシャル(順次処理)、ルーティング、パラレル(並列処理)、オーケストレーター・ワーカー、レビューサイクルの5つのパターンで網羅できます。Anthropic社独自のマルチエージェントシステムでは、通常のチャットの約15倍ものトークンを消費したとされており、まずは「動く最もシンプルな構成」を基本とすべきです。また、コーディングエージェントを運用するチームにとって、オーケストレーションの本質はタスク管理の問題(割り当て、作業環境の分離、引き継ぎ、人間によるレビュー)に帰着します。
2026年のある火曜日、開発現場ではよくある光景です。Claude Codeがマイグレーション作業を3つのサブエージェントに分割して実行しています。別のターミナルではCodexがテストスイートを走らせています。チームメンバーのGeminiセッションは、昨日作成されたプルリクエストをレビュー中です。どのツールも、配下のヘルパーたちをうまく連携させています。しかし、ツール同士を横断して統括する存在がいないため、2つのツールが同じ設定ファイルを同時に編集してしまったり、すでに変更されたコードに対してレビューが実行されたりしてしまいます。
この断絶を埋めるのが「AIエージェントオーケストレーション」です。この言葉は、エージェント同士をグラフ構造で結ぶPythonフレームワークから、どのチケットをどのコーディングエージェントに割り当てるかをチームで決める運用ルールまで、幅広い領域をカバーしています。本ガイドでは、引用可能な定義、各ベンダーが提唱する5つのパターン、オーケストレーションにかかるコスト、そしてエージェントがコードを書く際に考慮すべき変化について整理します。実践的なアプローチについては、複数のClaude Codeエージェントを並列実行するためのガイドをご覧ください。
AIエージェントオーケストレーションの定義と本質
AIエージェントオーケストレーションとは、共通の目標に向けて複数のAIエージェントを連携・調整することです。具体的には、どのエージェントがどの作業を担当し、どのような順序とコンテキストで実行し、それぞれの結果をどのように統合・検証するかを決定します。IBMの定義もこれに近く、「統合されたシステム内で、特化型の複数AIエージェントを協調させるプロセス」(IBM)としています。GitHubの定義には目的が明記されており、自律型エージェントを「共通の目標に向かって連携して動作させること」(GitHub)と説明されています。
ここで重要となるのが、「連携の判断を誰が下すのか」という区別です。Anthropicの「効果的なエージェントの構築」では、LLMとツールがあらかじめ定義されたコードパスによって制御される「ワークフロー」と、LLMが自身のプロセスやツールの使用を動的に判断する「エージェント」を明確に分けています。OpenAIのAgents SDKオーケストレーションガイドでも、「コードによるオーケストレーション」と「LLMによるオーケストレーション」として同様の境界線を引き、両者を組み合わせるアプローチを提案しています。
コードによるオーケストレーションは挙動の予測が容易で、デバッグのコストも抑えられます。一方、モデル(LLM)によるオーケストレーションは自由度の高いタスクに対応できますが、実行結果を完全には予測できないというトレードオフが生じます。そのため、多くの本番システムでは骨格をコードで制御し、その枠組みの中でモデルに判断を委ねる構成が採用されています。
代表的な5つのAIエージェントオーケストレーションパターン
主要なフレームワークによってパターンの呼称は異なりますが、表現している基本的な構造は共通しています。AutoGenやSemantic Kernelの後継であるMicrosoftのAgent Frameworkには5つのオーケストレーションが用意されており、GoogleのADKパターンページには7つが挙げられています。これらを相互にマッピングすると、次のようになります。
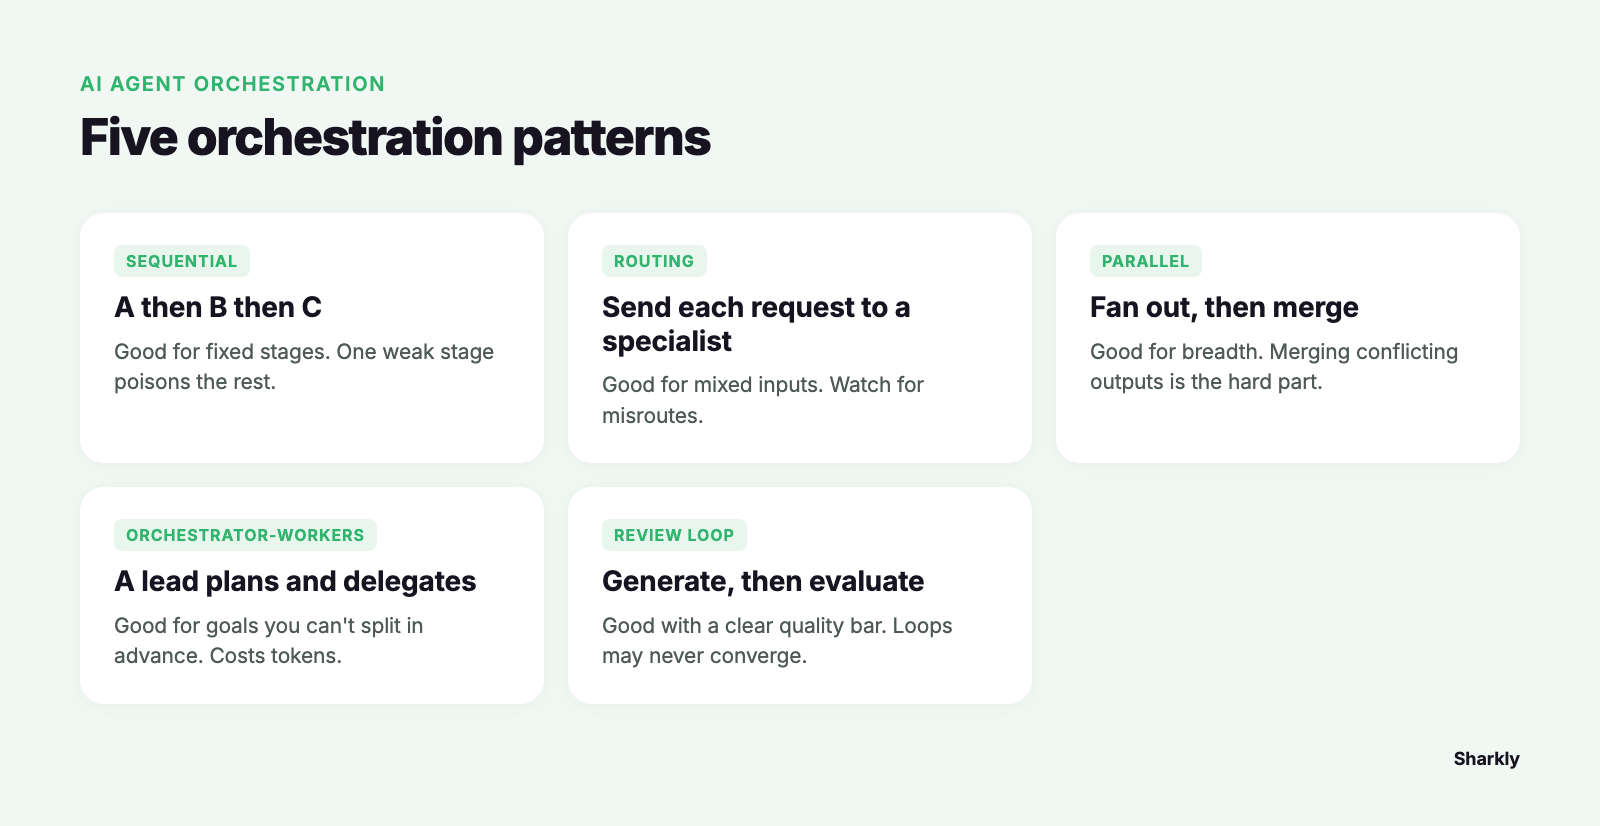
| パターン | 処理の流れ | 別名・関連用語 | 適した用途 | 注意点・リスク |
|---|---|---|---|---|
| シーケンシャル(順次実行) | エージェントAの出力をエージェントBに渡し、さらにCへ渡す | プロンプトチェイニング、パイプライン | ドラフト作成→チェック→フォーマット整形などの固定フェーズ | 途中の1つのフェーズで精度が落ちると後続全体に悪影響が及ぶ |
| ルーティング | 分類器またはエージェントが、リクエストの内容に応じて特定の専門エージェントへ振り分ける | ハンドオフ、トリアージ、コーディネーター | 異なる専門知識を要する多様な入力の処理 | ルーティングの誤りが、専門エージェント自体の失敗に見えてしまう |
| パラレル(並列実行) | 独立した処理を同時に実行し、最後に結果を統合する | 並行処理、Fan-out/Fan-in、セクショニング、多数決(投票) | 網羅性が必要なタスク:リサーチ、多角的な視点からのレビュー | 競合する出力結果の統合 |
| オーケストレーター・ワーカー | リーダー役のエージェントが計画を立て、ワーカーに委任し、結果をまとめる | スーパーバイザー、階層型(Hierarchical)、Magentic | 事前に作業を細分化できないタスク | トークン消費コストの増大、リーダーエージェントの判断ミス |
| レビューサイクル | 一方のエージェントが生成し、もう一方が評価するサイクルを繰り返す | Evaluator-Optimizer、生成&レビュー | 明確な品質基準がある作業 | 基準を満たせずループが収束しないリスク |
世間一般で「オーケストレーション」と言う場合、Anthropicが説明するオーケストレーター・ワーカーのパターンを指していることがほとんどです。同社はこれを「中心となるLLMがタスクを動的に分解し、ワーカーLLMに委任し、その結果を統合する構成」と説明しています。また、一部のフレームワークでは6つ目のパターンとして、共有スレッド上でエージェント同士が議論を行う「グループチャット」が追加されています。Microsoftのアーキテクチャガイドでは、このパターンのエージェント数を3体以下に抑えることを推奨しています。
AIエージェントオーケストレーションにかかるコスト
オーケストレーションの有効性を示すデータは実際に存在します。リーダーエージェントが3〜5個のサブエージェントを並列に起動するAnthropicのマルチエージェントリサーチシステムは、社内のリサーチ評価において「シングルエージェントのClaude Opus 4を90.2%上回るパフォーマンス」を示し、並列処理によって「複雑なクエリにおけるリサーチ時間を最大90%削減」しました。
しかし、同じ記事の中でそのコストについても言及されています。エージェントは通常のチャットの約4倍のトークンを消費し、「マルチエージェントシステムでは通常のチャットの約15倍ものトークンを消費する」とされています。BrowseCompのベンチマークでは、「トークン消費量単体でパフォーマンスのばらつきの80%が説明できる」と報告されています。エージェントを増やすということは、主に読み込む情報量が増えることを意味します。これは広範なリサーチには有効ですが、範囲の狭いタスクでは単に無駄なコストを発生させるだけです。
そのため、AnthropicとMicrosoftは揃って同様のアドバイスから始めています。Anthropicは「可能な限り最もシンプルなソリューションを見つけ、必要な場合にのみ複雑さを増すこと」を推奨しており、Microsoftのガイドでも「要件を確実に満たせる、最も低いレベルの複雑さを採用すること」と述べています。ほとんどの単一の変更作業においては、適切に指示が書かれた単一のエージェントのほうが、5つのエージェントで組まれた複雑なグラフよりも優れた成果を上げます。
コーディングツールにおける最も小規模で実践的なオーケストレーションの例をご紹介します。Claude Codeのサブエージェントは.claude/agents/内に置かれるファイルであり、メインセッションがこれにタスクを委任します。
---
name: test-writer
description: Writes missing unit tests for a module after a feature lands.
tools: Read, Edit, Bash
isolation: worktree
---
Write unit tests for the module you are given. Match the existing test style.
Run the suite and report which tests you added and whether they pass.
わずか8行でオーケストレーター・ワーカーが成立しています。メインセッションがリーダーとなり、サブエージェントは独立したコンテキストウィンドウと独自のworktreeで動作し、その結果がリーダーへと返されます。
コーディングエージェントにおけるオーケストレーション
コーディングエージェントには、リサーチ用エージェントにはない制約が伴います。作業成果が単一の共有リポジトリに反映されるため、2つのエージェントがそれぞれ単体では正しい変更を作成したとしても、互いに衝突(コンフリクト)してしまう可能性があります。Claude Codeの実験的機能(デフォルトでは無効)であるAgent Teamsのドキュメントにも、「2つのチームメンバーが同じファイルを編集すると上書きが発生する」と端的に記されています。
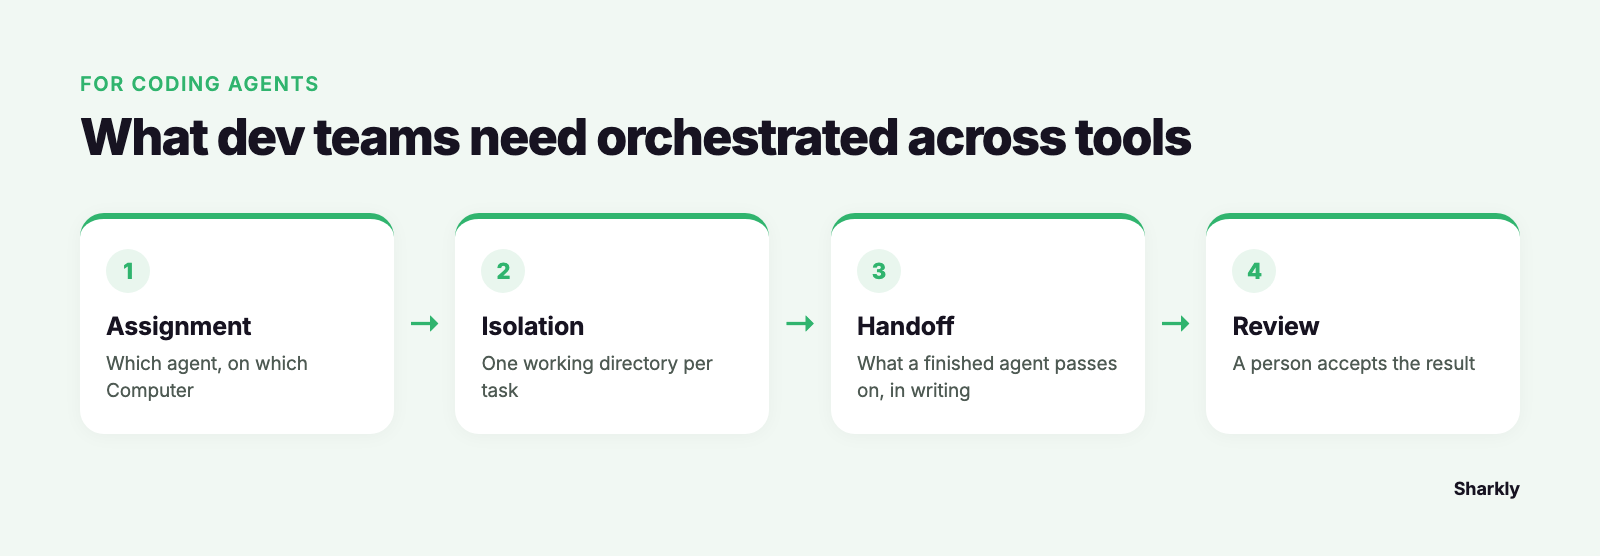
現在、各ベンダーは自社ツールの内部でオーケストレーションを行っています。Claude CodeにはサブエージェントやAgent Teamsがあり、Codexではサブエージェントワークフローがデフォルトで有効になっています。GitHubも2月にAgent HQを発表し、「IssueをCopilot、Claude、Codex、またはその3つすべてに割り当てて結果を比較する」機能を提供しています。しかし、どのツールもツール間や人間との調整までは行っておらず、開発チームが日常業務で直面しているのはまさにそのレイヤーの課題です。
- タスクの割り当て(Assignment): どのエージェントに、どのComputer上でタスクを実行させるか。どのコーディングエージェントにタスクを任せるべきかについての記事で、ルーティングの詳細を解説しています。
- 実行環境の分離(Isolation): 並列作業による競合やファイルの破損を防ぐため、タスクごとに作業ディレクトリを分離します。
- 引き継ぎ(Handoff): 作業を終えたエージェントが次の工程へ引き渡す内容を明文化します。詳細はコーディングエージェント向けの引き継ぎテンプレートをご覧ください。
- レビュー(Review): マージする前に人間が成果物を確認・承認します。Human-in-the-loop(人間参加型)のレビューワークフローでは、このゲートをどこに配置すべきかを解説しています。
エージェント製品を一から開発し、あらゆるステップを細かく制御したい場合は、LangGraph、OpenAI Agents SDK、Microsoft Agent Framework、ADKなどのオーケストレーションフレームワークが適しています。一方、Claude Code、Codex、Gemini CLIセッションなど、すでに個々のエージェントが導入されており、チーム全体でそれらの作業を協調・管理することが課題である場合は、マネジメントレイヤーが必要になります。
AIエージェントオーケストレーションにおけるSharklyの立ち位置
Sharklyはエージェントを構築するためのフレームワークではなく、Claude CodeやCodexなどの実行ツールに取って代わるものでもありません。それらの上位に位置する、マネジメントおよびオーケストレーションレイヤーです。すでにお手元にあるコーディングエージェントを、1つの「チーム」へと進化させます。
オーケストレーター・ワーカーのパターンは、Sharklyでは「Crew(クルー)」として機能します。Crewとは、1体のリーダーエージェントによって統括される、人間(People)とエージェント(Agents)の再利用可能なグループです。SharklyのCrewに関するドキュメントでは、次のような判断基準を示しています。「作業内容が小規模で明確な場合は、Taskを直接1体のエージェントに割り当ててください。リーダーが目標を解釈し、他のメンバーエージェントを巻き込んで結果を取りまとめる必要がある場合は、Crewを使用します。」実行はリーダー主導で行われ、Backlogに残されているCrew Taskが勝手にリーダーを起動することはありません。
どの構成を選択しても、管理フローの基本は変わりません。Taskにゴールが保持され、各実行は割り当てられたいずれかのComputer上で(デフォルトでは専用の作業ディレクトリ内で)行われ、実行状況、ブロッカー、最終成果物がTaskに集約されます。エージェントが調査、実装、テスト、レポートを行い、人間が方針を指示し、権限を付与し、成果物を承認します。リーダーがどのように作業を委任するかについてはAgents機能ページのCrewセクションで紹介しており、Sharkly Crewsの解説記事では具体的なワークフローを追って確認できます。
エージェント単体はすでに機能しており、人やリポジトリをまたいだ連携・調整にこそ課題を感じている――Sharklyはまさに、その課題を解決するために設計されています。
よくある質問(FAQ)
AIエージェントオーケストレーションは、マルチエージェントシステムと同じ意味ですか? 近い概念ですが、同一ではありません。マルチエージェントシステムは複数のエージェントが存在する構成そのものを指します。一方、オーケストレーションはその連携ロジック、つまり「誰が、いつ、どのようなコンテキストで実行され、どのように結果を統合するか」を指します。なお、単一のエージェントが複数のツールを使うだけのシステムであれば、オーケストレーションの必要性はほとんどありません。
AIエージェントオーケストレーションと、通常の「AIオーケストレーション」の違いは何ですか? 一般的なAIオーケストレーションは、モデル、データパイプライン、ツールをひとつのワークフローとして連携させることを指します。これに対してAIエージェントオーケストレーションはより限定的で、タスク内で自律的に判断を下すエージェント同士を協調・制御することを意味します。
エージェントをオーケストレーションするには、LangGraphのようなフレームワークが必要ですか? エージェントそのものを独自に開発する場合にのみ必要です。Claude CodeやCodexのようなコーディングエージェントは、すでにツール内部でサブエージェントを自律的にオーケストレーションしています。そのため、現場で必要となるのはタスクの割り当て、環境の分離、レビューといった実行全体のマネジメントです。まずは、AIエージェントに最初のタスクを割り当てるためのガイドから始めてみてください。
どのAIエージェントオーケストレーションパターンから始めるべきですか? まずは、明確なタスクを与えた単一のエージェントから始め、次にコードで制御するシーケンシャル(順次)またはパラレル(並列)の実行を試すのが最適です。オーケストレーター・ワーカーへの移行は、タスクを事前に分割できず、増大するトークンコストに見合う価値がある場合に検討してください。


