
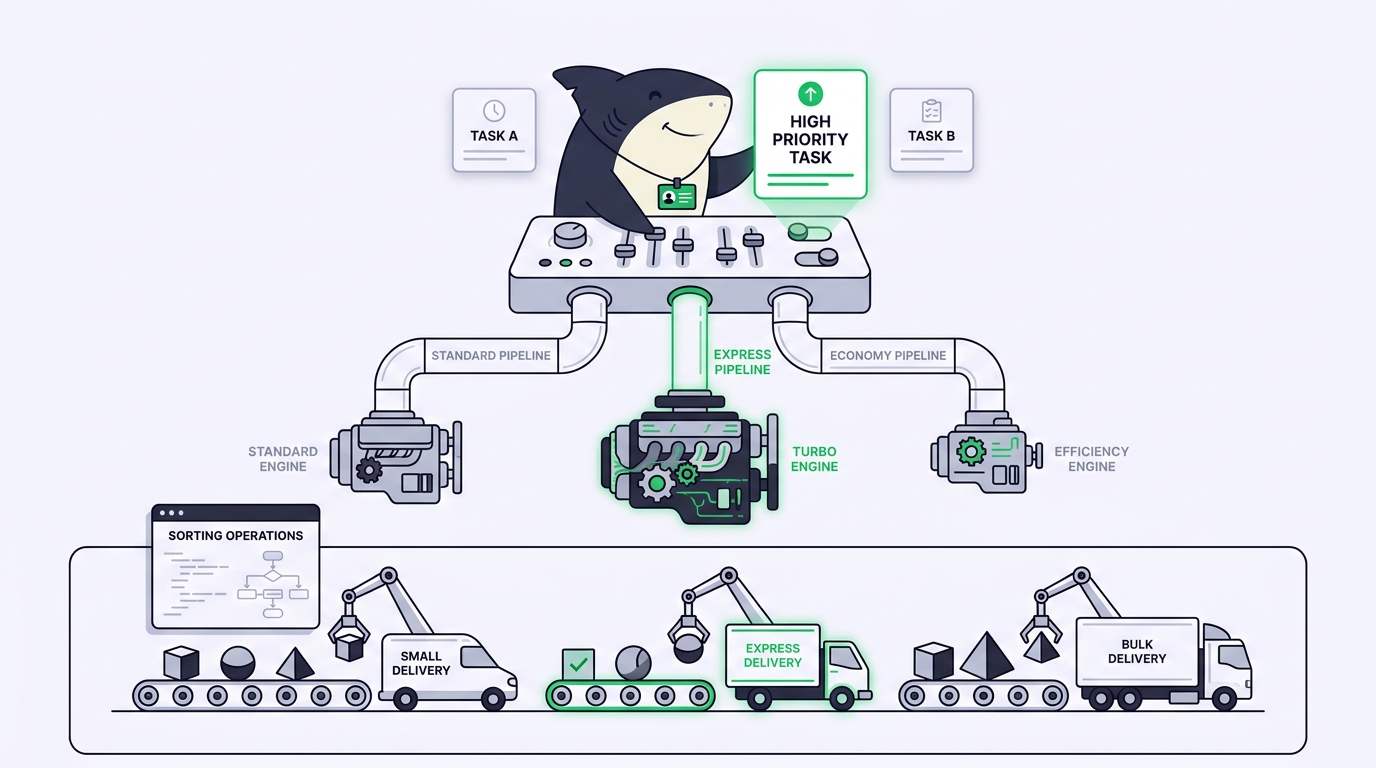
TL;DR: 唯一最高のモデルを探し回るのはやめよう。目の前のタスクの「形」にモデルを合わせる。アーキテクチャやファイルをまたぐリファクタリングには深い推論、ボイラープレートやテストには高速で安価なモデル、リポジトリ全体に関する質問には長いコンテキスト、多段階の編集には安定したツール追従性。ターミナルごとに選ぶやり方は、エージェントが1つか2つなら機能する。複数のリポジトリでいくつものタスクを動かすようになったら、そのマッピングは頭の中ではなく、保存されたAgentに置くべきだ。ここではそのマップ、実例、そして今日から実行できるチェックリストを紹介する。
5つのターミナルを開いている。1つでは厄介なリファクタリング、1つでは大量のユニットテスト、1つでは半分しか覚えていないコードベースへの質問への回答、1つでは不安定な統合テストの追跡、1つでは40ファイルにまたがるシンボルのリネーム。どれも同じ問いを黙って投げかけてくる。この作業はどのモデルで実行すべきか? リネームに重量級の推論モデルを向ければ、高速なモデルならきれいに終わる作業にトークンと時間を浪費する。アーキテクチャ変更に高速モデルを向ければ、3ファイル先の依存関係を見落とす。よく聞かれる不満は「モデルがダメだ」ではなく、「どれを使えばいいかわからない」だ。
解決策はリーダーボードではない。ランキングは数週間ごとに変わるし、汎用ベンチマークの勝者が、あなたの特定のタスクにとっては間違った選択であることも多い。長持ちするのは、モデルをタスクの形に合わせることだ。必要な推論の深さ、保持すべきコンテキストの量、ツールをどれだけ確実に追従する必要があるか、1回の実行にいくらかかるか。こうした性質は、モデル名が変わってもほとんど動かない。
ここでタスクレイヤーがその価値を発揮する。SharklyはオールインワンのAgentコマンド&管理プラットフォームだ。コーディングエージェントの上位に位置するので、「どのタスクにどのモデルか」をターミナルごとに決め直す必要がなくなる。その判断をAgentとして一度保存する。Agentは役割、ランタイム、そのルールをまとめた再利用可能な設定で、形の合うAgentにTaskを割り当てる。コーディングエージェントはすでに持っている。Sharklyはそれをチームに変える。
モデルはリーダーボードではなく、タスクの形に合わせる
モデルの選択とは、実際には順番に問う4つの問いだ。
- 推論の深さ。そのタスクはファイルをまたぐ多段階の計画を必要とするか、それとも局所的で機械的な変更か? アーキテクチャ、厄介なリファクタリング、根本原因のデバッグは、より強力な推論モデルが報われる。リネーム、フォーマット、スキャフォールディングはそうではない。
- コンテキストサイズ。モデルはリポジトリ全体、長い仕様書、巨大なログを一度に保持する必要があるか? コードベース全体に関する質問や大規模なマイグレーションでは、推論が少し浅くても長コンテキストモデルが有利だ。
- ツール追従の信頼性。多段階の作業(編集、テスト実行、出力の読み取り、再編集)は、モデルがどれだけ一貫して脱線せずにツールを使えるかにかかっている。素晴らしく推論してもテストの実行を忘れるモデルは、ここではより安定したモデルに劣る。
- 速度とコスト。大量でリスクの低い作業(テスト、ボイラープレート、docstring)は、基準を満たす最速かつ最安のモデルに任せるべきだ。高価な推論は、それが結果を左右するタスクのために取っておこう。
1つの誤ったステップが午後をデバッグで潰すようなら、重量級の推論モデルを使う。タスクが機械的で検証が簡単なら、高速で安価なモデルを使う。ほとんどの日は、異なるタスクで同時に両方が必要になる。だからこそ、単一のグローバルモデル設定はしっくりこない。異なる答えを求めるタスクに1つの答えを押し付けるからだ。
タスク種別からモデル役割へのおおまかなマップ
以下のタスク名は、特定のモデルバージョンより長く生き残る。バケットを名前に固定する前に、ベンダーの最新のモデルカードを読んでおこう。そしてバケットはそのままにしておく。
| 目の前のタスク | 最適化する対象 | モデルの役割 |
|---|---|---|
| アーキテクチャ、ファイルをまたぐリファクタリング、設計レビュー | 推論の深さ | 重量級リーズナー |
| 根本原因のデバッグ、不安定なテストの追跡 | 推論+安定したツール操作 | 重量級リーズナー |
| リポジトリ全体のQ&A、大規模マイグレーション、長い仕様の作業 | コンテキストサイズ | 長コンテキストモデル |
| ユニットテスト、ボイラープレート、docstring、スキャフォールディング | 速度とコスト | 高速で安価なモデル |
| 機械的なリネーム、フォーマット、一括編集 | 速度 | 高速で安価なモデル |
| 多段階のエージェントループ(編集、テスト、繰り返し) | ツール追従の信頼性 | 安定したツール利用者 |
正直に2点補足しておく。第一に、「重量級」は「常に優れている」という意味ではない。リネームでは、深い推論モデルは高速モデルより遅く、高価で、正確さも変わらない。第二に、Claude Code、Codex、Gemini CLI のようなランタイムには独自のデフォルトモデルがあり、モデルの利用はツールで設定されたサブスクリプションまたはAPIキーを通じて続く。つまり実際の選択肢は、チームがすでに支払っているモデルをこれらのバケットに当てはめたものになる。SWE-benchのような公開タスクベンチマークは、モデルがどの階層に位置するかをおおよそ教えてくれるが、あなたの正確なタスクにどのモデルが必要かは教えてくれない。
ターミナルごとのモデル選択がスケールしなくなる地点
エージェントが1つか2つなら、手動で選んでも問題ない。ターミナルを開き、モデルを設定し、2つしかないからどこに何があるか覚えている。今日うまくいっている構成は、1人の人間と2~3のツールだ。
問題は量が増えたときに始まる。3つのリポジトリで6つのタスクを動かすと、モデルとタスクのマッピングは頭の中に住み着く。どのターミナルが安い方か、先週の火曜日にどのリポジトリをリーズナーに設定したか、なぜマイグレーションが遅いのか(高速モデルのままにしていた)。同僚があなたの作業を引き継いでも、マッピングはタスクと一緒には移動しない。あなたの記憶に残り、結果は共有される場所に戻らず、プライベートなターミナルに散らばる。
Agentとは、ある種の作業をどう扱うべきかの保存された設定だ。役割、ランタイムとそのモデル、そしてそれに付随するルール。ターミナルごとにモデルを決め直す代わりに、Agentを一度作る(高速モデルの「Test Writer」、リーズナーの「Refactorer」)。そして形の合うAgentにTaskを割り当てる。モデルの選択は記憶ゲームではなく、再利用可能なものになる。Agentは調査し、実行し、テストし、報告する。人間は方向性を定め、結果を承認する。実行、ブロッカー、結果はTaskに戻るので、各モデル選択の根拠はリクエストからリリースまで可視化され、スクロールバックに埋もれない。
SharklyはClaude Code、Codex、その他の実行ツールの代替ではない。チームがすでに動かしているモデルの周りに、共有のタスク、コンテキスト、レビューのレイヤーを追加する。1つのターミナルで1つのエージェントしか動かさないなら、必要ない。複数のエージェントを並行して動かすようになったら、モデルマッチングの判断こそ保存する価値がある。
実例:3つのタスク、3つのAgent
あるスプリントで3つのタスクがキューに入ったとしよう。
- SH-312:リポジトリ全体で
UserSessionをAuthSessionにリネーム。機械的で検証が簡単。高速で安価なモデルの「Renamer」Agentに回す。編集し、型チェッカーを実行し、きれいなdiffを返す。ここでリーズナーのトークンを使っても何も得られない。 - SH-318:チェックアウトフローがリトライ時に二重請求する。サービスをまたぐ根本原因のデバッグ。安定したツール操作ができる重量級リーズナーの「Debugger」Agentに回す。計画を立て、ログを読み、仮説を立て、検証する必要がある。ここで高速モデルを使うと当て推量になり、レビューサイクルを無駄にする。
- SH-324:コードベースから「請求はStripeとどう突合しているか?」に答える。リポジトリ全体に関する質問。関連ファイルを一度に保持できる長コンテキストモデルの「Codebase Analyst」Agentに回す。
各Agentはそれぞれ独立したworktreeで実行されるので、3つのモデルが3つのタスクを同時に、互いに干渉せずに進められる。各結果は変更サマリーとエビデンスとともにTaskに戻る。レビューするのは3つの完成した成果物であり、記憶から再構築しなければならない3つのターミナルではない。自動化はあなたの判断が必要なところで止まる。承認する、変更を依頼する、マージを決める。
今日から実行できるチェックリスト
次のエージェント作業のバッチの前に、これを実行しよう。
- [ ] 各タスクについて、まずその形を名付ける。推論重視、コンテキスト重視、ツールループ重視、大量の機械的作業のどれか。
- [ ] その形の基準を満たす最も安価なモデルを割り当てる。リーズナーは、誤ったステップが実際の時間を奪うタスクのために取っておく。
- [ ] 長コンテキストの作業は、習慣でお気に入りのリーズナーにではなく、長コンテキストモデルに任せる。
- [ ] 多段階ループでは、生のベンチマーク順位よりもツール追従の信頼性を重んじる。
- [ ] マッピングを役割ごとの再利用可能なAgentとして一度書き留め、あなたも同僚もターミナルごとに決め直すのをやめる。
- [ ] 最終承認は人間が担当する。モデルが道筋を選び、あなたが結果を承認する。
モデルをタスクに合わせ、その組み合わせをAgentとして保存すれば、この記事の出発点となった問い(「どれを使えばいい?」)は、ターミナルごとではなく役割ごとに一度答えるだけで済む。
すべてを1つのモデルに決めるのではなく、複数のコーディングエージェントを使い続けたいなら、それこそSharklyが解決しようとしている課題だ。ターミナルごとにモデルを手動で選ぶこともできるし、ワークフロー全体を1か所で管理して、各結果をTaskに戻すこともできる。
FAQ
すべてに最高位のモデルを使えばいいのでは? いいえ。最高の汎用モデルは、機械的な作業では必要以上に遅く高価で、正確さも変わらない。順位はモデルがどの階層にいるかを教え、タスクの形はどの階層が必要かを教える。この2つを突き合わせる方が、リーダーボードの勝者をデフォルトにするより優れている。
タスクの難易度がまだわからないとき、どうモデルを選べばいい? 安いモデルから始めて、エスカレーションする。まず高速モデルにタスクを渡す。行き詰まる、当て推量になる、レビューで落ちるなら、それがタスクは推論重視だというシグナルであり、より強力なモデルに昇格させる。human-in-the-loopのレビューステップで、出荷前にミスマッチを捉える。
Sharklyがモデルを選んでくれる? Sharklyは自分でモデルを選ばない。Agentを作るときに役割をランタイムとそのモデルに紐づけ、作業の形に合うAgentにTaskを割り当てる。選択はあなたのものだ。Sharklyはそれを再利用可能にし、各実行の結果をプライベートなターミナルではなくTaskに残す。


