
あなたは最高のコーディングエージェントを選ぼうとしている。リーダーボードを読み、リリース記事を眺め、同じプロンプトを Claude Code、Codex、Gemini CLI で走らせて、どれが一番キレるかを確かめる。そこへ新しいモデルが出てランキングが入れ替わり、先月標準にしたエージェントが突然中位に落ちる。で、また乗り換える。
ここが居心地の悪いところだ。あなたが選ぶエージェントは、思っているほどあなたの一週間を変えない。実際に出荷できる仕事量を決めるのは、エージェントの周辺で起きていることだ。どのエージェントがどのタスクを担当しているか、何が完了し、何が失敗し、何があなたのレビュー待ちか。ほとんどの開発者はランキングの引力を感じながら、ランキングがボトルネックだったことなんて一度もないことに気づかない。
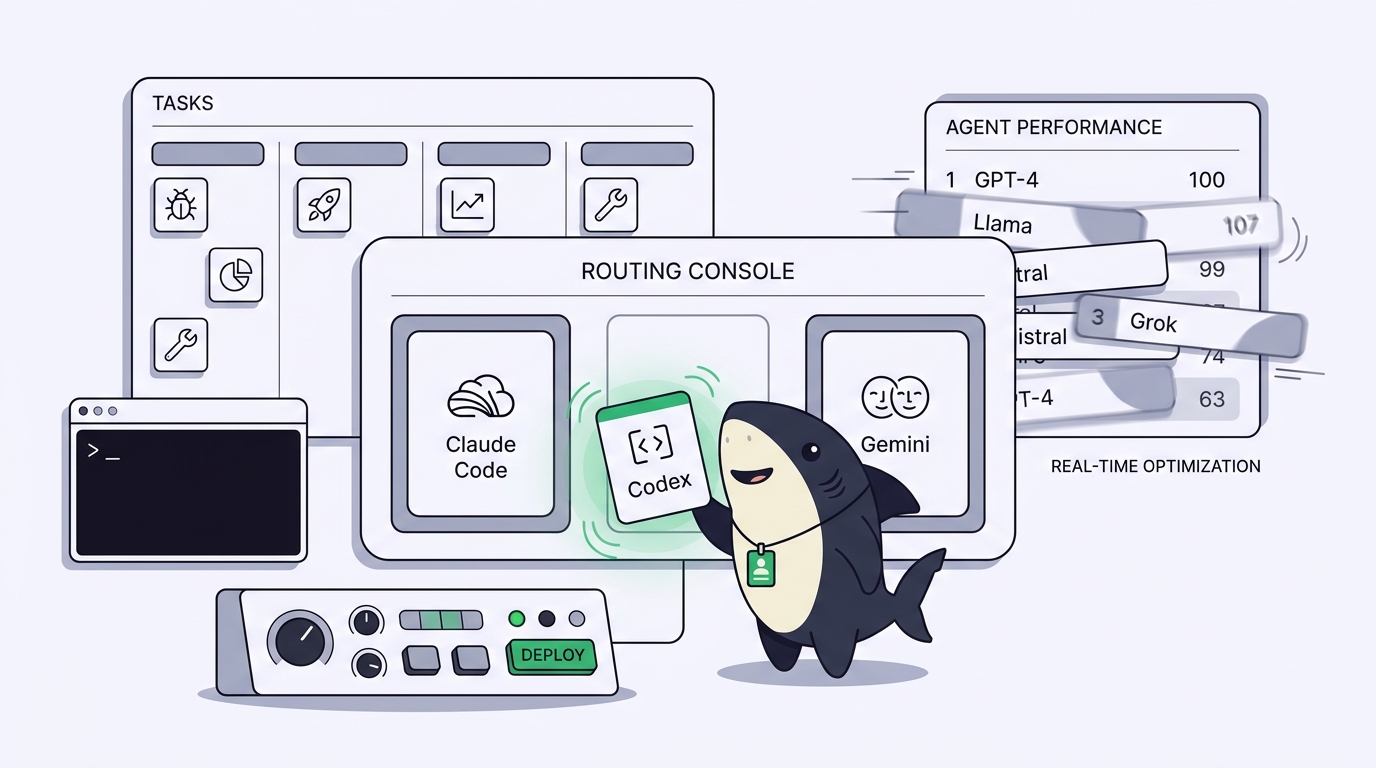
Sharkly はその観察を土台に作られている。Sharkly はオールインワンのエージェント指揮・管理プラットフォームだ。自分の Computer を接続し、すでに使っている任意の Agent に Task を割り当てると、実行ごとにその diff、テスト出力、レビューが一か所に返ってくる。エージェントの横に並ぶのではなく、その上位に立つ。本記事では、なぜ管理レイヤーがモデル以上にアウトプットを左右するのか、そして次のリーダーボードを追いかける代わりに今四半期に何をすべきかを解説する。
最高のエージェントは動く標的だ
コーディングエージェントのリーダーボードは、ある時点で固定された共通の問題セットを測定している。このどちらも、すぐに古びる。問題セットはあなたのコードベースではないし、その時点は来月ではない。
ペースを見てみよう。Anthropic、OpenAI、Google はこの一年でコーディングエージェント対応のモデル更新をそれぞれ何度も出しており、その相対的な順位は何度も入れ替わっている [VERIFY: 正確なリリース頻度と現在のランキングは毎月変わる。具体的な数字を引用する前に確認すること]。もし「最高のエージェントを使う」を意思決定だと捉えるなら、ラボが新モデルを出すたびにその決定をやり直す契約を結んでいるようなものだ。乗り換えには必ずコストが伴う。新しい設定、新しいコンテキストファイル、新しい習慣、そしてチームが学ばなければならない新たな失敗パターンだ。
ここで一つの予測を挙げる。予測として明示しておく。トップクラスのコーディングエージェント間の差は、広がるのではなく、今後も縮まり続ける。3つのエージェントがあなたのリポジトリの同じバグをすべて修正できるようになれば、問いは「どれが最高か」ではなく「この特定のタスクはどれに渡し、結果をどう確認するか」になる。差別化要因はモデルからワークフローへと移る。この変化は、チームがエージェントについて語る様子にもすでに表れている。例外ではなく、これが当たり前の働き方になるだろう。
動く標的への防御は、より良い狙いではない。標的が動いても生き残るワークフローだ。自分のコードベースでエージェントを比較することで、今日動かす価値のあるエージェントが分かる。ただし、明日もその答えに縛られるわけではない。
アウトプットを実際に決めているもの
タスクがどこに時間を使っているかを数字で見てみよう。エージェントが diff を生成するのは数分だ。それ以外のすべて、どのエージェントにタスクを渡すかの判断、その変更を他の4つのエージェントから隔離しておくこと、ビルドステップで止まっていることに気づくこと、生成物を読み、採用するか却下するか。これらがあなたの一日を食いつぶす。どれもモデルの性質ではない。
これが管理の問題であり、2つ以上のエージェントを動かした瞬間に姿を現す。どのエージェントが何を担当しているのか。次のタスクはどれに渡すべきか。何が完了し、何が失敗し、何が人間の目を必要としているのか。同じリポジトリを編集する3つのエージェントが同じファイルに触れないようにするにはどうするか。個々のエージェントの能力が上がるほど、同時に動かす数も増え、これらの問いはより鋭くなる。
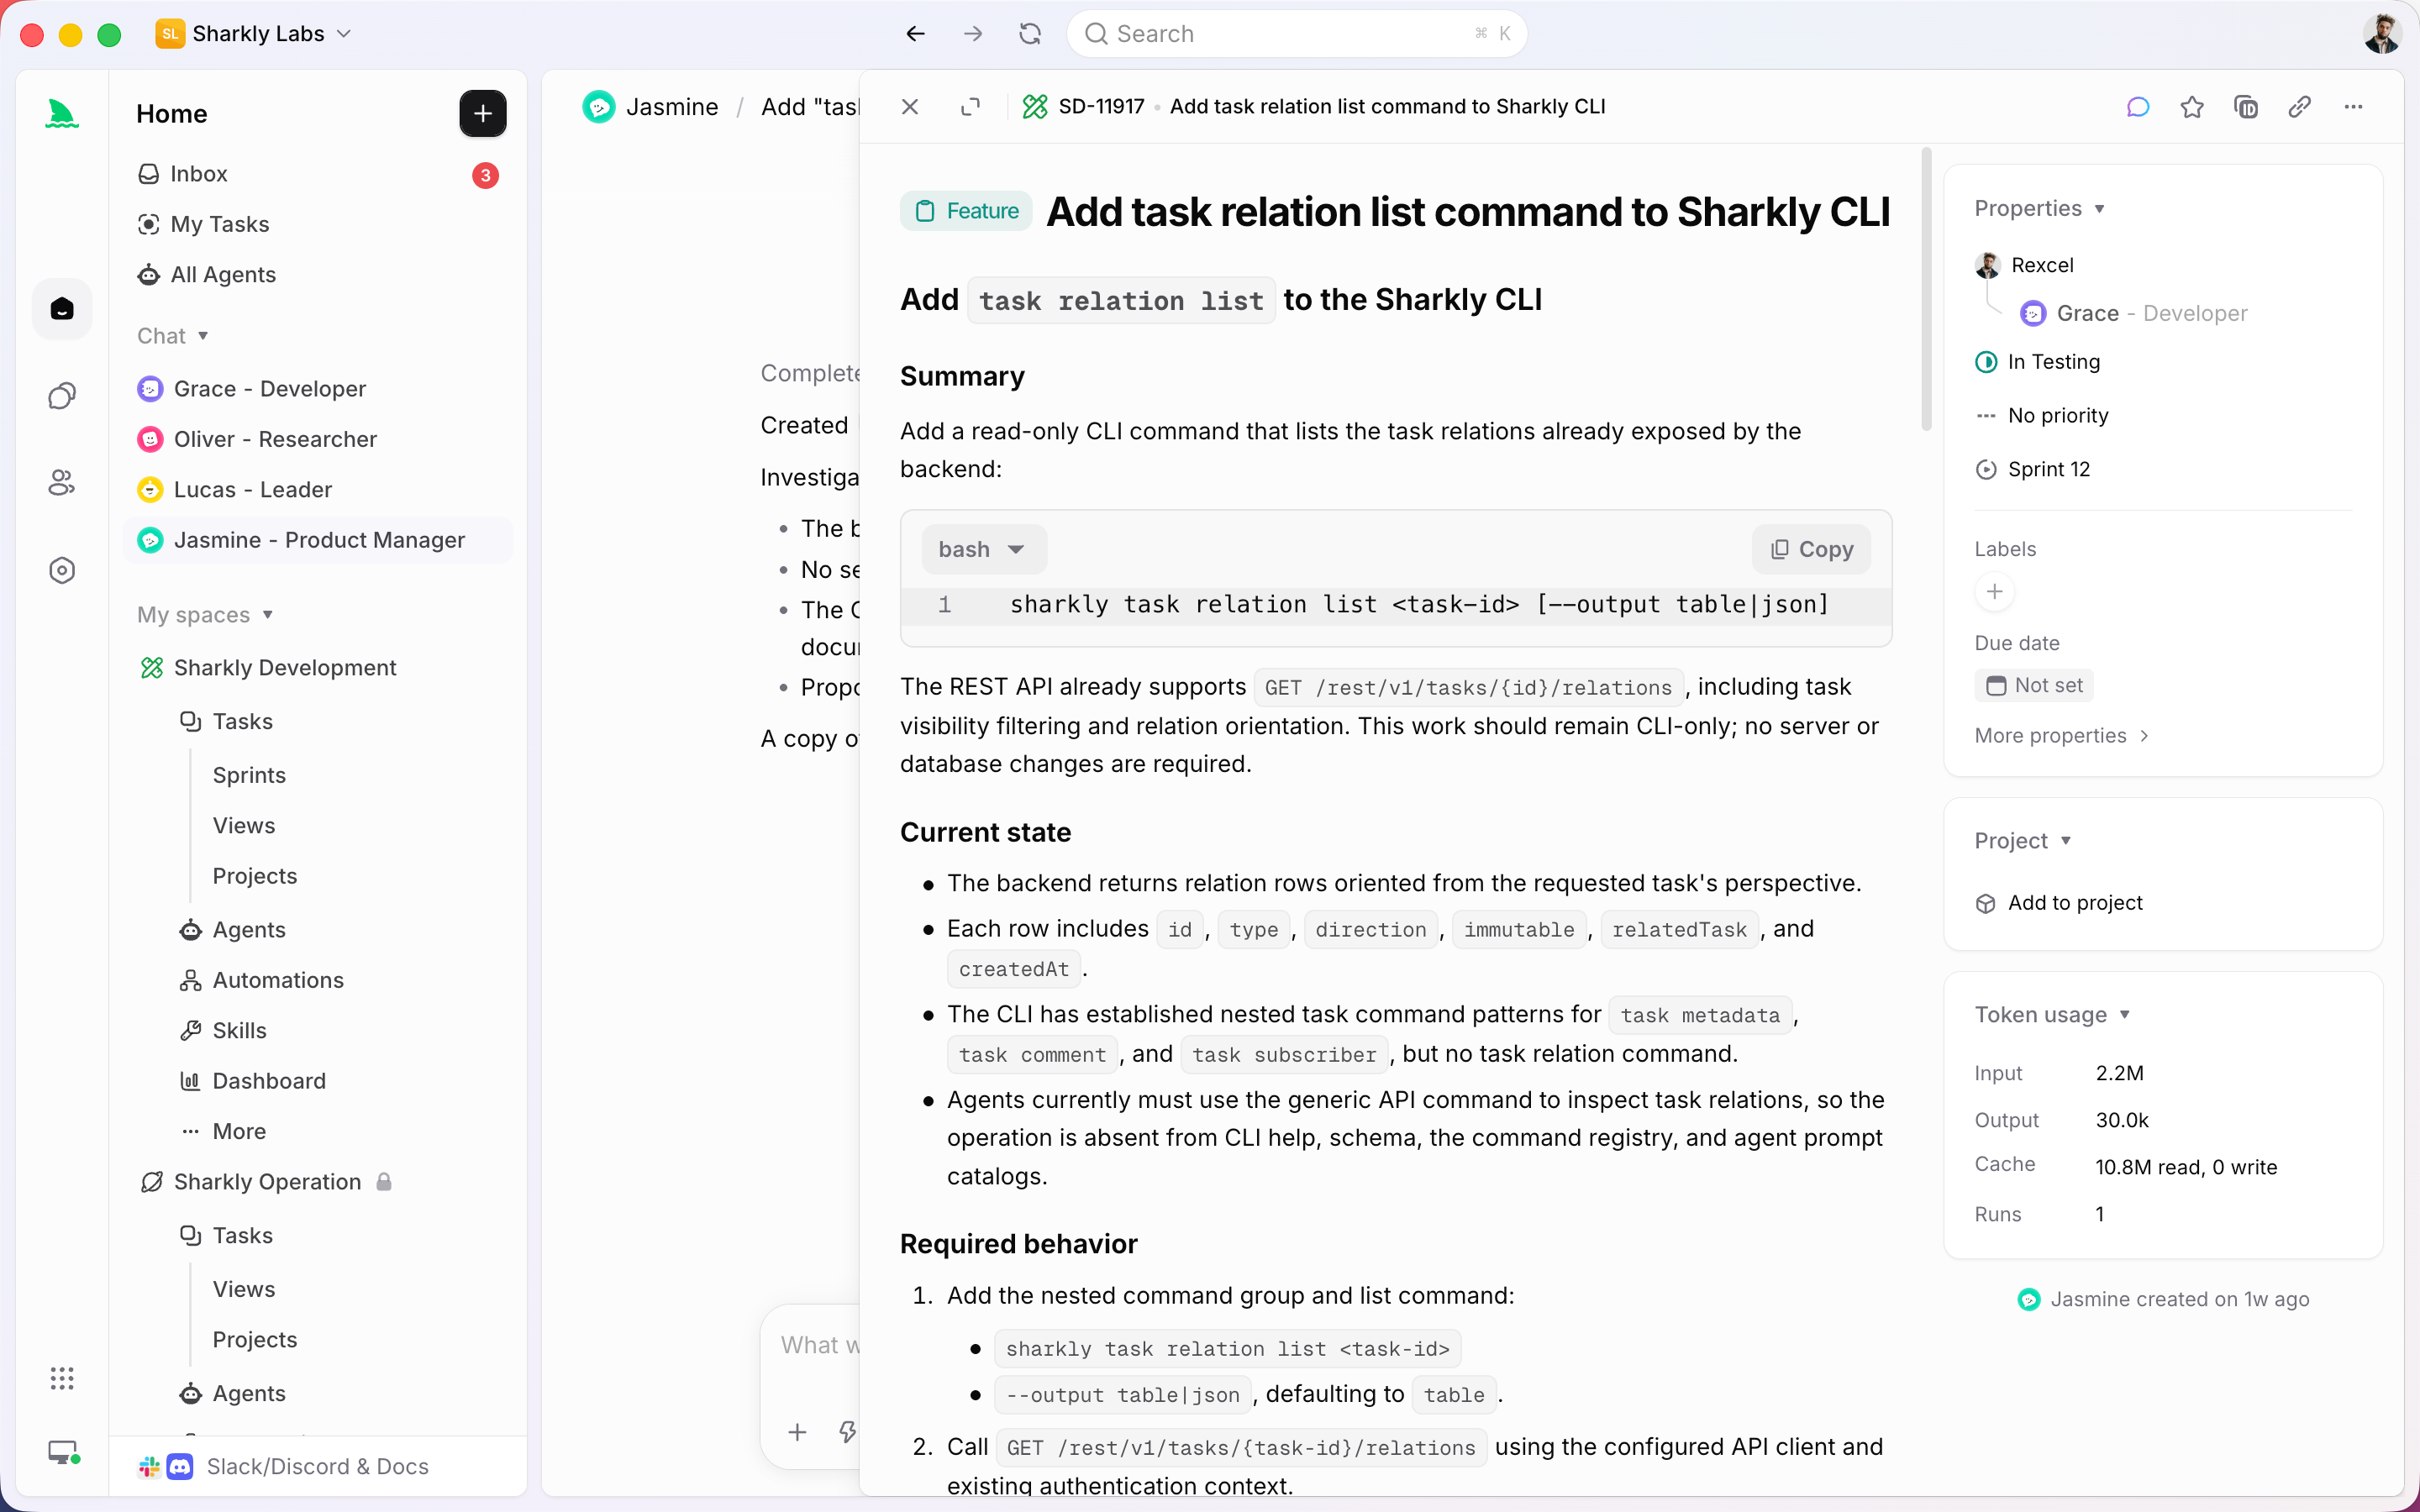
Sharkly はこれらにツールではなくレイヤーとして答える。Task が作業の基本単位だ。Task を Agent に割り当てると、Agent は接続された Computer 上の隔離された worktree で実行され、実行状況、ブロッカー、結果、フォローアップはすべて Task に返ってくる。作業を担ったエージェントは Task の設定であり、セットアップ全体のアーキテクチャではない。次のタスクで Claude Code を Codex に差し替えても、プロセスの他の何も変わらない。これがプロバイダー中立性の価値だ。今どのエージェントが勝っていようと、あなたのワークフローのほうが長く生き残る。
レビュー能力こそが本当の天井
「完了」と出力したエージェントは、まだ何も出荷していない。人間が diff を読み、テストを確認し、判断しなければならない。コード生成ではなく、このレビュー工程こそ、ほぼすべてのチームが最初にぶつかる制約だ。
計算は容赦ない。1つのエージェントが20分で一日分のレビュー可能な作業を生み出すなら、5つのエージェントは同じ20分で5日分のレビューを生み出す。そしてあなたの目は依然として一対しかない。より速く、より賢いエージェントは、キューを早く埋めるぶん、事態を悪化させる。最高のエージェントを選ぶことは、決してボトルネックではなかった工程を最適化し、実際のボトルネックには手をつけないままだ。レビュー能力は、チームが並列エージェントの作業をどれだけ吸収できるかの真の限界だ。そしてモデルのアップグレードはこの算術を変えない。
だから重要な意思決定のペアは「Claude Code か Codex か」ではない。これだ。制約が変更の初稿を生成することにあるなら、より速いエージェントを使う。制約が変更が正しいかを判断することにあるなら、レビューのワークフローに投資する。エージェントを並列で動かすほとんどのチームでは、2つ目の制約のほうがはるかに早く効いてくる。解決策は、すべての実行をタスクレベルのエビデンスでレビュー可能にすることだ。diff、型チェックとテストの出力、変更サマリー、そしてエージェントが認める限界。それらをターミナルに散らばせるのではなく、一か所に集める。
ここで人間とエージェントの契約が意味を持つ。エージェントは調査し、実行し、テストし、報告する。人間は方向性を定め、権限を与え、結果を受け入れる。自動化はチームの判断が必要なところで止まる。より良いエージェントは最初の文の仕事を増やすが、2番目の文の仕事は一切しない。天井はその線のあなた側にある。
エージェントの選択はアーキテクチャではなく設定にする
ここで境界をはっきり述べておく。誤解のないように。Sharkly はコーディングエージェントではなく、Claude Code、Codex、その他のランタイムの代替でもない。彼らより良いコードを書くわけではない。チームがすでに使っているツールの周囲に、共有の Task、Computer、コンテキスト、レビューのレイヤーを追加するのだ。
この区別が要点だ。エージェントの選択が設定であれば、新しいエージェントを試すコストはタスク一つ分で、移行ではない。ランタイムを接続し、実際の要件を割り当て、昨日使ったエージェントの結果と並べて返ってきたものを読む。エージェントの選択がアーキテクチャに組み込まれていると、すべての実験が高くつき、リーダーボードの入れ替わりがすべて脅威になる。
これが不要なケースについても正直に言っておこう。コーディングエージェントを1つだけ使い、単一のターミナルで満足しているなら、専用の worktree で丁寧に調整した Claude Code セッションで十分であり、管理レイヤーは省けるオーバーヘッドだ。方程式が変わるのは、2つ以上のエージェントを、複数のタスクやリポジトリにまたがって動かし、その結果をスクロールバックを実況しなくてもチームメイトが読める形で欲しくなったときだ。それが、コーディングエージェント管理が、単なる良いアイデアではなく実際に必要なレイヤーになる閾値だ。
今四半期に変えるべきこと
今週をランキングを追いかけることに費やすのはやめよう。ランキングを些細な事柄にするレイヤーを築くことに費やそう。
具体的な3つの行動だ。第一に、退屈なやり方でエージェントを選ぶ。バックログにある実際のタスクで2つを走らせ、自分のコードでより良く読めるほうを残す。見直す前提でいればいい。第二に、レビューのスループットを正直に測る。エージェントがあなたが受け入れられるより速く仕上げているなら、次のエージェントのアップグレードは役に立たず、より良いレビューフローなら役に立つ。第三に、1つのエージェントをプロセスにハードコードするのをやめる。エージェントを交換可能なものとして扱うレイヤー経由で作業を流す。そうすれば次のモデルリリースは、恐れる再構築ではなく、試せる選択肢になる。各エージェントにどのモデルを向けるかでまだ迷っているなら、モデルをエージェントの役割に合わせるほうが、リーダーボードを更新するより午後の使い方として良い。
1つのエコシステムにコミットするのではなく、複数のコーディングエージェントを使い続けたいなら、それこそ Sharkly が想定して設計された問題だ。Sharkly をダウンロードし、1つの Computer を接続し、同じ実際のタスクを2つのエージェントに割り当ててみよう。最高のエージェントは変わるだろう。それを管理するやり方は変えなくていい。


