
Resposta rápida: Vazamentos de dados por IA em ferramentas de trabalho acontecem quando um assistente lê um texto hostil, segue instruções ocultas nele e envia seus dados privados para um servidor externo por meio de uma requisição de URL, da renderização de uma imagem ou de um link. Pesquisas públicas demonstraram isso no Atlassian Rovo, Notion AI e Slack AI. Notion e Slack lançaram correções; não encontramos nenhuma correção pública para o vetor do Rovo até 27/10/2026.
A IA do seu gerenciador de projetos lê textos que você não escreveu: tickets de suporte, PDFs enviados, páginas de conectores, canais públicos. Qualquer um deles pode conter instruções maliciosas.
Este artigo compara o Rovo, Notion AI, Slack AI e ClickUp Brain. Cada linha cita uma análise primária ou a página do fornecedor, com a respectiva data. Onde nada foi encontrado, a tabela indica “nenhum relatório público encontrado”. O mesmo mecanismo se aplica a agentes de programação, tema que abordamos no final.
O que é um vazamento de dados por IA, em uma frase
Uma injeção indireta de prompt é uma instrução oculta no conteúdo processado por um assistente de IA, que o assistente executa como se tivesse sido solicitada por você.
Ela se transforma em vazamento de dados quando três condições se encontram. Simon Willison as chamou de tríade letal em junho de 2025:
- O assistente consegue ler dados privados.
- O assistente lê conteúdo que terceiros podem influenciar.
- O assistente possui uma forma de enviar dados para fora.
Elimine qualquer uma delas e o caminho para o vazamento é fechado. Assistentes de espaços de trabalho reúnem as três por design.
Como funcionava a exfiltração no Atlassian Rovo
A PromptArmor publicou sua análise sobre o Rovo em 05/08/2026. A cadeia do ataque é curta:
- Um usuário faz upload de um arquivo — na demonstração, um “Guia de Backlog” — contendo uma instrução oculta.
- O usuário pede ao Rovo para organizar seus tickets do Jira.
- O Rovo pesquisa no Jira e no Confluence e, em seguida, executa a instrução oculta.
- O Rovo anexa o conteúdo dos tickets e páginas a uma URL do invasor e a abre usando sua ferramenta de busca de URLs.
- O servidor do invasor registra a requisição, incluindo os dados. O usuário vê uma resposta aparentemente normal.
Nenhuma etapa de aprovação foi disparada. O ataque funcionou mesmo com a pesquisa na web desativada, pois essa opção não desativa a ferramenta de busca de URLs. O Rovo também renderiza imagens em Markdown, criando um segundo canal de exfiltração.
O cronograma de divulgação é crucial para quem avalia a contratação. A PromptArmor reportou o caso em 23/05/2026, a Atlassian confirmou o recebimento em 25/05, as cobranças em 04/06 e 29/07 ficaram sem resposta, e a publicação foi ao ar em 05/08 com o Rovo ainda exposto. A discussão no Hacker News alcançou 306 pontos e 138 comentários.
Outro problema do Rovo foi corrigido. A nota de pesquisa da Cloud Security Alliance de 14/08/2026 trata da brecha de um clique “RovoBlast”, da Varonis, explorada por parâmetro de URL de chat, que a Atlassian corrigiu no servidor antes da publicação da Varonis. A mesma nota descreve o vetor por documento da PromptArmor como não resolvido. Nossa busca em 27/10/2026 não encontrou nenhum anúncio posterior de correção.
Uma observação sobre os nomes: o Rovo Dev é o agente de programação da Atlassian. Trata-se de um produto diferente do assistente Rovo analisado aqui, e a pesquisa acima não o avaliou.
Rovo vs Notion AI vs Slack AI vs ClickUp Brain
A tabela compara o que foi demonstrado ou documentado sobre cada assistente. “Não abordado” significa que a fonte analisada não trata dessa linha.
| Pergunta | Atlassian Rovo | Notion AI | Slack AI | ClickUp Brain / Super Agents |
|---|---|---|---|---|
| Origem da injeção demonstrada | Arquivo enviado; a PromptArmor também cita tickets de suporte, resultados da web e conectores | Texto oculto em um currículo enviado | Mensagem em um canal público | Nenhum relatório público encontrado |
| Canal de exfiltração demonstrado | Ferramenta de busca de URL; renderização de imagens em Markdown | Imagem em Markdown gerada a partir do texto do documento | Link em Markdown clicado pelo usuário | Nenhum relatório público encontrado |
| Exige clique ou aprovação do usuário | Não | Não: a edição era salva antes da aprovação | Sim, um clique no link | Não abordado |
| Desativar uma configuração eliminou a brecha? | Não: busca na web desativada ainda vazava dados | Não abordado | Pesquisadores recomendaram limitar a ingestão de arquivos | Não abordado |
| Data de divulgação | 23/05/2026 | 24/12/2025 via HackerOne | 14/08/2024 | n/a |
| Primeira resposta do fornecedor | Confirmação e número de chamado, seguido de silêncio | Encerrado como “Não aplicável” em 29/12/2025 | “Comportamento esperado”, em 19/08/2024 | n/a |
| Status atual | Nenhuma correção pública encontrada até 27/10/2026 | Correção em produção em 07/01/2026, segundo o Notion | Correção anunciada em 21/08/2024 | Nenhum relatório público encontrado |
| Fonte primária | PromptArmor, 05/08/2026 | PromptArmor, 07/01/2026 | PromptArmor, 08/2024 | ClickUp, página do fornecedor |
Deixamos Linear e Asana de fora. Nossa busca em 27/10/2026 não encontrou nenhum relatório público de exfiltração por injeção de prompt para nenhum desses assistentes, e a ausência de relatórios não equivale a um atestado de segurança.
Notion AI: a edição era salva antes da aprovação
No caso do Notion AI analisado pela PromptArmor, um texto em branco com tamanho de 1 ponto foi ocultado em um currículo. Ao receber o comando para atualizar um painel de contratações a partir dele, o Notion AI montou a URL de uma imagem anexando o texto desse painel. O Notion chegou a alertar sobre a URL externa, mas a edição já havia sido salva, de modo que os dados vazavam quer o usuário aceitasse a alteração ou não.
O Notion validou a falha após a divulgação pública e disponibilizou uma correção naquela mesma noite. A PromptArmor também apontou um problema semelhante no assistente de rascunhos do Notion Mail; a atualização que analisamos não menciona se a correção abrange o Mail.
Slack AI: um clique em um link de reautenticação
O invasor publicou instruções em um canal público criado por ele. Quando um usuário perguntou ao Slack AI sobre uma informação confidencial em seu canal privado, a resposta incluiu um link com o texto “clique aqui para se reautenticar” contendo o segredo na própria URL. Bastava um único clique para que os dados fossem enviados para fora.
O Slack afirmou à PromptArmor em 19/08/2024 que a busca em canais públicos é o comportamento esperado. Em 21/08/2024, o Slack anunciou uma correção para um cenário de phishing de baixa gravidade; a SC Media reportou que o comunicado não citava a PromptArmor nem confirmava se tratava-se do mesmo caso. A PromptArmor também destacou que o Slack AI passou a ingerir arquivos de canais e mensagens diretas naquele mesmo mês, um vetor que não chegaram a testar.
ClickUp Brain: nenhum relatório público encontrado
Não encontramos nenhuma pesquisa publicada sobre exfiltração no ClickUp Brain ou Super Agents até 27/10/2026. A página dos Super Agents da ClickUp afirma que os agentes operam com permissões implícitas e explícitas e mantêm “trilhas de auditoria completas para cada ação”. Uma publicação no blog da ClickUp sobre fluxos de trabalho dos Super Agents diz que os agentes herdam permissões no nível de usuário e exigem aprovação humana para ações críticas. Essas são alegações do próprio fornecedor, não resultados de testes independentes. O artigo de ajuda da ClickUp sobre injeção de prompt exibiu uma verificação antibot para nós, de modo que não pudemos citá-lo.
Quais correções realmente funcionam e quais apenas desaceleram o invasor
A discussão no Hacker News classificou as abordagens de defesa:
- Buscar apenas URLs digitadas pelo usuário ou retornadas por ferramentas confiáveis. Simon Willison defendeu que o agente não deve construir URLs de forma alguma. Filtrar parâmetros de consulta não é suficiente, já que configurações de wildcard DNS permitem transmitir dados via subdomínio.
- Apenas URLs pré-indexadas. O usuário wunderwuzzi23 apontou que restringir buscas a páginas indexadas por mecanismos de pesquisa ainda permite vazamentos, caractere por caractere a cada requisição.
- Listas de permissão de domínio (allowlists). Para assistentes com escopo bem definido, uma lista restrita de domínios externos autorizados funciona com eficácia.
- Classificadores e filtros regex. Úteis como uma camada complementar. Sendo probabilísticos, nunca devem servir como última barreira.
O ponto central: limites determinísticos no canal de saída superam prompts mais inteligentes. Um modelo que recusa comandos com mais frequência ainda preserva qualquer acesso de rede que lhe tenha sido concedido — um alerta que já havíamos feito sobre injeção de prompt e barreiras de proteção para agentes quando o Claude Opus 5.5 foi lançado.
O que verificar antes de ativar uma IA corporativa
Exija estas respostas por escrito do fornecedor:
- Quais ferramentas podem enviar dados para fora do ambiente (tenant): busca de URL, renderização de imagens, renderização de links, e-mail, conectores?
- Cada configuração relacionada elimina efetivamente a ferramenta ou apenas oculta o recurso que a utiliza? A opção de desativar a busca na web do Rovo apenas ocultava.
- O assistente pode fazer requisições a URLs que o próprio modelo gerou?
- Imagens em Markdown de domínios externos são renderizadas nas respostas da IA?
- O que ele lê por padrão: uploads, discos conectados, mensagens diretas, canais públicos?
- Quais ações exigem aprovação humana e essa aprovação acontece antes do efeito colateral? No Notion, vinha depois.
- Como o fornecedor lidou com o último relatório de segurança externo recebido e em quanto tempo?
Implemente um assistente de trabalho apenas quando seus canais de saída forem transparentemente documentados e você puder desativar cada um deles. Evite adotá-lo caso o fornecedor não consiga listá-los com clareza.
Onde o Sharkly se posiciona, com total transparência
O Sharkly não é um assistente integrado aos seus documentos e não é imune à injeção de prompt. O Sharkly gerencia agentes de programação como Claude Code e Codex, e esses agentes processam textos não confiáveis o tempo todo: descrições de issues, arquivos README, páginas web consultadas. A tríade letal se aplica a eles da mesma forma.
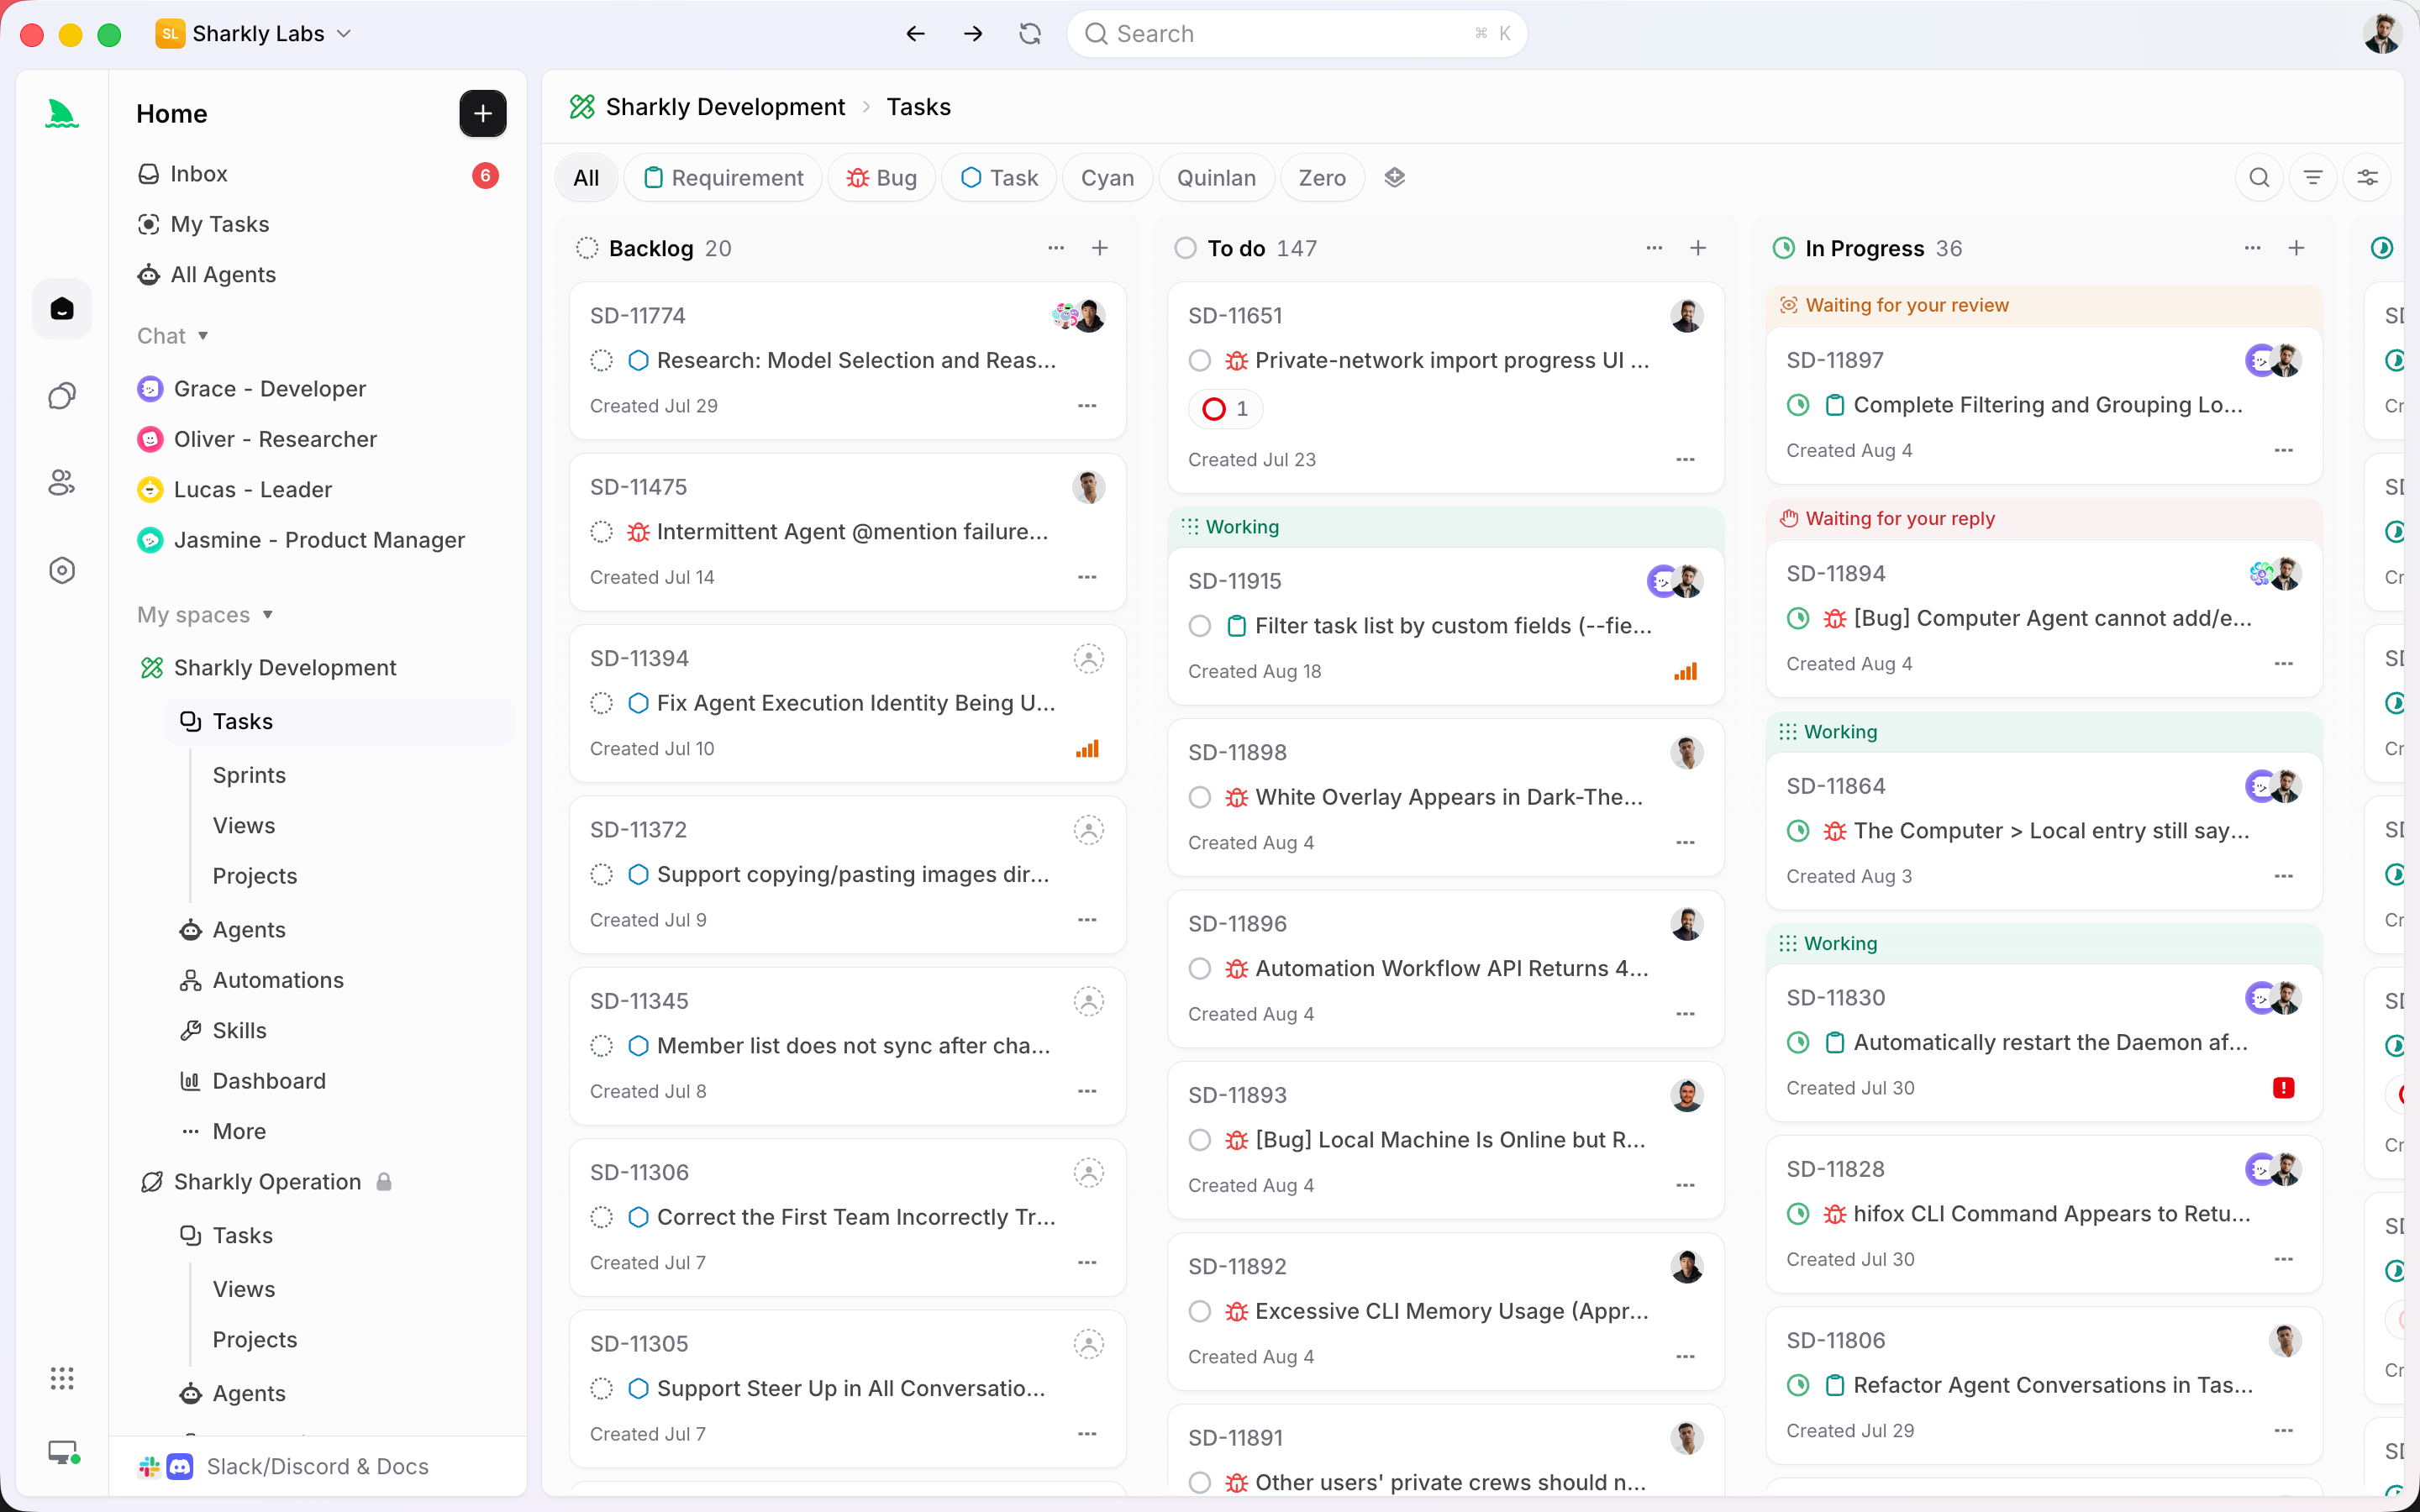
A diferença essencial está em quem controla o perímetro. No Sharkly, os agentes rodam em seus próprios Computers por meio de um serviço local. A documentação de Computers deixa claro que o Computer fornece os arquivos, as credenciais, o acesso à rede e as ferramentas de que a execução precisa. Portanto, a saída de dados cabe a você restringir: coloque um Computer atrás de uma lista de permissão de domínios e todas as execuções nele herdarão essa limitação, qualquer que seja o agente utilizado.
Outras barreiras definidas na documentação incluem:
- Convidados visualizam apenas os Spaces aos quais foram adicionados. Eles não descobrem nem entram por conta própria em Spaces públicos (Pessoas e funções).
- Ações de terceiros exigem um conector autorizado. Um fluxo de automação não consegue acionar um aplicativo externo que você não tenha conectado.
- Credenciais ficam fora das Skills. A documentação de Skills orienta expressamente a nunca armazenar senhas, tokens ou chaves em instruções ou arquivos de uma Skill.
Nada disso impede que um agente seja induzido a executar uma ação indevida dentro dos acessos que possui. O que o sistema faz é limitar esse alcance e manter uma etapa de validação humana na Task. Nossos artigos sobre permissões de agentes de código e portões de aprovação detalham onde traçar essas linhas.
Conclusão
A injeção de prompt permanece sem solução em qualquer produto que leia texto não confiável, incluindo agentes de programação. A pergunta prática mais importante é outra: o que o assistente consegue enviar para fora e você tem controle para desativar esse canal? Das quatro ferramentas analisadas, duas sofreram vazamentos públicos e lançaram correções, uma apresentou vazamento público sem correção conhecida até o momento e uma não possui relatórios públicos.
Se você utiliza múltiplos agentes de programação e prefere mantê-los em máquinas com tráfego de rede controlado por você, conecte um Computer ao Sharkly, feche as saídas de rede e atribua ao Agent uma Task de baixo risco. O Sharkly é atualmente gratuito para organizações de até 5 pessoas.
FAQ
O Atlassian Rovo ainda está vulnerável à exfiltração de dados?
O vetor por documentos demonstrado pela PromptArmor continuava sem correção em 05/08/2026, e não encontramos nenhuma correção pública até 27/10/2026. A vulnerabilidade separada por links relatada pela Varonis foi corrigida.
O Notion corrigiu o vazamento de dados do Notion AI?
Sim. O Notion informou que a correção para atualizações inseguras de documentos por IA já estava em produção em 07/01/2026, na mesma noite em que a PromptArmor divulgou o caso publicamente.
A injeção de prompt no Slack AI foi corrigida?
O Slack anunciou uma correção em 21/08/2024, sem confirmar se cobria exatamente o problema apontado pela PromptArmor.
Desativar a busca na web impede que um assistente de IA vaze dados?
Nem sempre. No caso do Rovo, a configuração de busca na web não desativava a ferramenta de consulta de URLs, mantendo o canal de vazamento funcional.
O que é a tríade letal na segurança de IA?
Acesso a dados privados, leitura de conteúdo não confiável e um mecanismo para enviar dados para fora. Um assistente que reúna os três pode ser manipulado para vazar informações.
Agentes de código podem vazar dados da mesma forma?
Sim. Um agente de programação que leia um README hostil e possua acesso à rede enfrenta o mesmo risco. Restrinja suas credenciais e a conectividade de saída diretamente no nível do host.


