
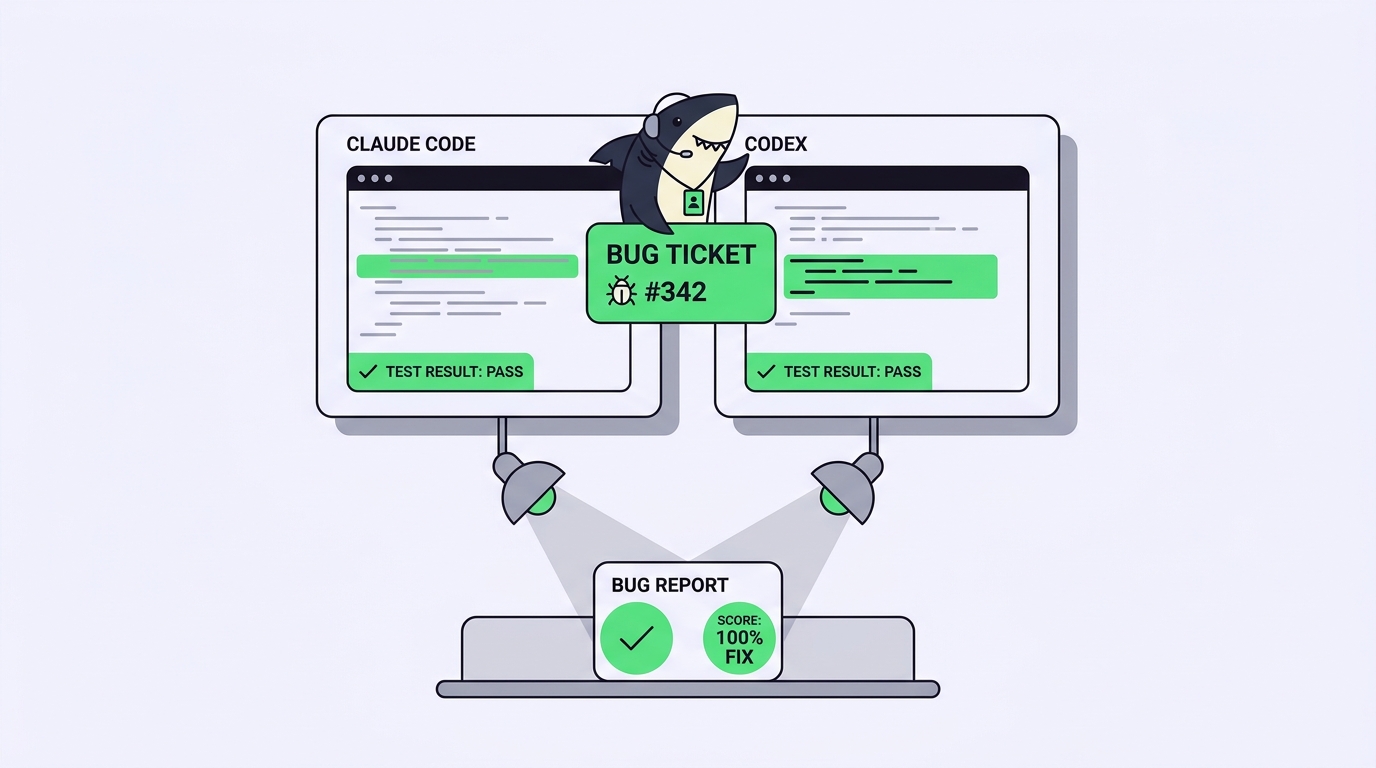
Você tem um bug real em aberto e dois agentes capazes de corrigi-lo: Claude Code e Codex. As abas estão cheias de opiniões sobre qual dos dois é mais inteligente, e nenhuma delas diz qual apontar para este bug, neste repositório, hoje. Os números de benchmarks públicos também não. Um ranking mede um conjunto fixo de problemas de código aberto com um harness ajustado. Seu bug é um problema privado: suas convenções, seu teste flaky, o módulo que só uma pessoa entende.
A forma honesta de responder “Claude Code ou Codex” é rodar os dois no mesmo bug, nas mesmas condições, e ler o que cada um devolve. Parece simples, mas vira uma bagunça rapidinho: dois agentes editando os mesmos arquivos, dois terminais, dois conjuntos de saída de testes e nenhuma forma limpa de compará-los lado a lado. A comparação que você quer é entre os agentes. O trabalho que está na sua frente é impedir que eles colidam.
É essa colisão que o Sharkly elimina. O Sharkly é uma plataforma tudo-em-um de comando e gerenciamento de Agentes: você atribui a mesma Task a dois Agentes diferentes, cada um roda em um Computer conectado, em seu próprio worktree isolado, e cada execução devolve seu diff, seus resultados de teste e sua revisão em um único lugar. O Sharkly não substitui o Claude Code nem o Codex, e não é um harness de benchmark. É a camada que torna possível uma comparação direta justa sem abrir um segundo terminal. Este guia percorre o método, uma rubrica de pontuação para um único bug e onde cada agente costuma se sair melhor.
A resposta rápida
Para comparar Claude Code e Codex de forma honesta, dê aos dois o mesmo bug, o mesmo commit inicial e o mesmo teste de aceitação, cada um rodando em sua melhor configuração. Depois pontue o que voltou: a correção passa, o diff se mantém dentro do escopo e quanto tempo a mudança leva para você revisar. O agente que vence um bug venceu um bug. Aplique o método a vários antes de confiar no veredito.
Por que “qual é melhor” é a pergunta errada
Claude Code e Codex são dois agentes de código que priorizam o terminal. Eles leem seu repositório, editam arquivos, executam comandos e reportam de volta. Diferem na forma como você os configura e em como se comportam sob pressão, mas nenhum dos dois é universalmente superior no trabalho que preenche um sprint normal.
Um ranking global único esconde justamente a parte que te interessa. “Qual é melhor” reduz tudo a um número que não sobrevive ao contato com a sua base de código. “Qual é melhor neste tipo de bug, no meu repositório, na hora da revisão” é respondível, e é a única versão que vale o esforço. Se você ainda está decidindo qual modelo cada agente deve rodar, combinar modelos com papéis de agente é uma primeira pergunta melhor do que qualquer leaderboard.
Rode os dois no mesmo bug: um método em que você pode confiar
Uma comparação justa mantém tudo constante, exceto o agente. Quatro regras garantem isso.
- Escolha um bug real, não um prompt de brinquedo. Escolha um defeito contido do seu backlog, com um teste de aceitação que você consiga rodar e um diff que você leia em poucos minutos. Descreva-o como seu rastreador de tarefas faria: uma tarefa como
SH-312: fix the timezone drift in the invoice export. “Criar um app de tarefas” não diz nada sobre o seu código. - Dê aos dois a mesma entrada. Mesma descrição de tarefa, mesmo commit inicial, mesmos critérios de aceitação. Se o Claude Code recebe um prompt mais rico que o Codex, você está medindo seu prompt, não o agente.
- Rode cada um no seu melhor. Dê ao Claude Code o seu
CLAUDE.md, ao Codex o seuAGENTS.mde a configuração, e dê a cada um as permissões e o modelo que a própria documentação de cada um recomenda. Comparar um agente bem configurado com um agente cru mede qual deles você se deu ao trabalho de configurar. - Isole as duas execuções. Cada agente precisa da própria cópia de trabalho. Dois agentes em um mesmo checkout vão sobrescrever um ao outro, e você vai passar a tarde desembaraçando um merge em vez de ler duas tentativas limpas. É para isso que servem os worktrees isolados.
Rode as duas tentativas e depois descarte o branch perdedor. Você fica com a correção em que confia e com as evidências do porquê.
Uma rubrica de pontuação para a correção de um único bug
“Passou?” é um único bit de informação. Uma correção de verdade se decide por muito mais do que isso, e escrever a rubrica antes de olhar mantém a comparação honesta.
| O que você pontua | A pergunta que responde | Por que importa |
|---|---|---|
| Correção | O teste de aceitação passa e nada mais quebra? | O piso. Um agente que imprime “pronto” não passou em nada. |
| Disciplina de escopo | O diff mexeu só no que o bug exigia? | Uma correção que reescreve quatro arquivos sem relação custa mais em revisão do que economiza. |
| Qualidade dos testes | O agente adicionou ou atualizou um teste que pegaria a regressão? | Uma correção sem teste é uma correção que você vai fazer de novo. |
| Tempo de revisão | Quanto tempo levou até você confiar na mudança? | Muitas vezes o gargalo real, e fácil de ignorar até virar a sua tarde. |
| Honestidade | O agente sinalizou os próprios limites e suposições? | A execução em que você pode confiar é a que te diz o que não verificou. |
Pontue as duas tentativas nos mesmos cinco critérios, no mesmo bug, e o vencedor deixa de ser questão de gosto. O tempo de revisão merece peso extra: dois agentes podem terminar em vinte minutos e ainda assim custar uma hora cada um para conferir. Essa hora costuma ser o limite real de quanto trabalho de agente uma equipe consegue absorver.
Onde cada um costuma se sair melhor
Nada de números inventados aqui, só o que observar. O Claude Code se apoia na memória de projeto do seu CLAUDE.md e tende a respeitar as convenções do repositório em mudanças que envolvem vários arquivos, o que aparece em refatorações que abrangem vários módulos. O Codex se sente à vontade em um ambiente sandbox orientado a configuração e costuma estruturar bem o código novo e seus testes, o que aparece em correções contidas. Os dois se dispersam mais conforme o repositório cresce, e os dois vão te entregar com confiança uma mudança que não passa. Rode o seu próprio bug antes de tratar qualquer uma dessas impressões como definitiva.
Aqui vai a parte honesta que a maioria das comparações pula. Se você usa só um agente e vive em um único terminal, não precisa de uma plataforma para fazer isso. Uma sessão bem ajustada do Claude Code em um worktree, ou uma execução do Codex, já basta, e você mesmo pode bater o olho no diff. A equação muda no momento em que você está comparando dois agentes, em mais de um bug, e quer os resultados em um formato que outra pessoa consiga ler.
Fazendo a comparação direta no Sharkly
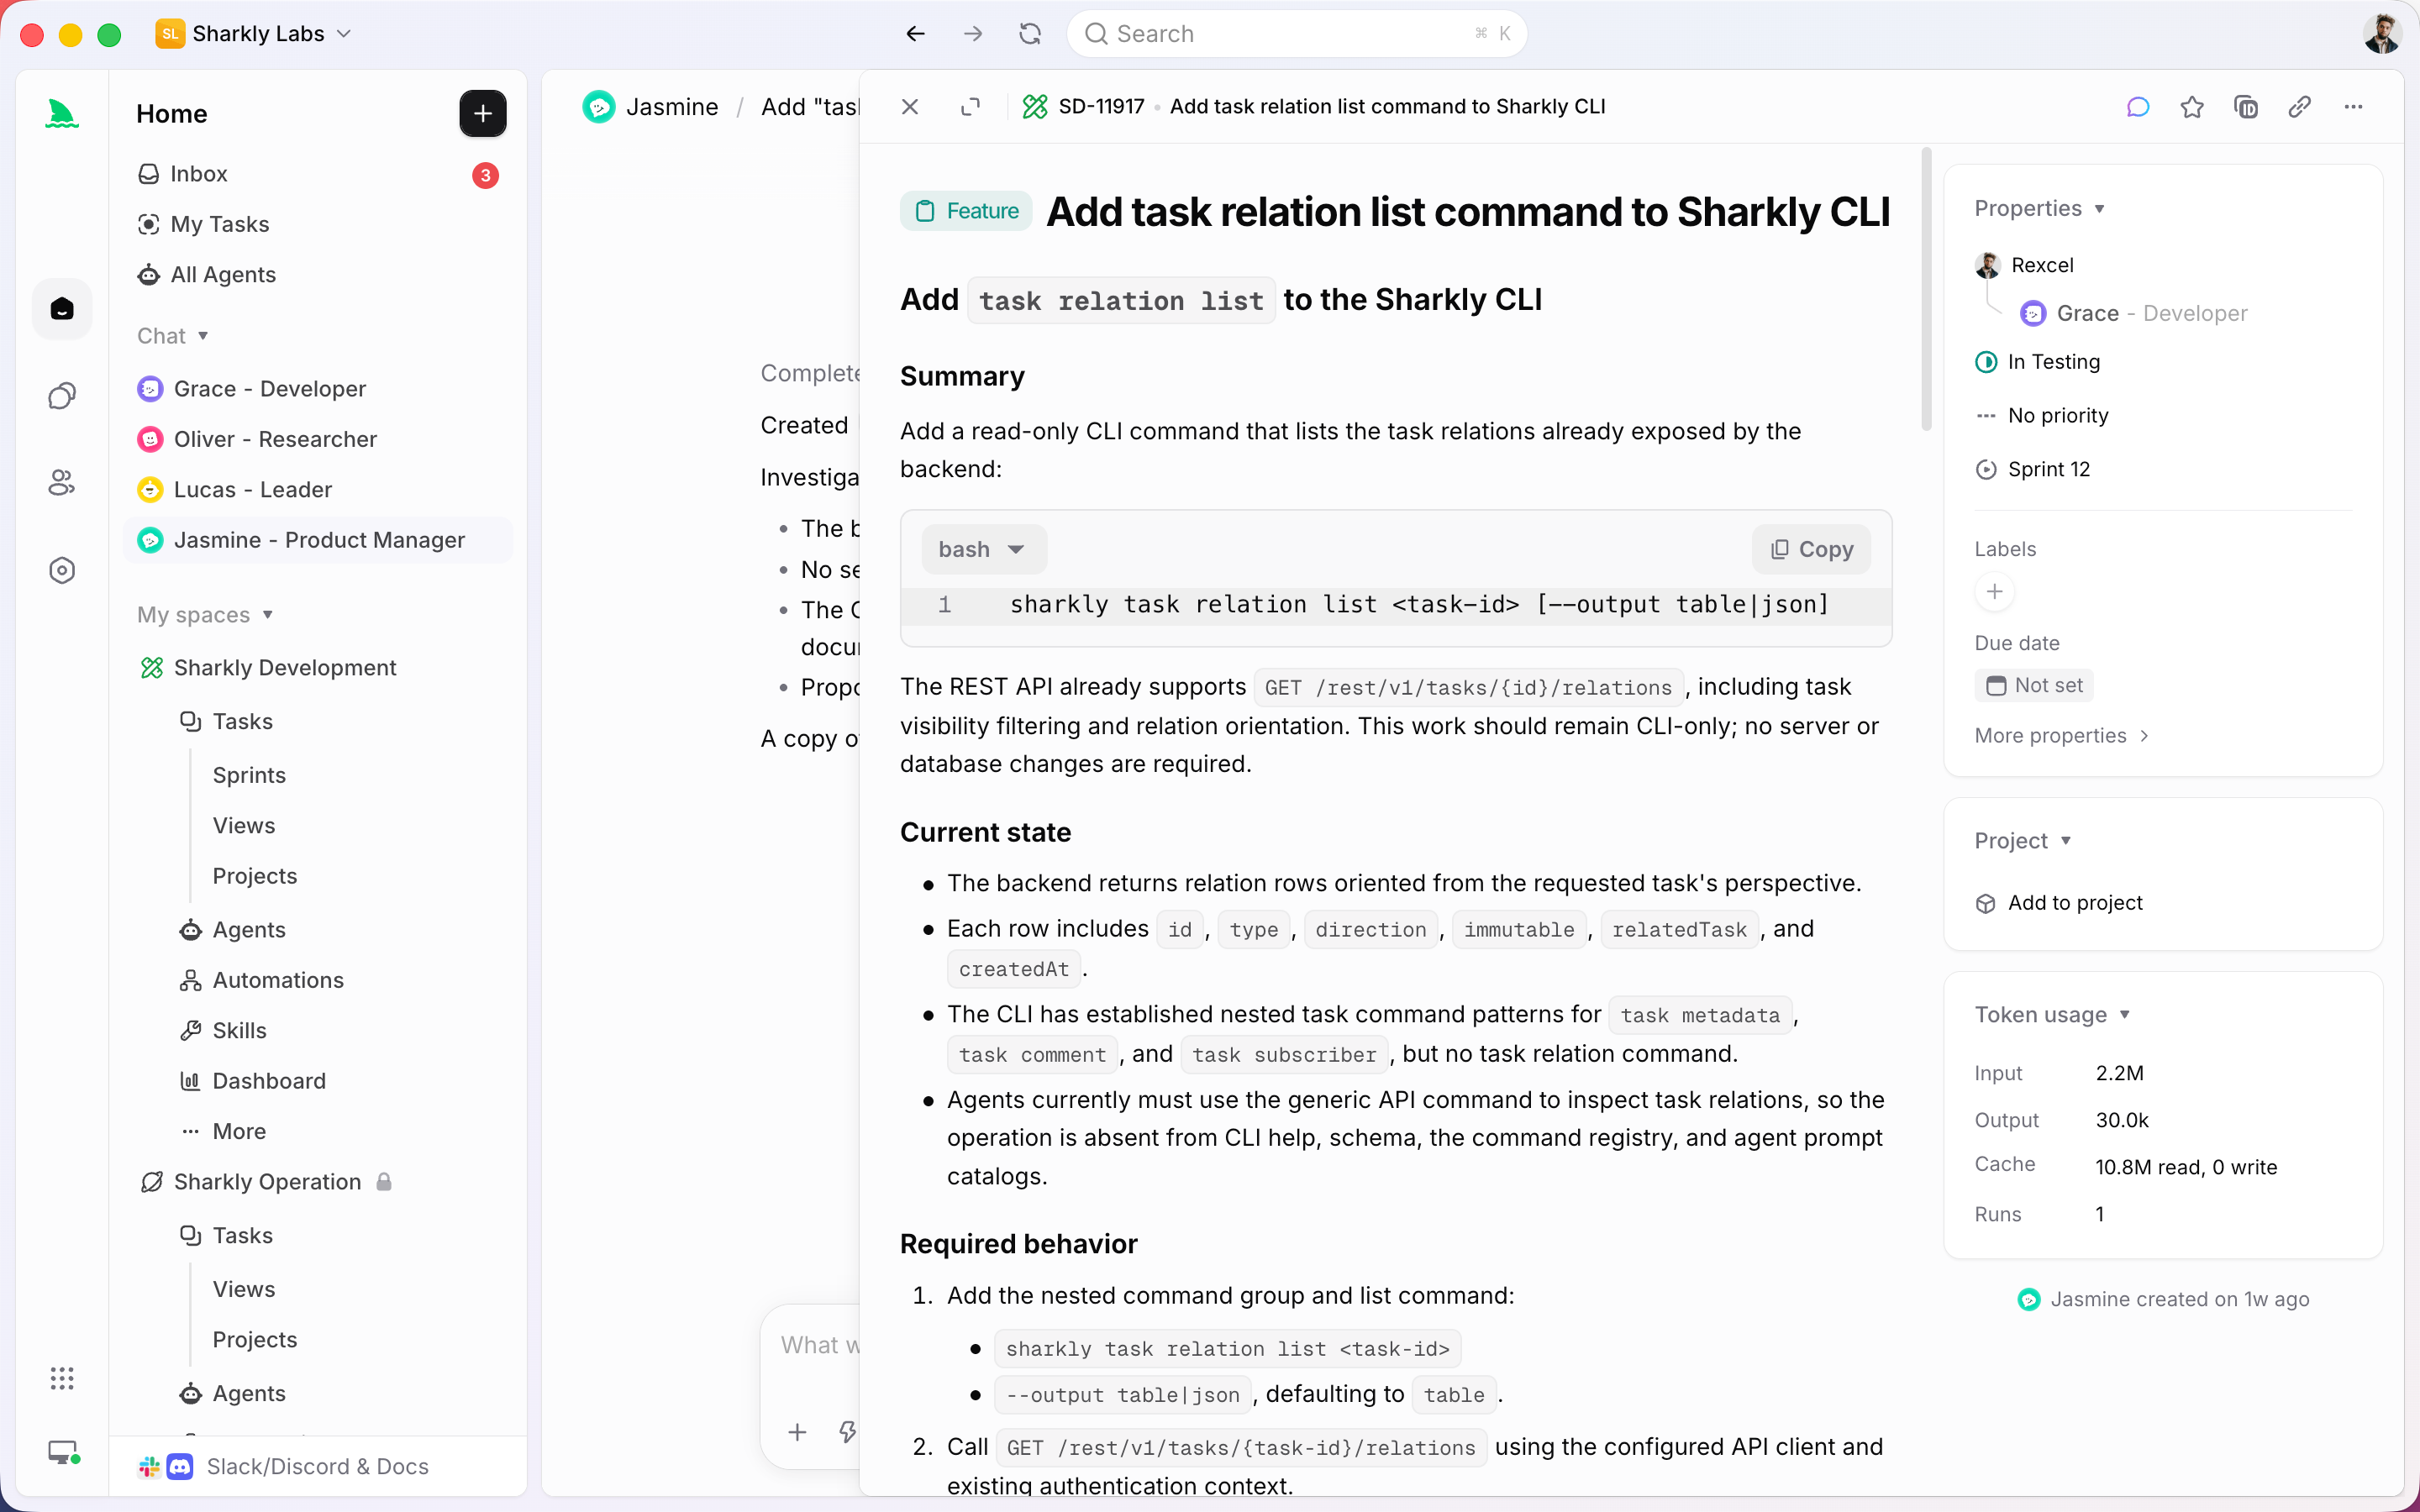
É aqui que o Sharkly justifica seu lugar. Você cria uma Task para o bug e a atribui tanto a um Agente Claude Code quanto a um Agente Codex. Cada Agente roda em um Computer conectado, em seu próprio worktree, então as duas tentativas nunca tocam os mesmos arquivos. Execução, bloqueios, resultados e o resumo da mudança voltam para a linha do tempo da Task, e você lê os dois diffs e as duas execuções de teste um contra o outro em uma única visão, em vez de tentar lembrar qual terminal tinha o quê.
A divisão do trabalho continua clara. Os Agentes pesquisam, executam, testam e reportam. As pessoas definem a direção e aceitam o resultado. A automação para onde o seu julgamento é necessário, e o Sharkly mantém contexto, progresso, bloqueios, resultados e revisão humana visíveis da solicitação à entrega. Você não está entregando a decisão a uma ferramenta; está recebendo as duas tentativas organizadas de um jeito que leva minutos. Quando você quiser manter os dois agentes no trabalho do dia a dia, em vez de num teste pontual, rodar Claude Code e Codex juntos em uma mesma base de código é o mesmo fluxo de trabalho, agora rotineiro.
Qual escolher, por tamanho de equipe
A escolha certa depende de quem está escolhendo e do que a comparação precisa sobreviver.
| Tamanho da equipe | Dê mais peso a | O que escolher |
|---|---|---|
| Desenvolvedor solo | Tempo de revisão e execução na própria máquina | O agente que você revisa mais rápido; você é o único leitor |
| Equipe pequena | Execuções paralelas e visibilidade compartilhada | Os dois, atribuídos por meio de uma única Task, para que todos vejam as mesmas evidências |
| Equipe de plataforma | Integrações e neutralidade entre fornecedores | Mantenha os dois; o fluxo de trabalho precisa sobreviver a qualquer que seja o agente líder no próximo trimestre |
Essa última linha é o verdadeiro motivo para fazer a comparação em vez de escolher um favorito e defendê-lo. O melhor agente deste trimestre pode não ser o melhor do próximo, e refazer seu processo toda vez que a liderança muda é um custo à parte. Comparar nos seus próprios bugs, em um fluxo de trabalho que roda qualquer agente, te deixa livre para trocar quando a resposta mudar.
Se você quer continuar usando vários agentes de código em vez de se comprometer com um único ecossistema, esse é o problema em torno do qual o Sharkly foi projetado. Baixe o Sharkly, conecte um Computer e atribua o mesmo bug real aos dois agentes. O veredito que você recebe é sobre a sua base de código, que é a única capaz de prever a sua semana.
FAQ
O Claude Code ou o Codex é melhor para corrigir bugs? Nenhum dos dois vence de forma geral. No mesmo bug, em sua melhor configuração, um costuma levar ligeira vantagem sobre o outro, e qual deles leva varia conforme o tipo de bug e o tamanho do repositório. Rode os dois em um defeito real do seu backlog e pontue correção, escopo, testes e tempo de revisão.
Posso rodar Claude Code e Codex no mesmo bug ao mesmo tempo? Sim, se cada um tiver a própria cópia de trabalho. Dois agentes em um mesmo checkout sobrescrevem um ao outro. Dê a cada um um worktree isolado, ou atribua a Task aos dois no Sharkly e deixe cada Agente rodar em seu próprio Computer.
As pontuações de benchmark me dizem qual agente usar? Elas dizem quais agentes vale a pena testar, não como um deles se comporta no seu repositório. Um conjunto de dados público nunca vai conter suas bibliotecas internas, sua configuração de lint ou seu módulo sem testes. Trate o leaderboard como um filtro e depois faça a comparação que realmente importa no seu próprio código.
O Sharkly substitui o Claude Code ou o Codex? Não. O Sharkly é a camada de atribuição, contexto e revisão em torno dos agentes de código que sua equipe já roda. Os agentes fazem a execução; o Sharkly gerencia a Task, mantém as execuções visíveis e deixa a aceitação para as pessoas.
Quantos bugs devo comparar antes de decidir? Um bug te fala sobre um bug. Aplique o método a alguns tipos de defeito antes de confiar em um padrão, e mantenha a rubrica idêntica a cada vez para que os resultados se acumulem de forma comparável.


