
TL;DR: Uma equipe do MIT CSAIL fez um modelo de fronteira ler e editar os pesos do Qwen3.5-0.8B dentro de um sandbox Python, com um orçamento rígido de passagens diretas e um log completo de cada etapa. Os autores relatam que o MATH-500 subiu de 7,9% para 48,1%. Você pode deixar um agente de código editar os pesos de um modelo da mesma forma: cinco tarefas em um quadro, o orçamento definido em cada tarefa, um segundo agente na avaliação e uma pessoa aprovando o arquivo editado.
Em 2 de novembro de 2026, Rikiya Takehi, Jayden Teoh, Alex Zhang e Omar Khattab publicaram Sparks of Weight-Space Programming. O modelo do estudo, o GPT-6 Astra, abriu tensores de peso, escreveu código numpy e PyTorch sobre eles, formulou uma hipótese e alterou 131.072 números em um modelo de 0,8 bilhão de parâmetros.
Leia a configuração e ela parece familiar: um sandbox, um orçamento de ferramentas, um log de cada prompt e de cada célula executada. Isso é um agente de código com um harness — e o harness é justamente a parte que sua equipe pode copiar hoje mesmo.
O que a equipe do MIT fez, em números
Programação em espaço de pesos significa que um LLM lê os parâmetros de uma rede como dados e os edita diretamente, sem descida de gradiente e sem treinamento. O artigo do MIT relata isso em modelos pequenos, sob limites rígidos de ferramentas, com cada turno registrado em log.
O resultado principal é a edição do Qwen3.5-0.8B:
| Métrica (números dos autores) | Modelo base | Modelo editado |
|---|---|---|
| MATH-500 | 7,9% | 48,1% |
| GSM8K | 13,8% | 67,1% |
| IFEval | 21,0% | 62,3% |
| Execuções que atingiram o limite de 32.768 tokens | 93,0% | 33,1% |
Astra rastreou o hábito do modelo de entrar em loop até esgotar os tokens até uma direção gravada pelas MLPs das camadas 15 e 19 e, em seguida, subtraiu essa direção de 64 colunas de saída em cada uma delas: 131.072 pesos, ou 0,016% do modelo. O checkpoint publicado é Apache-2.0, e seu model card afirma que apenas dois tensores diferem do modelo base: as matrizes down_proj.weight dessas duas camadas.
Por que o harness decide o resultado
Dois achados do artigo importam mais para uma equipe do que o resultado principal.
O orçamento mudou o desfecho. Cada passagem direta usou, em média, um lote de 64 sequências. Com 10 passagens, o MATH-500 chegou a 12,3%. Com 25, chegou a 14,1%. Com 50, chegou a 48,1%. Mesmo modelo, mesma tarefa, teto diferente para quantas vezes o agente podia testar uma ideia.
As ferramentas mudaram o desfecho. Recebendo apenas os pesos de duas variantes do Gemma 3 270M, Astra não conseguiu dizer qual delas era bajuladora (sycophantic) em nenhuma das quatro tentativas. Com uma ferramenta que retornava os pesos de atenção de até 16 textos escritos por ele mesmo, identificou a bajuladora nos três pares.
Duas alavancas, então: o que o agente pode gastar e o que pode examinar. Ambas precisam estar definidas por escrito antes de a execução começar.
Os limites são igualmente claros. Astra não conseguiu melhorar o Gemma 3 270M no MATH-500: partindo de uma base de 6,8%, sua melhor edição chegou a 7,7%. Os autores interpretam isso como uma edição que remove um obstáculo, e não que acrescenta uma habilidade que o modelo não tinha. Eles classificam os achados como preliminares, e vários deles vêm de execuções únicas. Planeje seu próprio experimento como um teste, não como uma correção.
Como deixar um agente de código editar pesos de modelo com segurança
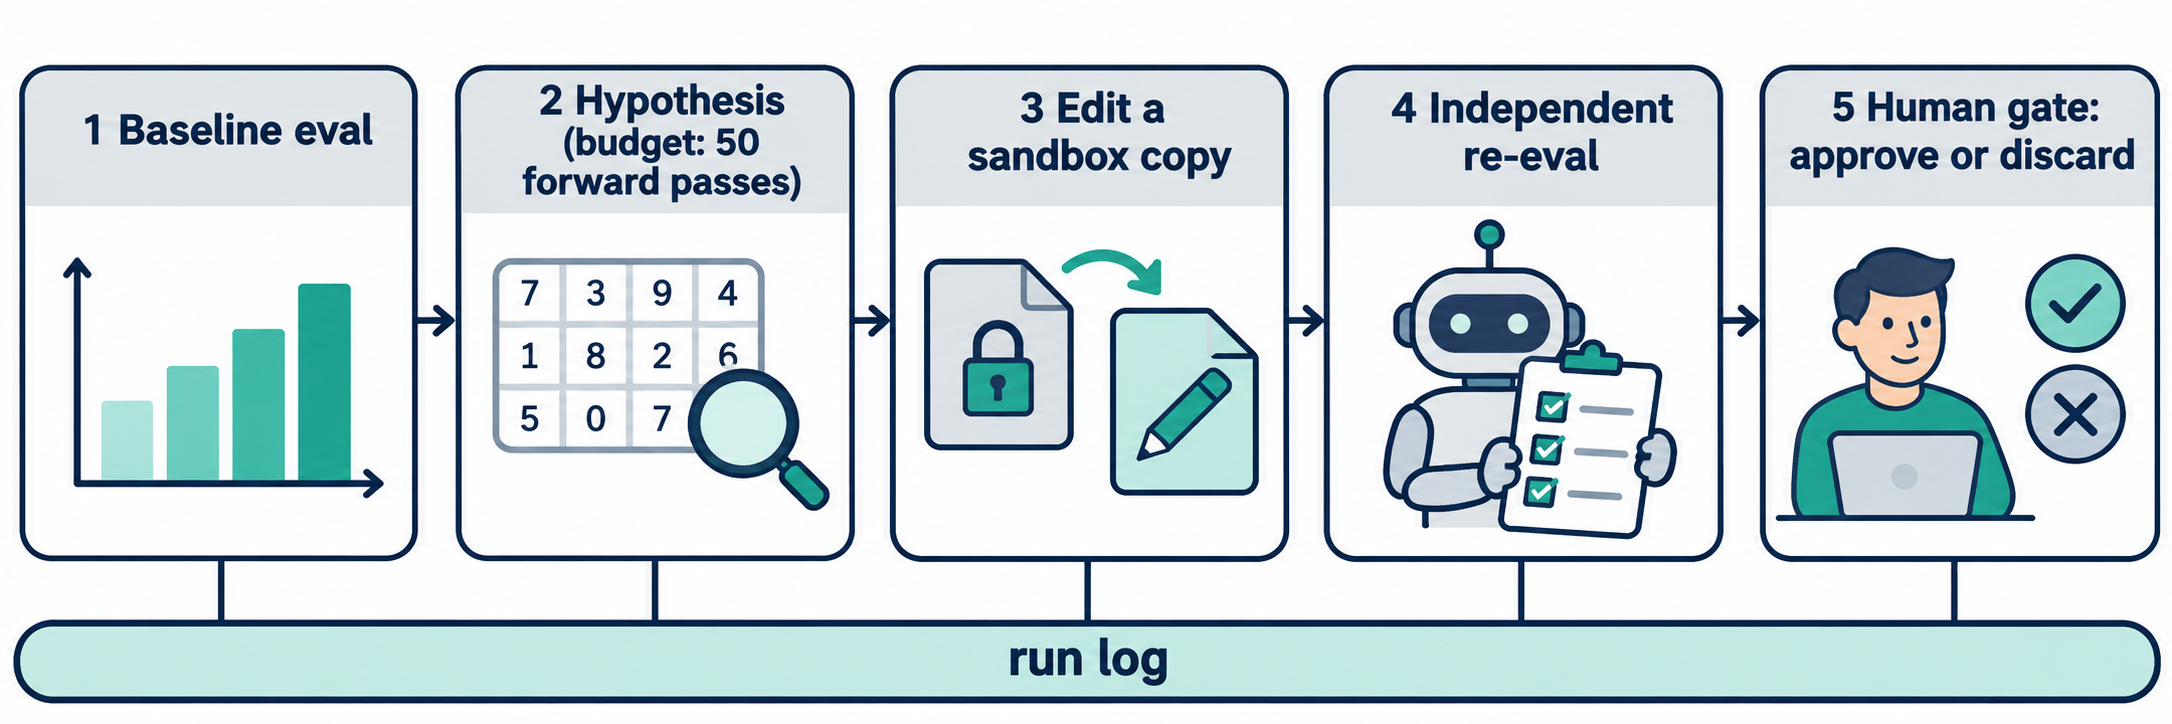
Um experimento seguro em espaço de pesos tem cinco características:
- Os pesos originais são somente leitura para todos os agentes.
- O orçamento de passagens diretas é um número na tarefa, imposto pelo sandbox.
- O conjunto de avaliação que o editor enxerga é separado do conjunto de regressão que o revisor executa.
- O log de cada execução permanece vinculado à etapa a que pertence.
- Uma pessoa aprova o arquivo editado antes que qualquer coisa o carregue fora do sandbox.
O Sharkly não conta passagens diretas nem inspeciona tensores. Quem faz isso é o seu script de sandbox, e o seu runtime (Claude Code, Codex ou outro agente que você já usa) faz a leitura e a edição. O Sharkly organiza o trabalho: quem é responsável por cada etapa, quanto ela pode gastar, o que retornou e quem aprovou. O próprio repositório de logs da equipe do MIT mantém uma pasta harness/ com uma configuração do Codex e um script de sandbox, uma referência útil para o lado do sandbox.
Etapa 1: avaliação de linha de base do modelo intocado
A primeira tarefa executa sua avaliação no checkpoint original e registra as pontuações e onde o modelo falha. No Qwen3.5-0.8B, 93,0% das execuções atingiram o limite de tokens. A tarefa de hipótese precisa dessa descrição de falhas.
Etapa 2: ler os pesos e escrever uma hipótese
Esta é a tarefa que tem o orçamento. Coloque o número no corpo, em um formato que o agente não possa interpretar errado:
## Stage 2: Hypothesis from weights

Model: ./models/qwen3.5-0.8b-base (READ-ONLY, mounted ro)
Budget: 50 forward passes, batch 64. The sandbox stops at 50.
Tools: numpy, torch (CPU), forward() wrapper. No attention tool.
Inputs: Stage 1 failure notes (task COIN-xxx), GSM8K/MATH practice split only.
Output: one-page hypothesis naming layers, tensors and the direction to change,
plus the passes used. Do not write any weights in this stage.
O orçamento na tarefa é uma promessa; o orçamento no wrapper do sandbox é a garantia. Escreva os dois, e faça o wrapper imprimir as passagens usadas para que o número apareça no log da execução.
Etapa 3: fazer a edição em uma cópia dentro do sandbox
O agente editor altera uma cópia do checkpoint e relata o diff. Ele nunca recebe acesso de escrita ao original. No Sharkly, cada execução de tarefa recebe seu próprio diretório isolado, e o trabalho em repositório pode usar um worktree separado por execução, de modo que a etapa 3 não consiga tocar no que a etapa 1 mediu.
Etapa 4: reavaliação independente por um agente revisor
Atribua esta etapa a um agente diferente daquele que fez a edição. Ele roda novamente a avaliação da etapa 1 e acrescenta um conjunto de regressão que o editor nunca viu. Se você usa um Crew, o líder pode entregar a edição a um membro e a reavaliação a outro. O padrão corresponde a um Crew de modelos mistos com um revisor separado: o agente que escreveu a mudança não é o agente que a avalia.
O editor otimizou com base no que conseguia ver, então um ganho que aparece só nesses problemas prova muito pouco.
Etapa 5: aprovação humana do diff
A última tarefa chega a uma pessoa com três anexos: a lista de tensores alterados, a tabela de antes e depois e os resultados de regressão do revisor. Nada carrega o checkpoint editado fora do sandbox enquanto essa tarefa não avançar.
Este script curto gera o primeiro anexo. Ele compara dois checkpoints safetensors e lista todos os tensores que mudaram:
from safetensors import safe_open
import torch

BASE = "models/qwen3.5-0.8b-base/model.safetensors"
EDIT = "sandbox/qwen3.5-0.8b-edit/model.safetensors"

changed, total = [], 0
with safe_open(BASE, "pt") as a, safe_open(EDIT, "pt") as b:
    assert set(a.keys()) == set(b.keys()), "tensor names differ"
    for name in a.keys():
        x, y = a.get_tensor(name), b.get_tensor(name)
        total += x.numel()
        n = (x != y).sum().item()
        if n:
            changed.append((name, n, (x - y).abs().max().item()))

for name, n, dmax in changed:
    print(f"{name}: {n:,} weights changed, max |delta| {dmax:.4g}")
print(f"{sum(c[1] for c in changed):,} of {total:,} weights changed")
No checkpoint publicado, o model card diz que você deve ver exatamente dois tensores down_proj.weight. Se a sua própria edição tocar tensores que a hipótese nunca mencionou, esse é o motivo para descartá-la.
Executando o quadro no Sharkly
Este é o quadro de um experimento. Cada linha é uma tarefa com seu próprio responsável, status e histórico de execuções.
| Tarefa | Responsável | Orçamento ou aprovação | Concluída quando |
|---|---|---|---|
| 1. Avaliação de linha de base | Agente de avaliação | Apenas o conjunto de avaliação | Pontuações e notas de falhas publicadas |
| 2. Hipótese a partir dos pesos | Agente editor | 50 passagens diretas | Hipótese publicada, passagens usadas registradas em log |
| 3. Edição no sandbox | Agente editor | Apenas cópia, original somente leitura | Diff e arquivo editado no sandbox |
| 4. Reavaliação e regressão | Agente revisor | Conjunto de regressão mantido à parte | Tabela de antes/depois publicada |
| 5. Aprovar ou descartar | Uma pessoa | Aprovação humana | Decisão registrada na tarefa |
Conecte as etapas com relações do tipo blocks para que o quadro mostre a cadeia. As relações entre tarefas do Sharkly são honestas quanto ao escopo: uma relação mostra dependência e progresso no cartão, mas não move uma tarefa nem inicia uma execução por conta própria. Mantenha cada etapa em Backlog até que a anterior termine. Uma tarefa atribuída a um agente não inicia uma execução enquanto estiver em Backlog, então tirá-la de lá é o gatilho.
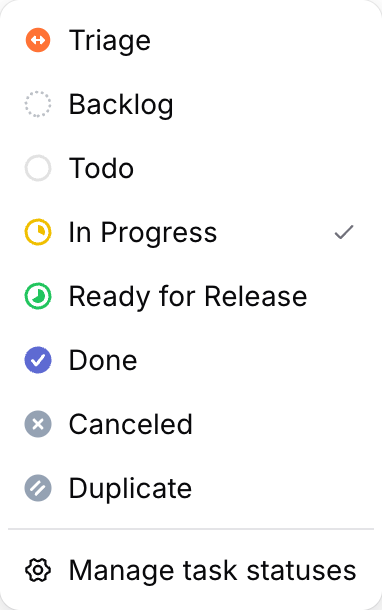
Quando a etapa 4 termina, o agente pode deixar a tarefa aguardando revisão humana, e a pessoa a vê no Inbox. O log de execução registra o início, o fim, as chamadas de ferramenta e o gatilho de cada execução: sua trilha de auditoria, mantida na etapa a que pertence. Para saber mais sobre onde interromper agentes, consulte portões de aprovação para agentes de código.
Limites práticos antes de começar
- Comece pequeno. O estudo usou modelos de 0,8B e 270M com acesso a tensores na CPU. Escolha um modelo que você consiga avaliar em minutos.
- Não espere ganho em habilidades ausentes. O resultado com o Gemma indica que uma edição pode desbloquear um modelo, não ensiná-lo.
- Trate uma execução isolada como anedota. Repita o experimento com um agente novo antes de confiar na edição.
Conclusão
A lição reaproveitável do artigo do MIT é o harness: um orçamento por escrito, ferramentas limitadas, um log completo e resultados que outra pessoa possa conferir. Esses são os controles que você já quer ter em volta de um agente de código que edita código.
Para experimentar, crie as cinco tarefas em um Space do Sharkly, atribua as etapas 1 a 4 a agentes no seu Computer conectado e reserve a etapa 5 para você. O Sharkly é grátis para começar em sharkly.ai.
Perguntas frequentes
Um agente de código pode editar pesos de modelo?
No estudo do MIT CSAIL, sim. O GPT-6 Astra leu tensores do Qwen3.5-0.8B em um sandbox Python e alterou 131.072 pesos. Os autores relatam que o MATH-500 subiu de 7,9% para 48,1%. O trabalho é preliminar, feito em modelos pequenos, e vários resultados vêm de execuções únicas.
O que é programação em espaço de pesos?
É quando um LLM lê os parâmetros de uma rede como dados e os edita diretamente, sem treinamento. Ele analisa os tensores com código, formula uma hipótese, altera os pesos e mede o efeito com um número limitado de passagens diretas.
Por que o orçamento de passagens diretas importa?
Na ablação com o Qwen feita pelos autores, 10 passagens chegaram a 12,3% no MATH-500, 25 chegaram a 14,1% e 50 chegaram a 48,1%. O orçamento define quantas ideias o agente pode testar. Escreva-o na tarefa e imponha-o no sandbox.
A edição de pesos pode adicionar novas habilidades a um modelo?
O estudo sugere que não. A melhor edição do Astra levou o Gemma 3 270M de 6,8% para 7,7% no MATH-500. Os autores concluem que a edição removeu um obstáculo no Qwen, em vez de acrescentar uma habilidade.
Como evitar que pesos editados cheguem à produção?
Monte o original como somente leitura, edite uma cópia, execute uma reavaliação independente e exija que uma pessoa aprove o diff dos tensores antes que qualquer coisa carregue o arquivo fora do sandbox.


