Resumo: Para dar voz ao seu agente de IA, coloque o GPT-Live-1.1 da OpenAI na frente dele como uma interface de voz e mantenha o trabalho real nos agentes que você já executa. O GPT-Live escuta enquanto fala e transfere o raciocínio e as chamadas de ferramentas para um backend por meio de delegação. No modo de delegação ao cliente, seu aplicativo captura cada transferência, inicia uma Sharkly Automation por meio do webhook dela e devolve o resultado em voz.
O que é o GPT-Live-1.1?
O GPT-Live-1.1 é o modelo de voz full-duplex da OpenAI para conversas multilíngues: ele pode escutar enquanto fala, então as pessoas podem interrompê-lo do mesmo jeito que interrompem um colega. Ele roda no endpoint v1/live/sessions, suporta function calling e streaming, e pode delegar o raciocínio e o uso de ferramentas a um agente backend em vez de fazer esse trabalho sozinho.
Segundo a página do modelo GPT-Live-1.1 da OpenAI, ele transcreve fala com mais precisão do que o GPT-Live-1 e mantém um sotaque e uma voz mais consistentes entre idiomas. A entrada e a saída são áudio e texto. Ele não aceita imagens diretamente.
A parte que importa para equipes de agentes é a delegação. O modelo de voz foi feito para conversar, não para executar uma refatoração de 20 minutos. Ele transfere esse trabalho para outra coisa e mantém a conversa rolando enquanto espera.
Se a sua equipe já atribui trabalho a agentes de código em um quadro compartilhado, a Sharkly pode ser essa "outra coisa". O resto deste guia mostra como fazer a ligação.
Por que um agente de voz precisa de uma equipe backend
Uma interface de voz tem um orçamento de latência rígido. As pessoas esperam uma resposta em cerca de um segundo, e um silêncio mais longo que isso parece uma falha. O trabalho real de agentes não cabe nessa janela: ler um repositório, rodar testes ou triar uma fila leva minutos.
Então, um agente de voz que tenta fazer tudo sozinho falha de uma de duas maneiras. Ou ele responde rápido e superficial, ou fica em silêncio enquanto pensa. Nenhuma das duas é útil quando você está indo para uma reunião e quer saber se as execuções dos agentes da noite passada passaram.
A solução é uma divisão que você talvez já use para texto: uma frente rápida que cuida da conversa e um backend mais lento que faz o trabalho. O GPT-Live incorpora essa divisão na própria API. Se você leu nosso post sobre transferências de agente para agente e de agente para humano, este é o mesmo padrão com um microfone acoplado.
Como funciona a delegação do GPT-Live
O GPT-Live tem dois modos de delegação, escolhidos no momento da criação da sessão. Para trocar de modo, é preciso iniciar uma nova sessão.
| Delegação Responses | Delegação ao cliente | |
|---|---|---|
| Quem executa o backend | A OpenAI, por meio da API Responses | Sua aplicação |
| Configuração | delegation.type: "responses" mais model, instructions, tools |
delegation.type: "client" |
| Modelo backend | Um que você configurar, por exemplo gpt-6-luna |
Qualquer um que você possa chamar |
| Como os resultados retornam | Tratado para você | session.commentary.append ou session.thinking.append |
| Serve para | Consultas e chamadas de ferramentas que a OpenAI pode executar | Trabalho que vive nos seus próprios sistemas |
A delegação Responses é o caminho curto. Você indica um modelo backend, e a OpenAI o executa com as ferramentas que você listar. O guia de delegação sugere começar com o gpt-6-luna e experimentar o gpt-6-sol para tarefas backend mais complexas.
A delegação ao cliente é o caminho para agentes que você já executa. Quando o modelo de voz decide que precisa de ajuda, seu aplicativo recebe um evento session.delegation.created com um ID de delegação. Esse evento não traz as palavras do usuário, então seu aplicativo reconstrói a solicitação a partir dos eventos de transcrição e do seu próprio estado. Quando o trabalho termina, você envia o resultado de volta com o mesmo ID de delegação, e o GPT-Live o parafraseia em voz alta.
O padrão: o GPT-Live fala, sua equipe de agentes trabalha
Esta é a estrutura de uma interface de voz sobre a Sharkly. A Sharkly fica acima dos seus agentes de código (Claude Code, Codex, Gemini CLI e outros) como a camada onde o trabalho é atribuído, executado em Computadores conectados e revisado. O modelo de voz nunca toca em um repositório. Ele pede trabalho, e o quadro o registra.
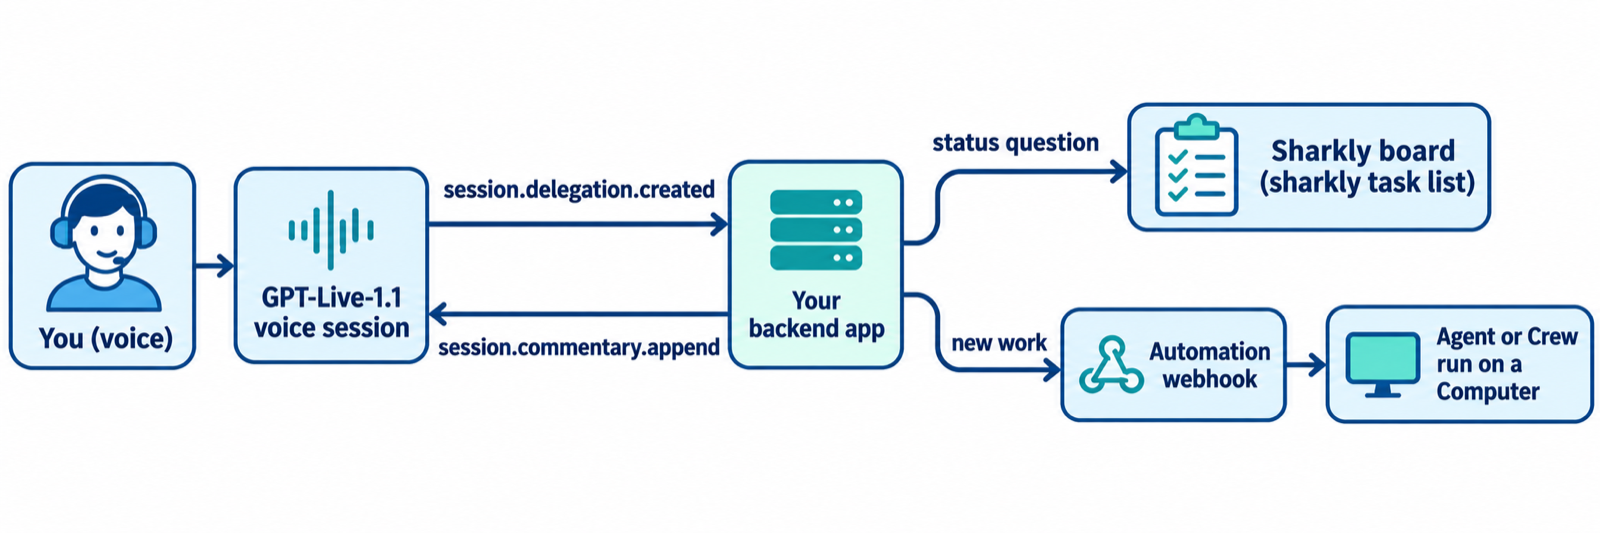
Três tipos de solicitação cobrem a maior parte do que as pessoas perguntam a um agente de voz sobre sua equipe de agentes:
- Perguntas de status ("O teste noturno passou?"). Seu backend lê o quadro com a CLI
sharklye responde em segundos. - Trabalho novo ("Peça a um agente para olhar o teste de login instável"). Seu backend chama um webhook de Sharkly Automation, e um Agent ou Crew inicia uma execução.
- Decisões ("Faz o merge"). Seu backend recusa e diz à pessoa onde revisar. Voz é um lugar ruim para aprovar mudanças.
Essa terceira regra é uma escolha de design, não uma limitação de nenhum dos produtos. Um "sim" falado é fácil de ouvir errado e difícil de auditar. Mantenha as aprovações onde está a evidência, o que nosso guia sobre agentes de código com human-in-the-loop aborda em profundidade.
Dê voz ao seu agente de IA: configuração passo a passo
Passo 1: Crie a Automation e o gatilho de webhook dela
Na Sharkly, uma Automation é uma definição pertencente a um Space para trabalho repetível de Agent ou Crew: instruções, um responsável, gatilhos e histórico de execuções. Um gatilho de webhook cria uma URL secreta que aceita uma requisição POST de um serviço externo. A documentação de Automations avisa que a URL completa é exibida apenas uma vez, quando o gatilho é criado ou regenerado, então armazene-a como segredo imediatamente.
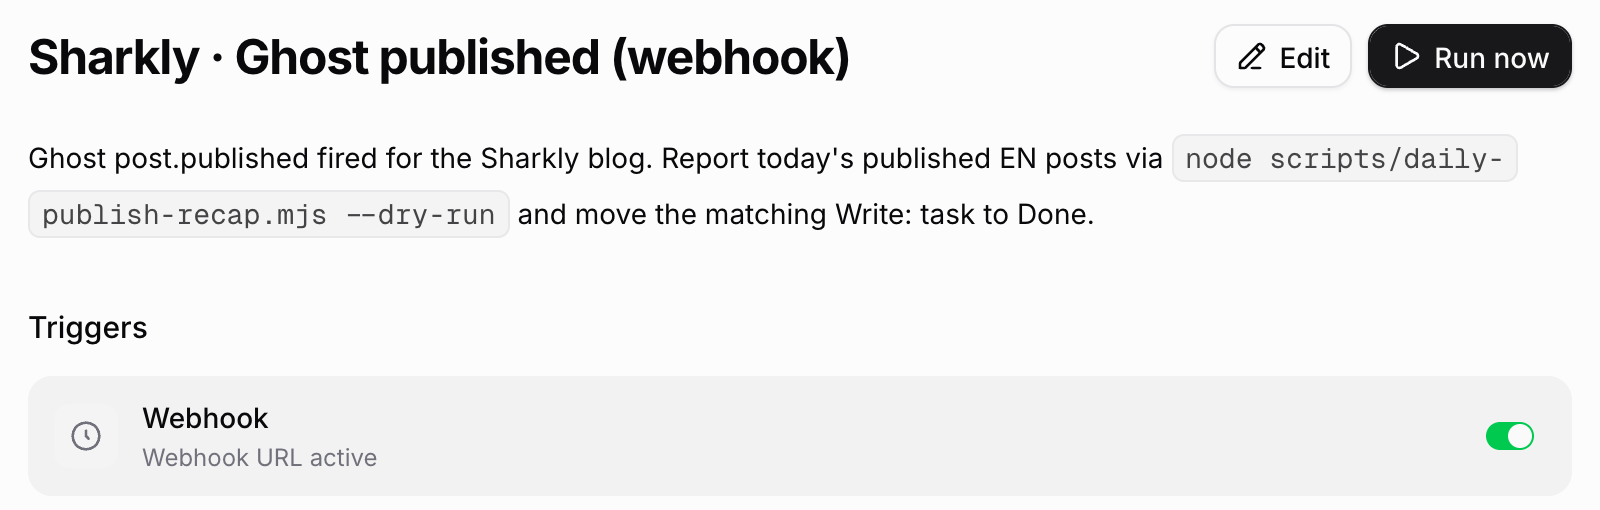
Escreva as instruções para que o Agent leia a solicitação do payload do gatilho e registre o resultado como um comentário na tarefa. Declare o que ele pode alterar e quando uma pessoa precisa decidir. Depois use o Run now para testar o Agent e o Computador dele antes de conectar qualquer tráfego de voz. Nosso passo a passo sobre Automations na Sharkly mostra mais tipos de gatilho.
Passo 2: Crie uma sessão GPT-Live em modo cliente
A configuração da sua sessão nomeia o modelo de voz e ativa a delegação ao cliente. A configuração acknowledgement_delay_ms dá ao seu app tempo para enviar sua própria atualização antes que o GPT-Live diga um reconhecimento genérico.
export const session = {
  model: "gpt-live-1.1",
  instructions:
    "You are the voice front end for an engineering team's agent board. " +
    "Delegate status questions and new work requests. Never approve, merge, or deploy.",
  delegation: {
    type: "client",
    acknowledgement_delay_ms: 800,
  },
};
A OpenAI recomenda WebRTC para áudio em apps de navegador, dispositivos móveis e servidores, com WebSockets como alternativa suportada. O guia de primeiros passos do GPT-Live cobre a configuração da conexão.
Passo 3: Encaminhe cada delegação para a Sharkly
Quando o session.delegation.created chegar, salve o ID da delegação, reconstrua a solicitação a partir da transcrição e decida qual caminho ela segue. Este esboço em Node envia trabalho novo para o webhook da Automation e responde perguntas de status lendo o quadro.
import { execFile } from "node:child_process";
import { promisify } from "node:util";
const run = promisify(execFile);

const WEBHOOK_URL = process.env.SHARKLY_AUTOMATION_WEBHOOK_URL!; // stored secret

async function handleDelegation(connection, delegationId: string, request: string) {
  // Quiet note so the voice model knows work started; not spoken on append.
  connection.send({
    type: "session.thinking.append",
    event_id: `start_${delegationId}`,
    delegation_id: delegationId,
    content: "Request received. Checking the agent board.",
  });

  if (isStatusQuestion(request)) {
    const { stdout } = await run("sharkly", ["task", "list", "--status", "In Progress", "--output", "json"]);
    const tasks = JSON.parse(stdout);
    return speak(connection, delegationId, `${tasks.length} tasks are in progress right now.`);
  }

  const res = await fetch(WEBHOOK_URL, {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ source: "voice", request }),
  });
  if (!res.ok) {
    return speak(connection, delegationId, "I couldn't start that run. Nothing was assigned.");
  }
  return speak(connection, delegationId, "An agent run has started. The result will land on the board.");
}

function speak(connection, delegationId: string, content: string) {
  connection.send({
    type: "session.commentary.append",
    event_id: `result_${delegationId}`,
    delegation_id: delegationId,
    content, // 500-token limit per append
  });
}
Repare no que a resposta de voz promete. Ela diz que uma execução começou, não que o trabalho está pronto. O guia da OpenAI faz a mesma observação sobre reservas: só envie o resultado depois que a ação tiver tido sucesso.
Passo 4: Leia os resultados no quadro, não de ouvido
Execuções de agentes levam minutos, e uma sessão de voz pode terminar antes do trabalho. Por isso, o quadro é o registro. O Agent publica o resultado na tarefa, o histórico de execuções mostra o payload do gatilho e a saída, e uma pessoa revisa lá. Na próxima vez que você perguntar "o que aconteceu com o teste instável?", o caminho de status lê esse resultado de volta para você.
Custos e limites para planejar
| Item | GPT-Live-1.1 (documentação da OpenAI, 20/11/2026) |
|---|---|
| Endpoint | v1/live/sessions |
| Sessão ativa | US$ 0,05 por minuto |
| Standby | US$ 0,02 por minuto (sessões WebRTC enquanto a inferência está pausada) |
| Faturamento | Por duração; a página de preços da OpenAI diz que o GPT-Live cobra por segundo |
| Sessões simultâneas | Limites separados do GPT-Live-1; veja a página de limites da sua organização |
| Chamadas backend | Faturadas pelas tarifas normais do modelo configurado |
Um check-in de standup de 10 minutos custa US$ 0,50 em tempo de voz na tarifa ativa, antes de qualquer chamada backend. Como referência, a página do modelo GPT-Live-1 lista 50, 300 e 500 sessões simultâneas nos planos Build, Launch e Grow, e nenhum acesso no plano Free. O GPT-Live-1.1 tem limites próprios.
Execuções de agentes no lado da Sharkly são faturadas contra o plano Claude Code, Codex ou API já vinculado a cada Runtime. A Sharkly não vende tokens. Se você encaminhar perguntas de status para um modelo backend barato, nossas notas sobre executar agentes GPT-6 Luna na Sharkly se aplicam diretamente.
Medidas de proteção que valem a pena desde o primeiro dia
- Interrupções não cancelam o trabalho. O guia da OpenAI diz que interromper a conversa falada não para o trabalho backend. Se alguém disser "deixa pra lá", seu backend precisa tratar isso, ou a execução continua.
- Trate a URL do webhook como uma senha. A documentação da Sharkly a descreve como um segredo bearer por padrão. Adicione um signing secret e regenere a URL se ela vazar.
- Delimite o escopo da Automation. Comece com trabalho observável e reversível, como a documentação da Sharkly recomenda, e revise várias execuções antes de ampliá-lo.
- Mantenha a delegação de Crews dentro da Sharkly. Se uma solicitação precisar de vários agentes, aponte o webhook para uma Sharkly Crew e deixe o líder dela dividir o trabalho.
Quando uma interface de voz é a ferramenta errada
Passe longe quando a solicitação precisar de um diff, um log ou uma captura de tela para fazer sentido. Voz não consegue te mostrar um teste que falhou. Também é o canal errado para qualquer coisa que precise de uma assinatura: aprovações, deploys e mudanças de acesso pertencem à tarefa onde está a evidência.
A voz se justifica para verificações rápidas de status, disparo de execuções bem definidas e momentos em que as mãos estão ocupadas. Pense nela como um controle remoto para o seu quadro de agentes, não como um substituto dele.
Conclusão
O GPT-Live-1.1 cuida da parte de um agente de voz que é difícil de construir por conta própria: conversa full-duplex com interrupções. A delegação transfere todo o resto para um backend. Coloque sua equipe de agentes existente por trás desse backend, e você poderá perguntar sobre execuções e iniciar novas em voz alta, enquanto cada resultado continua chegando a um quadro que uma pessoa revisa.
Seu próximo passo: crie uma Automation com gatilho de webhook na Sharkly, teste-a com o Run now e depois aponte uma sessão GPT-Live em modo cliente para ela. A documentação da Sharkly cobre Agents, Computadores e Automations em detalhes.
FAQ
Como dou voz ao meu agente de IA?
Coloque um modelo de voz como o GPT-Live-1.1 na frente do agente e deixe-o delegar. O modelo de voz cuida de escutar e falar, e seu backend executa o agente e devolve um resultado curto para o modelo de voz dizer.
O GPT-Live-1.1 está disponível na API?
Sim. A OpenAI lista o gpt-live-1.1 com o endpoint v1/live/sessions, function calling e streaming. Ele não suporta v1/realtime nem v1/responses diretamente.
Quanto custa o GPT-Live-1.1?
A OpenAI lista US$ 0,05 por minuto para sessões ativas e US$ 0,02 por minuto em standby. Chamadas ao modelo backend feitas por meio de delegação são faturadas separadamente, pelas tarifas normais.
Qual é a diferença entre delegação Responses e delegação ao cliente?
Na delegação Responses, a OpenAI executa um modelo backend que você configura. Na delegação ao cliente, seu app recebe cada solicitação e devolve os resultados com session.commentary.append ou session.thinking.append.
O GPT-Live-1.1 pode executar agentes de código diretamente?
Não. Ele delega. Seu backend decide o que executa, por exemplo, chamando um webhook de Sharkly Automation que inicia uma execução de Agent ou Crew em um Computador conectado.
O que acontece se eu interromper o agente de voz no meio de uma tarefa?
A conversa para, mas o trabalho backend não. Trate o cancelamento no seu backend, por exemplo, pausando a execução ou comentando na tarefa.