
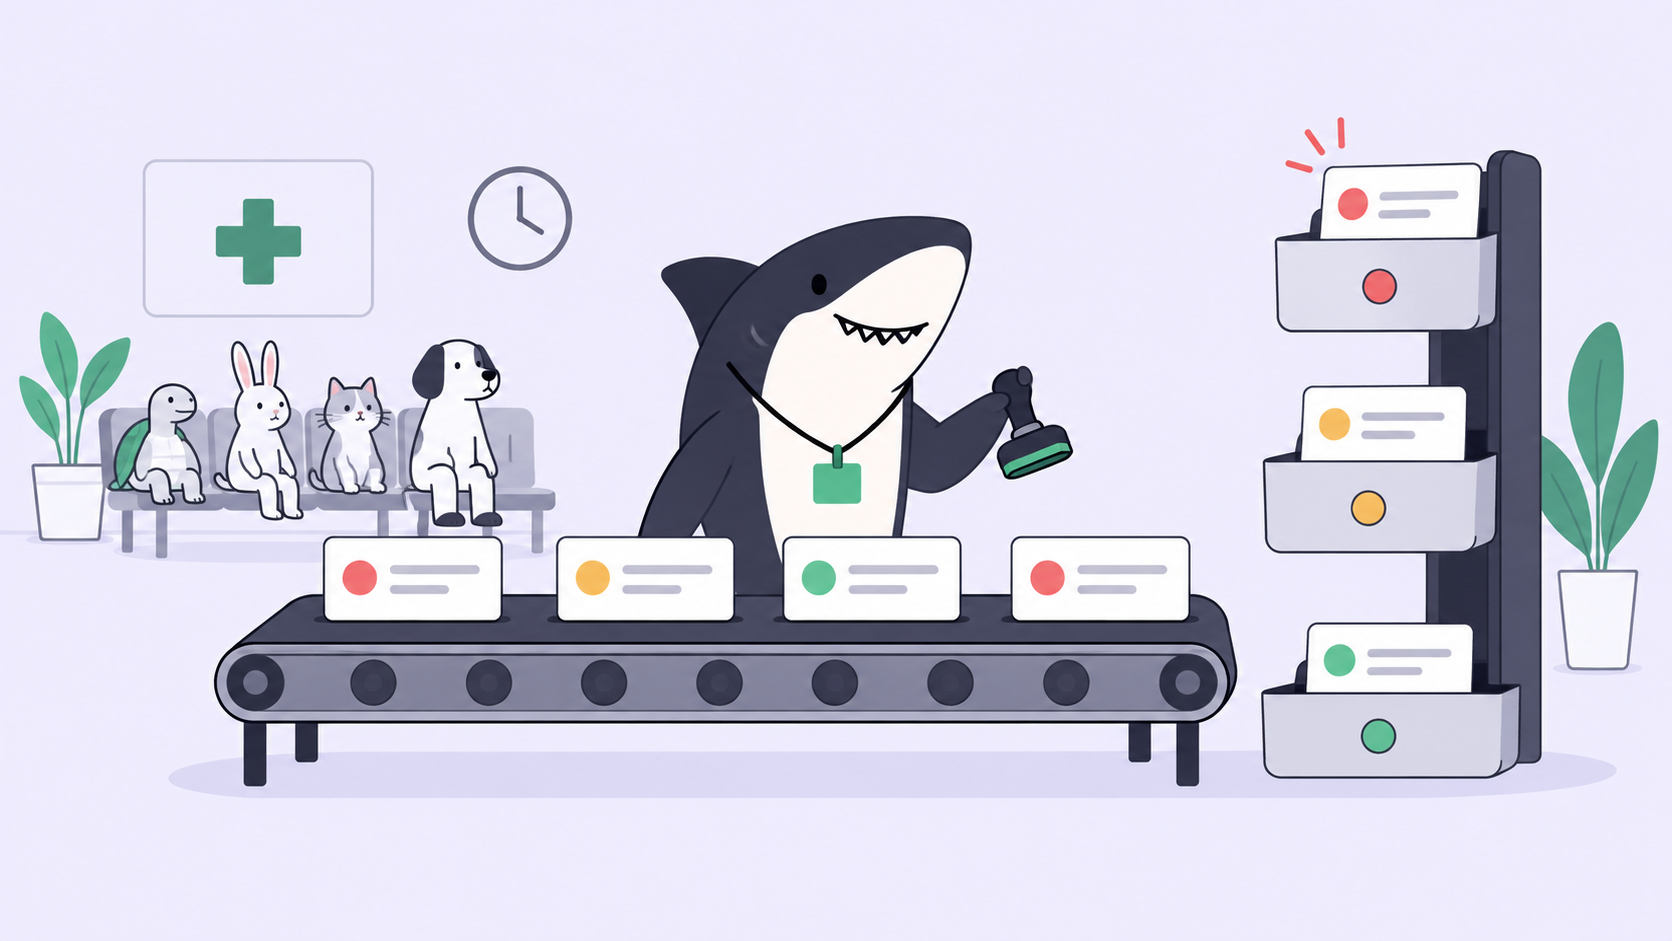
Quatro agentes de código terminam dentro da mesma hora e abrem quatro pull requests. Uma mexe em um caminho de retentativa de cobrança, outra renomeia um helper de teste, outra adiciona uma migração, outra corrige um typo no README. O gargalo não é o código nem os testes. É a pergunta que uma pessoa responde antes de ler um único diff: qual desses eu vejo primeiro? Já argumentamos que a revisão humana é o gargalo quando os agentes rodam em paralelo. Este post cobre a parte mecânica desse problema, a ordenação da fila, e como um modelo de decisão como o Jev pode tirar isso da mesa do revisor sem tirar a revisão.
O que é o Jev
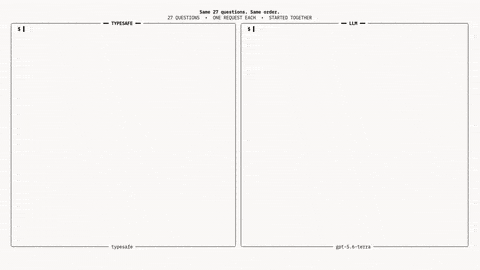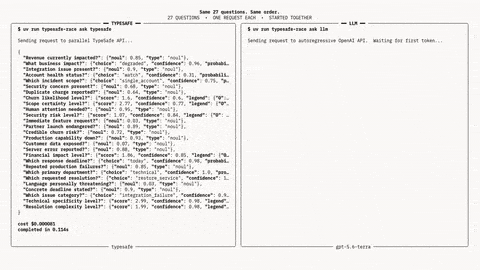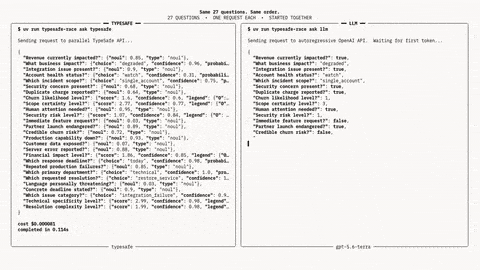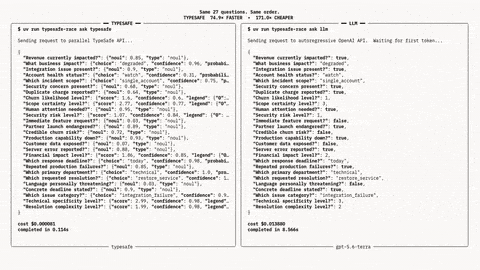
Jev é um System One Model da TypeSafe AI: você envia um trecho de estado e um conjunto de perguntas tipadas, e ele retorna uma resposta para cada pergunta com uma probabilidade calibrada, nunca texto livre. Para deixar claro o nome, este é o Jev da TypeSafe, não o youtuber nem a vacina contra encefalite japonesa. O post de lançamento da TypeSafe o descreve como “estado não estruturado entra, decisões probabilísticas tipadas saem”. A API é um único endpoint, POST https://api.typesafe.ai/v1/systemone, chave Bearer, modelo jev-latest, três tipos de pergunta: noul (probabilidade de sim/não), choice (uma escolha entre até 255 opções) e score (uma posição em uma rubrica de 2 a 10 níveis). Apenas texto, 64k tokens por requisição, com 32k para o estado, US$ 0,042 por milhão de tokens de entrada, saída não é cobrada. Nosso post irmão sobre Jev como camada de decisão para agentes de código cobre o modelo em geral; aqui o usamos para um único trabalho.
As três perguntas de revisão
Todo PR que um agente de código abre levanta as mesmas três perguntas, e cada uma mapeia para uma primitiva. O estado é o mesmo para as três: um resumo do diff, o resultado dos testes e os caminhos tocados. Não o diff completo. Um resumo mantém a chamada dentro do orçamento e mantém o modelo respondendo à pergunta de roteamento em vez de revisar o código de novo.
Isto precisa de uma pessoa antes do merge? Um noul. Este é o filtro. Ele decide se um PR entra na fila humana ou espera em uma faixa de baixa prioridade.
Qual revisor ou fila? Um choice entre as filas que seu time realmente opera. A resposta traz a escolha mais a distribuição completa, então uma divisão de 0,48 / 0,44 entre duas filas indica que o PR está na fronteira de ownership, o que por si só já vale saber.
Quanto risco ele carrega? Um score em uma rubrica ordenada. O resultado é uma posição ponderada por probabilidade, então uma mudança pode ficar em 2,6 entre “mudança de lógica coberta por testes” e “toca autenticação, cobrança ou dados”. Esse número é a chave de ordenação da fila.
Uma requisição responde às três:
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
A resposta são três respostas tipadas sob as mesmas chaves. Para o SH-418, espere needs_human perto de 0,9, queue escolhendo payments, e risk perto do topo da rubrica. Uma correção de retentativa de cobrança com testes verdes ainda vai para a frente da fila de pagamentos, porque testes verdes não respondem “uma pessoa deveria ler isto”.
Limiares e o que cada faixa faz
Uma probabilidade só é útil quando o código a transforma em ação. As faixas abaixo são um ponto de partida, não uma recomendação para o seu repositório; ajuste-as depois de uma semana de execuções.
needs_human |
Ação |
|---|---|
| 0,85 ou mais | Frente da fila humana, ordenada por risk decrescente |
| 0,15 a 0,85 | Fila humana, ordenada por risk, depois da faixa acima |
| abaixo de 0,15 | Faixa de baixa prioridade; uma pessoa ainda faz o merge, no ritmo dela |
Duas regras mantêm isto honesto. Primeiro, risk no topo da rubrica sempre promove um PR para a faixa da frente, independentemente do que needs_human diga. Um modelo que está 0,12 confiante de que uma migração de schema precisa de revisão viu um resumo de diff arrumadinho, não a produção. Segundo, um choice cujas duas principais opções ficam a menos de 0,1 uma da outra vai para as duas filas, não para nenhuma. Ambiguidade sobre ownership é motivo para duas pessoas darem uma olhada em uma mudança, não para zero.
Note o que permanece com a pessoa em todas as faixas: o merge. As faixas mudam a ordem de leitura e a profundidade de leitura. Nunca mudam quem decide.
Use o Jev para a fila, não para o veredito
Use o Jev quando a pergunta tem um conjunto fixo de respostas, o estado é um resumo fiel, e você quer gastar a atenção de um humano em uma ordem melhor: quem lê isto, quão cedo, em qual fila. Essas perguntas aparecem em todo PR e são baratas o suficiente nesse preço para serem feitas em toda execução.
Use uma pessoa, ou um modelo de linguagem que consiga mostrar seu raciocínio, quando a pergunta é se a mudança está correta. Uma probabilidade de que uma mudança precisa de revisão não é uma revisão. O Jev não tem compilador, nem executor de testes, nem acesso ao arquivo que está pontuando, apenas o resumo que você enviou. Um 0,96 em “seguro para merge” é um forte motivo para colocar esse PR no topo da lista de alguém, nunca um motivo para pular o alguém. O gate de aprovação fica depois do modelo, e o modelo não tem como abri-lo.
O que a comunidade construiu
Poucos dias após o lançamento, um desenvolvedor publicou o jev-review, que seu README descreve como “um pequeno fluxo de revisão de código construído com TypeSafe Jev”. Ele revisa um diff do Git ou um codebase inteiro, faz triagem de correção, segurança, confiabilidade, compatibilidade e cobertura de testes, seleciona regiões de código antes de pontuar impacto, aplica limiares e políticas de fluxo em código, e mostra os resultados em um dashboard local. O README é cuidadoso quanto ao escopo: chama o projeto de “um experimento de compor julgamentos tipados rápidos em um fluxo de revisão” e diz que ele “ainda não integra diagnósticos de compilador, analisadores estáticos, indexação de repositório ou explicações geradas”.
Duas coisas nesse design valem a pena copiar: a orquestração vive no código e o Jev só responde a perguntas delimitadas, e o trabalho é faseado, escolha uma região e depois pontue-a, em vez de uma única pergunta gigante sobre o diff inteiro. O Jev também está no Vercel AI Gateway como typesafe-ai/jev via experimental_evaluate no AI SDK 7; a documentação do Gateway observa que isso está disponível apenas através do AI SDK.
Onde isto se encaixa com o Sharkly
O Sharkly não chama o Jev por você, e não é um modelo de decisão. É a camada compartilhada de tarefa, Computer, contexto e revisão em torno dos agentes de código que seu time já usa. O que uma fila ordenada precisa dessa camada é de um lugar para rodar e um lugar para chegar.
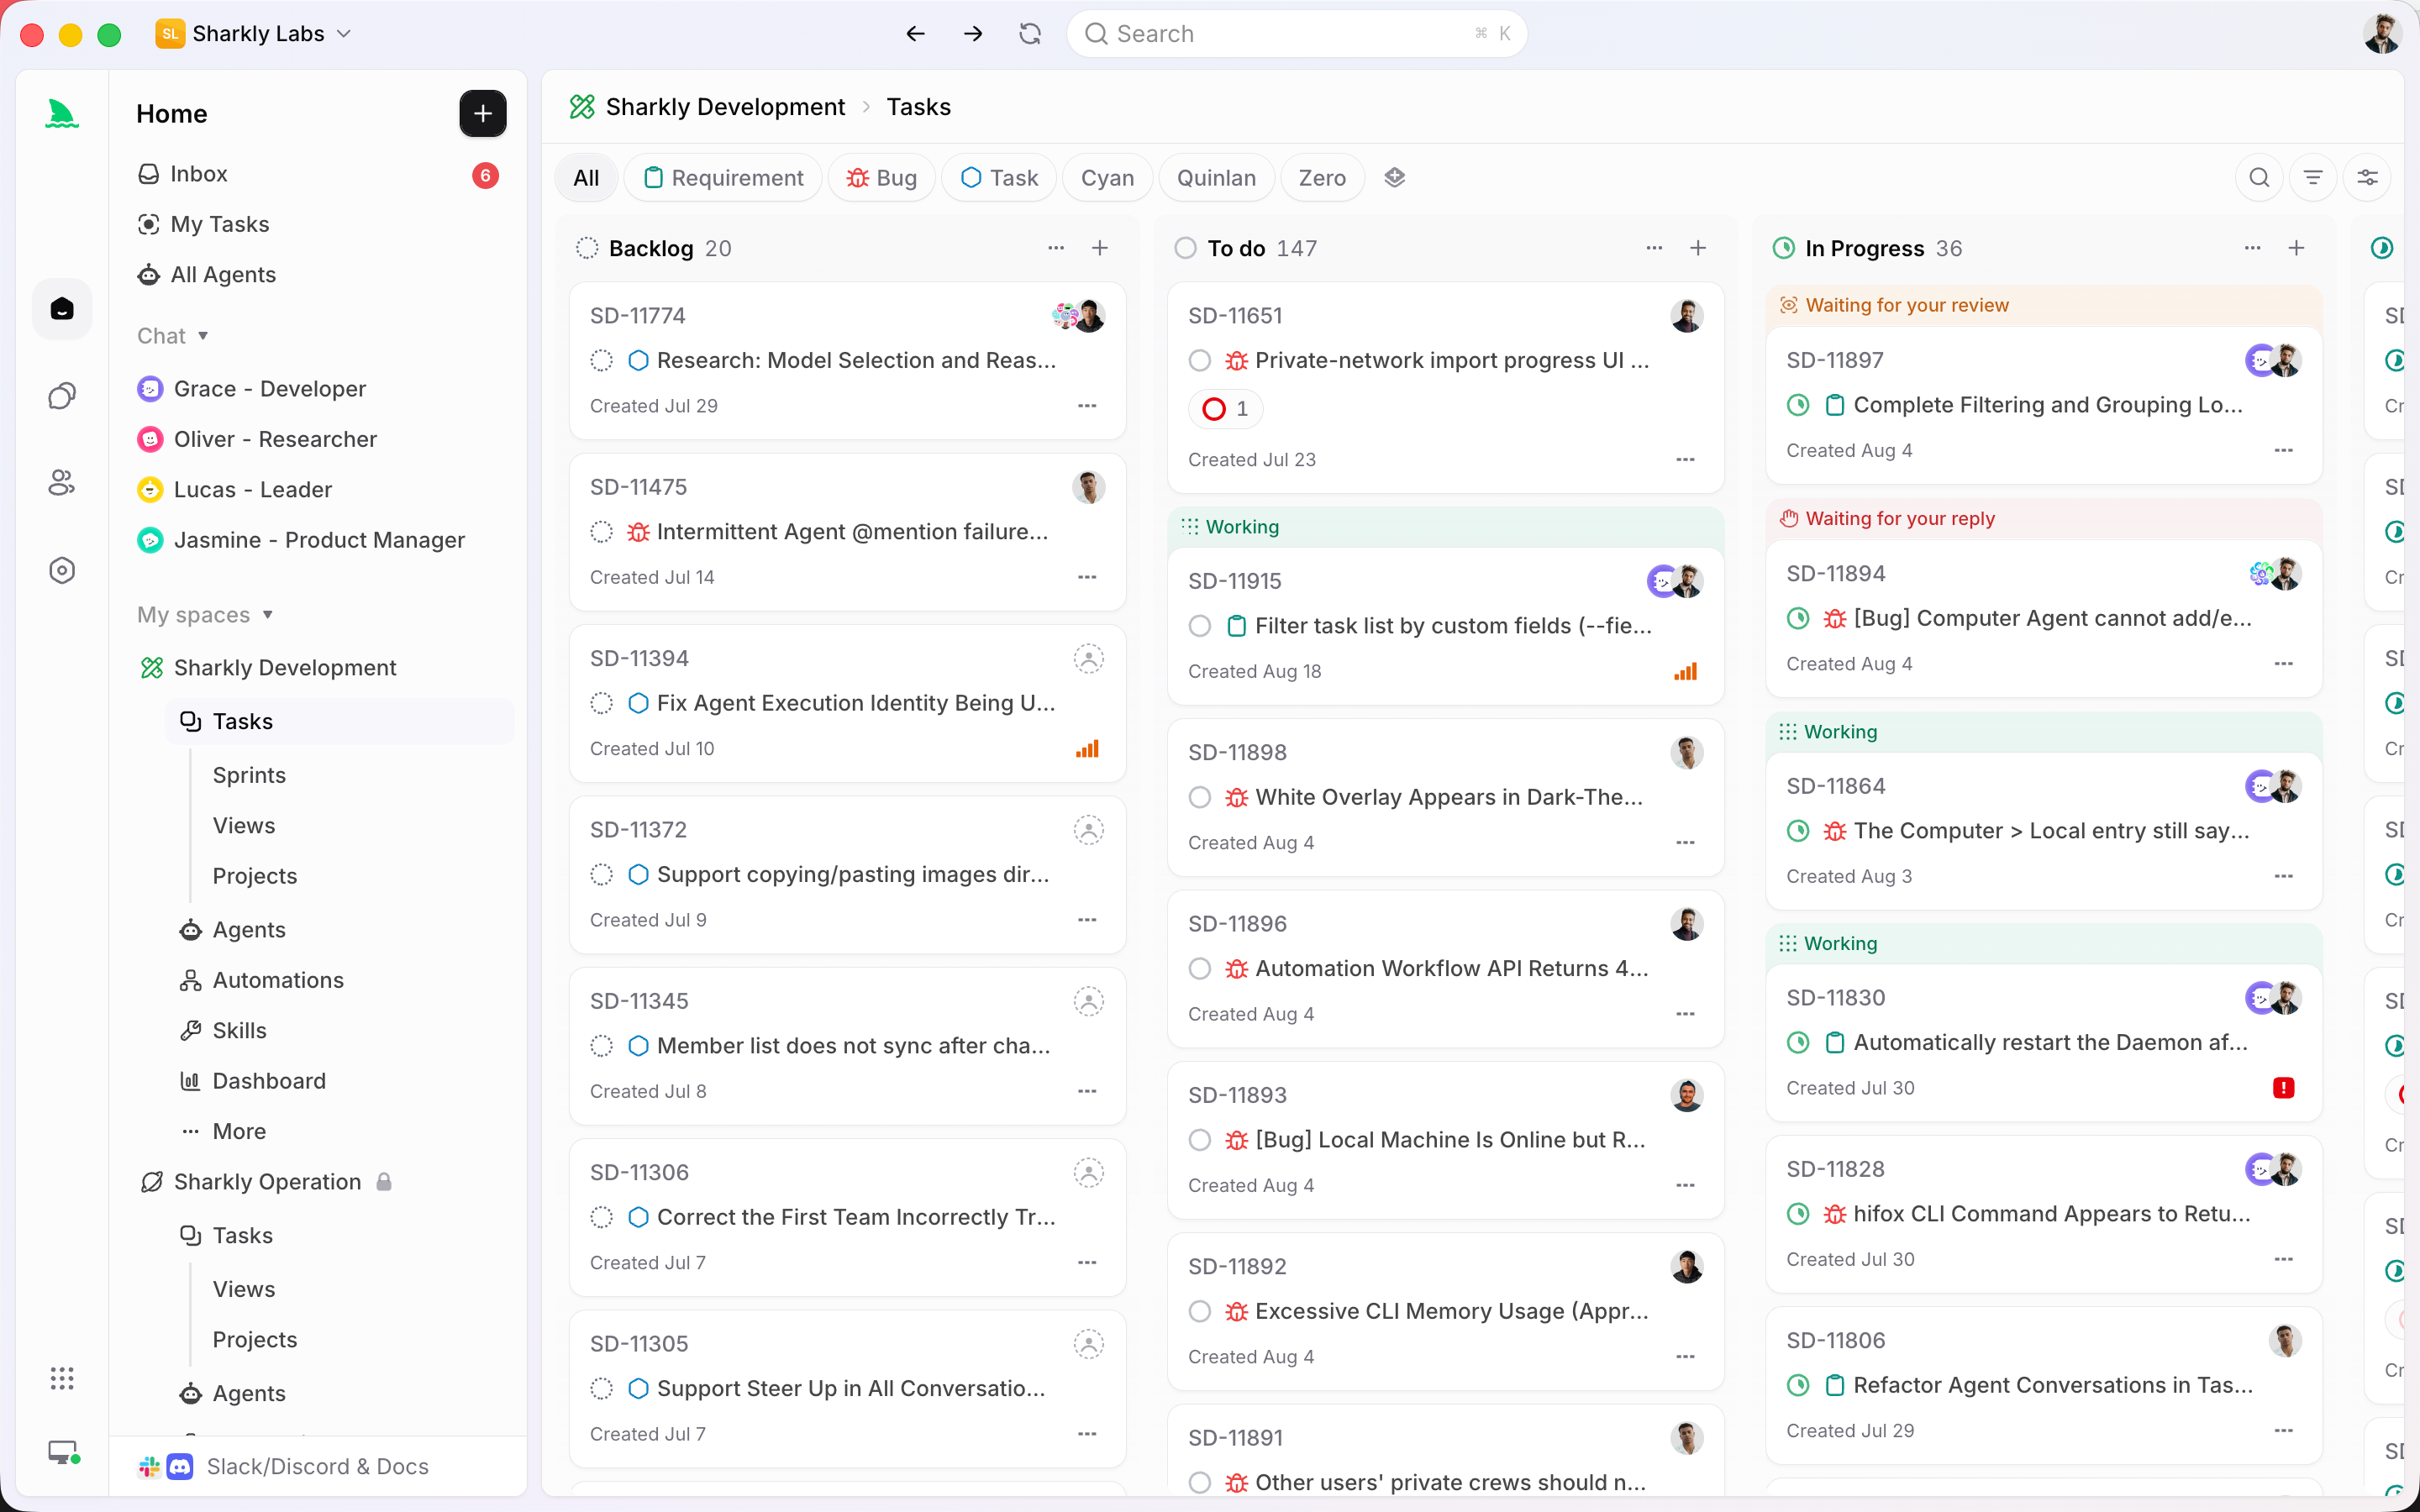
O lugar para rodar é uma Automation: uma regra pertencente a um Space que inicia um Agent com um conjunto de instruções em um gatilho, e um gatilho é uma tarefa se movendo para um status escolhido. Aponte-a para o status que seus Agents atingem quando um PR está aberto, e as instruções passam a ser: leia o resumo do diff da Task, o resultado dos testes e os caminhos tocados; chame o Jev com as três perguntas; escreva as respostas e a faixa de volta como um comentário na Task; defina um label para a fila. A documentação é explícita ao dizer que uma execução concluída “não é uma promessa de que todo resultado de negócio a jusante estava correto”, que é a mesma fronteira que as faixas de revisão traçam.
O lugar para chegar é a própria Task. A faixa, a fila e a pontuação de risco voltam para a Task, onde o revisor já olha, ao lado do resumo de mudanças e dos resultados de verificação da execução. Uma pessoa abre o board ordenado por risco e vê por que cada PR está onde está. Os agentes abrem o pull request, rodam os testes e reportam. As pessoas leem na ordem que a fila sugere, e aceitam ou rejeitam. A ordem veio de uma probabilidade; a decisão não.
Se você já roda vários agentes e a fila de revisão é o que dói, esse é o fluxo que o primeiros passos com o Sharkly configura: um Computer, um Agent, uma Task com as evidências que uma ordenação precisa.
Perguntas frequentes
O Jev consegue ler o diff inteiro em vez de um resumo?
Ele aceita até 32k tokens de estado, então um diff pequeno cabe. Envie um resumo de qualquer forma: os diffs dos agentes ultrapassam o orçamento rapidamente, e um resumo mantém a pergunta no nível de roteamento. O diff completo é o que o humano lê, com evidências no nível da tarefa ao lado.
E se o próprio agente escreveu o resumo do diff?
Então o resumo pode estar errado a favor do agente, e a ordenação herda isso. Prefira um resumo produzido a partir do diff por uma etapa separada, e sempre deixe uma pontuação risk de alto nível sobrescrever um needs_human baixo. Os limites da revisão de código por IA se aplicam aqui: o modelo consegue ordenar o que lhe é mostrado, não consegue verificar o que não é.
Uma faixa baixa significa que o PR faz merge automaticamente?
Não. Uma faixa baixa significa que uma pessoa faz o merge depois, no ritmo dela, sem ler primeiro na fila. O ownership do merge, e do trabalho que o agente produziu, permanece com uma pessoa nomeada em todas as faixas.
O Jev é gratuito através do Sharkly?
O Sharkly não revende o Jev nem nenhum modelo; você traz sua própria chave TypeSafe ou do Gateway, da mesma forma que as execuções são cobradas contra as assinaturas vinculadas aos seus Runtimes. O Sharkly em si é atualmente gratuito para organizações de até 5 pessoas.


