
O artigo de lançamento da Meta para o Muse Wonder descreve um comportamento denominado Active Focus: o modelo continua trabalhando em direção a um objetivo difícil, tenta abordagens alternativas, supera bloqueios e, nas palavras da própria Meta, pede esclarecimentos quando necessário e faz check-ins antes de ações importantes. A Meta também recomenda a confirmação humana antes de ações com consequências relevantes, e seu guia de coding-agents disponibiliza o Muse Code com aprovações e sandbox ativados desde a primeira execução.
Essa é a abordagem correta de design. Mas ela também traz à tona uma dúvida bem conhecida por qualquer equipe que executa agentes em paralelo: quando o modelo para para perguntar, quem está lá para responder, com que rapidez e com qual contexto? Um check-in que vai parar em um terminal que ninguém está monitorando é uma execução travada. Um check-in que chega a uma Inbox compartilhada, vinculado à Task de origem, é uma etapa de revisão. Este artigo aborda como estruturar essa segunda opção.
O que o Active Focus gera
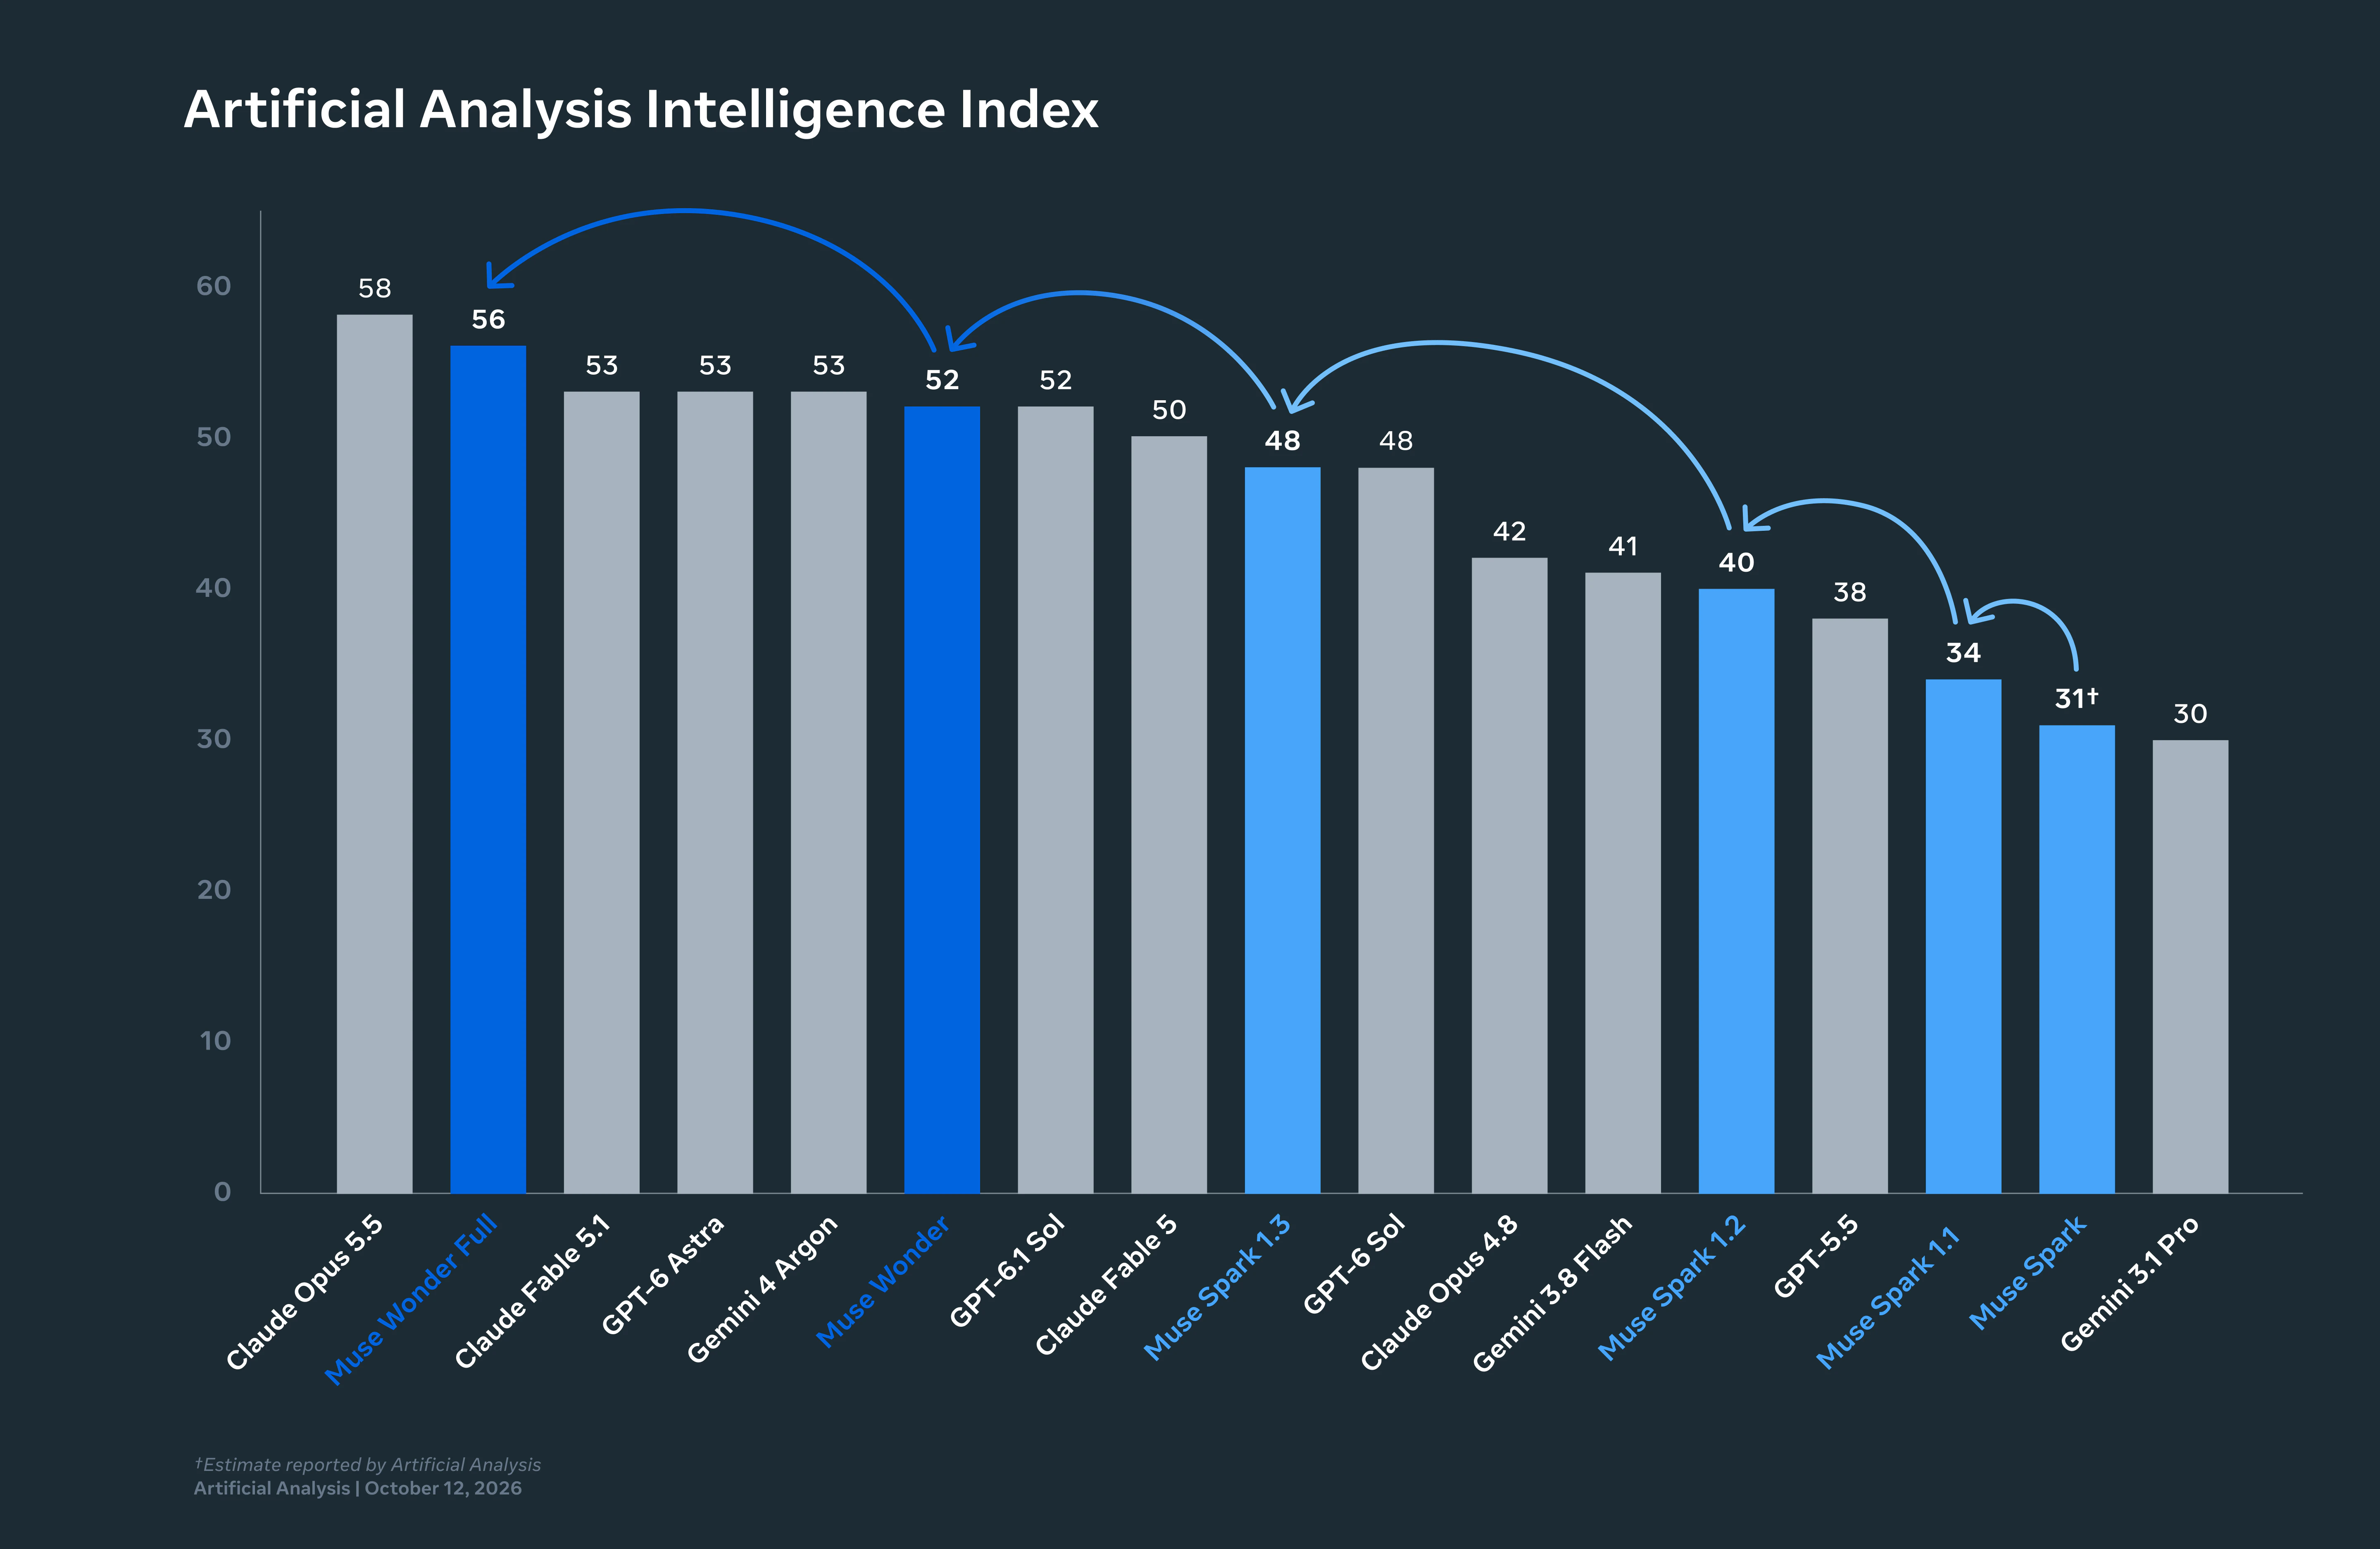
A Meta treinou o modelo para três comportamentos e os avalia em um benchmark interno chamado FocusBench, no qual o Muse Wonder Full lidera com 54,2% e a versão do Wonder disponível via API fica em 44,9%, atrás do GPT-6 Astra e do Claude Opus 5.5. Deixando as pontuações de lado, são os comportamentos que realmente importam para um board:
- Persistência. O modelo continua avançando mesmo após falhas. No SWE-Marathon, benchmark de codificação de longa duração, o Wonder atinge 53,1 contra 46,3 do Opus 5.5. Execuções mais longas, mais tentativas e mais conteúdo para revisar.
- Esclarecimento. O modelo faz perguntas quando a Task é ambígua em vez de tentar adivinhar. Em um board, isso se transforma em um comentário na Task; em um terminal, é um prompt aguardando o pressionamento de uma tecla.
- Check-ins. O modelo faz uma pausa antes de executar uma ação que considera importante. A recomendação da própria Meta é transformar isso em uma confirmação humana para qualquer ação com impacto significativo.
Cada um desses comportamentos altera a dinâmica da fila de revisão. A persistência aumenta o volume por Task. O esclarecimento introduz interrupções. Os check-ins criam decisões que bloqueiam a execução até que alguém intervenha.
Onde o check-in vai parar
No Muse Code, uma solicitação de aprovação é exibida no terminal do usuário e a execução é pausada. Execuções em modo headless (muse exec) não contam com um prompt interativo; por isso, a documentação da Meta recomenda definir uma política que possa ser concluída sem supervisão ou esperar que ações retidas permaneçam indefinidamente sem resolução. Essa é a escolha real: ou há alguém no teclado, ou o modelo executa com aprovações desativadas, ou a ação aguarda para sempre.
Em um board do Sharkly, a execução é uma Task atribuída a um Agent em um Computer. Quando o Agent para para perguntar, a dúvida é enviada de volta à Task como um comentário e roteada para a Inbox. A Task preserva todo o contexto: o que foi perguntado, o que o Agent já fez até o momento e o log de execução com as chamadas de ferramentas e eventos de Runtime. Quem assumir a pendência responde diretamente na Task, permitindo que a execução seja retomada do ponto correto. O check-in continua sendo uma decisão humana — mas uma decisão com histórico, fila organizada e múltiplos responsáveis aptos a respondê-la.
Essa é a diferença entre uma medida de segurança e uma paralisação. O comportamento do modelo é idêntico. O ecossistema ao redor dele é o que determina se um check-in custará um minuto ou um dia.
Como instruir o Agent para gerar check-ins úteis
Um check-in é tão bom quanto a pergunta que ele faz. Defina o padrão para uma boa solicitação diretamente nas instruções do Agent:
Stop and ask before anything destructive, anything that sends data outside the
attached repositories, any payment or external account action, and any change
to CI, deploy or access configuration.
When you ask, state in one comment: what you are about to do, why the Task needs
it, what you considered instead, and what happens if the answer is no.
Do not ask about reversible edits inside the repository. Make them, test them,
and report.
If you have waited for an answer and the Task has a deadline, say so in a second
comment rather than proceeding.
A primeira regra estabelece o limite. O modelo da Meta decide por conta própria o que considera importante; a instrução define o que a equipe considera prioritário. A segunda regra garante que o comentário possa ser respondido em trinta segundos por alguém que não acompanhou a execução. A terceira regra impede que o modelo faça perguntas sobre tudo — padrão de falha que transforma um agente cauteloso em algo improdutivo. O artigo sobre guardrails para o Opus 5.5 analisa esse mesmo limite pelo viés da injeção de prompt: o ponto de controle é a barreira de revisão, independentemente do que o modelo prometa.
Dimensionando a fila
Persistência resulta em mais revisão por Task, não menos. Planeje-se para isso.
| Lane | Execução típica | O que chega à fila |
|---|---|---|
| Muse Wonder em uma Task longa | Muitas etapas, várias abordagens revertidas | Um diff mais longo, um log mais extenso, de zero a três check-ins |
| Opus 5.5 na mesma Task | Menos etapas, mais decisivo | Um diff mais curto ou uma Task devolvida pela metade |
| Qualquer modelo, sem supervisão durante a noite | O que a política permitiu | Ações retidas ou ações que ninguém confirmou |
Três práticas mantêm a fila em fluxo contínuo. Em primeiro lugar, direcione os check-ins para um revisor nominal específico por lane em vez de enviá-los para um grupo genérico, evitando que uma pergunta fique parada. Defina o tempo limite (timeout) por Task no Agent para que uma execução travada em um check-in falhe de maneira visível, em vez de permanecer com status em andamento durante horas. E leia o log, não apenas o diff, nas execuções do Wonder: o caminho percorrido por três abordagens fracassadas é justamente a contribuição de um modelo persistente, e é ali que os erros sutis costumam se instalar. O artigo Coding agents while you’re away aborda o cenário noturno sem supervisão, e o artigo human review is the bottleneck detalha por que nada disso fica mais simples com um modelo mais avançado.
Como é um bom check-in no board
Este é o padrão produzido pelas instruções acima — um comentário de Task sobre o qual um revisor pode intervir diretamente pelo celular:
Check-in before action.
About to: drop the legacy `orders_v1` table in the migration.
Why: the Task says remove v1 read paths; the table is the last reference.
Considered: keeping the table and removing only the code. Rejected because
the nightly job still writes to it and would fail silently.
If no: I will leave the table, remove the code paths, and note the job in
the report for a follow-up Task.
Quatro linhas, uma única decisão, ambos os cenários já mapeados. O revisor digita “sim” ou “não, mantenha” na Task, a execução continua e o log registra quem aprovou. Compare essa experiência com um prompt de terminal exibindo Allow? [y/N] para alguém que não acompanhou os quarenta passos anteriores.
Dois refinamentos recomendados após a lane rodar por uma semana: se um único revisor estiver respondendo à maior parte dos check-ins, adicione um segundo revisor designado ao Agent dessa lane para que uma reunião à tarde não trave todas as execuções extensas. E se o Agent fizer perguntas repetidas sobre a mesma categoria de ação, essa classe deve ser incorporada às instruções como um sim ou não definitivo, e não encaminhada à fila.
O caso de computer use
A Meta lista o computer use entre os recursos do Wonder: interação com navegadores, interfaces desktop e aplicativos móveis. É aqui que os check-ins se tornam mais essenciais e onde um prompt de terminal é menos adequado, pois a ação envolve um clique em uma tela que o revisor não está vendo. As mesmas diretrizes do artigo sobre computer use no Astra se aplicam: o Agent roda em um Computer selecionado pela equipe, o check-in especifica a tela e a ação, e o responsável pode inspecionar o log da Task antes de autorizar. Um modelo que solicita permissão para clicar em Enviar só oferece segurança se alguém puder discernir o impacto desse envio.
O que este recurso não é
O Active Focus é um comportamento de modelo, e comportamentos de modelos não representam garantias absolutas. O relatório do próprio modelo da Meta destaca que ele pode cometer equívocos em tarefas complexas de várias etapas em ambientes desconhecidos, e o relatório integral de segurança ainda não foi divulgado. O check-in é um recurso projetado para aprimorar um sistema de revisão competente; ele não o substitui. Uma equipe que compreende “faz check-ins antes de ações importantes” como autorização para execuções sem supervisão interpretou mal a funcionalidade. Já a equipe que assegura a cada check-in uma Task, um revisor e um timeout implementou exatamente a solução para a qual a funcionalidade foi projetada.
Nada disso acarreta custos adicionais na conta do Sharkly. O consumo do modelo utiliza a chave de API da Meta configurada no Computer. O modelo foi atualizado em 12 de outubro. Contexto, progresso, bloqueios, resultados e revisão humana permaneceram transparentes da solicitação ao lançamento. Você pode implementar essa estrutura manualmente via worktrees ou adotar o Sharkly para orquestrar o fluxo de trabalho.


