
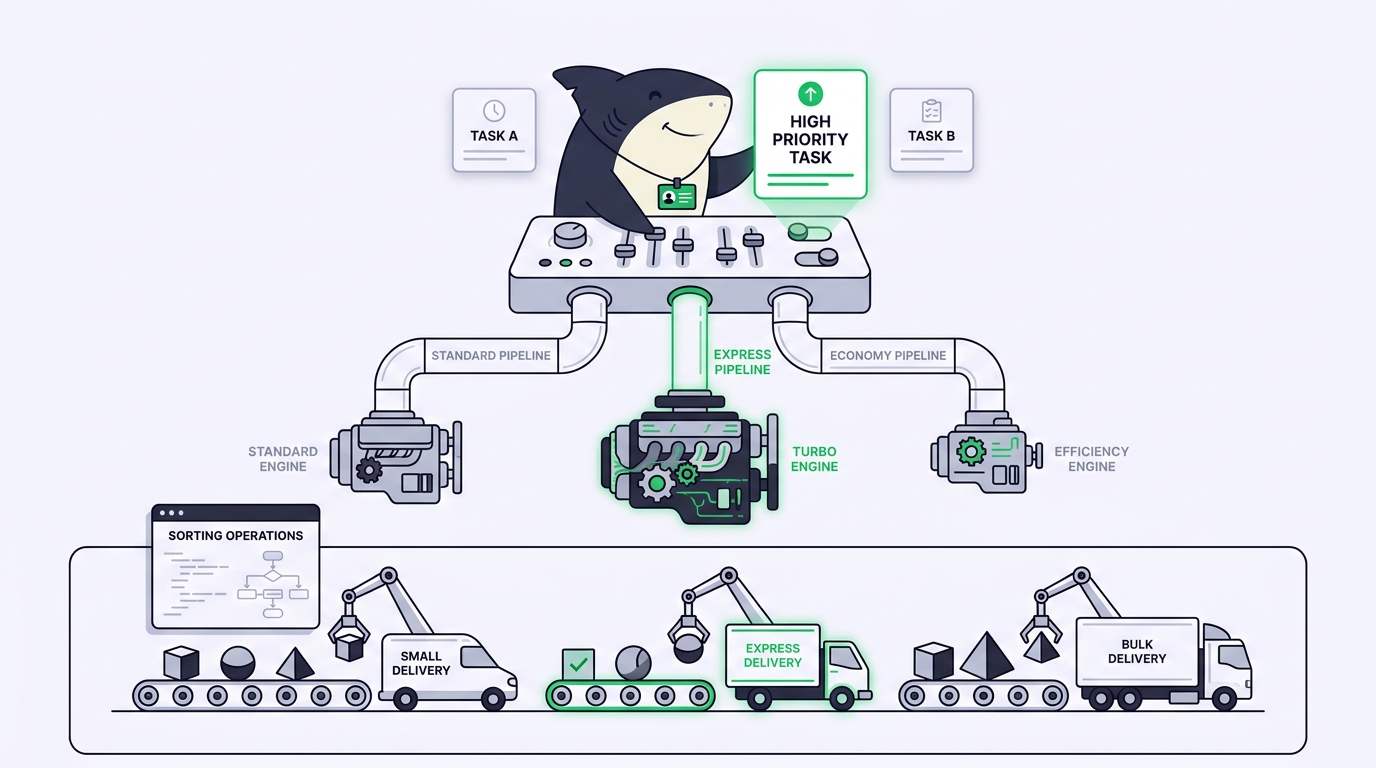
TL;DR: Pare de caçar o melhor modelo único. Combine cada modelo com o formato da tarefa que está à sua frente: raciocínio profundo para arquitetura e refatorações entre arquivos, rapidez e baixo custo para código repetitivo e testes, contexto longo para perguntas sobre o repositório inteiro, uso consistente de ferramentas para edições em várias etapas. Escolher modelo por terminal funciona com um ou dois agentes. Quando você passa a rodar várias tarefas em vários repositórios, esse mapeamento pertence a um Agente salvo, não à sua cabeça. Aqui está o mapa, um exemplo prático e um checklist que você pode aplicar hoje mesmo.
Você tem cinco terminais abertos. Em um deles há uma refatoração espinhosa, outro precisa de uma leva de testes unitários, outro responde a perguntas sobre uma base de código que você só conhece pela metade, outro caça um teste de integração instável e outro renomeia um símbolo em quarenta arquivos. Todos fazem a mesma pergunta silenciosa: qual modelo deve rodar isso? Aponte um modelo de raciocínio pesado para a renomeação e você queima tokens e minutos em um trabalho que qualquer modelo rápido termina sem sujeira. Aponte um modelo rápido para a mudança de arquitetura e ele deixa passar uma dependência a três arquivos de distância. A reclamação recorrente raramente é “os modelos são ruins”. É “não sei qual usar”.
A solução não é um ranking. As posições mudam a cada poucas semanas, e o vencedor de um benchmark geral costuma ser a escolha errada para a sua tarefa específica. A jogada que dura é casar o modelo com o formato da tarefa: quanto raciocínio ela exige, quanto contexto ele precisa carregar, com que confiabilidade ele deve seguir ferramentas e quanto você vai gastar por execução. Essas propriedades quase não mudam, mesmo quando os nomes dos modelos mudam.
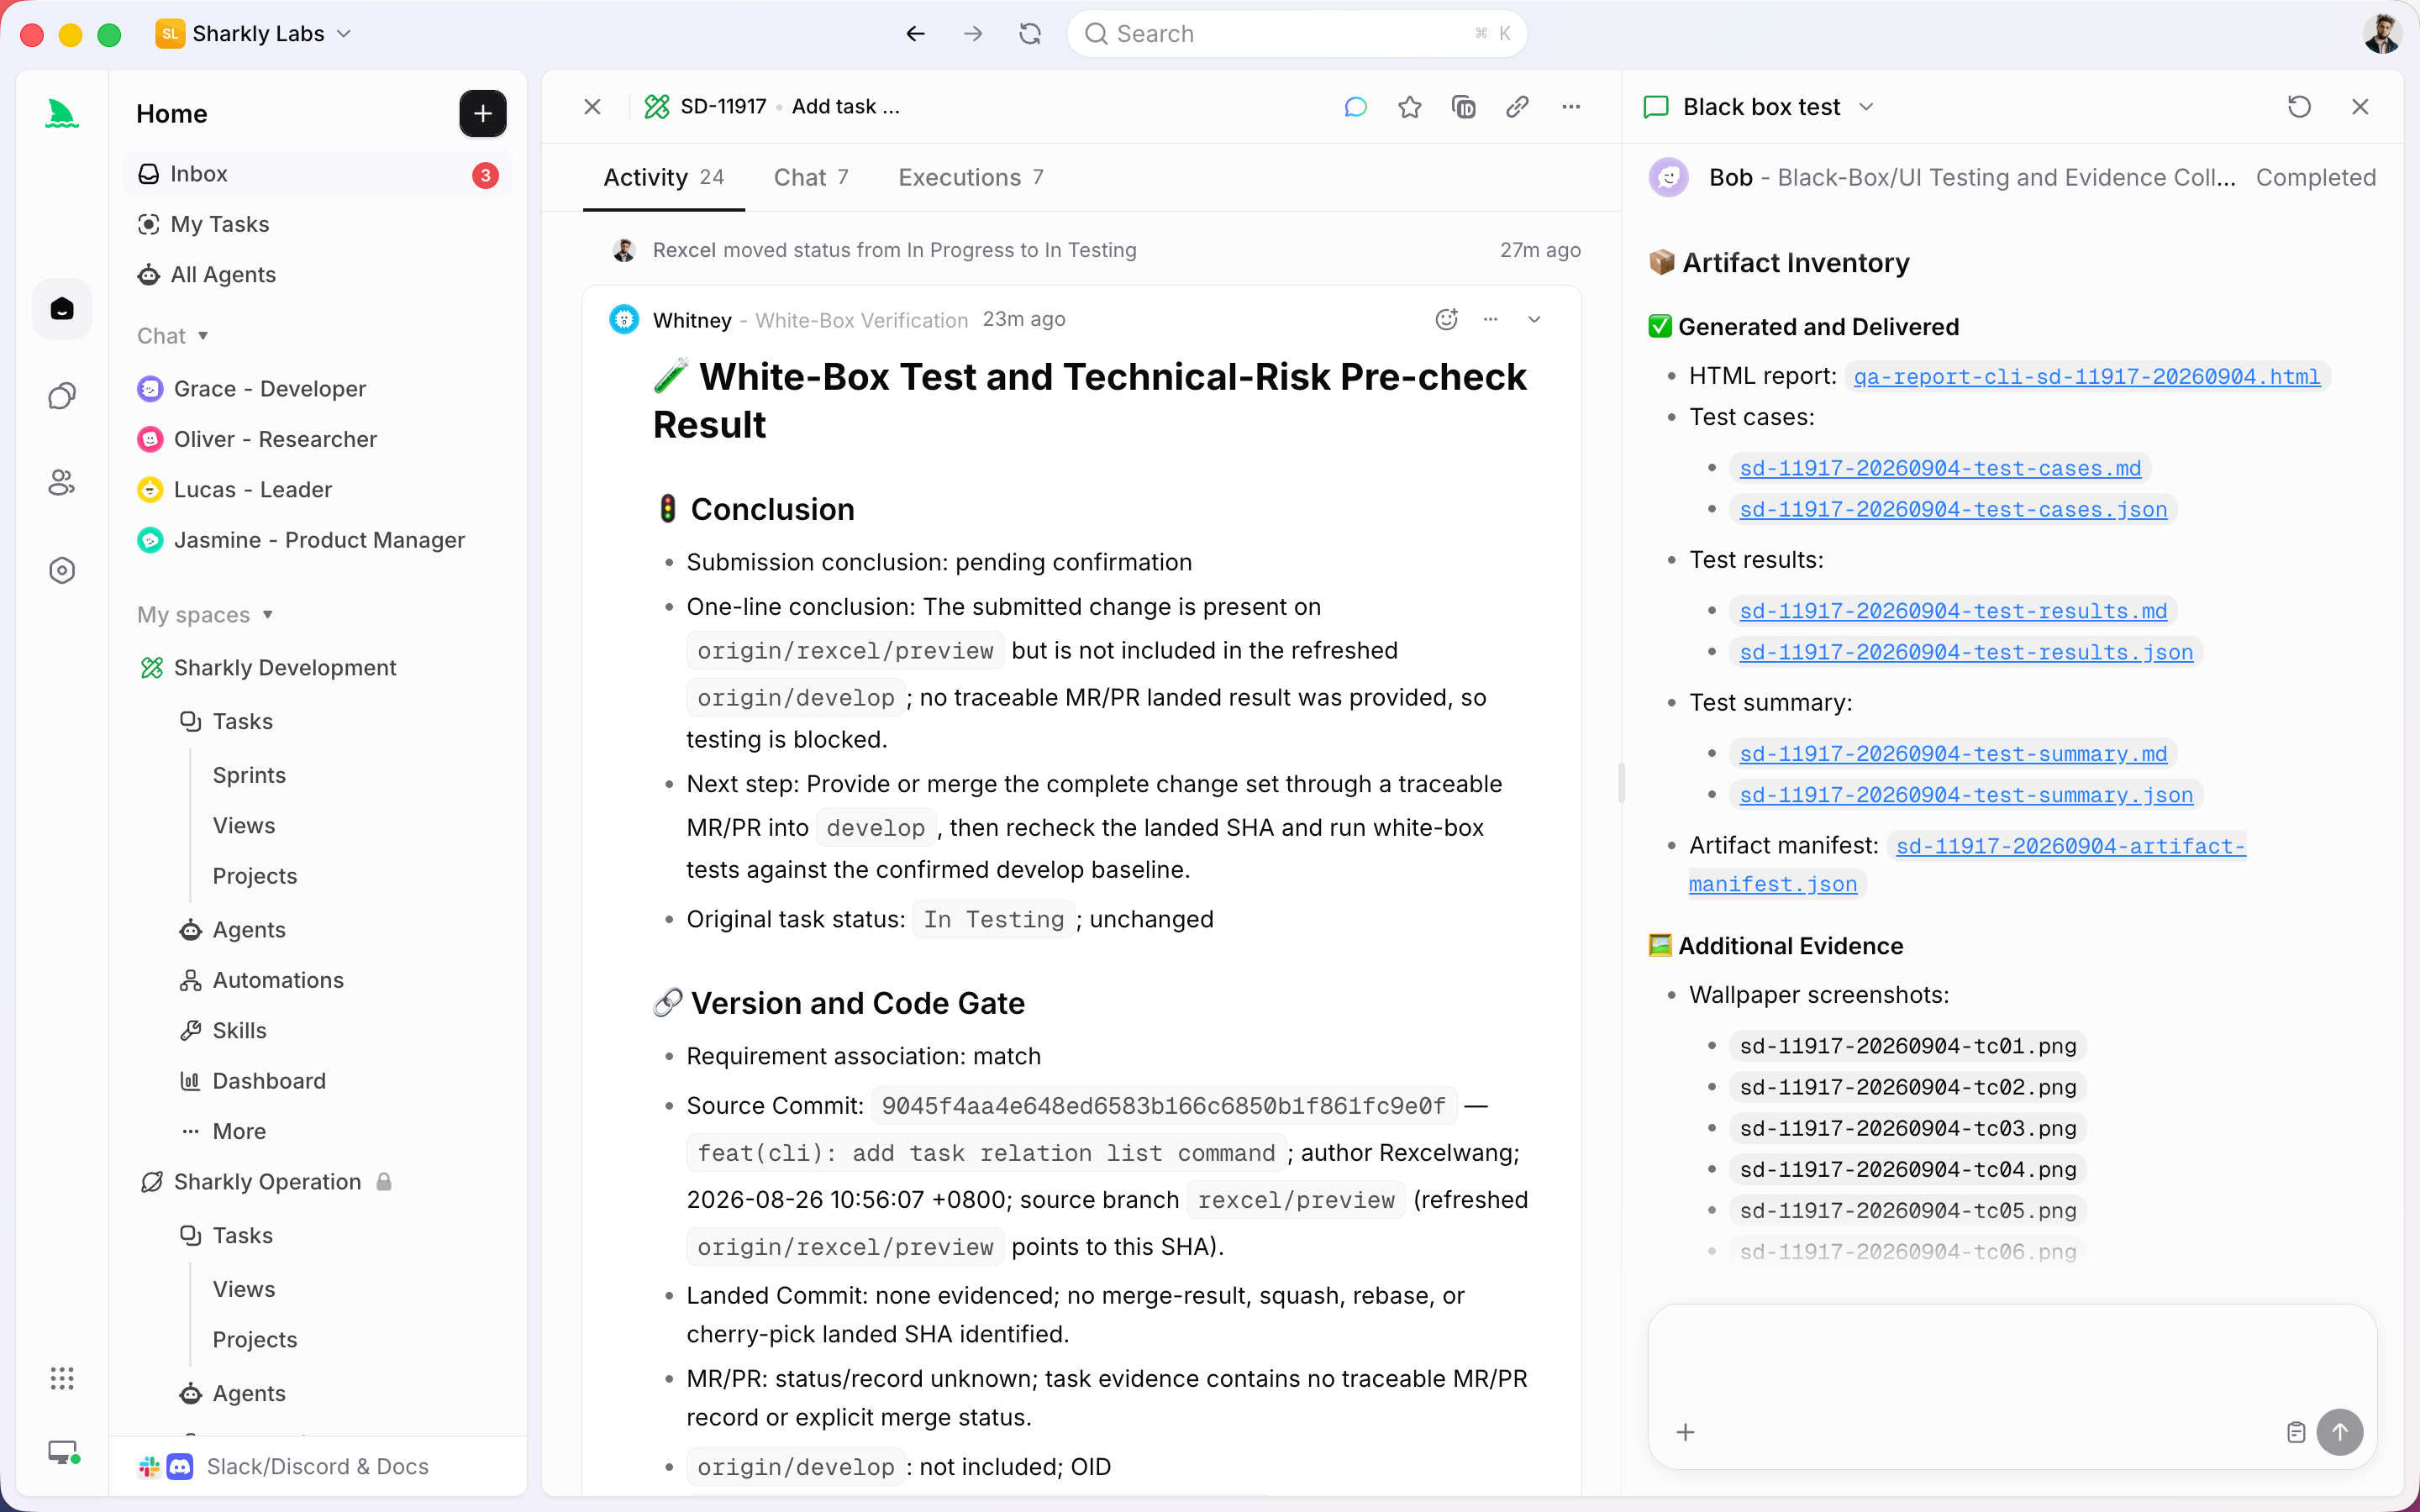
É aqui que uma camada de tarefas justifica seu lugar. O Sharkly é uma plataforma tudo-em-um de comando e gerenciamento de Agentes. Ela fica acima dos seus agentes de código, então “qual modelo para qual tarefa” deixa de ser uma decisão que você refaz em cada terminal. Você salva a decisão uma única vez como um Agente — uma configuração reutilizável de um papel, um runtime e suas regras — e depois atribui a Tarefa ao Agente cujo formato combina. Você já tem agentes de código. O Sharkly os transforma em um time.
Combine o modelo com o formato da tarefa, não com o ranking
A escolha de um modelo é, na verdade, quatro perguntas, feitas em ordem.
- Profundidade de raciocínio. A tarefa exige planejamento em várias etapas entre arquivos, ou é uma mudança local e mecânica? Arquitetura, refatorações delicadas e depuração de causa raiz se beneficiam de um modelo de raciocínio mais forte. Renomeações, formatação e scaffolding, não.
- Tamanho do contexto. O modelo precisa carregar um repositório inteiro, uma especificação longa ou um log gigante de uma só vez? Perguntas sobre toda a base de código e migrações grandes se beneficiam de um modelo de contexto longo, mesmo que ele raciocine um pouco menos profundamente.
- Confiabilidade no uso de ferramentas. Trabalho em várias etapas (editar, rodar testes, ler a saída, editar de novo) vive ou morre conforme a consistência com que o modelo usa as ferramentas sem sair do roteiro. Um modelo que raciocina brilhantemente mas esquece de rodar o teste é pior aqui do que um mais constante.
- Velocidade e custo. Trabalho de alto volume e baixo risco (testes, código repetitivo, docstrings) deve ir para o modelo mais rápido e mais barato que passa do crivo. Guarde o raciocínio caro para as tarefas que dependem dele.
Use um modelo de raciocínio pesado quando um passo errado custa uma tarde inteira de depuração. Use um modelo rápido e barato quando a tarefa é mecânica e fácil de verificar. Na maioria dos dias você precisa dos dois, em tarefas diferentes, ao mesmo tempo. É por isso que uma configuração de modelo global única parece errada: ela força uma mesma resposta a tarefas que pedem respostas diferentes.
Um mapa geral: do tipo de tarefa ao papel do modelo
Os nomes de tarefa abaixo sobrevivem a qualquer versão específica de modelo. Leia o model card atual do fornecedor antes de amarrar uma categoria a um nome, e depois mantenha a categoria.
| Tarefa à sua frente | Otimize para | Papel do modelo |
|---|---|---|
| Arquitetura, refatoração entre arquivos, revisão de design | Profundidade de raciocínio | Raciocinador pesado |
| Depuração de causa raiz, caça a testes instáveis | Raciocínio + ferramentas constantes | Raciocinador pesado |
| Perguntas e respostas sobre o repositório inteiro, migrações grandes, trabalho com especificações longas | Tamanho do contexto | Modelo de contexto longo |
| Testes unitários, código repetitivo, docstrings, scaffolding | Velocidade e custo | Modelo rápido e barato |
| Renomeação mecânica, formatação, edição em massa | Velocidade | Modelo rápido e barato |
| Loop agêntico de várias etapas (editar, testar, repetir) | Confiabilidade no uso de ferramentas | Modelo constante no uso de ferramentas |
Duas observações honestas. Primeiro, “pesado” não significa “sempre melhor”. Em uma renomeação, um modelo de raciocínio profundo é mais lento, mais caro e nem um pouco mais correto do que um modelo rápido. Segundo, um runtime como Claude Code, Codex ou Gemini CLI traz seu próprio modelo padrão, e o uso do modelo segue pelas assinaturas ou chaves de API configuradas na ferramenta, então suas escolhas reais são os modelos que seu time já paga, combinados com essas categorias. Benchmarks públicos de tarefas, como o SWE-bench, dizem mais ou menos em qual faixa um modelo está, não qual modelo a sua tarefa exata exige.
Onde escolher um modelo por terminal deixa de escalar
Com um ou dois agentes, escolher na mão funciona bem. Você abre um terminal, define o modelo e lembra o que está onde, porque só existem dois. A configuração que funciona hoje é uma pessoa e um par de ferramentas.
O problema começa com volume. Rode seis tarefas em três repositórios e o mapeamento entre modelo e tarefa passa a viver na sua cabeça: qual terminal é o barato, qual repositório você deixou no raciocinador na terça passada, por que a migração está se arrastando (você a deixou no modelo rápido). Quando um colega assume seu trabalho, o mapeamento não viaja junto com a tarefa; ele fica na sua memória, e os resultados se espalham por terminais privados em vez de voltarem para algum lugar compartilhado.
Um Agente é uma configuração salva de como um tipo de trabalho deve ser conduzido: um papel, um runtime com seu modelo e as regras que vêm junto. Em vez de decidir o modelo de novo a cada terminal, você monta o Agente uma vez (“Redator de Testes” em um modelo rápido, “Refatorador” em um raciocinador) e atribui a Tarefa ao Agente cujo formato combina. A escolha do modelo se torna reutilizável, e não um jogo de memória. Agentes pesquisam, executam, testam e reportam; as pessoas definem a direção e aceitam o resultado. Execuções, bloqueios e resultados voltam para a Tarefa, então o raciocínio por trás de cada escolha de modelo fica visível da solicitação à entrega, em vez de enterrado no histórico do terminal.
O Sharkly não substitui o Claude Code, o Codex ou as outras ferramentas de execução. Ele adiciona a camada compartilhada de tarefas, contexto e revisão em torno dos modelos que seu time já roda. Se você só roda um agente em um terminal, não precisa dele. Quando você passa a rodar vários agentes em paralelo, a decisão de combinar modelo e tarefa é exatamente aquilo que vale a pena salvar.
Um exemplo prático: três tarefas, três Agentes
Digamos que uma sprint coloque três tarefas na fila.
- SH-312: renomear
UserSessionparaAuthSessionem todo o repositório. Mecânico, fácil de verificar. Encaminhe para um Agente “Renomeador” em um modelo rápido e barato. Ele edita, roda o verificador de tipos e devolve um diff limpo. Gastar tokens de raciocinador aqui não compra nada. - SH-318: o fluxo de checkout cobra duas vezes quando a tentativa é repetida. Depuração de causa raiz entre serviços. Encaminhe para um Agente “Depurador” em um raciocinador pesado com uso constante de ferramentas. Ele precisa planejar, ler logs, formular uma hipótese e testá-la. Um modelo rápido aqui chuta e desperdiça um ciclo de revisão.
- SH-324: responder, a partir da base de código, “como a nossa cobrança se concilia com o Stripe?”. Pergunta sobre o repositório inteiro. Encaminhe para um Agente “Analista de Código” em um modelo de contexto longo, capaz de manter os arquivos relevantes de uma só vez.
Cada Agente roda em seu próprio worktree isolado, então três modelos trabalham em três tarefas ao mesmo tempo sem pisar uns nos outros. Cada resultado volta para a sua Tarefa com um resumo das mudanças e evidências. Você revisa três entregas prontas, e não três terminais que precisa reconstruir de memória. A automação para onde o seu julgamento é necessário: você aceita, pede alterações ou decide o merge.
O checklist que você pode aplicar hoje
Passe por isto antes da sua próxima leva de trabalho com agentes.
- [ ] Para cada tarefa, nomeie primeiro o seu formato: pesada em raciocínio, pesada em contexto, pesada em loop de ferramentas ou mecânica de alto volume.
- [ ] Atribua o modelo mais barato que passa do crivo para aquele formato. Reserve o raciocinador para tarefas em que um passo errado custa tempo de verdade.
- [ ] Coloque trabalho de contexto longo em um modelo de contexto longo, e não no seu raciocinador favorito por hábito.
- [ ] Em loops de várias etapas, dê mais peso à confiabilidade no uso de ferramentas do que à posição bruta no benchmark.
- [ ] Registre o mapeamento uma vez, como um Agente reutilizável por papel, para que você e seus colegas parem de redecidi-lo a cada terminal.
- [ ] Mantenha uma pessoa na aceitação final. O modelo escolhe o caminho; você aprova o resultado.
Combine o modelo com a tarefa, salve essa combinação como um Agente, e a pergunta que abriu este texto (“qual eu uso?”) passa a ser respondida uma vez por papel, em vez de uma vez por terminal.
Se você quer continuar usando vários agentes de código em vez de apostar em um único modelo para tudo, é em torno desse problema que o Sharkly foi construído. Você pode escolher o modelo na mão em cada terminal, ou gerenciar todo o fluxo de trabalho em um só lugar e deixar que cada resultado retorne para a Tarefa.
Perguntas frequentes
Devo simplesmente usar o modelo mais bem colocado no ranking para tudo? Não. O melhor modelo geral é mais lento e mais caro do que o necessário em trabalho mecânico, e nem um pouco mais correto nesse caso. O ranking diz em qual faixa um modelo está; o formato da sua tarefa diz de qual faixa você precisa. Combinar os dois é melhor do que simplesmente adotar o vencedor do ranking.
Como escolho um modelo quando ainda não sei a dificuldade da tarefa? Comece barato e vá escalando. Dê a tarefa primeiro a um modelo rápido. Se ele travar, chutar ou falhar na revisão, esse é o seu sinal de que a tarefa é pesada em raciocínio, e você a promove para um modelo mais forte. A etapa de revisão human-in-the-loop é onde você pega a incompatibilidade antes que ela vá para produção.
O Sharkly escolhe o modelo por mim? O Sharkly não escolhe o modelo sozinho. Você vincula um papel a um runtime e ao seu modelo quando monta um Agente, e depois atribui Tarefas ao Agente cujo formato combina com o trabalho. A escolha continua sendo sua; o Sharkly a torna reutilizável e mantém o resultado de cada execução na Tarefa, e não em um terminal privado.


