
coding agent ของคุณเขียน service ได้ รีแฟกเตอร์โมดูลได้ และอธิบาย stack trace ได้ แต่พอถามว่าคนพูดถึงการอัปเดตไลบรารีเมื่อสัปดาห์ที่แล้วว่าอย่างไร มันกลับเงียบ หรือสั่งให้สรุปทอล์กจากงานคอนเฟอเรนซ์ มันก็เข้าไม่ถึงทรานสคริปต์ ข้อมูลที่ agent ต้องการมากที่สุดกลับอยู่ในแพลตฟอร์มที่คิดค่าเข้าถึง หรือไม่ก็ปิดกั้นไม่ให้เข้าถึง
Agent-Reach เป็น CLI ตัวเดียวที่เลี่ยงข้อจำกัดเหล่านั้น และด้วยดาว 77,134 ดวง จึงเป็นคำตอบที่มีคนนำไปใช้มากที่สุดสำหรับปัญหานี้ มันแก้เรื่องการอ่านได้ แต่ไม่ได้แก้เรื่องสิ่งที่เกิดขึ้นกับข้อมูลที่ agent อ่านมา ซึ่งเป็นส่วนที่ทำให้ทีมเสียเวลาจริง ๆ
TL;DR
นี่คือหนึ่งในห้าบทวิเคราะห์เจาะลึกจากบทความรวบรวม เครื่องมือโอเพนซอร์สที่ต่อยอดความสามารถของ coding agent ของเรา
Agent-Reach เชื่อมต่อ agent ทุกตัวที่รันคำสั่ง shell ได้ เข้ากับ X, Reddit, YouTube, GitHub, RSS, Bilibili, XiaoHongShu, Facebook, Instagram, พอดแคสต์ และการค้นหาเว็บทั่วไป โดยใช้ช่องทางเข้าถึงฟรีแทน API แบบเสียเงินของแพลตฟอร์ม ทุกแพลตฟอร์มทำงานผ่าน backend หลักที่มีตัวสำรองไว้ ดังนั้นเมื่อช่องทางใดใช้ไม่ได้ ทาง upstream จะสลับให้เองโดยที่คุณไม่ต้องทำอะไร เริ่มจากแพลตฟอร์มที่ไม่ต้องตั้งค่าอะไร แล้วค่อยศึกษาข้อกำหนดก่อนเชื่อมต่อตัวที่ใช้คุกกี้ และหาที่เก็บผลงานค้นคว้าที่ไม่ใช่แค่การเลื่อนดูย้อนหลังในเทอร์มินัล
อุปสรรคที่มันเข้ามาแก้
แต่ละแพลตฟอร์มมีอุปสรรคของตัวเอง และวิธีเลี่ยงแต่ละอย่างก็กลายเป็นโปรเจกต์เชื่อมต่อเล็ก ๆ แยกกันไป:
| แพลตฟอร์ม | อุปสรรค | การตั้งค่าใน Agent-Reach |
|---|---|---|
| Twitter/X | API แบบเสียเงิน ประมาณ 215 ดอลลาร์ต่อเดือนหากใช้ในระดับปานกลาง | คุกกี้จากเบราว์เซอร์ |
| IP ของเซิร์ฟเวอร์ถูกบล็อกจาก endpoint ที่ไม่ต้องล็อกอิน | เซสชันเบราว์เซอร์หรือคุกกี้ | |
| YouTube | ไม่เปิดให้เข้าถึงทรานสคริปต์ | ไม่ต้องตั้งค่า |
| GitHub | ต้องยืนยันตัวตนหากอ่านเกินกว่าข้อมูลสาธารณะ | ไม่ต้องตั้งค่า ใช้ gh auth login หากต้องการมากกว่านั้น |
| หน้าเว็บ | ขยะจาก markup | ไม่ต้องตั้งค่า |
| การค้นหาเว็บ | คีย์ API | ตั้งค่าให้อัตโนมัติตอนติดตั้ง |
ถ้าคุณต่อแพลตฟอร์มเองห้าตัว คุณก็จะได้ของที่พังแยกกันห้าอย่าง ข้อเสนอของที่นี่คือติดตั้งครั้งเดียว แล้วหลังจากนั้นก็ลืมมันไปได้เลย
การติดตั้ง
วิธีติดตั้งค่อนข้างแปลกกว่าปกติ คือคุณส่ง URL เอกสารให้ agent แทนที่จะรันคำสั่งเอง
Install Agent Reach: https://raw.githubusercontent.com/Panniantong/agent-reach/main/docs/install.md
agent จะติดตั้งแพ็กเกจ Python ตรวจสอบสภาพแวดล้อม และรายงานว่าอะไรพร้อมใช้บ้าง ค่าเริ่มต้นเป็นแบบอ่านอย่างเดียว และการเปลี่ยนแปลงระดับระบบต้องระบุแฟล็กอย่างชัดเจน
pip install https://github.com/Panniantong/agent-reach/archive/main.zip
agent-reach install --env=auto
agent-reach doctor
agent-reach doctor จะแสดงว่าอะไรใช้ได้ อะไรใช้ไม่ได้ และต้องแก้แต่ละอย่างอย่างไร สำหรับเครื่องมือที่ต้องพึ่งการเข้าถึงของบุคคลที่สามซึ่งเปราะบางโดยธรรมชาติ การมีคำสั่งตรวจสอบสุขภาพมาให้เป็นคำสั่งหลักถือเป็นสัญชาตญาณที่ถูกต้อง
การตัดสินใจด้านดีไซน์ที่ควรค่าแก่การลอกเลียนแบบ
ใครก็ห่อ scraper ได้ แต่เหตุผลที่โปรเจกต์นี้ยืนระยะได้คือห่วงโซ่ตัวสำรอง ทุกแพลตฟอร์มมี backend หลักและรายการทางเลือกที่เรียงลำดับไว้ พอช่องทางใดตายไป ทางโปรเจกต์ก็สลับค่าเริ่มต้นและปล่อยอัปเดตให้ ตัวอย่างที่พวกเขาเล่าเองคือ Bilibili เริ่มคืนค่า error 412 ให้ backend ตัวหนึ่งในเดือนมิถุนายน 2026 โดยที่ผู้ใช้ไม่รู้สึกอะไรเลย
นั่นช่วยป้องกันรูปแบบความล้มเหลวที่ฆ่าเวอร์ชันทำเองในบ้าน scraper ของคุณใช้งานได้สี่เดือน แล้วพังในวันอังคาร และคุณจะรู้ตัวก็ตอนที่ agent รายงานอย่างมั่นใจว่าหัวข้อนี้ไม่มีการพูดถึงเลย แทนที่จะบอกว่าดึงข้อมูลไม่สำเร็จ agent ที่แยกไม่ออกระหว่างผลลัพธ์ว่างเปล่ากับคำขอที่ล้มเหลว จะพูดทั้งสองอย่างด้วยความมั่นใจเท่ากัน
จุดที่โมเดลการเข้าถึงฟรีต้องตัดสินใจ
แพลตฟอร์มที่ไม่ต้องตั้งค่าไม่มีความซับซ้อนอะไร ก็แค่ API สาธารณะ, GitHub CLI อย่างเป็นทางการ, RSS และผู้ให้บริการค้นหาที่อยากได้ทราฟฟิก
แพลตฟอร์มที่ใช้คุกกี้เป็นอีกประเด็นหนึ่ง การอ่าน X, Reddit หรือ Instagram ผ่านเซสชันที่คุณล็อกอินอยู่เองไม่ใช่ช่องทาง API ที่ได้รับอนุญาต ตัวโปรเจกต์จัดการเรื่องนี้อย่างมีความรับผิดชอบ โดยเก็บคุกกี้ไว้ในเครื่องและไม่อัปโหลดขึ้นที่ไหน และมันเป็นโอเพนซอร์ส คุณจึงตรวจสอบได้ สิ่งที่มันทำไม่ได้คือเปลี่ยนข้อกำหนดที่คุณตกลงไว้กับบัญชีเหล่านั้น
ใช้มันเพื่องานค้นคว้าส่วนตัวบนบัญชีของคุณเอง ซึ่งเป็นเหตุผลที่คนส่วนใหญ่ติดตั้งมัน อย่าลืมอ่านข้อกำหนดที่เกี่ยวข้องก่อนนำไปใช้เชิงพาณิชย์ และใช้บัญชีที่คุณยอมเสียได้ อย่าถือว่าการเข้าถึงแบบไม่เป็นทางการเป็นฟีดข้อมูลสำหรับงานโปรดักชัน
งานค้นคว้าเป็นงานระยะยาว และงานระยะยาวต้องมี Task
นี่คือปัญหาที่จะโผล่มาในสัปดาห์ที่สอง และมันไม่ใช่ปัญหาเชิงเทคนิค
การค้นคว้าแต่ละรอบใช้เวลานาน agent ที่ค้นหาใน X, Reddit, Hacker News และ GitHub สองชั่วโมงย่อมได้ของมีค่า ไม่ว่าจะเป็นแหล่งอ้างอิง คำพูด วันที่ ลิงก์ และบทสรุป จากนั้นเซสชันก็จบลง เพื่อนร่วมงานถามว่าข้อกล่าวอ้างนั้นมาจากไหน แต่กลับตอบไม่ได้ ยิ่งแย่กว่านั้นคือ เดือนถัดมามีคนรันการค้นคว้าเดิมซ้ำอีกเพราะไม่มีใครรู้ว่ามันมีอยู่แล้ว
Task คือหน่วยหลักของงานใน Sharkly มันเก็บคำขอ บริบท การทำงาน และผลลัพธ์ไว้ในที่เดียวที่แชร์ร่วมกัน แทนที่จะแยกกระจายไปตามพรอมป์ส่วนตัวและเซสชันเทอร์มินัล การทำงาน อุปสรรค ผลลัพธ์ และการพูดคุยติดตามผลจะกลับไปอยู่ในไทม์ไลน์ของ task แหล่งอ้างอิงจึงยังอยู่ครบแม้ผ่านไปถึงไตรมาสหน้า
มีสามส่วนของโมเดลนี้ที่สำคัญเป็นพิเศษต่องานค้นคว้า
Agent คือการตั้งค่าที่บันทึกไว้ ทั้งคำสั่ง runtime สกิล รีโพซิทอรี และสภาพแวดล้อม ชุดการค้นคว้าที่คุณปรับจูนไว้ครั้งเดียว รวมถึงข้อกำหนดว่าให้เข้าถึงแพลตฟอร์มไหนได้บ้าง จะถูกนำกลับมาใช้ซ้ำ ไม่ต้องสร้างใหม่
Computer เป็นผู้จัดหาโฮสต์และทรัพยากรในเครื่อง ส่วน Runtime เป็นตัวรันเซสชันบนนั้น เรื่องนี้ไม่ใช่แค่แนวคิดนามธรรม เพราะแพลตฟอร์มที่ใช้คุกกี้ของ Agent-Reach ต้องใช้เบราว์เซอร์ที่ล็อกอินอยู่จริงบนเครื่องที่ระบุไว้ ดังนั้นการเลือกว่าจะรันงานค้นคว้าบน Computer ตัวไหนจึงเป็นการตัดสินใจเชิงปฏิบัติจริง ไม่ใช่แค่ใช้แล็ปท็อปเครื่องไหนที่บังเอิญเปิดอยู่
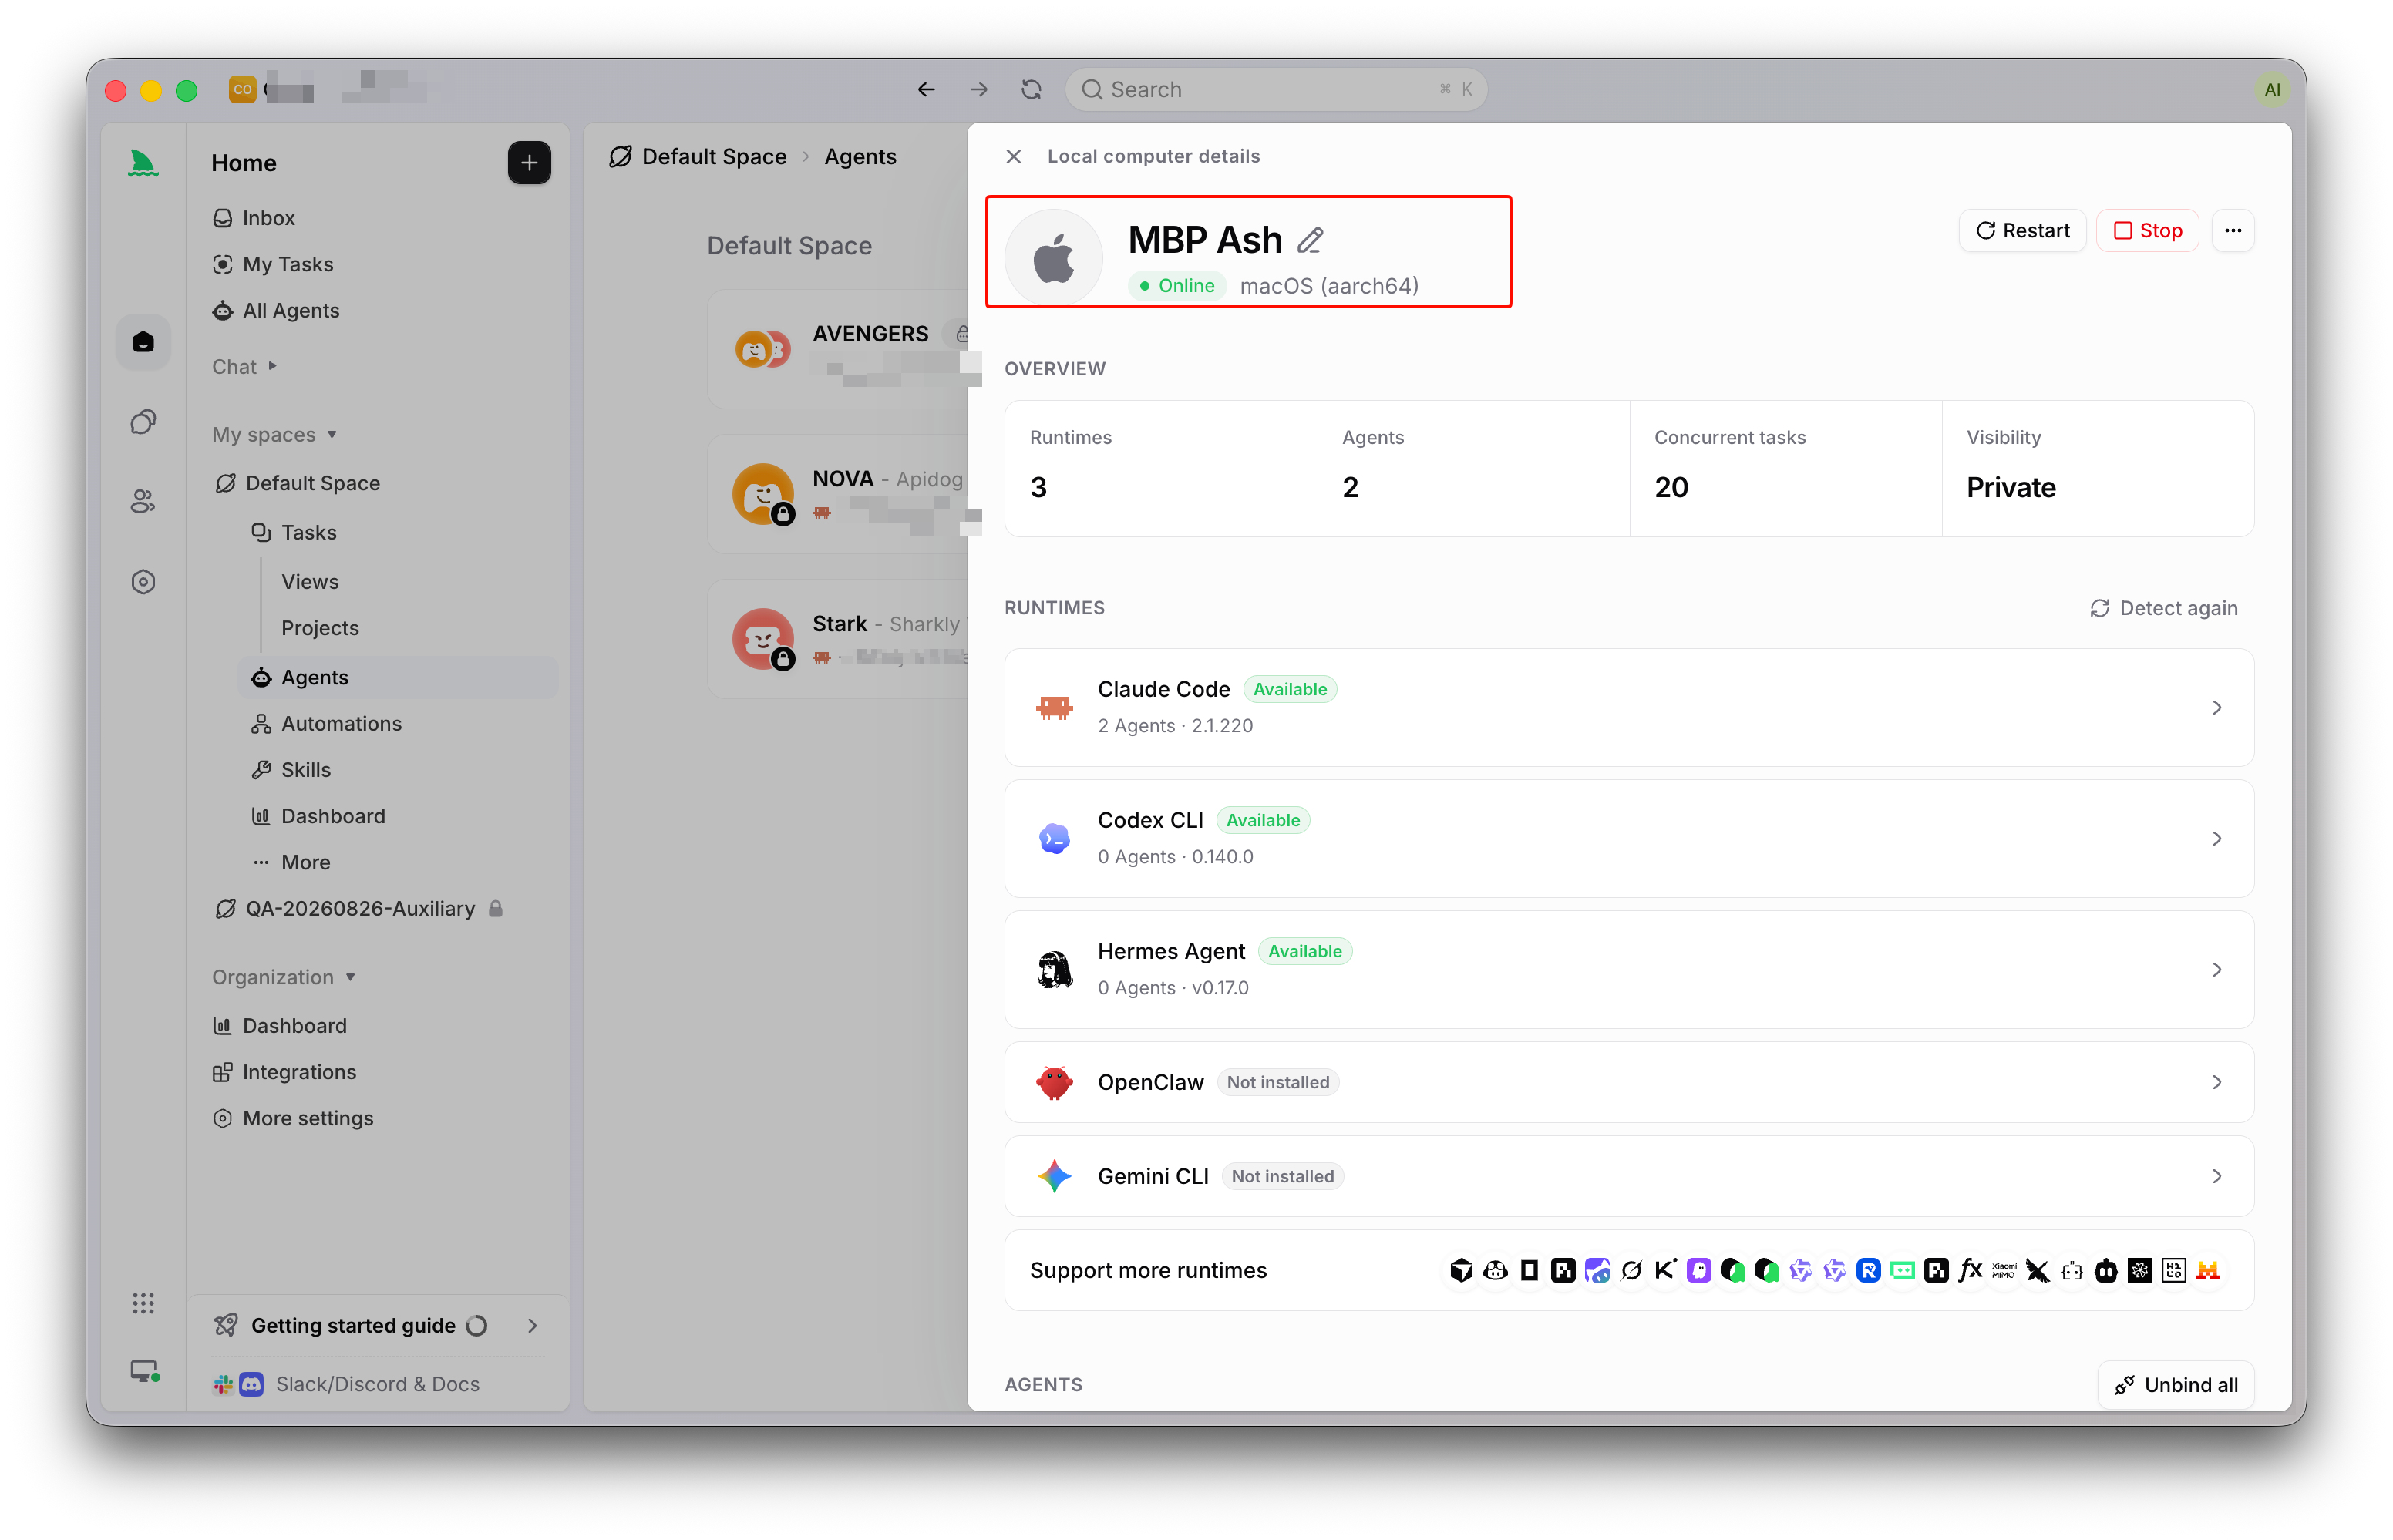
Task ที่อยู่ในสถานะ Backlog จะไม่เริ่มรันทันที คุณสามารถจัดคิวหัวข้อค้นคว้าไว้ได้ทันทีที่นึกออก โดยไม่ต้องเปลืองโควตาการใช้งานในวินาทีที่จดมันลงไป
Sharkly ไม่ใช่ตัวแทนที่มาแทน Agent-Reach หรือเครื่องมือเขียนโค้ดที่รันมันอยู่ แต่เข้ามาเพิ่มชั้นของ task ที่แชร์ร่วมกัน, Computer, บริบท, การควบคุม และการรีวิวให้กับทั้งคู่
ใช้มันโดยตรง หรือให้ที่สำหรับรายงานผล
ใช้ Agent-Reach เดี่ยว ๆ เมื่อคุณต้องการหาคำตอบให้ตัวเองในวันนี้ ติดตั้ง ถาม อ่าน แล้วไปต่อ ไม่จำเป็นต้องมีอะไรเพิ่ม
ใช้ระบบทำงานแบบแชร์ร่วมกันเมื่อผลการค้นคว้าจะไปประกอบการตัดสินใจของคนอื่น เมื่อข้อกล่าวอ้างจะไปอยู่ในเอกสารหรือบทสนทนากับลูกค้า หรือเมื่อการค้นคว้าเดียวกันนั้นอาจถูกทำซ้ำโดยเพื่อนร่วมงานที่ไม่รู้ว่ามันมีอยู่แล้ว
ไม่ว่าจะทางไหน ก็มีวินัยหนึ่งข้อที่ต้องยึด ให้ถือว่าทุกสิ่งที่ค้นเจอยังไม่ได้รับการยืนยันจนกว่าจะมีคนเปิดลิงก์นั้นดูด้วยตัวเอง agent อ่านโพสต์ที่อ้างผลการทดสอบ benchmark ได้ แต่บอกคุณไม่ได้ว่า benchmark นั้นเป็นของจริงหรือเปล่า agent ค้นคว้า ลงมือทำ ทดสอบ และรายงาน ส่วนคนเป็นผู้กำหนดทิศทาง ให้อำนาจ และรับผลลัพธ์
คำถามที่พบบ่อย
Agent-Reach ใช้กับ agent ตัวไหนได้บ้าง? ใช้ได้กับ agent ทุกตัวที่รันคำสั่ง shell ได้ เช่น Claude Code, Cursor, Windsurf, OpenClaw และ Codex โดย OpenClaw ต้องเปิดสิทธิ์ exec ก่อน เพราะโปรไฟล์การส่งข้อความเริ่มต้นไม่สามารถรันคำสั่งได้
ใช้งานฟรีจริงไหม? เครื่องมือเป็นโอเพนซอร์สและช่องทางเข้าถึงไม่คิดค่าใช้จ่าย พร็อกซีบนเซิร์ฟเวอร์มีค่าใช้จ่ายประมาณเดือนละหนึ่งดอลลาร์หาก IP ของเครื่องคุณถูกบล็อก ส่วนเครื่องในเครื่องคุณไม่ต้องใช้พร็อกซี การไม่มีค่าใช้จ่ายจากผู้ให้บริการไม่ได้หมายความว่าไม่มีข้อกำหนดการให้บริการที่ต้องคำนึงถึง
คุกกี้ของฉันปลอดภัยไหม? ทางโปรเจกต์ระบุว่าคุกกี้จะอยู่ในเครื่องเท่านั้นและไม่ถูกอัปโหลดขึ้นที่ไหน และโค้ดต้นทางก็เปิดให้ตรวจสอบได้ ความเสี่ยงจริง ๆ ไม่ใช่การถูกขโมยข้อมูล แต่เป็นการที่บัญชีของคุณถูกจำกัดอัตราการใช้งานหรือถูกแพลตฟอร์มตั้งธง
มันจะพังเมื่อแพลตฟอร์มเปลี่ยนไหม? พังได้ และทางโปรเจกต์ก็วางแผนรองรับไว้แล้ว ทุกแพลตฟอร์มมีตัวสำรอง และทางโปรเจกต์จะสลับค่าเริ่มต้นให้ที่ระดับ upstream ให้รัน agent-reach doctor เมื่อมีอะไรดูไม่ปกติ
แล้วเข้ากับการรัน agent หลายตัวพร้อมกันได้อย่างไร? งานค้นคว้าและงานเขียนโค้ดทำงานขนานกันได้ดี และ Task run แต่ละครั้งจะมี worktree แยกอิสระ ของตัวเอง จึงไม่ชนกัน แล้วผลที่ได้ก็กลับไปอยู่ใน Task ของตัวเอง
สรุปแบบสั้น
Agent-Reach ลบข้อจำกัดที่มีอยู่จริง agent ที่อ่านบทสนทนาจริงรอบ ๆ ไลบรารีได้ ดูทอล์กได้ และเช็ก issue tracker ได้ ย่อมตอบคำถามได้ดีกว่า agent ที่ทำงานจากข้อมูลที่ตัดที่จุดสิ้นสุดการเทรน และการออกแบบตัวสำรองก็ทำให้มันยังใช้งานได้แม้จะเกิดความเสียหายที่หลีกเลี่ยงไม่ได้
ติดตั้งเพื่อใช้กับแพลตฟอร์มที่ไม่ต้องตั้งค่าก่อน แล้วค่อยคิดให้ดีก่อนเชื่อมต่อคุกกี้ จากนั้นก็ตัดสินใจว่าผลการค้นคว้าจะไปไว้ที่ไหน งานค้นคว้าที่อยู่แค่ในประวัติการเลื่อนดูย้อนหลังจะถูกทำซ้ำ Sharkly ดูแลอีกครึ่งที่เหลือ: Task คือบันทึกที่แชร์ร่วมกัน การทำงานรันบน Computer ที่คุณเชื่อมต่อ และผลลัพธ์ก็กลับมาอยู่ในที่ที่คนสามารถรีวิวได้


