
คุณต่อเอเจนต์รีวิวโค้ด AI เข้ากับไปป์ไลน์ และมันก็ทำงานได้จริง มันตีธง null check ที่หายไป จับ unused import ได้ และทิ้งคอมเมนต์เรียบร้อย ๆ สามอันเกี่ยวกับการตั้งชื่อ คุณ merge ผ่านไป สองวันต่อมา ลูกค้าเจอบั๊กที่เอเจนต์อ่านผ่านไปเฉย ๆ: การเปลี่ยนแปลงนั้นสะอาดในตัวเอง แต่ทำในสิ่งที่ผิด เอเจนต์รีวิวตรวจสอบโค้ดได้ แต่ตรวจสอบเจตนาไม่ได้
ช่องว่างตรงนี้คือเรื่องทั้งหมดของเอเจนต์รีวิวโค้ด AI พวกมันเก่งกับปัญหากลุ่มหนึ่งที่เฉพาะเจาะจงและตรวจสอบได้ และมองไม่เห็นปัญหาอีกกลุ่มหนึ่งที่หน้าตาเหมือนกันเป๊ะใน diff ถ้าคุณถือว่าการอนุมัติของมันคือการ accept คุณก็จะปล่อยปัญหากลุ่มที่มองไม่เห็นนั้นออกไป แต่ถ้ารู้ว่าเส้นแบ่งอยู่ตรงไหน คุณจะได้ first pass ที่รวดเร็วซึ่งปลดปล่อยนักรีวิวของคุณไปทำงานตัดสินใจที่มีแต่คนเท่านั้นทำได้
บทความนี้จะตีเส้นแบ่งนั้นให้เห็น: เอเจนต์รีวิวโค้ด AI ตรวจสอบอะไรได้ ตรวจสอบอะไรไม่ได้ และโมเดลการทำงานที่ทำให้ทั้งสองอย่างไม่ปนกัน Sharkly คือเลเยอร์ที่เราจะพาไล่ดูไปด้วยกัน พื้นที่ทำงานร่วมกันที่การรีวิวของเอเจนต์และการ accept ของคนเป็นสถานะคนละอย่างบน Task เดียวกัน ไม่ใช่ตราประทับอันเดียว คุณมีเอเจนต์เขียนโค้ดอยู่แล้ว ประเด็นตรงนี้คือการรีวิวผลลัพธ์ของพวกมันโดยไม่แสร้งว่าเอเจนต์ตัวที่สองจะปิดวงจรให้
เอเจนต์รีวิวโค้ด AI ตรวจสอบอะไรได้บ้าง
เอเจนต์รีวิวโค้ด AI คือโปรแกรมที่อ่าน diff รันเช็คกับมัน แล้วรายงานสิ่งที่พบเหมือนที่นักรีวิวคนหนึ่งทิ้งคอมเมนต์ โซนที่มันเชื่อถือได้คือทุกอย่างที่นักรีวิวผู้พิถีพิถันยืนยันได้จากการอ่านการเปลี่ยนแปลงและโค้ดข้างเคียงโดยตรง:
- ความถูกต้องเชิงกลไก: syntax, types, การจัดการ null และขอบเขตที่ชัดเจน, promise rejection ที่ไม่ได้จัดการ, resource leak ที่มองเห็นได้ใน diff
- ตรรกะเฉพาะจุด: off-by-one error, เงื่อนไขกลับด้าน, กิ่งที่ตายแล้ว, การอ่านตัวแปรก่อนที่จะถูกกำหนดค่า
- ธรรมเนียมปฏิบัติ: การตั้งชื่อ, การจัดรูปแบบ, ความสะอาดของ import, ว่าฟังก์ชันใหม่มีเทสอยู่ข้าง ๆ หรือไม่
- แอนติแพตเทิร์นที่รู้จักกันดี: SQL ที่ประกอบขึ้นจาก string concatenation, ซีเคร็ตที่ commit แบบ plaintext, เมธอด public ที่ขาดการตรวจสอบ input
ทั้งหมดนี้มีลักษณะร่วมกันอย่างหนึ่ง หลักฐานอยู่ใน diff เอง เอเจนต์ไม่จำเป็นต้องรู้ธุรกิจของคุณก็จับสิ่งเหล่านี้ได้ และมันจับได้เร็วกว่าและสม่ำเสมอกว่ามนุษย์ที่เหนื่อยล้าตอนหกโมงเย็น นั่นคือคุณค่าจริง และเป็นเหตุผลที่ทีมเลือกใช้เครื่องมือแบบนี้ คู่มือรีวิวโค้ดของ Google มองว่าการตรวจรอบนี้เป็นพื้นฐานขั้นต่ำ เพื่อให้ความสนใจของคนไปลงที่การออกแบบได้ เอเจนต์รีวิวเป็นวิธีที่อดทนในการเคลียร์รอบนั้นให้ผ่านทุกครั้ง
สิ่งที่มันตรวจสอบไม่ได้
นี่คือเส้นแบ่ง พูดให้ตรง ๆ: เอเจนต์รีวิวโค้ด AI ตรวจสอบไม่ได้ว่าการเปลี่ยนแปลงนี้คือการเปลี่ยนแปลงที่ถูกต้อง ทุกอย่างข้างล่างนี้ต้องการบริบทที่ diff ไม่มี
- เจตนาเทียบกับสเปก โค้ดอาจไร้ที่ติและแก้ปัญหาผิดข้อ มีเพียงเกณฑ์การยอมรับของ ticket เท่านั้นที่ตัดสินเรื่องนี้ และเอเจนต์แทบไม่เคยเห็นมันอยู่ในสายตา
- ความถูกต้องทางธุรกิจ กฎส่วนลด การคำนวณภาษี หรือขอบเขตสิทธิ์ จะตรงกับวิธีที่บริษัททำงานจริงหรือไม่ เป็นการตัดสินใจ ไม่ใช่กฎ lint
- พฤติกรรมข้ามระบบ การเปลี่ยนแปลงที่อ่านแล้วดูดีในไฟล์หนึ่งสามารถทำลายผู้เรียกที่อยู่ห่างออกไปสามเซอร์วิสได้ OWASP Top Ten เต็มไปด้วยความล้มเหลวอย่าง broken access control ที่จะปรากฏขึ้นก็ต่อเมื่อคุณไล่ตามเส้นทางของ request ทั้งเส้น ไม่ใช่แค่ดู diff
- ว่าเทสซื่อสัตย์หรือไม่ เอเจนต์ยืนยันได้ว่าเทสมีอยู่และผ่าน แต่บอกคุณไม่ได้ว่าเทสยืนยันในสิ่งที่สำคัญจริง หรือเอเจนต์ที่เขียนโค้ดก็เขียนเทสที่จัดรูปรอให้ผ่านไว้แล้วด้วย
อย่างหลังนี่คือกับดักเฉพาะของโค้ดที่ AI เขียน เมื่อระบบประเภทเดียวกันสร้างทั้งการเปลี่ยนแปลงและการรีวิว diff ที่สะอาดกับเครื่องหมายถูกสีเขียวอาจเป็นจริงทั้งคู่ และไม่เกี่ยวกับประเด็นทั้งคู่ ดังนั้นการอนุมัติจากเอเจนต์รีวิวเป็นสัญญาณ ไม่ใช่การตัดสินใจ เอเจนต์รายงาน คนต่างหากที่ accept
โมเดลการทำงานที่ปิดช่องว่างนี้
ทางแก้ไม่ใช่เอเจนต์รีวิวที่ดีกว่า แต่เป็นโมเดลการทำงานที่งานของเอเจนต์รีวิวและงานของคนเป็นคนละสถานะ และไม่มีอันไหนถูกข้าม
Sharkly ทำให้สถานะเหล่านี้ชัดเจนในรูปของ สถานะของ Task Task เคลื่อนจาก In progress ไป Ready for review ไป Done กฎนี้ง่ายและเป็นตัวรับน้ำหนักทั้งหมด: เอเจนต์เลื่อนงานไปที่ Ready for review; คนเป็นผู้เลื่อนไปที่ Done เอเจนต์ ไม่ว่าจะเป็นตัวที่เขียนโค้ดหรือตัวที่รีวิว มาร์กงานของตัวเองว่า accept ไม่ได้เลย เอเจนต์ค้นคว้า ลงมือ ทำเทส และรายงาน คนกำหนดทิศทาง มอบอำนาจ และ accept ผลลัพธ์ ระบบอัตโนมัติหยุดตรงจุดที่ต้องใช้วิจารณญาณของทีม
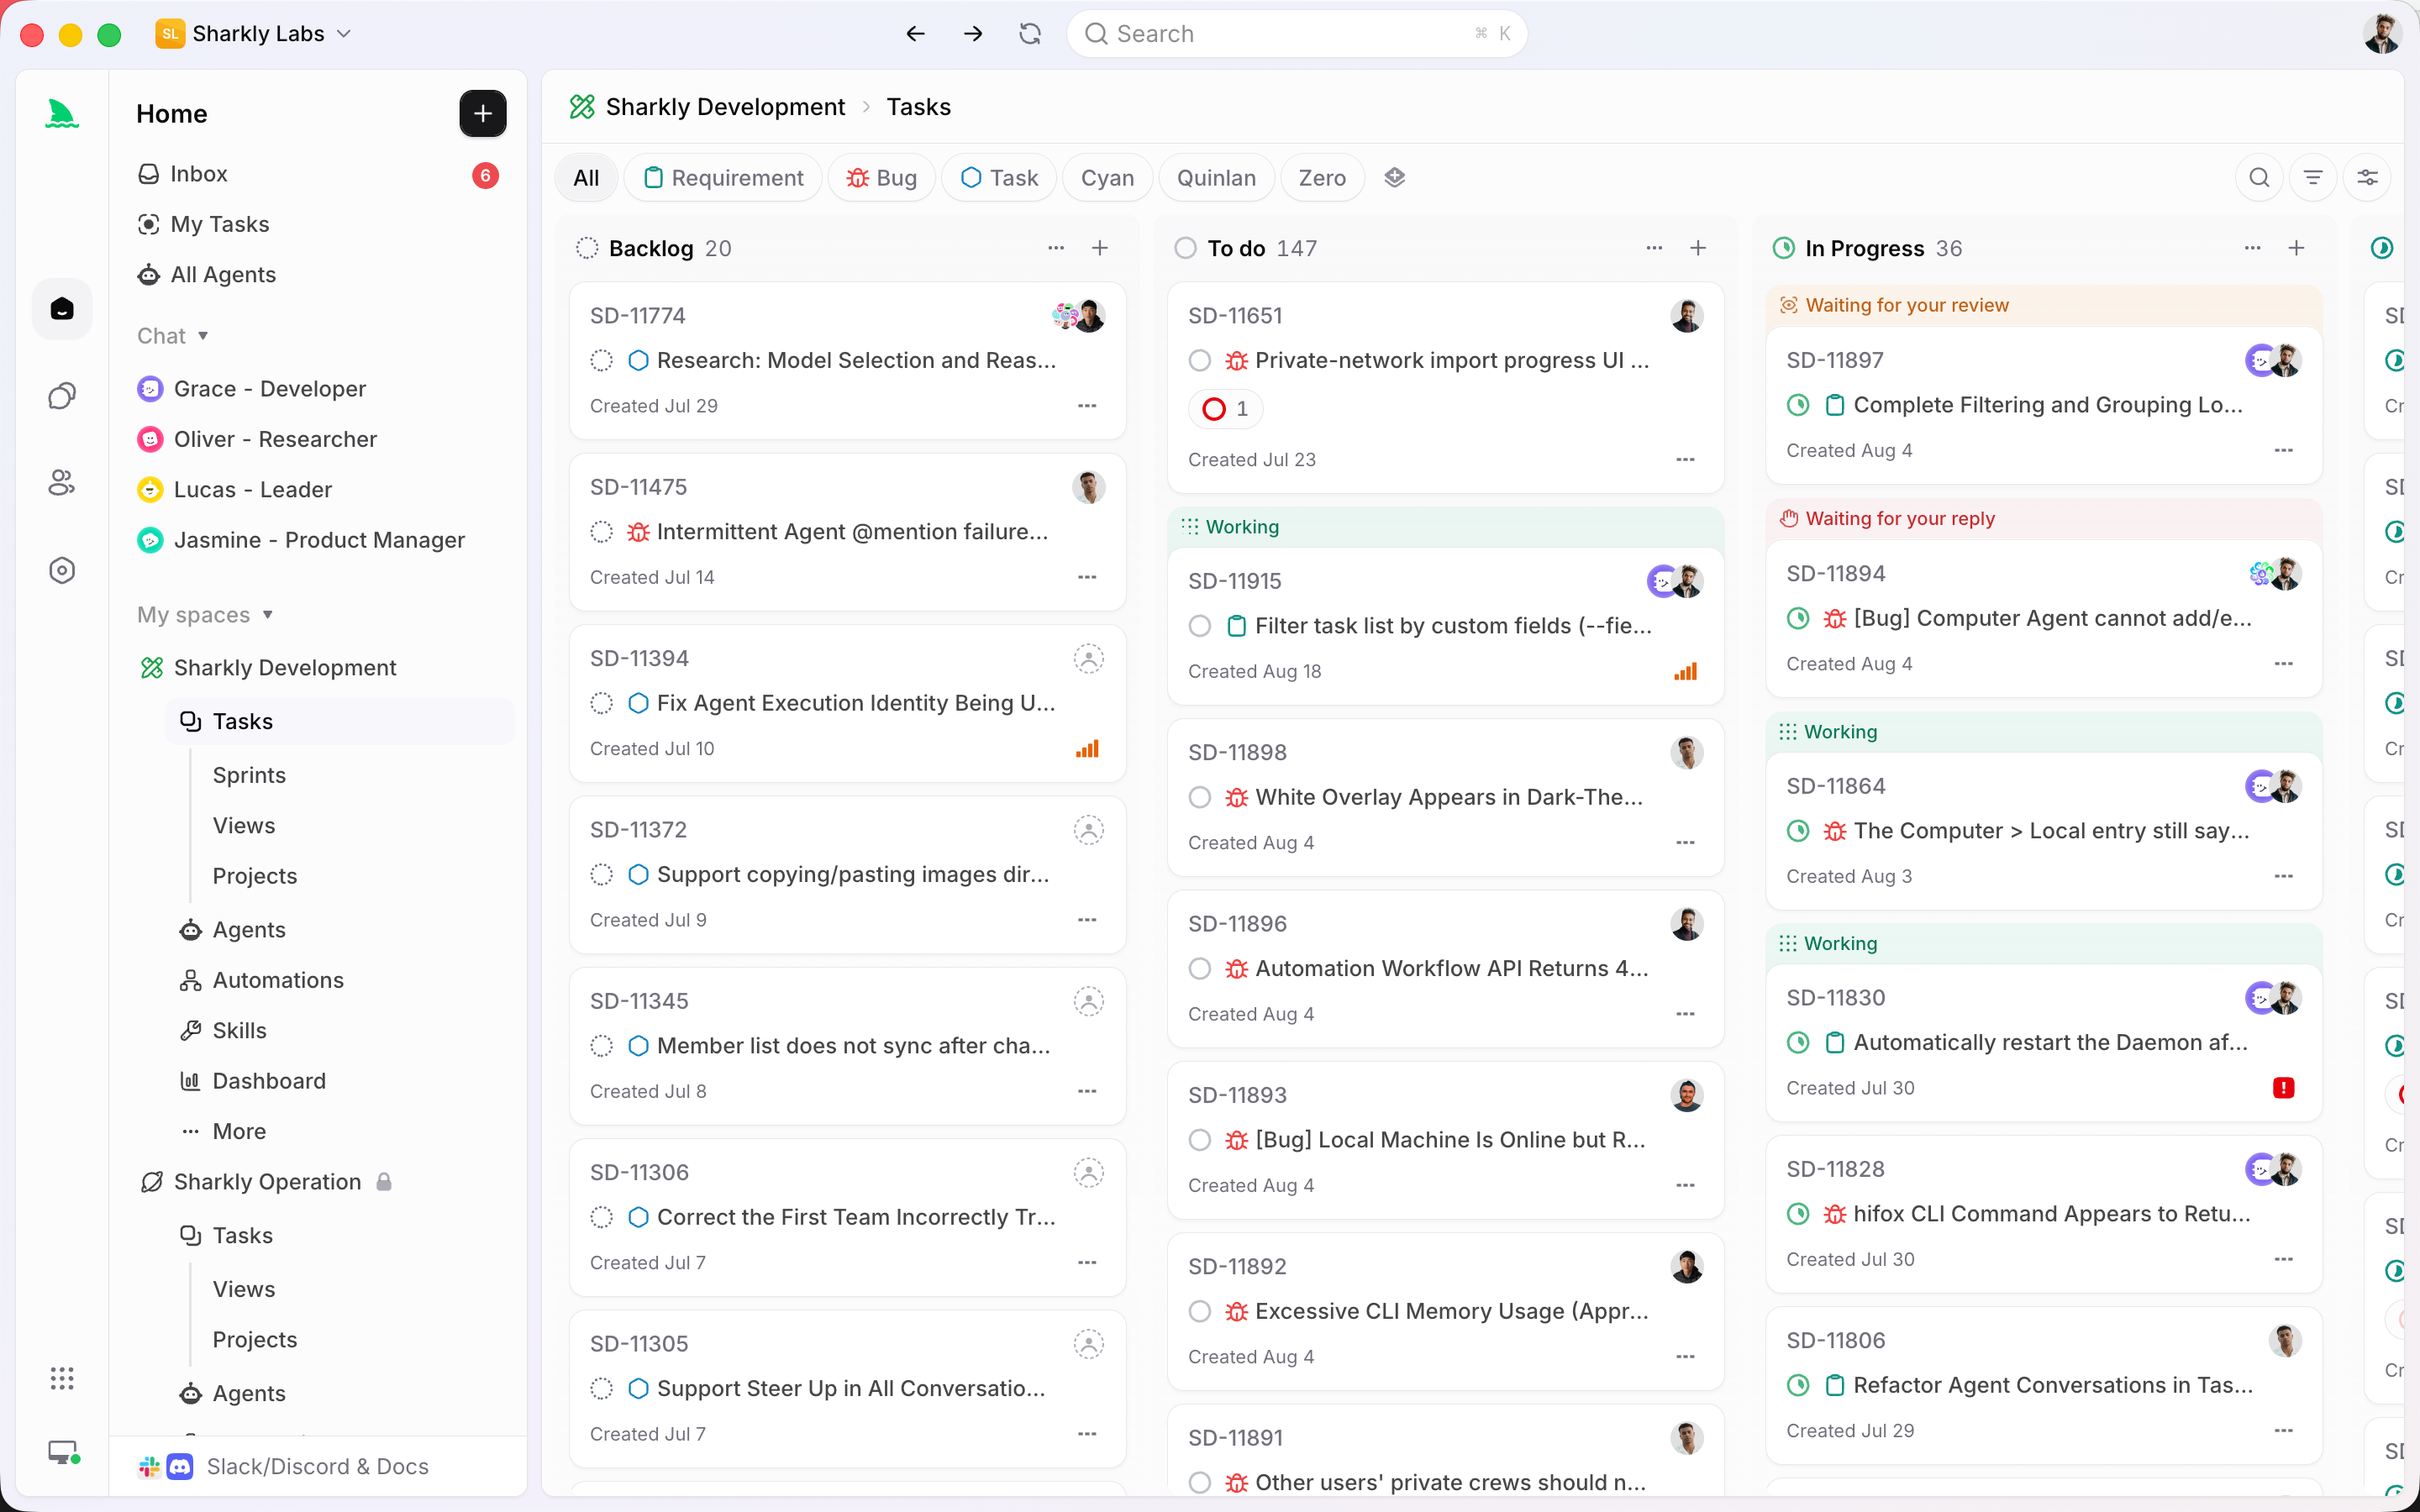
แต่ละบทบาทมีงานอย่างเดียว เอเจนต์เขียนโค้ดสร้างการเปลี่ยนแปลง เอเจนต์รีวิวรันการตรวจเชิงกลไกและแนบสิ่งที่พบ นักรีวิวที่เป็นคนอ่านสิ่งที่พบเหล่านั้น ตรวจการเปลี่ยนแปลงเทียบกับเจตนาใน ticket แล้วตัดสิน ทั้งหมดกลับไปที่ Task: diff, คอมเมนต์ของเอเจนต์รีวิว, ผลเทส และการตัดสินใจของคน อยู่บนไทม์ไลน์เดียว แทนที่จะกระจัดกระจายอยู่ใน PR แชท และความทรงจำของใครสักคน
ใช้เอเจนต์รีวิวเป็นด่านแรกเมื่อการเปลี่ยนแปลงเป็นเชิงกลไกและอยู่ในตัวมันเอง เช่นการรีแฟกเตอร์ การอัปเดต dependency หรือการแก้บั๊กที่ขอบเขตชัดเจน ปล่อยให้มันเคลียร์เสียงรบกวนเพื่อให้รอบของคนเร็วขึ้น แต่อย่าพึ่งมันเป็นด่านเดียวเมื่อการเปลี่ยนแปลงแตะเรื่องเงิน, auth, data migration หรือสัญญาสาธารณะ ตรงนั้นคนต้องอ่านก่อน และรอบของเอเจนต์เป็นเพียงเช็กลิสต์ ไม่ใช่คำตัดสิน
ตัวอย่างจริง: จาก ticket สู่ PR ที่ merge แล้ว
ลองดู SH-312: “ปฏิเสธโค้ดคูปองที่หมดอายุตอน checkout” มีคนเขียนเกณฑ์การยอมรับและมอบหมาย Task เอเจนต์เขียนโค้ดรับงานไป ทำใน worktree แยก แล้วส่ง diff พร้อมเทสที่ผ่านกลับมาที่ Task เลื่อนเป็น Ready for review
ตอนนี้เอเจนต์รีวิวเริ่มทำงาน มันยืนยัน types ตีธง null guard ที่หายไปหนึ่งจุด และระบุว่าเทสครอบคลุมกรณีหมดอายุแล้ว รอบสะอาด ตามนิสัยเดิม การอนุมัตินั้นก็จะถูก merge ทันที
แต่แทนที่จะเป็นอย่างนั้น นักรีวิวที่เป็นคนเปิด Task แล้วอ่านเทียบกับเจตนา โค้ดปฏิเสธคูปองที่หมดอายุ ตรงตามที่เขียนไว้จริง แต่เกณฑ์การยอมรับยังสื่อเป็นนัยด้วยว่าคูปองที่ถูกใช้ไปแล้วควรถูกปฏิเสธด้วย และทั้งเอเจนต์เขียนโค้ดและเอเจนต์รีวิวไม่รู้เรื่องนี้ เพราะมันอยู่ในหัวของนักรีวิวและในสเปกผลิตภัณฑ์ ไม่ได้อยู่ใน diff นักรีวิวขอให้แก้ไข SH-312 จึงกลับไปที่ In progress พร้อมโน้ตเฉพาะเจาะจง เอเจนต์ต่อเติมโค้ด แล้วหลังจากนั้นเท่านั้นที่คนจะเลื่อนเป็น Done และ merge pull request
เอเจนต์รีวิวทำหน้าที่ได้ดีและก็ยังจะปล่อยช่องว่างออกไปอยู่ดี โมเดลการทำงานจับได้ เพราะการ accept เป็นการกระทำแยกต่างหากโดยคนที่มีบริบท นั่นคือวินัยแบบเดียวกับที่อยู่เบื้องหลังการรีวิวโค้ดที่ AI สร้างด้วยหลักฐานระดับ Task: หน่วยของการรีวิวคือ Task และเจตนาของมัน ไม่ใช่ diff ที่ลอยอยู่ลำพัง
ควรวางด่านรีวิวไว้ตรงไหน
คำถามในทางปฏิบัติไม่ใช่ว่าจะใช้เอเจนต์รีวิวโค้ด AI หรือไม่ แต่คือรอบของมันนับผลตรงไหน และตรงไหนที่คนต้องอ่านก่อน กฎไม่กี่ข้อที่ยังใช้ได้ดี:
- ให้เอเจนต์เป็นด่านของสไตล์ การจัดรูปแบบ และบั๊กเชิงกลไกในทุกการเปลี่ยนแปลง นั่นคือรอบที่มันถนัดที่สุด และเป็นรอบที่คนทำได้แย่ที่สุดตอนเหนื่อย
- บังคับด่านของคนกับทุกอย่างที่แตะ auth, billing, data migration หรือ public API โซนที่มองไม่เห็นจะกระจุกตัวอยู่ตรงนั้น
- ปรับขนาดด่านให้พอดีกับความสามารถในการรีวิวของคุณ เอเจนต์ผลิตได้เร็วกว่าที่คนจะ accept ดังนั้นใช้รอบของคนในจุดที่เอเจนต์มองไม่เห็น
- ทำให้ด่านเป็นสถานะ ไม่ใช่นิสัย ด่านอนุมัติที่เขียนเป็นลายลักษณ์อักษรและบล็อกไม่ให้ไปถึง Done นั้นบังคับใช้ได้จริง ส่วนบรรทัดฐานที่ว่า “ใครสักคนน่าจะลองดู” บังคับใช้ไม่ได้ การรักษาคนให้อยู่ในลูปจะได้ผลก็ต่อเมื่อลูปนั้นเป็นขั้นตอนที่เวิร์กโฟลว์กำหนดไว้
เอเจนต์รีวิวโค้ด AI ไม่ใช่ตัวแทนของนักรีวิวที่เป็นคน มันคือรอบแรกที่ทำให้รอบของคนเร็วขึ้นและคมขึ้น ถ้าคุณรันเอเจนต์เขียนโค้ดหลายตัวอยู่แล้ว และอยากให้ผลลัพธ์ของพวกมันถูกรีวิวและ accept ในที่เดียว แทนที่จะเปิดแท็บ PR ห้าแท็บ นั่นคือปัญหาที่ Sharkly ถูกสร้างมาเพื่อแก้: มอบหมาย ติดตาม และรีวิวงานของเอเจนต์บน Task ที่ใช้ร่วมกัน โดยสิ่งที่เอเจนต์รีวิวพบและการตัดสินใจของคนต่างกลับมาที่บันทึกเดียวกัน เก็บเอเจนต์เขียนโค้ดและเอเจนต์รีวิวที่คุณใช้อยู่ไว้ แล้วเพิ่มเลเยอร์ที่ตัดสินว่ารอบของพวกมันเพียงพอแล้วเมื่อไหร่


