
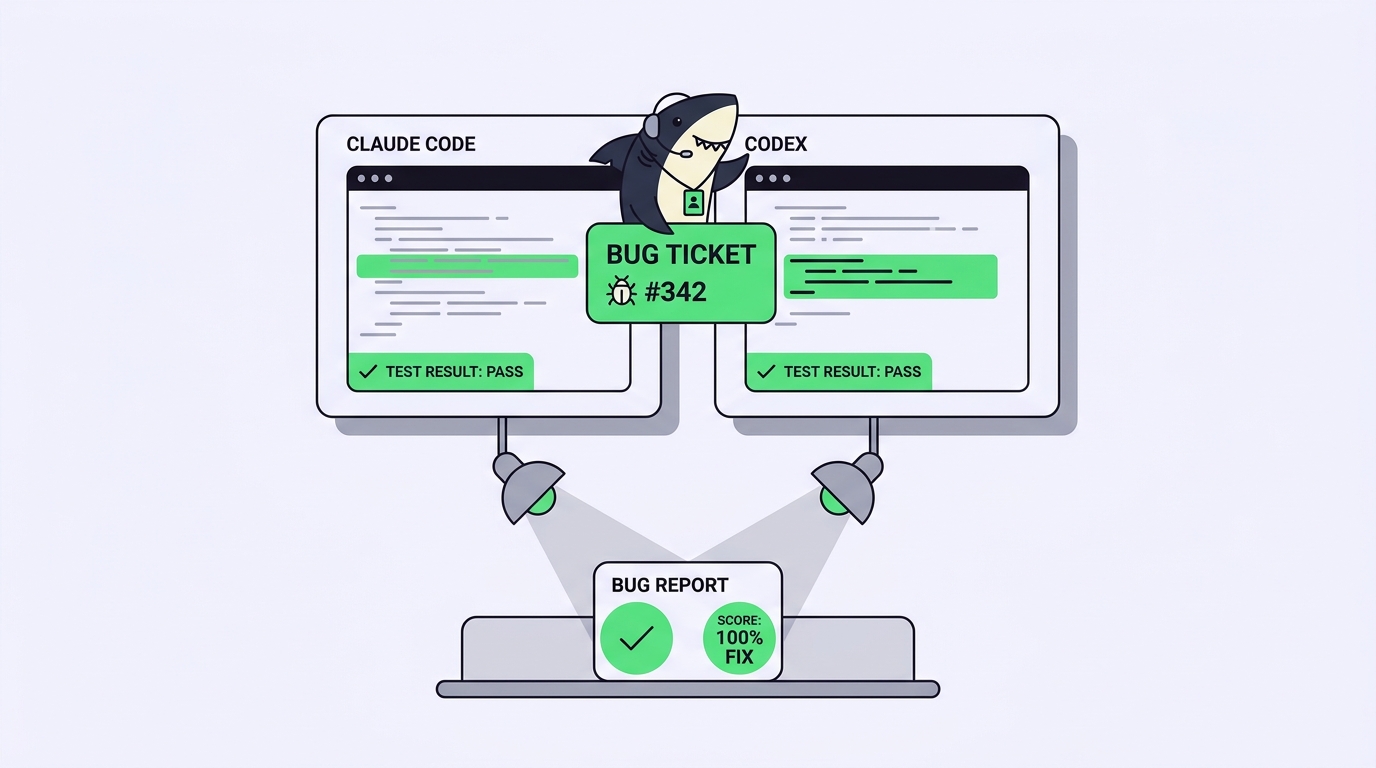
คุณมีบั๊กจริงค้างอยู่ในมือหนึ่งตัว และมีเอเจนต์สองตัวที่แก้มันได้: Claude Code กับ Codex แท็บต่าง ๆ เต็มไปด้วยความเห็นว่าตัวไหนฉลาดกว่า แต่ไม่มีสักอันที่บอกว่าวันนี้ ในรีโปนี้ คุณควรชี้ตัวไหนไปที่บั๊กตัวนี้ ตัวเลขจากเบนช์มาร์กสาธารณะก็ช่วยไม่ได้เช่นกัน ลีดเดอร์บอร์ดวัดปัญหาชุดหนึ่งที่ตายตัวจากโอเพนซอร์สด้วยฮาร์เนสที่ปรับจูนมาแล้ว แต่บั๊กของคุณคือปัญหาเฉพาะตัว: ธรรมเนียมการเขียนโค้ดของคุณ เทสต์ที่ล้มเหลว ๆ หาย ๆ ของคุณ โมดูลที่มีคนเข้าใจอยู่คนเดียว
วิธีตอบคำถาม “Claude Code หรือ Codex” อย่างซื่อสัตย์คือรันทั้งสองตัวบนบั๊กเดียวกัน ภายใต้เงื่อนไขเดียวกัน แล้วอ่านสิ่งที่แต่ละตัวส่งกลับมา ฟังดูง่ายแต่ก็กลายเป็นความวุ่นวายอย่างรวดเร็ว: เอเจนต์สองตัวแก้ไฟล์เดียวกัน เทอร์มินัลสองหน้าต่าง ผลเทสต์สองชุด และไม่มีวิธีเทียบข้างกันให้สะอาดตา สิ่งที่คุณอยากเปรียบคือตัวเอเจนต์ แต่สิ่งที่รออยู่ตรงหน้ากลับเป็นการคอยกันไม่ให้它们ชนกัน
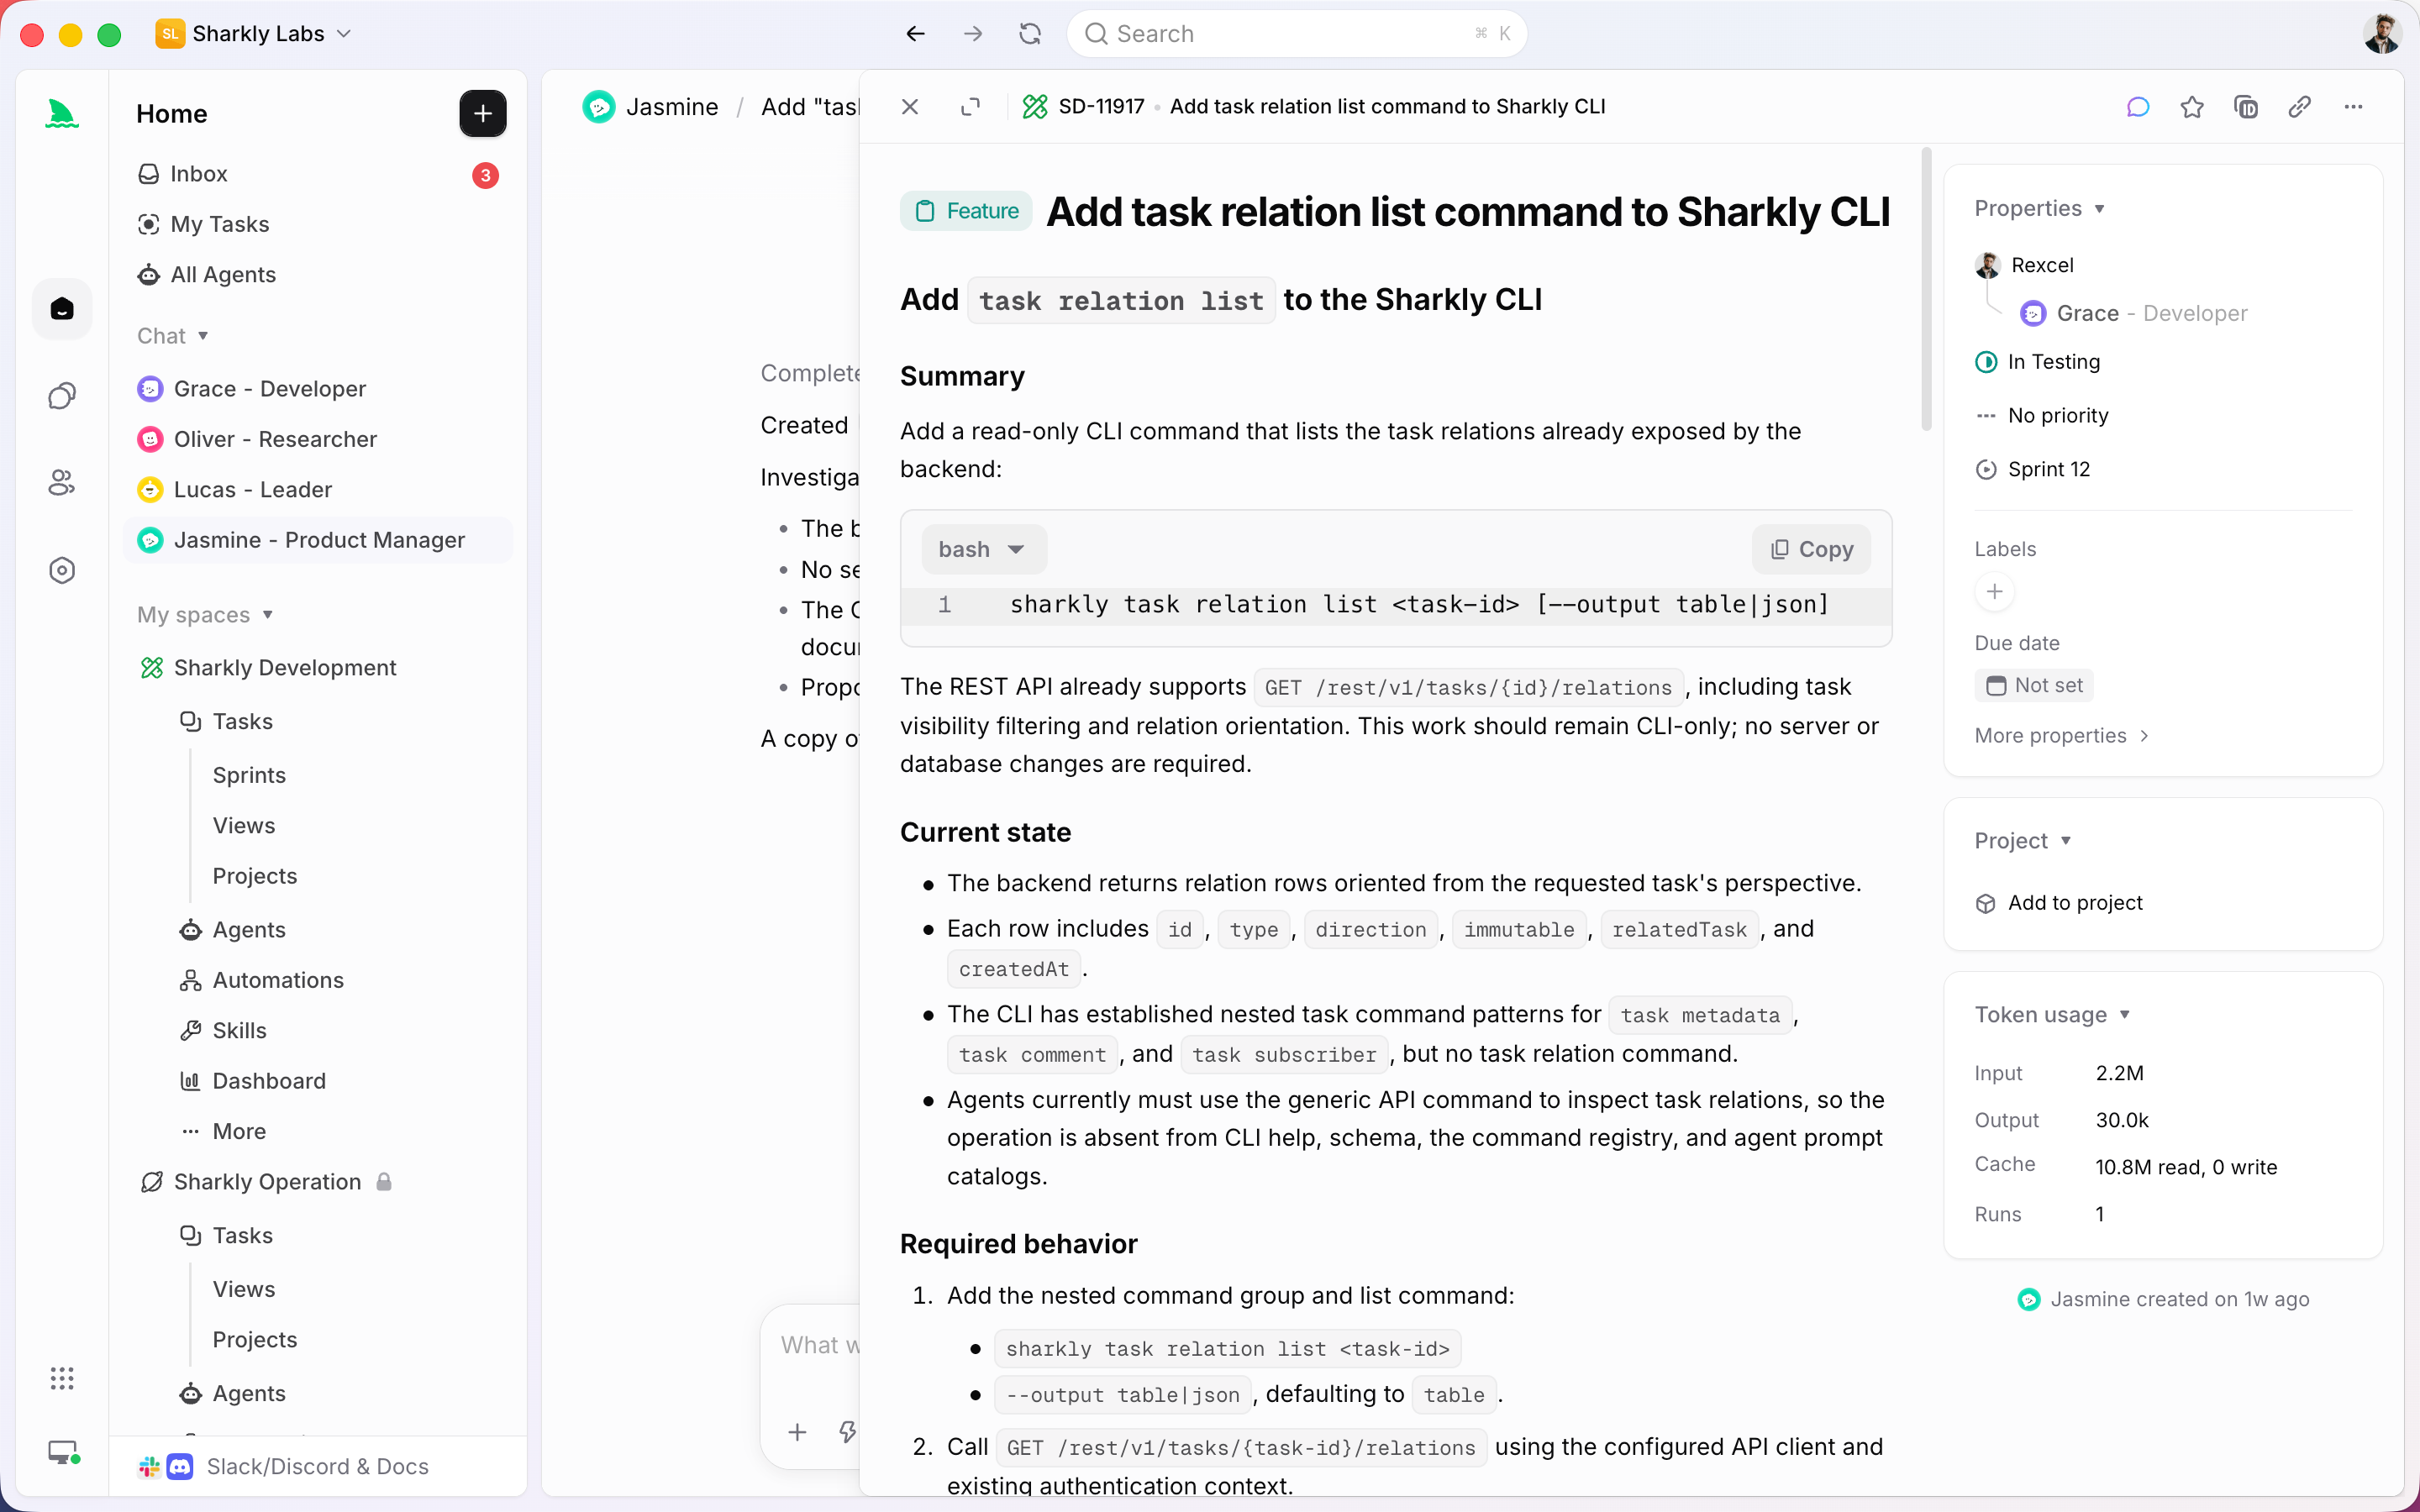
การชนกันนั้นคือสิ่งที่ Sharkly กำจัดออกไป Sharkly เป็นแพลตฟอร์มสั่งการและจัดการ Agent แบบครบวงจร: คุณมอบหมาย Task เดียวกันให้ Agent สองตัวที่ต่างกัน แต่ละตัวรันบน Computer ที่เชื่อมต่อไว้ ใน worktree ที่แยกออกจากกันของตัวเอง และทุกการรันจะส่ง diff ผลเทสต์ และรีวิวของมันกลับมาที่จุดเดียว Sharkly ไม่ได้มาแทน Claude Code หรือ Codex และไม่ใช่ฮาร์เนสสำหรับเบนช์มาร์ก มันคือชั้นที่ทำให้การเทียบแบบตัวต่อตัวเป็นไปได้อย่างยุติธรรมโดยไม่ต้องเปิดเทอร์มินัลเพิ่ม คู่มือนี้จะพาคุณไปดูวิธีทำ เกณฑ์ให้คะแนนสำหรับบั๊กหนึ่งตัว และจุดที่เอเจนต์แต่ละตัวมักได้เปรียบ
คำตอบสั้น ๆ
ถ้าอยากเทียบ Claude Code กับ Codex อย่างยุติธรรม ให้ทั้งคู่ได้รับบั๊กตัวเดียวกัน คอมมิตเริ่มต้นเดียวกัน และ acceptance test ตัวเดียวกัน โดยแต่ละตัวรันด้วยคอนฟิกที่ดีที่สุดของมัน จากนั้นให้คะแนนสิ่งที่ส่งกลับมา: แพตช์ผ่านไหม diff อยู่ในขอบเขตที่ควรแก้ไหม และคุณใช้เวลารีวิวการเปลี่ยนแปลงนี้นานแค่ไหน เอเจนต์ที่ชนะบั๊กหนึ่งตัวก็แค่ชนะบั๊กหนึ่งตัว ลองใช้วิธีนี้กับบั๊กหลาย ๆ ตัวก่อนจะเชื่อคำตัดสิน
ทำไม “อันไหนดีกว่า” ถึงเป็นคำถามที่ผิด
Claude Code กับ Codex ต่างเป็นเอเจนต์เขียนโค้ดที่ใช้เทอร์มินัลเป็นหลัก ทั้งคู่อ่านรีโปของคุณ แก้ไฟล์ รันคำสั่ง แล้วรายงานกลับมา ต่างกันตรงวิธีตั้งค่าและพฤติกรรมเมื่อเจอแรงกดดัน แต่ไม่มีตัวไหนนำขาดในงานที่เติมเต็มสปรินต์ตามปกติ
อันดับแบบภาพรวมเพียงชุดเดียวจะซ่อนส่วนที่คุณ关心的ไป “อันไหนดีกว่า” ย่อมทุกอย่างให้เหลือตัวเลขตัวหนึ่งที่พอเจอโค้ดเบสของคุณจริงก็ใช้ไม่ได้ ส่วนคำถามที่ว่า “อันไหนดีกว่ากับบั๊กแบบนี้ ในรีโปของฉัน ตอนต้องรีวิว” เป็นคำถามที่ตอบได้ และเป็นคำถามเวอร์ชันเดียวที่คุ้มค่าจะลงแรงหา ถ้าคุณยังตัดสินใจอยู่่ว่าแต่ละเอเจนต์ควรใช้โมเดลไหน การจับคู่โมเดลกับบทบาทของเอเจนต์ เป็นคำถามแรกที่ดีกว่าลีดเดอร์บอร์ดใด ๆ
รันทั้งสองตัวบนบั๊กเดียวกัน: วิธีที่คุณเชื่อถือได้
การเปรียบเทียบที่ยุติธรรมต้องตรึงทุกอย่างให้คงที่ ยกเว้นตัวเอเจนต์ กฎสี่ข้อทำให้เป็นเช่นนั้น
- เลือกบั๊กจริงหนึ่งตัว ไม่ใช่พรอมป์ต์ของเล่น เลือกบั๊กที่ขอบเขตชัดเจนจากแบ็คล็อกของคุณ ที่มี acceptance test ให้รันได้ และ diff ที่อ่านจบในไม่กี่นาที เขียนมันออกมาแบบที่ tracker ของคุณจะเขียน เช่นงานอย่าง
SH-312: fix the timezone drift in the invoice exportส่วน “สร้างแอป todo” ไม่ได้บอกอะไรคุณเกี่ยวกับโค้ดของคุณเลย - ป้อนข้อมูลแบบเดียวกันเป๊ะให้ทั้งคู่ คำอธิบายงานเดียวกัน คอมมิตเริ่มต้นเดียวกัน เกณฑ์การยอมรับเดียวกัน ถ้า Claude Code ได้พรอมป์ต์ที่ละเอียดกว่า Codex คุณกำลังวัดพรอมป์ต์ของคุณ ไม่ได้วัดเอเจนต์
- รันแต่ละตัวในสภาพที่ดีที่สุด ให้ Claude Code มี
CLAUDE.mdของมัน ให้ Codex มีAGENTS.mdและคอนฟิกของมัน และให้สิทธิ์กับโมเดลตามที่เอกสารของแต่ละตัวแนะนำ การเทียบเอเจนต์ที่ตั้งค่าไว้ดีกับตัวที่ปล่อยเปล่า ๆ แท้จริงคือการวัดว่าคุณตั้งค่าตัวไหนไว้จริงจัง - แยกการรันทั้งสองออกจากกัน เอเจนต์แต่ละตัวต้องมีสำเนาทำงานของตัวเอง เอเจนต์สองตัวในเช็กเอาต์เดียวจะเขียนทับกัน และคุณจะเสียเวลาทั้งบ่ายไปกับการงัดแยก merge แทนที่จะได้อ่านสองความพยายามที่สะอาด ๆ นี่คือเหตุผลที่ต้องใช้ worktree ที่แยกออกจากกัน
พอรันทั้งสองครั้งเสร็จ ก็ทิ้งแบรนช์ที่แพ้ไป คุณจะเหลือแพตช์ที่เชื่อใจได้และหลักฐานว่าทำไมถึงเลือกมัน
เกณฑ์ให้คะแนนสำหรับการแก้บั๊กหนึ่งตัว
“ผ่านไหม” เป็นข้อมูลแค่หนึ่งบิต การแก้บั๊กจริงตัดสินกันด้วยมากกว่านั้น และการเขียนเกณฑ์ออกมาก่อนลงมือดูจะช่วยให้การเปรียบเทียบซื่อสัตย์
| สิ่งที่ให้คะแนน | คำถามที่มันตอบ | ทำไมถึงสำคัญ |
|---|---|---|
| ความถูกต้อง | acceptance test ผ่านไหม และไม่มีอย่างอื่นพังใช่หรือไม่ | เป็นขั้นต่ำสุด เอเจนต์ที่พิมพ์ว่า “done” ไม่ได้ผ่านอะไรเลย |
| วินัยเรื่องขอบเขต | diff แตะเฉพาะสิ่งที่บั๊กต้องใช้หรือไม่ | แพตช์ที่เขียนไฟล์ไม่เกี่ยวข้องใหม่ถึงสี่ไฟล์ มีต้นทุนการรีวิวสูงกว่าที่ประหยัดได้ |
| คุณภาพของเทสต์ | เอเจนต์เพิ่มหรืออัปเดตเทสต์ที่จะจับ regression นี้ได้หรือไม่ | แพตช์ที่ไม่มีเทสต์คือแพตช์ที่คุณจะต้องกลับมาแก้ซ้ำ |
| เวลารีวิว | คุณใช้เวลานานแค่ไหนกว่าจะเชื่อใจการเปลี่ยนแปลงนี้ | มักเป็นคอขวดตัวจริง และเป็นเรื่องง่ายที่จะมองข้ามจนมันกินเวลาบ่ายทั้งบ่ายของคุณ |
| ความซื่อตรง | เอเจนต์ระบุข้อจำกัดและสมมติฐานของตัวเองหรือไม่ | การรันที่เชื่อถือได้คือการรันที่บอกคุณว่ามันยังไม่ได้ตรวจสอบอะไรบ้าง |
ให้คะแนนทั้งสองครั้งด้วยห้าข้อเดียวกัน บนบั๊กเดียวกัน แล้วผู้ชนะก็จะไม่ใช่เรื่องของรสนิยมอีกต่อไป เวลารีวิวควรได้น้ำหนักเป็นพิเศษ: เอเจนต์สองตัวอาจทำงานเสร็จในยี่สิบนาทีเท่ากัน แต่ยังต้องใช้เวลาตรวจคนละชั่วโมงอยู่ดี ชั่วโมงนั้นมักเป็น ขีดจำกัดจริงของปริมาณงานเอเจนต์ที่ทีมหนึ่งจะรองรับไหว
จุดที่แต่ละตัวมักได้เปรียบ
ไม่มีตัวเลขกุขึ้นมาในนี้ มีแต่สิ่งที่ควรจับตา Claude Code พึ่งพาหน่วยความจำโปรเจกต์อย่าง CLAUDE.md และมักอยู่ในกรอบธรรมเนียมของรีโปเมื่อแก้หลายไฟล์ ซึ่งเห็นได้ชัดในงานรีแฟกเตอร์ที่คร่อมหลายโมดูล ส่วน Codex อยู่กับสภาพแวดล้อมแบบแซนด์บ็อกซ์ที่ขับเคลื่อนด้วยคอนฟิกได้สบาย ๆ และมักจัดโครงสร้างโค้ดใหม่กับเทสต์ได้เรียบร้อย ซึ่งเห็นผลในงานแก้แบบจำกัดขอบเขต ทั้งคู่จะยิ่งออกนอกลู่นอกทางมากขึ้นเมื่อรีโปโตขึ้น และทั้งคู่ก็พร้อมจะยื่นการเปลี่ยนแปลงที่รันไม่ผ่านให้คุณอย่างมั่นใจ ลองรันกับบั๊กของคุณเองก่อนจะปักใจเชื่ออะไรก็ตามในนี้
นี่คือส่วนที่ซื่อสัตย์ที่สุด whichการเปรียบเทียบส่วนใหญ่มองข้าม ถ้าคุณใช้เอเจนต์ตัวเดียวและอยู่ในเทอร์มินัลเดียว คุณไม่จำเป็นต้องใช้แพลตฟอร์มใด ๆ เพื่อทำสิ่งนี้ เซสชัน Claude Code ที่ปรับจูนมาดีใน worktree หนึ่งอัน หรือการรัน Codex หนึ่งครั้งก็เพียงพอ และคุณดู diff เองด้วยตาเปล่าได้ สมการจะเปลี่ยนทันทีที่คุณกำลังเทียบเอเจนต์สองตัว บนบั๊กมากกว่าหนึ่งตัว และอยากได้ผลลัพธ์ในรูปแบบที่คนอื่นอ่านได้
การรันแบบตัวต่อตัวใน Sharkly
นี่คือจุดที่ Sharkly พิสูจน์คุณค่า คุณสร้าง Task หนึ่งอันสำหรับบั๊ก แล้วมอบหมายให้ทั้ง Claude Code Agent และ Codex Agent แต่ละ Agent รันบน Computer ที่เชื่อมต่อไว้ใน worktree ของตัวเอง สองความพยายามจึงไม่แตะไฟล์เดียวกันเลย การทำงาน อุปสรรค ผลลัพธ์ และสรุปการเปลี่ยนแปลงจะกลับมาอยู่ในไทม์ไลน์ของ Task และคุณอ่าน diff สองชุดกับผลเทสต์สองชุดเทียบกันในมุมมองเดียว แทนที่จะต้องจำว่าเทอร์มินัลไหนถืออะไรอยู่
การแบ่งงานยังชัดเจน เอเจนต์ค้นคว้า ลงมือทำ ทดสอบ และรายงาน คนเป็นคนกำหนดทิศทางและรับผลลัพธ์ ระบบอัตโนมัติหยุดตรงจุดที่ต้องใช้ดุลยพินิจของคุณ และ Sharkly ทำให้บริบท ความคืบหน้า อุปสรรค ผลลัพธ์ และการรีวิวโดยคนมองเห็นได้ตลอดทางตั้งแต่คำขอจนถึงการปล่อยของ คุณไม่ได้ยกการตัดสินใจให้เครื่องมือ แต่คุณได้เห็นทั้งสองความพยายามเรียงไว้ให้ดูจนใช้เวลาแค่ไม่กี่นาที เมื่อคุณอยากเก็บเอเจนต์ทั้งสองไว้ใช้ทำงานประจำแทนการทดสอบครั้งเดียว การรัน Claude Code กับ Codex ไปพร้อมกันบนโค้ดเบสเดียว ก็คือเวิร์กโฟลว์เดียวกันที่กลายเป็นงานปกติ
ควรเลือกใช้อะไร ตามขนาดทีม
ตัวเลือกที่ถูกต้องขึ้นอยู่กับว่าใครเป็นคนเลือก และการเปรียบเทียบนั้นต้องทนอยู่กับอะไร
| ขนาดทีม | ให้น้ำหนักกับอะไรมากที่สุด | ควรเลือกใช้อะไร |
|---|---|---|
| นักพัฒนาคนเดียว | เวลารีวิวและการรันบนเครื่องตัวเอง | ตัวที่คุณรีวิวได้เร็วกว่า เพราะคุณเป็นผู้อ่านคนเดียว |
| ทีมเล็ก | การรันขนานกันและความโปร่งใสที่แชร์ร่วมกัน | ใช้ทั้งคู่ โดยมอบหมายผ่าน Task เดียวเพื่อให้ทุกคนเห็นหลักฐานชุดเดียวกัน |
| ทีมแพลตฟอร์ม | การเชื่อมต่อกับระบบอื่นและความเป็นกลางต่อผู้ให้บริการ | เก็บทั้งคู่ไว้ เพราะเวิร์กโฟลว์ต้องอยู่รอดไม่ว่าเอเจนต์ตัวไหนจะนำในไตรมาสหน้า |
แถวสุดท้ายนี่แหละคือเหตุผลจริง ๆ ที่ควรลงมือเปรียบเทียบ แทนที่จะเลือกตัวโปรดแล้วปกป้องมันไว้ เอเจนต์ที่ดีที่สุดในไตรมาสนี้อาจไม่ใช่ตัวที่ดีที่สุดในไตรมาสหน้า และการสร้างกระบวนการใหม่ทุกครั้งที่ผู้นำเปลี่ยนก็มีต้นทุนของมันเอง การเปรียบเทียบบนบั๊กของคุณเอง ในเวิร์กโฟลว์ที่รันเอเจนต์ตัวไหนก็ได้ ทำให้คุณสลับได้อย่างอิสระเมื่อคำตอบเปลี่ยนไป
ถ้าคุณอยากใช้เอเจนต์เขียนโค้ดหลายตัวต่อไป แทนที่จะผูกกับระบบนิเวศเดียว นั่นคือปัญหาที่ Sharkly ถูกออกแบบมาเพื่อแก้ ดาวน์โหลด Sharkly เชื่อมต่อ Computer หนึ่งเครื่อง แล้วมอบหมายบั๊กจริงตัวเดียวกันให้เอเจนต์ทั้งสอง คำตัดสินที่คุณได้กลับมาจะเป็นเรื่องของโค้ดเบสคุณ ซึ่งเป็นสิ่งเดียวที่ทำนายสัปดาห์ของคุณได้จริง
คำถามที่พบบ่อย
Claude Code หรือ Codex แก้บั๊กได้ดีกว่ากัน ไม่มีตัวไหนชนะโดยรวม บนบั๊กเดียวกัน เมื่อตั้งค่าดีที่สุดของแต่ละตัว ปกติแล้วตัวหนึ่งจะเฉือนชนะอีกตัว และตัวที่ชนะก็สลับไปมาตามชนิดของบั๊กและขนาดของรีโป ลองรันทั้งคู่กับบั๊กจริงจากแบ็คล็อกของคุณ แล้วให้คะแนนความถูกต้อง ขอบเขต เทสต์ และเวลารีวิว
รัน Claude Code กับ Codex บนบั๊กเดียวกันพร้อมกันได้ไหม ได้ ถ้าแต่ละตัวมีสำเนาทำงานของตัวเอง เอเจนต์สองตัวในเช็กเอาต์เดียวจะเขียนทับกัน ให้ worktree แยกกันคนละอัน หรือมอบหมาย Task ให้ทั้งคู่ใน Sharkly แล้วให้แต่ละ Agent รันบน Computer ของตัวเอง
คะแนนเบนช์มาร์กบอกได้ไหมว่าควรใช้เอเจนต์ตัวไหน มันบอกว่าตัวไหนน่าลองทดสอบ ไม่ได้บอกว่าตัวหนึ่งจะทำงานอย่างไรในรีโปของคุณ ชุดข้อมูลสาธารณะไม่มีทางมีไลบรารีภายในของคุณ คอนฟิก lint ของคุณ หรือโมดูลที่ไม่มีเทสต์ของคุณ มองลีดเดอร์บอร์ดเป็นตัวกรอง แล้วค่อยรันการเปรียบเทียบที่สำคัญจริงบนโค้ดของคุณเอง
Sharkly มาแทน Claude Code หรือ Codex ไหม ไม่ Sharkly คือชั้นสำหรับมอบหมายงาน ให้บริบท และรีวิว รอบ ๆ เอเจนต์เขียนโค้ดที่ทีมคุณใช้อยู่แล้ว เอเจนต์เป็นตัวลงมือทำ ส่วน Sharkly จัดการ Task ทำให้การรันมองเห็นได้ และปล่อยให้คนเป็นผู้อนุมัติ
ควรเทียบบั๊กกี่ตัวก่อนตัดสินใจ บั๊กหนึ่งตัวบอกได้แค่เรื่องบั๊กหนึ่งตัว ลองใช้วิธีนี้กับบั๊กหลาย ๆ ประเภทก่อนจะเชื่อรูปแบบที่เห็น และให้เกณฑ์คะแนนเหมือนเดิมทุกครั้งเพื่อให้ผลเทียบกันได้


