
สรุปสั้นๆ: ราคาของ Claude Fable 5.2 บน Standard API ของ Anthropic อยู่ที่ $8 ต่อ 1 ล้าน Input Token และ $40 ต่อ 1 ล้าน Output Token ส่วน Fast mode มีค่าใช้จ่ายอยู่ที่ $16 และ $80 ตามลำดับ การวางงบประมาณจำเป็นต้องคำนวณตลอดทั้งเวิร์กโฟลว์ ไม่ว่าจะเป็น Context ที่ส่งซ้ำ กระบวนการคิด (Thinking) การลองใหม่ (Retries) การประสานงานระหว่างเอเจนต์ เครื่องมือต่างๆ รวมถึงการตรวจสอบโดยมนุษย์ (Human review) โดยอัตรานี้ตรวจสอบล่าสุดเมื่อวันที่ 10 พฤศจิกายน 2026
ราคาต่อโทเคนบอกเพียงค่าใช้จ่ายในการเรียกใช้โมเดลแต่ละครั้ง แต่งบประมาณด้านวิศวกรรมจริงต้องดูจากต้นทุนของผลงานที่ผ่านเกณฑ์รับมอบ การไมเกรตระบบที่ต้องลองทำถึงสามครั้ง ผ่านการรีวิวจากอีกเอเจนต์ และต้องให้คนมาช่วยแก้ไข ย่อมมีค่าใช้จ่ายพ่วงมาหลายส่วนกว่าจะได้งานชิ้นสุดท้ายเพียงชิ้นเดียว
หากคุณใช้งาน Coding Agent หลายตัวร่วมกัน Sharkly จะเป็นพื้นที่ส่วนกลางสำหรับจัดเก็บ Tasks และผลลัพธ์ของแต่ละตัว เริ่มต้นการวิเคราะห์ต้นทุนของคุณจากตรงนี้: กำหนดนิยามของงานที่ "เสร็จสมบูรณ์" ให้ชัดเจนก่อนจะเริ่มเปรียบเทียบโมเดล
Claude Fable 5.2 มีค่าใช้จ่ายเท่าไร?
Anthropic คิดค่าบริการแยกกันระหว่าง Input Token และ Output Token พร้อมกำหนดอัตราที่แตกต่างกันสำหรับการแคช (Caching) การประมวลผลแบบแบทช์ (Batch processing) และ Fast mode ทั้งนี้ MTok หมายถึงโทเคนจำนวนหนึ่งล้านหน่วย อัตราค่าบริการในสกุลเงินดอลลาร์สหรัฐ (USD) ด้านล่างนี้อ้างอิงจาก เอกสารราคาอย่างเป็นทางการ ซึ่งตรวจสอบเมื่อวันที่ 10 พฤศจิกายน 2026 โดยเป็นราคาสำหรับการใช้งานผ่าน API ไม่ใช่ค่าสมาชิกรายเดือนแบบคงที่
| หมวดหมู่การคิดค่าบริการ | Input ต่อ MTok | Output ต่อ MTok |
|---|---|---|
| Standard API | $8 | $40 |
| Fast mode | $16 | $80 |
| Batch API | $4 | $20 |
| Standard five-minute cache write | $10 | Not applicable |
| Standard one-hour cache write | $16 | Not applicable |
| Standard cache hit | $0.20 | Not applicable |
การเขียนแคชและการแคชฮิตจัดอยู่ในหมวด Input Token ไม่ใช่ส่วนลดสำหรับ Output ส่วนราคาการแคชใน Fast mode จะนำตัวคูณการแคชไปคิดกับอัตรา Input ของ Fast mode ขณะที่ Batch processing จะมอบส่วนลด 50% สำหรับทั้ง Input และ Output แต่จะไม่สามารถใช้งาน Fast mode ร่วมกับ Batch ได้
Fable มาพร้อมกับ Context Window ขนาดเต็ม 1 ล้านโทเคนในอัตรามาตรฐานต่อโทเคน แต่การใช้ Context ขนาดใหญ่ก็ยังมีค่าใช้จ่ายสูง เนื่องจาก Input ที่ไม่ได้แคชไว้จะสะสมเพิ่มขึ้นเรื่อยๆ ในแต่ละรอบการเรียกใช้งาน นอกจากนี้ แพลตฟอร์มคลาวด์ของพันธมิตรอาจมีโครงสร้างราคาที่ต่างกันออกไป จึงควรตรวจสอบ Endpoint ที่เรียกเก็บค่าใช้จ่ายกับทีมของคุณให้แน่ชัด
การคำนวณงบประมาณเวิร์กโฟลว์ทำอย่างไร?
สำหรับการเรียกใช้งานแบบมาตรฐานที่ไม่ได้แคช ให้คูณจำนวน Input Token ด้วย $8 ต่อหนึ่งล้านโทเคน และคูณจำนวน Output Token ด้วย $40 ต่อหนึ่งล้านโทเคน แล้วนำผลลัพธ์มารวมกัน จากนั้นคำนวณแบบนี้ซ้ำกับการเรียกใช้งานทุกครั้งในการพยายามทำแต่ละรอบ รวมทั้งบวกค่าบริการของเครื่องมือและโครงสร้างพื้นฐานแยกต่างหาก แล้วปิดท้ายด้วยต้นทุนเวลาในการรีวิวของมนุษย์ เพื่อประมาณการต้นทุนการส่งมอบงานทั้งหมดอย่างครบถ้วน
# Hypothetical standard-API example, not a measured benchmark.
input_tokens = 100_000
output_tokens = 20_000
api_cost = input_tokens / 1_000_000 * 8
api_cost += output_tokens / 1_000_000 * 40
print(f"${api_cost:.2f}")  # $1.60
ในที่นี้ Output หมายถึงจำนวนโทเคนขาออกทั้งหมดที่คิดค่าบริการ ซึ่งรวมถึงกระบวนการคิด (Thinking) ในกรณีที่มีด้วย อย่าใช้ความยาวของคำตอบที่มองเห็นมาแทนปริมาณการใช้งานจริงที่ผู้ให้บริการรายงาน
สมมติว่าคุณรันงาน 20 งานด้วยจำนวนโทเคนตามตัวอย่างข้างต้น โดยมี 5 งานที่ต้องลองทำซ้ำอีกหนึ่งรอบด้วยปริมาณเท่าเดิม และมีเอเจนต์ประสานงาน (Coordinating agent) ที่เพิ่มค่าใช้จ่ายรวมอีก $2 พร้อมด้วยผู้รีวิวหนึ่งคนที่ใช้เวลา 15 นาที ซึ่งคิดเป็นต้นทุนภายในองค์กร $80 ต่อชั่วโมง
| องค์ประกอบสมมติ | การคำนวณ | ต้นทุน |
|---|---|---|
| Initial attempts | 20 × $1.60 | $32 |
| Additional attempts | 5 × $1.60 | $8 |
| Coordinator | Assumed aggregate model spend | $2 |
| Human review | 0.25 hours × $80 | $20 |
| Total | Before tools, infrastructure, and taxes | $62 |
หากงานทั้ง 20 ชิ้นผ่านการยอมรับ ต้นทุนตัวอย่างนี้จะอยู่ที่ $3.10 ต่องานที่สำเร็จ แต่หากผ่านเพียง 16 ชิ้น งบ $62 เดียวกันนี้จะกลายเป็นต้นทุนราว $3.88 ต่องานที่สำเร็จ ตัวส่วนที่เปลี่ยนไปนี้ย่อมส่งผลต่อการตัดสินใจของคุณ
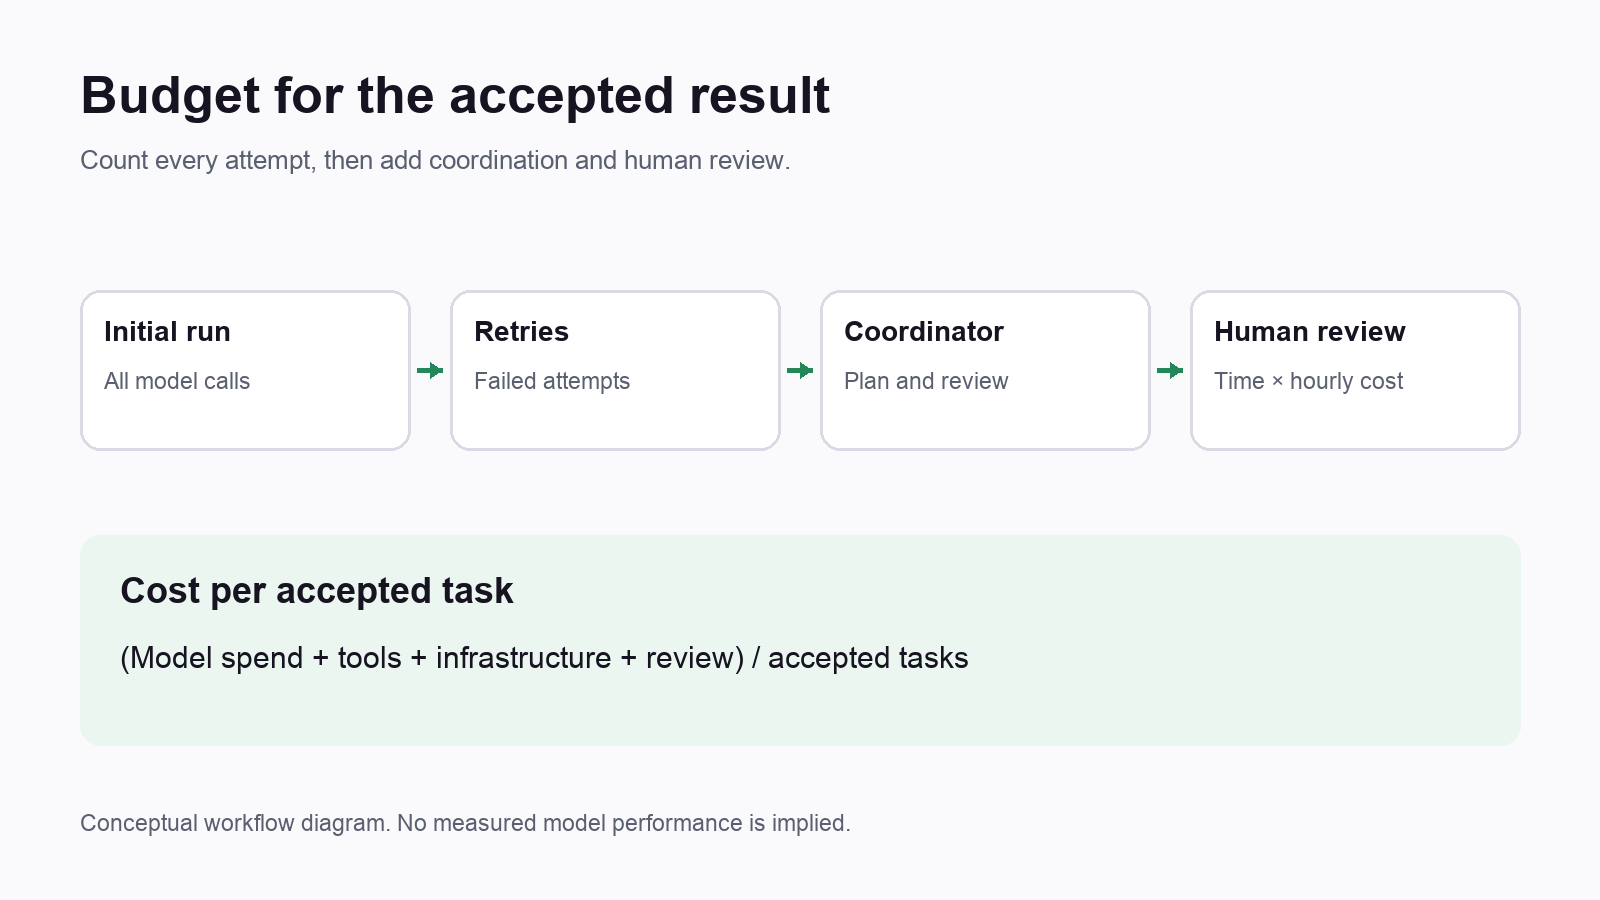
นี่เป็นเพียงข้อสมมติฐานสำหรับการวางแผน ไม่ใช่ประสิทธิภาพจริงของ Fable ที่วัดได้จากการใช้งาน คุณควรแทนที่ตัวเลขเหล่านี้ด้วยปริมาณโทเคน จำนวนครั้งที่ลองใหม่ ผลการตรวจรับงาน และเวลาที่ใช้รีวิวจริงของคุณ คู่มือของเราเรื่อง การคิดราคาการรันเอเจนต์ต่อการเปลี่ยนแปลงที่ยอมรับ ได้อธิบายไว้ว่าทำไมการเปรียบเทียบในแง่มุมนี้จึงสำคัญ
Fast mode และการตั้งค่า Effort ส่งผลต่อต้นทุนคนละส่วน
Fast mode เพิ่มอัตราค่าบริการต่อโทเคนเพื่อลดเวลาในการประมวลผลข้อความ (Generation time) ส่วน Effort จะเปลี่ยนปริมาณงานที่โมเดลต้องทำ รวมถึงกระบวนการคิดและการเรียกใช้เครื่องมือ คุณควรแยกการควบคุมทั้งสองส่วนนี้ออกจากกัน: การประมวลผลที่เร็วขึ้นไม่ได้การันตีว่าระยะเวลาเวิร์กโฟลว์ตั้งแต่ต้นจนจบจะสั้นลง และการตั้งค่า Effort ให้อยู่ในระดับต่ำก็ไม่ได้เป็นการกำหนดเพดานงบประมาณที่แน่นอน
ประกาศเปิดตัว ของ Anthropic ระบุว่า Fast mode สามารถสร้างโทเคนได้เร็วขึ้นสูงสุดถึง 2.5 เท่า แต่นั่นเป็นเพียงการอ้างอิงถึงความเร็วในการสร้างข้อความของผู้ให้บริการ ไม่ได้รับประกันว่าการบิลด์ การทดสอบ การเรียกเครือข่าย หรือการตรวจสอบโดยมนุษย์จะเสร็จเร็วขึ้น 2.5 เท่าไปด้วย
เมื่อใช้จำนวนโทเคนเท่ากัน ตัวอย่าง $1.60 จะกลายเป็น $3.20 ใน Fast mode ควรเลือกใช้ Fast mode เมื่อความคุ้มค่าของการลดเวลารอคอยสูงกว่าส่วนต่างราคาที่เพิ่มขึ้น และใช้ Standard mode สำหรับงานอัตโนมัติที่ทำงานเบื้องหลังโดยไม่ต้องมีคนเฝ้า ซึ่งความหน่วงในการสร้างข้อความไม่ได้ส่งผลกระทบต่อกำหนดการส่งมอบงาน
เอกสารคู่มือเกี่ยวกับ Effort ระบุระดับไว้ดังนี้: Low, Medium, High, Xhigh และ Max สำหรับ Fable 5.2 โดยค่าเริ่มต้นบน API คือ High ขณะที่ในประกาศระบุว่า Medium เป็นค่าเริ่มต้นสำหรับแอปของ Claude และ Claude Code ดังนั้นควรบันทึกชื่อผลิตภัณฑ์และการตั้งค่าที่ระบุไว้อย่างชัดเจนในการเปรียบเทียบของคุณ
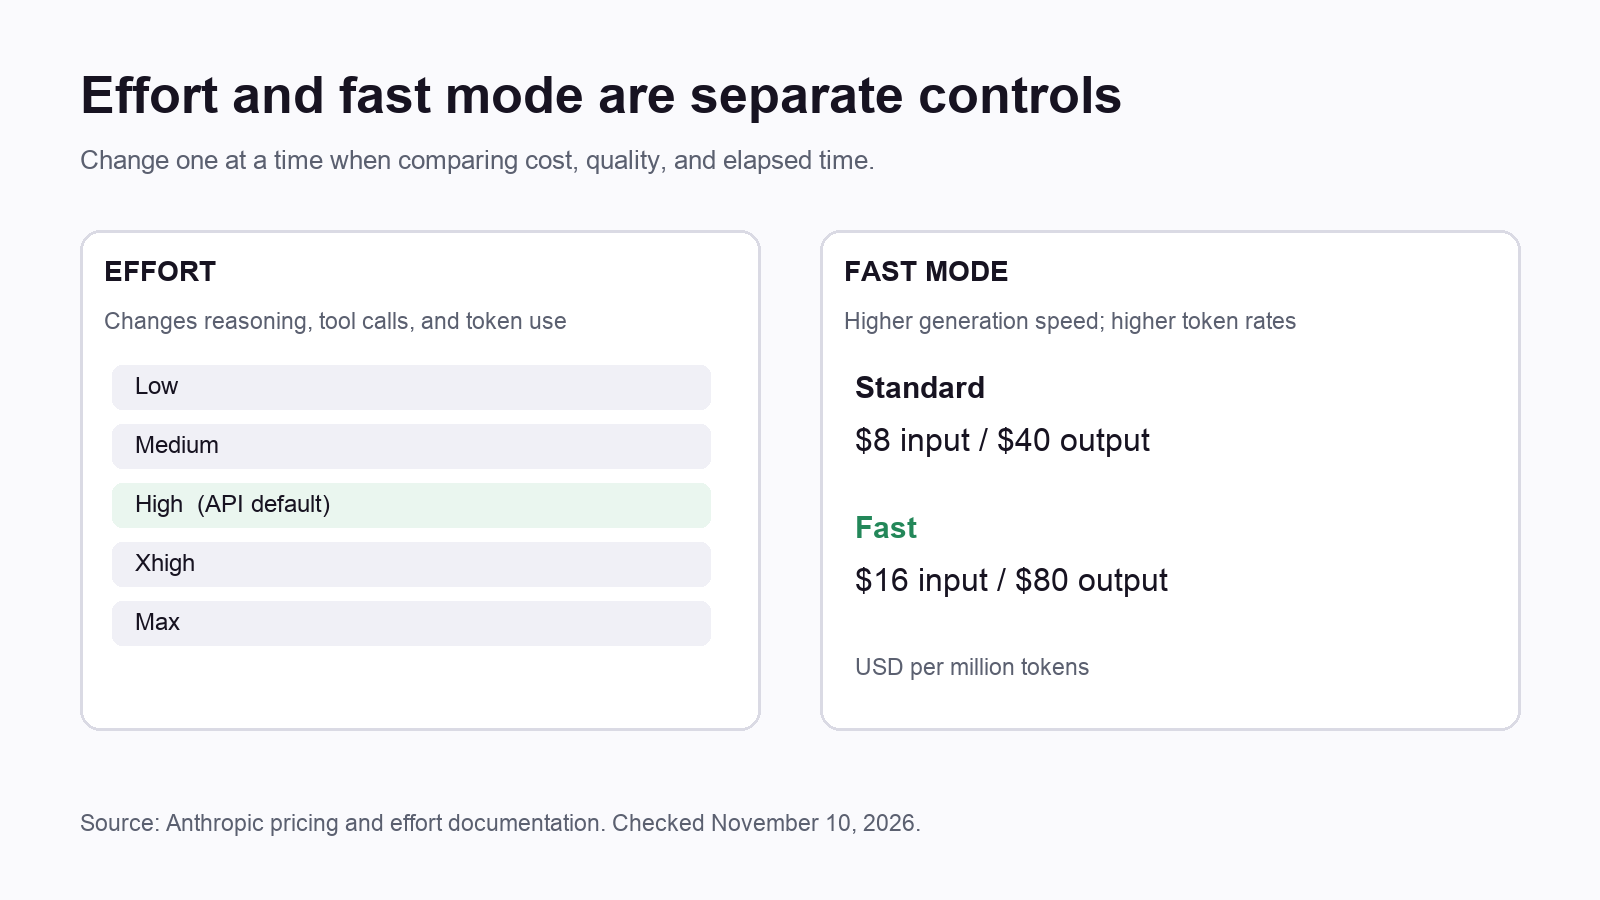
Anthropic แนะนำให้เริ่มต้นการทำงานผ่าน API ที่ระดับ High จากนั้นค่อยลดระดับ Effort ลงในจุดที่การประเมินพบว่ายังคงรักษาคุณภาพได้ และขยับขึ้นไปเป็น Xhigh เมื่องานที่ซับซ้อนแสดงผลลัพธ์ที่ดีขึ้นอย่างชัดเจน ส่วนระดับ Max จะเน้นความสามารถสูงสุดโดยไม่คำนึงถึงต้นทุนโทเคน ระดับ Effort เป็นเพียงการกำหนดพฤติกรรมของโมเดล ดังนั้นคุณจึงควรควบคุมงบประมาณค่าใช้จ่ายจริงในระดับแอปพลิเคชันและกระบวนการทำงานของคุณเอง
ควบคุม Context ที่ส่งซ้ำ การลองใหม่ และการจัดการ Orchestration
ใช้มาตรการควบคุม 6 ประการนี้ก่อนที่จะเพิ่มจำนวนเอเจนต์:
- วัดผลทุกครั้งที่ลองรัน: รวมต้นทุนของการรันที่ล้มเหลวหรือไม่สำเร็จไว้ในยอดรวมของงานชิ้นนั้นด้วย
- แคช Context ที่ไม่มีการเปลี่ยนแปลง: นำคำสั่งของ Repository และเอกสารที่ไม่มีการแก้ไขกลับมาใช้ซ้ำเมื่อเวิร์กโหลดรองรับ Prompt Caching
- กำหนดขอบเขตการลองใหม่: ตั้งขีดจำกัดจำนวนครั้งในการลองใหม่ (Retry limit) และกำหนดให้ต้องมีการวิเคราะห์หาสาเหตุก่อนจะเริ่มการรันใหม่ที่มีค่าใช้จ่ายสูง
- จัดเส้นทางงานตามระดับความยาก: ส่งต่องานที่ต้องใช้เหตุผลขั้นสูงและยังแก้ไม่ตก แทนที่จะส่งงานสกัดข้อมูลหรือจัดรูปแบบทั่วไปให้ Fable ทั้งหมด
- จัดสรรงบสำหรับการประสานงาน: นับรวมการวางแผน การจ่ายงาน การสรุปผล และการเรียกใช้เอเจนต์ผู้ตรวจสอบ ควบคู่ไปกับเอเจนต์ผู้ปฏิบัติงาน
- จำกัดปริมาณงานที่ส่งเข้ามารีวิว: ควบคุมปริมาณงานที่เสร็จแล้วให้สอดคล้องกับความสามารถในการตรวจสอบของผู้รีวิว
คำจำกัดความของเครื่องมือ (Tool definitions) และผลลัพธ์ของเครื่องมือ (Tool results) ล้วนเพิ่มปริมาณ Input ของโมเดล โดยเครื่องมือฝั่งเซิร์ฟเวอร์บางตัวอาจมีค่าบริการแยกต่างหากตามที่ระบุในคู่มือราคาของ Anthropic คำสั่งที่ส่ง Log ปริมาณมหาศาลกลับมาอาจทำให้ต้นทุน Context ในรอบถัดไปพุ่งสูงขึ้น แม้ว่าตัวคำสั่งนั้นจะมีค่าใช้จ่ายเพียงเล็กน้อยก็ตาม
การแคชก็จำเป็นต้องมีการวัดผลเช่นกัน สำหรับคำนำหน้า (Prefix) สมมติขนาด 100,000 โทเคน การเขียนแคชแบบมาตรฐาน 5 นาทีจะมีค่าใช้จ่าย $1 และการแคชฮิตในครั้งถัดมาจะมีค่าใช้จ่าย $0.02 เมื่อเทียบกับ $0.80 สำหรับ Input ที่ไม่ได้แคชไว้ ตัวเลขเหล่านี้ยังไม่รวม Input และ Output ใหม่ ดังนั้นควรตรวจสอบอัตราการแคชฮิตจริงก่อนที่จะสรุปว่าจะประหยัดต้นทุนได้เท่าใด
เพื่อสร้างนโยบายการจัดเส้นทางงาน (Routing policy) ที่ทำซ้ำได้ ให้ศึกษาจาก ภาพรวมโมเดล ของ Anthropic ซึ่งแนะนำ Opus 5.5 สำหรับเวิร์กโหลดส่วนใหญ่ และแนะนำ Fable สำหรับงานที่ต้องใช้เหตุผลขั้นสูงหรืองานที่มีขั้นตอนยาวนานและซับซ้อน แต่นี่เป็นเพียงแนวทางเริ่มต้นสำหรับการประเมิน ไม่ใช่บทสรุปว่าโมเดลใดจะให้ผลลัพธ์ดีที่สุดสำหรับ Repository ของคุณเสมอไป
ควรวัดผลอะไรบ้างในการทดสอบนำร่อง (Pilot)?
ควรกำหนดขอบเขตของงานและชุดการทดสอบการยอมรับ (Acceptance tests) ให้เหมือนกันในทุกการกำหนดค่า (Configuration) บันทึกเวลาโดยแยกเวลารอคิว (Queue time), เวลาการประมวลผลของโมเดล (Model generation), เวลาการทำงานของเครื่องมือ (Tool execution) และเวลาที่มนุษย์ใช้รีวิวออกจากกันอย่างชัดเจน มิฉะนั้น ชุดทดสอบที่ทำงานช้าอาจบดบังประโยชน์ของความเร็วในการสร้างข้อความ หรือชุดงานที่ง่ายเกินไปอาจทำให้การตั้งค่าที่มีราคาแพงดูเหมือนประหยัดคุ้มค่า
บันทึกปริมาณ Input ที่แคชแยกจาก Input ที่ไม่ได้แคช เก็บข้อมูลปริมาณการใช้งานจริงจากผู้ให้บริการในการลองแต่ละครั้งแทนการประมาณการโทเคนจากขนาดไฟล์ เมื่อคุณปรับเปลี่ยนการตั้งค่า Effort ให้เปรียบเทียบผลลัพธ์ที่ผ่านการยอมรับและปริมาณงานที่ต้องแก้ไขใหม่ (Rework) ควบคู่ไปกับการตอบกลับรอบแรก เนื่องจากการรันรอบแรกที่สั้นกว่าอาจทิ้งภาระค่าใช้จ่ายในการแก้ไขที่สูงกว่าไว้เบื้องหลัง
กำหนดเงื่อนไขการหยุด (Stop condition) ก่อนเริ่มการทดสอบนำร่อง เช่น จำนวนครั้งในการลองรัน ขีดจำกัดงบประมาณค่าใช้จ่าย หรือจุดตรวจเช็กการรีวิว เพราะโมเดลที่พยายามสืบค้นและแก้ไขไปเรื่อยๆ อาจผลาญงบประมาณของคุณจนหมด ทั้งที่งานยังพัฒนาไปไม่ถึงขั้นที่คุณจะยอมรับได้
ผูกงบประมาณไว้กับเนื้องานจริง
คำอธิบายผลิตภัณฑ์อย่างเป็นทางการ ของ Sharkly รวมทั้ง Tasks, Coding Agent, คอมพิวเตอร์ที่เชื่อมต่อ (Connected Computers) และการรีวิวโดยมนุษย์ไว้ในพื้นที่ทำงานเดียวกัน คุณยังคงกำหนดค่าบัญชี API หรือแพ็กเกจสมาชิกสำหรับการเขียนโค้ดไว้ในเครื่องมือของคุณเอง และการคิดค่าใช้งานโมเดลจะบันทึกอยู่บนบัญชีของผู้ให้บริการเหล่านั้น
ใช้บันทึกการทำงานร่วมกันนี้ในการรายงานโมเดล ระดับ Effort จำนวนครั้งที่ลอง ร่องรอยหลักฐานการทำงาน (Evidence) และผลการรีวิว สำหรับงานไมเกรตระบบ ให้กำหนดให้ Agent ส่งผลการทดสอบและข้อจำกัดที่พบกลับมาพร้อมกับโค้ดที่แก้ไข จากนั้นทีมงานจึงพิจารณายอมรับงานหรือส่งกลับไปแก้ไข อ่านเพิ่มเติมได้ที่ วิธีรีวิวโค้ดที่สร้างโดย AI ด้วยหลักฐานในระดับ Task เพื่อดูโครงสร้างการรีวิวที่นำไปใช้ได้จริง
สำหรับการแก้ไขจุดเล็กๆ ให้มอบหมาย Agent เพียงตัวเดียว และเลือกใช้ Crew เมื่องานจำเป็นต้องอาศัยผู้เชี่ยวชาญเฉพาะด้านหลายฝ่ายและการประสานงานร่วมกัน การเพิ่มเอเจนต์จะทำให้มีการเรียกใช้โมเดลและการส่งต่องาน (Handoffs) เพิ่มขึ้น ดังนั้นควรวัดผลลัพธ์ให้ชัดเจนก่อนจะเลือกใช้การทำงานแบบขนานเป็นค่าเริ่มต้น คู่มือ Crew แบบผสมผสานโมเดล ได้เจาะลึกถึงรายละเอียดการส่งต่องานเหล่านี้ไว้แล้ว
เริ่มต้นด้วยงานตัวอย่างที่เป็นตัวแทนสัก 10 งาน บันทึกค่าใช้จ่ายทั้งหมด เวลาที่ใช้ อัตราการยอมรับงาน และเวลาที่ผู้รีวิวใช้ในแต่ละการกำหนดค่า เชื่อมต่อคอมพิวเตอร์หนึ่งเครื่องใน Sharkly มอบหมายงานที่มีขอบเขตชัดเจนหนึ่ง Task และเรียกขอหลักฐานแนบมาพร้อมกับการส่งมอบงาน จากนั้นค่อยขยายสเกลเมื่อคุณสามารถอธิบายต้นทุนต่องานที่ยอมรับได้อย่างชัดเจนแล้ว
คำถามที่พบบ่อย (FAQ)
Claude Fable 5.2 Fast mode มีราคาแพงกว่าสองเท่าจริงหรือไม่?
อัตราค่าบริการต่อโทเคนทั้ง Input และ Output ตามที่ระบุไว้มีราคาสูงกว่าอัตรามาตรฐานเป็นสองเท่า แต่ค่าใช้จ่ายรวมของเวิร์กโฟลว์ของคุณยังขึ้นอยู่กับปริมาณโทเคน การแคช เครื่องมือที่ใช้ และจำนวนครั้งในการลองใหม่อีกด้วย
ระดับ Medium effort ทำให้ราคาต่อโทเคนเปลี่ยนไปหรือไม่?
ระดับ Effort จะเปลี่ยนพฤติกรรมของโมเดลและปริมาณโทเคนที่ใช้ แต่ไม่ได้เปลี่ยนอัตราค่าบริการ Input และ Output ที่กำหนดไว้เป็นอัตราใหม่ตามระดับ Effort แต่อย่างใด
งบประมาณแบบสมาชิกรายเดือนเหมือนกับงบประมาณ API หรือไม่?
ไม่เหมือนกัน บทความนี้คำนวณจากการใช้งานผ่าน API แบบคิดตามจริง (Metered API usage) คุณควรตรวจสอบเงื่อนไขและโควตาของแพ็กเกจสมาชิกการเขียนโค้ดที่เชื่อมต่อไว้แยกต่างหาก
Batch processing ช่วยลดค่าใช้จ่ายได้หรือไม่?
Batch API มีอัตราอยู่ที่ $4 สำหรับ Input และ $20 สำหรับ Output ต่อหนึ่งล้านโทเคนของ Fable จึงควรเลือกใช้การประมวลผลแบบอะซิงโครนัสในเวิร์กโฟลว์ที่สามารถรอผลลัพธ์ได้ ทั้งนี้ Fast mode ไม่สามารถใช้งานร่วมกับ Batch ได้
ต้นทุนต่อการเรียกใช้งานที่ถูกกว่า หมายถึงการส่งมอบงานที่ถูกกว่าเสมอไปหรือไม่?
ถูกกว่าก็ต่อเมื่อจำนวนการลองใหม่ การยอมรับงาน การประสานงาน และการรีวิวยังคงรักษาความได้เปรียบด้านต้นทุนนั้นไว้ได้ ดังนั้นจึงควรเปรียบเทียบค่าใช้จ่ายทั้งหมดต่องานที่ผ่านการยอมรับ โดยใช้เกณฑ์การตรวจรับเดียวกัน
แหล่งข้อมูลเพิ่มเติม
สำหรับการวางแผนเวิร์กโฟลว์ที่เกี่ยวข้อง สามารถอ่านเพิ่มเติมได้ที่ การจัดการต้นทุนของ Coding Agent และ ขีดความสามารถในการรีวิวของมนุษย์สำหรับเอเจนต์ที่ทำงานแบบขนาน และอย่าลืมตรวจสอบเอกสารราคาและระดับ Effort ตามลิงก์ของ Anthropic อีกครั้งก่อนนำอัตราเหล่านี้ไปใช้ในการวางงบประมาณใหม่


