
สรุปสั้น: ทีมงานที่ MIT CSAIL ให้โมเดลระดับแนวหน้าอ่านและแก้ไขค่าน้ำหนักของ Qwen3.5-0.8B ภายในแซนด์บ็อกซ์ Python โดยมีงบประมาณการทำ forward pass แบบตายตัว และบันทึกทุกขั้นตอนไว้อย่างครบถ้วน ผู้เขียนรายงานว่า MATH-500 เพิ่มขึ้นจาก 7.9% เป็น 48.1% คุณก็ปล่อยให้ coding agent แก้ไขค่าน้ำหนักโมเดลในแบบเดียวกันได้: ห่างานบนบอร์ด กำหนดงบประมาณไว้ในแต่ละงาน ให้ agent อีกตัวดูแลการประเมิน และให้คนเป็นผู้อนุมัติไฟล์ที่แก้ไขแล้ว
เมื่อวันที่ 2 พฤศจิกายน 2026 Rikiya Takehi, Jayden Teoh, Alex Zhang และ Omar Khattab ได้เผยแพร่ Sparks of Weight-Space Programming โมเดลที่ใช้ในการศึกษาของพวกเขาอย่าง GPT-6 Astra ได้เปิดเทนเซอร์ค่าน้ำหนัก เขียนโค้ด numpy และ PyTorch จัดการกับมัน ตั้งสมมติฐาน และแก้ไขตัวเลข 131,072 ตัวในโมเดลขนาด 0.8B พารามิเตอร์
พออ่านรายละเอียดการทดลองแล้วจะรู้สึกคุ้นเคย: แซนด์บ็อกซ์ งบประมาณการใช้เครื่องมือ บันทึกทุกพรอมป์และทุกเซลล์ที่รัน นั่นก็คือ coding agent ที่มี harness ครอบอยู่ และ harness นี่แหละคือส่วนที่ทีมของคุณลอกมาใช้ได้ตั้งแต่วันนี้
สิ่งที่ทีม MIT ทำ ในมุมของตัวเลข
การเขียนโปรแกรมในปริภูมิค่าน้ำหนัก (weight-space programming) หมายถึงการที่ LLM อ่านพารามิเตอร์ของเครือข่ายเป็นข้อมูล แล้วแก้ไขโดยตรง ไม่ต้องใช้ gradient descent และไม่ต้องรันเทรน บทความของ MIT รายงานผลนี้กับโมเดลขนาดเล็ก ภายใต้ข้อจำกัดเครื่องมือที่เข้มงวด และบันทึกทุกเทิร์น
ผลลัพธ์เด่นคือการแก้ไข Qwen3.5-0.8B:
| ตัวชี้วัด (ตัวเลขจากผู้เขียน) | โมเดลฐาน | โมเดลที่แก้ไขแล้ว |
|---|---|---|
| MATH-500 | 7.9% | 48.1% |
| GSM8K | 13.8% | 67.1% |
| IFEval | 21.0% | 62.3% |
| รอบที่ชนเพดาน 32,768 โทเคน | 93.0% | 33.1% |
Astra สืบสาวนิสัยของโมเดลที่วนซ้ำจนโทเคนหมด ไปจนพบว่ามาจากทิศทางหนึ่ง (direction) ที่เขียนขึ้นโดย MLP ในเลเยอร์ที่ 15 และ 19 จากนั้นจึงลบทิศทางนั้นออกจากคอลัมน์เอาต์พุต 64 คอลัมน์ในแต่ละเลเยอร์ รวม 131,072 ค่าน้ำหนัก หรือคิดเป็น 0.016% ของโมเดล เช็กพอยต์ที่เผยแพร่อยู่ภายใต้สัญญาอนุญาต Apache-2.0 และการ์ดของมันระบุว่ามีเพียงสองเทนเซอร์ที่ต่างจากโมเดลฐาน คือเมทริกซ์ down_proj.weight ในสองเลเยอร์นั้น
ทำไม harness ถึงเป็นตัวตัดสินผลลัพธ์
มีสองข้อค้นพบในบทความที่สำคัญต่อทีมมากกว่าผลลัพธ์พาดหัวข่าว
งบประมาณเปลี่ยนผลลัพธ์ forward pass แต่ละครั้งเฉลี่ยจากแบตช์ 64 ซีเควนซ์ ด้วย 10 พาส MATH-500 ไปถึง 12.3% ด้วย 25 พาส ไปถึง 14.1% ด้วย 50 พาส ไปถึง 48.1% โมเดลเดิม งานเดิม แต่เพดานจำนวนครั้งที่ agent ทดลองไอเดียได้นั้นต่างกัน
เครื่องมือเปลี่ยนผลลัพธ์ เมื่อให้แค่ค่าน้ำหนักของ Gemma 3 270M สองเวอร์ชัน Astra ไม่สามารถบอกได้ว่าตัวไหนเป็นพวกประจบ (sycophantic) ในการลองทั้งสี่ครั้ง แต่เมื่อให้เครื่องมือที่คืนค่า attention weight จากข้อความไม่เกิน 16 ข้อความที่มันเขียนเอง มันชี้ตัวที่ประจบได้ถูกทั้งสามคู่
สรุปคือมีคันโยกสองตัว: agent ใช้จ่ายอะไรได้บ้าง และมันดูอะไรได้บ้าง ทั้งสองอย่างควรถูกเขียนไว้ก่อนเริ่มรัน
ข้อจำกัดก็ชัดเจนพอ ๆ กัน Astra ปรับปรุง Gemma 3 270M บน MATH-500 ไม่ได้: จากฐาน 6.8% การแก้ไขที่ดีที่สุดทำได้ 7.7% ผู้เขียนตีความว่านี่เป็นการแก้ไขที่ขจัดอุปสรรคออกไป ไม่ใช่การเพิ่มความสามารถที่โมเดลไม่มี พวกเขาเรียกข้อค้นพบเหล่านี้ว่ายังอยู่ในช่วงเริ่มต้น และหลายข้อมาจากการรันเพียงครั้งเดียว วางแผนการทดลองของคุณให้เป็นการทดสอบ ไม่ใช่การแก้ไขให้จบ
ทำอย่างไรให้ coding agent แก้ไขค่าน้ำหนักโมเดลได้อย่างปลอดภัย
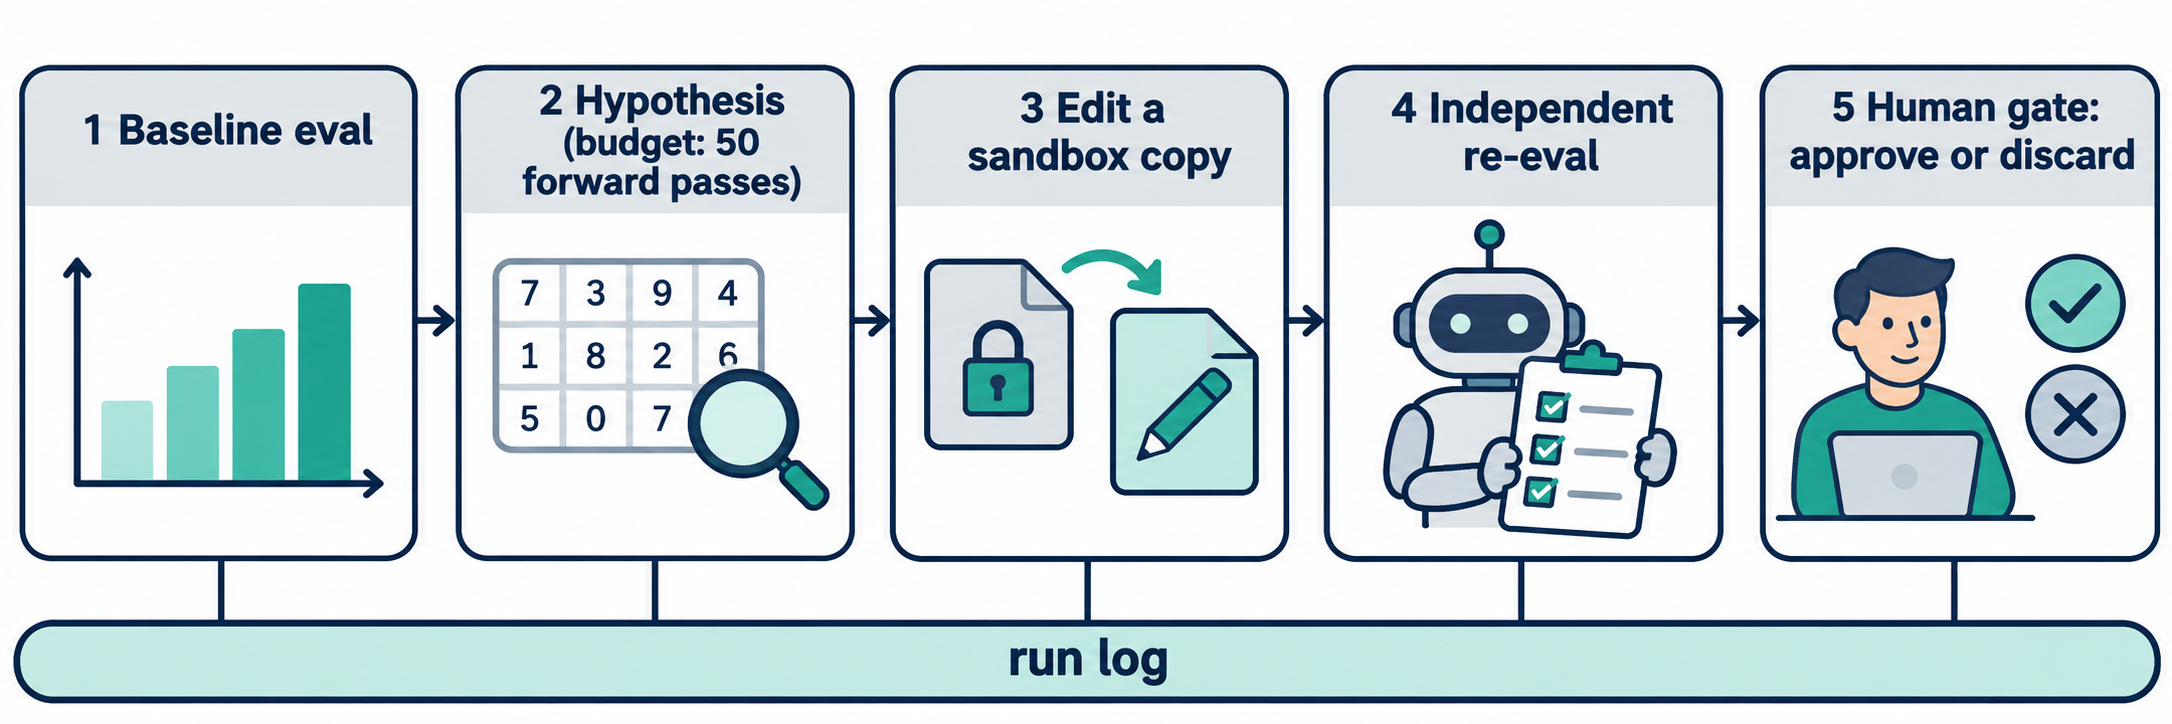
การทดลองในปริภูมิค่าน้ำหนักที่ปลอดภัยมีคุณสมบัติห้าข้อ:
- ค่าน้ำหนักต้นฉบับเป็นแบบอ่านอย่างเดียวสำหรับ agent ทุกตัว
- งบประมาณ forward pass เป็นตัวเลขที่ระบุในงาน และถูกบังคับใช้โดยแซนด์บ็อกซ์
- ชุดประเมินที่ agent ฝ่ายแก้ไขเห็น แยกจากชุดรีเกรสชันที่ agent ฝ่ายตรวจสอบรัน
- log ของทุกรันผูกอยู่กับขั้นตอนที่มันสังกัด
- ต้องมีคนอนุมัติไฟล์ที่แก้ไขก่อนที่อะไรจะโหลดมันนอกแซนด์บ็อกซ์
Sharkly ไม่ได้นับ forward pass หรือตรวจสอบเทนเซอร์ สคริปต์แซนด์บ็อกซ์ของคุณต่างหากที่ทำหน้าที่นั้น และ runtime ที่คุณใช้ (Claude Code, Codex หรือ agent อื่นที่คุณรันอยู่แล้ว) เป็นตัวอ่านและแก้ไข Sharkly ทำหน้าที่ถืองานเอาไว้: ใครเป็นเจ้าของแต่ละขั้นตอน ใช้อะไรได้บ้าง ผลลัพธ์ที่ได้กลับมาคืออะไร และใครเป็นคนอนุมัติ ที่เก็บ log ของทีม MIT เองก็มีโฟลเดอร์ harness/ ที่บรรจุคอนฟิกูเรชันของ Codex และสคริปต์แซนด์บ็อกซ์ ซึ่งเป็นตัวอย่างอ้างอิงที่มีประโยชน์สำหรับฝั่งแซนด์บ็อกซ์
ขั้นที่ 1: ประเมินฐานของโมเดลที่ยังไม่ถูกแตะต้อง
งานแรกคือรันการประเมินของคุณบนเช็กพอยต์ต้นฉบับ และบันทึกคะแนนพร้อมจุดที่โมเดลล้มเหลว สำหรับ Qwen3.5-0.8B นั้น 93.0% ของการรันชนเพดานโทเคน งานตั้งสมมติฐานจำเป็นต้องใช้คำอธิบายความล้มเหลวนี้
ขั้นที่ 2: อ่านค่าน้ำหนักและเขียนสมมติฐาน
นี่คืองานที่มีงบประมาณกำกับ ใส่ตัวเลขลงในเนื้อความของงาน ในรูปแบบที่ agent อ่านผิดไม่ได้:
## Stage 2: Hypothesis from weights

Model: ./models/qwen3.5-0.8b-base (READ-ONLY, mounted ro)
Budget: 50 forward passes, batch 64. The sandbox stops at 50.
Tools: numpy, torch (CPU), forward() wrapper. No attention tool.
Inputs: Stage 1 failure notes (task COIN-xxx), GSM8K/MATH practice split only.
Output: one-page hypothesis naming layers, tensors and the direction to change,
plus the passes used. Do not write any weights in this stage.
งบประมาณในตัวงานเป็นเพียงคำสัญญา แต่งบประมาณในตัวห่อแซนด์บ็อกซ์คือสิ่งค้ำประกัน เขียนทั้งสองที่ และให้ตัวห่อพิมพ์จำนวนพาสที่ใช้ เพื่อให้ตัวเลขนั้นไปอยู่ใน log ของการรัน
ขั้นที่ 3: แก้ไขในสำเนาบนแซนด์บ็อกซ์
agent ฝ่ายแก้ไขจะแก้สำเนาของเช็กพอยต์และรายงาน diff มันไม่เคยได้สิทธิ์เขียนไฟล์ต้นฉบับ บน Sharkly การรันงานแต่ละครั้งจะได้ไดเรกทอรีแยกของตัวเอง และงานที่เกี่ยวกับรีโพซิทอรีสามารถใช้ worktree แยกต่อการรันหนึ่งครั้ง ได้ ดังนั้นขั้นที่ 3 จึงแตะต้องสิ่งที่ขั้นที่ 1 วัดไว้ไม่ได้
ขั้นที่ 4: ประเมินซ้ำอย่างอิสระโดย agent ฝ่ายตรวจสอบ
มอบหมายขั้นนี้ให้ agent ตัวอื่นที่ไม่ใช่ตัวที่ทำการแก้ไข มันจะรันการประเมินของขั้นที่ 1 ซ้ำ และเพิ่มชุดรีเกรสชันที่ฝ่ายแก้ไขไม่เคยเห็น หากคุณใช้ Crew หัวหน้าทีมสามารถส่งงานแก้ไขให้สมาชิกคนหนึ่ง และส่งงานประเมินซ้ำให้อีกคน รูปแบบนี้สอดคล้องกับ Crew แบบผสมโมเดลที่มีผู้ตรวจสอบแยกออกไป: agent ที่เขียนการเปลี่ยนแปลงไม่ใช่ agent ที่ให้คะแนนมัน
ฝ่ายแก้ไขปรับจูนกับสิ่งที่มันมองเห็นได้เท่านั้น ดังนั้นการเพิ่มขึ้นที่ปรากฏเฉพาะบนโจทย์เหล่านั้นจึงพิสูจน์อะไรได้น้อย
ขั้นที่ 5: ด่านมนุษย์ตรวจ diff
งานสุดท้ายจะส่งถึงมือคนพร้อมไฟล์แนบสามอย่าง: รายการเทนเซอร์ที่เปลี่ยนแปลง ตารางก่อนและหลัง และผลรีเกรสชันจากฝ่ายตรวจสอบ จะไม่มีอะไรโหลดเช็กพอยต์ที่แก้ไขนอกแซนด์บ็อกซ์จนกว่างานนี้จะถูกเลื่อน
สคริปต์สั้น ๆ นี้สร้างไฟล์แนบชิ้นแรก มันเปรียบเทียบเช็กพอยต์ safetensors สองไฟล์ และแสดงรายการเทนเซอร์ทุกตัวที่เปลี่ยนแปลง:
from safetensors import safe_open
import torch

BASE = "models/qwen3.5-0.8b-base/model.safetensors"
EDIT = "sandbox/qwen3.5-0.8b-edit/model.safetensors"

changed, total = [], 0
with safe_open(BASE, "pt") as a, safe_open(EDIT, "pt") as b:
    assert set(a.keys()) == set(b.keys()), "tensor names differ"
    for name in a.keys():
        x, y = a.get_tensor(name), b.get_tensor(name)
        total += x.numel()
        n = (x != y).sum().item()
        if n:
            changed.append((name, n, (x - y).abs().max().item()))

for name, n, dmax in changed:
    print(f"{name}: {n:,} weights changed, max |delta| {dmax:.4g}")
print(f"{sum(c[1] for c in changed):,} of {total:,} weights changed")
บนเช็กพอยต์ที่เผยแพร่ การ์ดโมเดลระบุว่าคุณควรเห็นเทนเซอร์ down_proj.weight แค่สองตัวเท่านั้น หากการแก้ไขของคุณไปแตะเทนเซอร์ที่สมมติฐานไม่ได้ระบุไว้ นั่นคือเหตุผลที่ควรทิ้งมัน
การรันบอร์ดบน Sharkly
นี่คือบอร์ดสำหรับการทดลองหนึ่งครั้ง แต่ละแถวคือหนึ่งงานที่มีผู้รับผิดชอบ สถานะ และประวัติการรันของตัวเอง
| งาน | ผู้รับผิดชอบ | งบประมาณหรือด่าน | เสร็จเมื่อ |
|---|---|---|---|
| 1. ประเมินฐาน | agent ฝ่ายประเมิน | ใช้เฉพาะชุดประเมิน | โพสต์คะแนนและบันทึกความล้มเหลวแล้ว |
| 2. ตั้งสมมติฐานจากค่าน้ำหนัก | agent ฝ่ายแก้ไข | 50 forward pass | โพสต์สมมติฐานแล้ว และบันทึกจำนวนพาสที่ใช้แล้ว |
| 3. แก้ไขในแซนด์บ็อกซ์ | agent ฝ่ายแก้ไข | แก้เฉพาะสำเนา ต้นฉบับอ่านอย่างเดียว | มี diff และไฟล์ที่แก้ไขอยู่ในแซนด์บ็อกซ์ |
| 4. ประเมินซ้ำและรีเกรสชัน | agent ฝ่ายตรวจสอบ | ชุดรีเกรสชันที่กันไว้ | โพสต์ตารางก่อน/หลังแล้ว |
| 5. อนุมัติหรือทิ้ง | คน | ด่านมนุษย์ | บันทึกการตัดสินใจไว้บนงานแล้ว |
เชื่อมแต่ละขั้นตอนด้วยความสัมพันธ์แบบ blocks เพื่อให้บอร์ดแสดงลูกโซ่ของงาน ความสัมพันธ์ของงานใน Sharkly นั้นตรงไปตรงมาเรื่องขอบเขต: ความสัมพันธ์แสดงการพึ่งพาและความคืบหน้าบนการ์ด แต่ไม่ได้เลื่อนงานหรือเริ่มการรันด้วยตัวเอง เก็บแต่ละขั้นตอนไว้ใน Backlog จนกว่าขั้นก่อนหน้าจะเสร็จ งานที่มอบหมายให้ agent จะไม่เริ่มรันขณะที่ยังอยู่ใน Backlog ดังนั้นการย้ายมันออกจาก Backlog คือตัวกระตุ้น
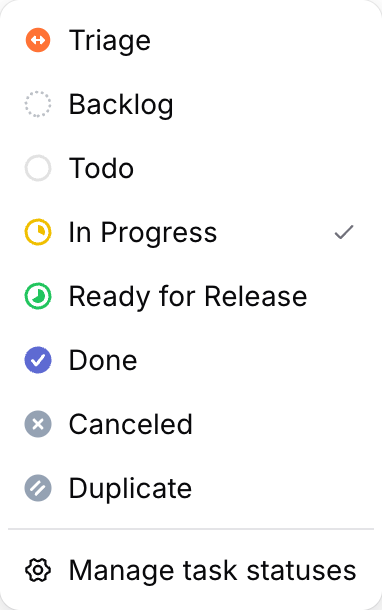
เมื่อขั้นที่ 4 เสร็จ agent สามารถปล่อยให้งานรอการตรวจสอบจากมนุษย์ และคนจะเห็นมันใน Inbox execution log บันทึกเวลาเริ่ม เวลาจบ การเรียกใช้เครื่องมือ และตัวกระตุ้นของแต่ละรัน: นี่คือร่องรอยการตรวจสอบ (audit trail) ของคุณ ที่เก็บไว้กับขั้นตอนที่มันสังกัด สำหรับเรื่องจุดที่ควรหยุด agent ดูเพิ่มเติมได้ที่ ด่านอนุมัติสำหรับ coding agent
ข้อจำกัดในทางปฏิบัติก่อนเริ่ม
- เริ่มจากเล็ก ๆ การศึกษาใช้โมเดลขนาด 0.8B และ 270M ที่เข้าถึงเทนเซอร์ผ่าน CPU เลือกโมเดลที่คุณประเมินได้ภายในไม่กี่นาที
- อย่าคาดหวังว่าจะได้ทักษะที่โมเดลไม่มี ผลกับ Gemma บอกว่าการแก้ไขสามารถปลดล็อกโมเดลได้ แต่ไม่ได้สอนมัน
- มองการรันครั้งเดียวเป็นแค่เกร็ดเรื่องเล่า ทำการทดลองซ้ำด้วย agent ตัวใหม่ก่อนที่คุณจะเชื่อใจการแก้ไขนั้น
บทสรุป
บทเรียนที่นำกลับมาใช้ซ้ำได้จากบทความ MIT คือ harness: งบประมาณที่เขียนไว้เป็นลายลักษณ์อักษร เครื่องมือที่จำกัด log ที่ครบถ้วน และผลลัพธ์ที่คนอื่นสามารถตรวจสอบได้ นั่นคือมาตรการควบคุมที่คุณอยากมีล้อมรอบ coding agent ที่แก้ไขโค้ดอยู่แล้ว
ถ้าอยากลอง สร้างงานทั้งห้าใน Sharkly Space มอบหมายขั้นที่ 1 ถึง 4 ให้ agent บน Computer ที่คุณเชื่อมต่อไว้ และเก็บขั้นที่ 5 ไว้ทำเอง Sharkly เริ่มใช้ฟรีได้ที่ sharkly.ai
คำถามที่พบบ่อย
coding agent แก้ไขค่าน้ำหนักโมเดลได้ไหม
ในการศึกษาของ MIT CSAIL นั้นได้ GPT-6 Astra อ่านเทนเซอร์ของ Qwen3.5-0.8B ในแซนด์บ็อกซ์ Python และแก้ไขค่าน้ำหนัก 131,072 ตัว ผู้เขียนรายงานว่า MATH-500 เพิ่มขึ้นจาก 7.9% เป็น 48.1% งานนี้ยังอยู่ในช่วงเริ่มต้น ทำกับโมเดลขนาดเล็ก และหลายผลลัพธ์มาจากการรันเพียงครั้งเดียว
weight-space programming คืออะไร
คือการที่ LLM อ่านพารามิเตอร์ของเครือข่ายเป็นข้อมูล แล้วแก้ไขโดยตรงโดยไม่ต้องเทรน มันวิเคราะห์เทนเซอร์ด้วยโค้ด ตั้งสมมติฐาน เปลี่ยนค่าน้ำหนัก และวัดผลด้วยจำนวน forward pass ที่จำกัด
ทำไมงบประมาณ forward pass จึงสำคัญ
ในการทดลอง ablation กับ Qwen ของผู้เขียน 10 พาสทำได้ 12.3% บน MATH-500, 25 พาสทำได้ 14.1% และ 50 พาสทำได้ 48.1% งบประมาณกำหนดว่า agent ทดลองไอเดียได้กี่แบบ เขียนมันลงในงานและบังคับใช้ในแซนด์บ็อกซ์
การแก้ไขค่าน้ำหนักเพิ่มความสามารถใหม่ให้โมเดลได้ไหม
การศึกษาบ่งชี้ว่าไม่ได้ การแก้ไขที่ดีที่สุดของ Astra ขยับ Gemma 3 270M จาก 6.8% เป็น 7.7% บน MATH-500 ผู้เขียนสรุปว่าการแก้ไขขจัดอุปสรรคใน Qwen มากกว่าเพิ่มความสามารถ
ทำอย่างไรไม่ให้ค่าน้ำหนักที่แก้ไขแล้วหลุดไปถึงโปรดักชัน
เมานต์ต้นฉบับเป็นแบบอ่านอย่างเดียว แก้ไขบนสำเนา รันการประเมินซ้ำอย่างอิสระ และกำหนดให้คนอนุมัติ diff ของเทนเซอร์ก่อนที่อะไรจะโหลดไฟล์นั้นนอกแซนด์บ็อกซ์


