
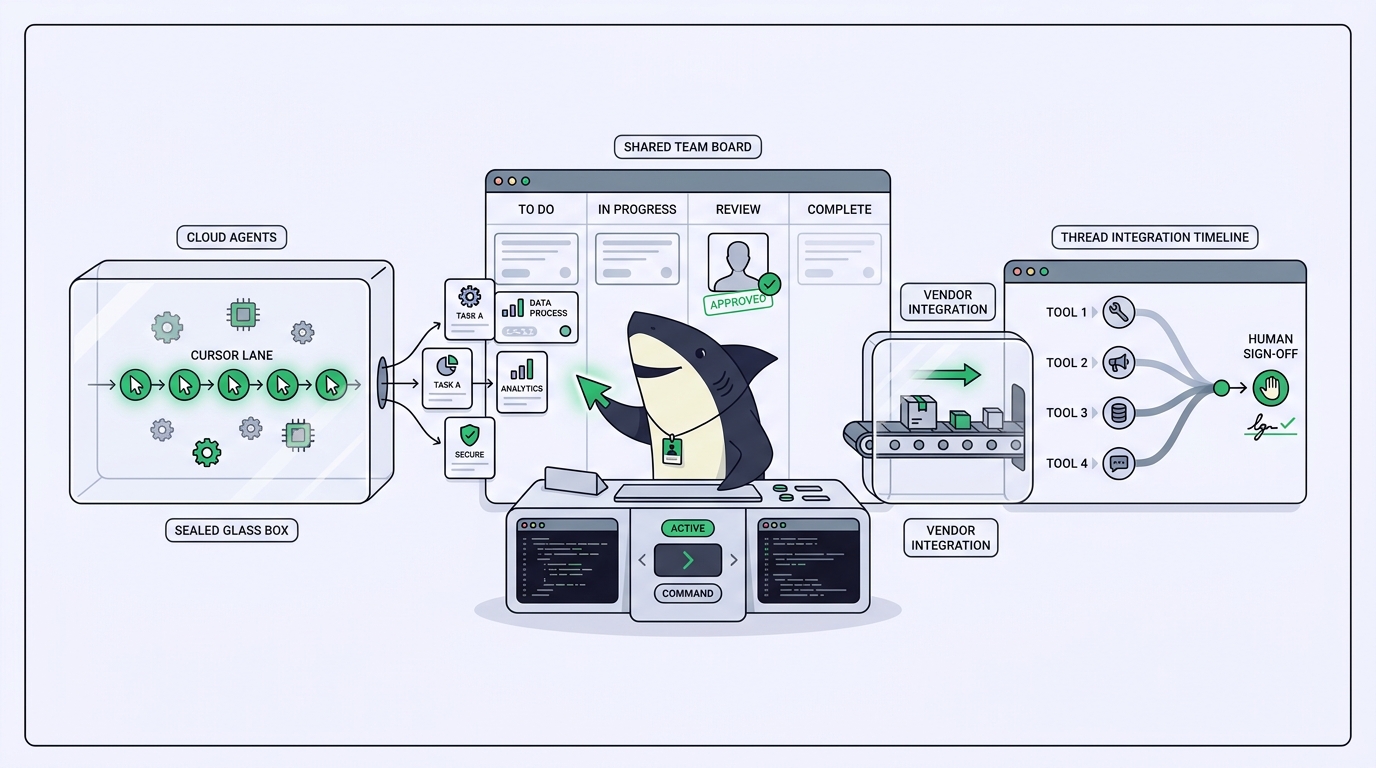
คุณเปิด pull request แล้วก็รอ อยู่ที่ไหนสักแห่งในคลาวด์ agent ที่คุณสั่งให้เริ่มทำงานเมื่อสิบนาทีก่อนกำลังโคลน repo ของคุณ รันชุดทดสอบ และ push commit ขึ้น branch ขณะที่คุณพิมพ์ไฟล์อื่นต่อไป นั่นคือคำสัญญาของ Cursor background agents และสำหรับงานบางประเภท มันก็ทำได้จริงตามที่รับปาก ปัญหาจะเริ่มขึ้นทันทีที่ทีมของคุณใช้เครื่องมือเขียนโค้ดมากกว่าหนึ่งตัว คู่มือนี้จะอธิบายว่า background agent คืออะไร เก่งจริงเรื่องอะไร และมีข้อจำกัดหนึ่งข้อที่ตัดสินว่ามันเพียงพอด้วยตัวเองหรือไม่ นั่นคือ มัน orchestrate Cursor ไม่ใช่ส่วนอื่น ๆ ของ stack คุณ
ถ้าทีมของคุณใช้ runtime ผสมกันอยู่แล้ว ไม่ว่าจะเป็น Claude Code ในเทอร์มินัลหนึ่ง Codex ในอีกอัน หรือ agent ของ Gemini บนแล็ปท็อปของเพื่อนร่วมทีม คำตอบที่ตรงไปตรงมาคือคุณต้องมี layer ที่อยู่เหนือเครื่องมือทั้งหมดนั้น layer นั้นคือ Sharkly แพลตฟอร์มสั่งการและจัดการ Agent แบบครบวงจร เราจะพาคุณดูว่า background agent โดดเด่นตรงไหน หยุดอยู่ตรงไหน และ layer ที่เป็นกลางช่วยให้มองเห็นทั้ง fleet ได้อย่างไรตั้งแต่คำขอจนถึงการ release
สรุปสั้น ๆ
Cursor background agents คือ coding agent ที่โฮสต์บนคลาวด์ ทำงานแบบ asynchronous ใน remote environment ที่แยกออกมา เปิดใช้งานจาก Cursor editor หรือ Slack และส่งงานออกมาเป็น branch หรือ pull request เหมาะอย่างยิ่งเมื่อทั้งทีมของคุณอยู่กับ Cursor ทั้งหมด พวกมัน orchestrate agent ของ Cursor เอง จึงไม่ได้ประสานงานกับ Claude Code, Codex, Gemini หรือ agent ที่รันบนเครื่องอื่น และไม่ได้มอบ review layer ร่วมหนึ่งเดียวให้ทีมที่ใช้ runtime ผสมกัน ใช้ background agents ในฐานะเครื่องมือเดียวของ Cursor ใช้ layer ที่เป็นกลางอย่าง Sharkly เมื่อทีมใช้หลาย runtime และต้องการการมอบหมาย context และการรีวิวโดยคนร่วมกัน across ทุกตัว
Cursor background agents คืออะไรกันแน่
Cursor background agent คือ coding agent ที่ทำงานแบบ asynchronous ใน remote environment ที่ Cursor เตรียมไว้ให้ แทนที่จะทำงานในเซสชัน editor บนเครื่องของคุณ ประโยคเดียวนี้สรุปแนวคิดทั้งหมดได้ Cursor agent ปกติทำงานใน editor บนเครื่องคุณขณะที่คุณนั่งดูอยู่ ส่วน background agent จะออกจากเครื่องคุณ โคลน repository ไปยัง cloud environment ที่แยกเป็น sandbox แล้วทำงานด้วยตัวเองขณะที่คุณไปทำอย่างอื่น
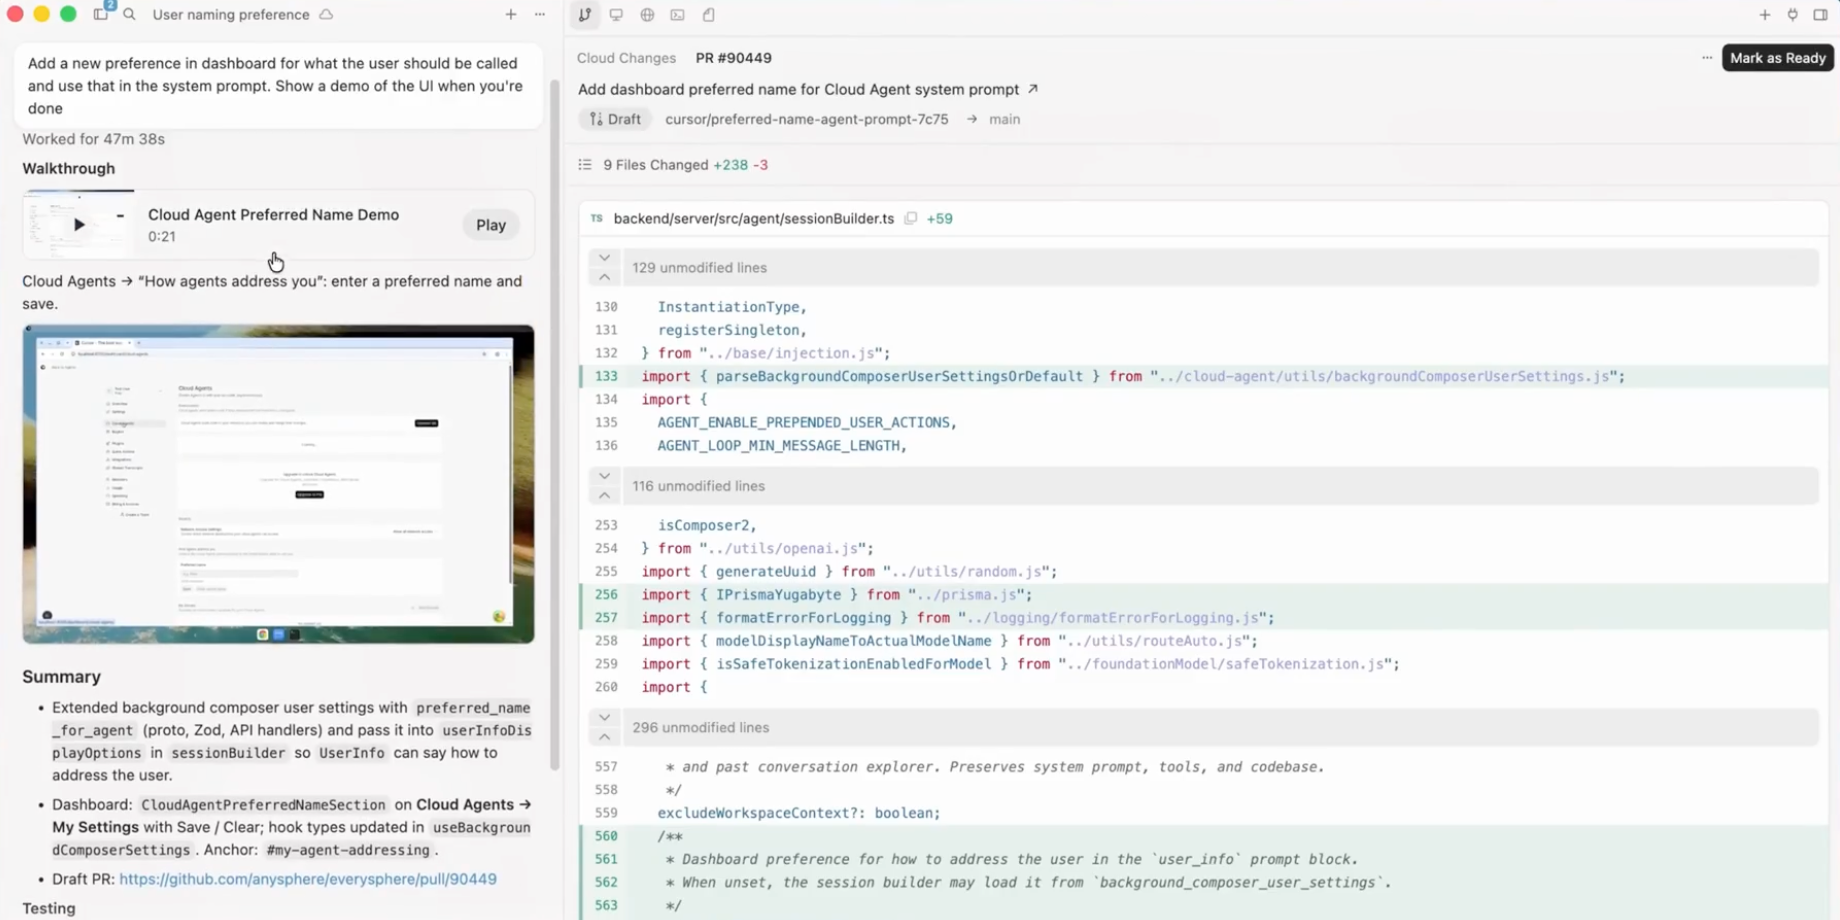
คุณเริ่มมันได้จากใน Cursor หรือโดยการ mention agent ใน Slack เพื่อให้เพื่อนร่วมทีมสั่งงานได้โดยไม่ต้องเปิด editor agent จะอ่านงานที่สั่ง แก้ไขข้ามไฟล์ รันคำสั่งในเทอร์มินัล ติดตั้ง dependencies รันเทสต์ และ push งานขึ้น branch เมื่อเสร็จ คุณจะได้ branch หรือ pull request ที่นำไปรีวิวได้ และคุณสามารถกระโดดเข้าไปใน environment ของ agent เพื่อลงมือทำต่อเองได้ ถ้าอยากปิดงานช่วงสุดท้ายด้วยตัวเอง
หัวใจของคำว่า "background" คือ throughput คุณไม่ถูกบล็อกระหว่างที่ agent ทำงาน คุณสั่งมันรวดเดียวสามตัวเพื่อจัดการสาม issue ที่แยกกัน แล้วเขียนโค้ดตัวที่สี่ต่อไปได้ ถ้าคุณเคยอ่านบทความอธิบายของเราเรื่อง agent orchestration หมายถึงอะไร นี่คือ orchestration ในรูปแบบ vendor เดียว: เครื่องมือเดียว คลาวด์เดียว แต่รันขนานกันได้หลายงาน
background agents เก่งเรื่องอะไร
ลองสมมติว่าฟีเจอร์นี้ทำได้ดีที่สุด เพราะมันทำได้ดีจริง นี่คือจุดที่ background agents พิสูจน์คุณค่าของตัวเอง
รันขนานแบบ async โดยไม่ต้องเจ็บตัวบนเครื่องตัวเอง การรัน agent หลายตัวพร้อมกันบนแล็ปท็อปของคุณหมายถึงต้อง juggle ทั้งแท็บเทอร์มินัล git worktree และ CPU อยู่ตลอด background agents ย้ายภาระนั้นไปไว้บนคลาวด์ของ Cursor การรันขนานจึงไม่สร้างภาระให้เครื่องคุณเลย สำหรับทีมที่เคยต่อระบบนี้ด้วยมือ คู่มือของเราเรื่อง การรัน Claude Code agents หลายตัวพร้อมกัน แสดงให้เห็นว่าเวอร์ชัน DIY ยุ่งยากแค่ไหน background agents ตัดขั้นตอนตั้งค่านั้นออกไปจาก Cursor ทั้งหมด
Environment แยกกันในแต่ละรอบการทำงาน background agent แต่ละตัวได้ environment ของตัวเอง ดังนั้น agent สองตัวที่แก้ไฟล์ทับซ้อนกันจะไม่ทำให้ state ของกันและกันเสียหาย นี่คือหลักความปลอดภัยเดียวกับ git worktrees สำหรับ coding agents เพียงแต่นำมาปรับใช้บนคลาวด์ คุณตั้งค่า environment ครั้งเดียว ทั้งคำสั่งติดตั้ง base image และ secrets แล้วทุกรอบการทำงานในอนาคตก็สืบทอดค่านั้นไปใช้
จุดสั่งงานที่อยู่ตรงที่งานเกิดขึ้นอยู่แล้ว เพราะคุณสั่ง background agent ได้จาก Slack product manager หรือเพื่อนร่วมทีมที่ไม่เคยเปิด Cursor ก็ยังเริ่มงานได้ "แก้ลิงก์ที่เสียบนหน้า pricing ให้หน่อย" กลายเป็นข้อความข้อความหนึ่ง แล้วมี branch ส่งกลับมา นี่คือการลดแรงเสียดทานได้จริง
การส่งต่องานเข้าสู่ขั้นตอนรีวิวที่สะอาด ผลลัพธ์คือ branch หรือ pull request ซึ่งเข้าสู่กระบวนการรีวิวบน GitHub ที่ทีมคุณเชื่อถืออยู่แล้วได้ทันที ไม่ต้องไปดูที่ใหม่ diff ของ agent จะโผล่ในที่ที่ diff โผล่เสมอ
สำหรับทีมที่ตั้งมาตรฐานเป็น Cursor ทั้งระบบตั้งแต่ต้นจนจบ นี่คือ loop ที่เรียบร้อยและทรงพลัง อธิบายงาน สั่ง agent รีวิว pull request แล้ว merge ถ้าคุณเป็นแบบนั้น background agents อาจเป็น orchestration ทั้งหมดที่คุณต้องใช้ และคุณหยุดอ่านตรงนี้ได้อย่างสบายใจ
ข้อจำกัดที่ต้องพูดตรง ๆ: มัน orchestrate Cursor ไม่ใช่เครื่องมืออื่นของคุณ
นี่คือเส้นแบ่งที่ฝ่ายการตลาดมักไม่ค่อยบอกคุณ background agents orchestrate Cursor พวกมันรัน agent ของ Cursor บนคลาวด์ของ Cursor ควบคุมจาก Cursor หรือ Slack แล้วส่งงานไปยัง Git host ของคุณ ทุกส่วนในประโยคนั้นล้วนเป็นส่วนของ Cursor ทั้งหมด นั่นไม่ใช่ข้อบกพร่อง แต่เป็นดีไซน์โดยตั้งใจ แต่มันกำหนดขีดจำกัดที่ชัดเจนในวันที่ความเป็นจริงของทีมคุณไม่ใช่ "ทุกคนใช้ Cursor" อีกต่อไป
background agent ไม่ได้รัน Claude Code, Codex, Gemini หรือ OpenCode มันรัน agent ของ Cursor ถ้าครึ่งหนึ่งของทีมย้ายไปใช้ Claude Code ในเทอร์มินัลเพราะเข้ากับ workflow ของตัวเอง งานเหล่านั้นก็อยู่ในโลกที่แยกออกไปโดยสิ้นเชิง ไม่มี timeline ร่วมที่งานของ Cursor background agent กับงานที่รันด้วย Claude Code จะอยู่เคียงข้างกัน
background agent ไม่ได้มอบ review layer เดียวที่ครอบทุกเครื่องมือ งานของมันกลับไปเป็น pull request บน GitHub ซึ่งก็โอเค จนกระทั่งคุณมี agent ที่รันอยู่ที่อื่นด้วย ซึ่งความคืบหน้า อุปสรรค และผลลัพธ์ไม่เคยไปถึงที่เดียวกัน ตอนนี้ "single source of truth" ของคุณกลายเป็นสามแหล่งความจริง
background agent ไม่ได้จัดการการมอบหมายงานระดับทีมข้าม runtime มันไม่มีความคิดเรื่อง "Task นี้เป็นของคนนี้ รันบน Computer เครื่องนั้น ด้วย Agent ตัวนี้ และนี่คือเกณฑ์การยอมรับงาน" มันรู้แค่ repo กับ prompt ส่วน coordination layer ที่ทีมคุณต้องการ ทั้งใครรับผิดชอบอะไร อะไรติดบล็อก อะไรกำลังรอคนรีวิว อยู่นอกขอบเขตของมัน
ทั้งหมดนี้ไม่ใช่การตำหนิ Cursor การบอกตรง ๆ ว่าเครื่องมือหนึ่งไม่ใช่อะไร ณ จุดที่ผู้อ่านอาจเข้าใจผิด เป็นสิ่งจำเป็น: background agents เป็นฟีเจอร์ orchestration ของ vendor เดียว ไม่ใช่ coordination layer ที่เป็นกลางสำหรับ fleet ที่ใช้หลายเครื่องมือ ถ้าคุณใช้แค่ Cursor ตลอด ข้อจำกัดนี้ก็ไม่เคยทำร้ายคุณ แต่ทันทีที่คุณใช้สอง runtime มันก็ทำ
ทางเลือกสองทาง: orchestration จาก vendor เดียว หรือ layer ที่เป็นกลาง
ทางเลือกนี้ไม่ใช่ "เครื่องมือดีกับเครื่องมือแย่" แต่เป็น "orchestration รูปแบบไหนที่เข้ากับทีมของคุณ" นี่คือทางเลือกสองทางที่ต้องพูดกันตรง ๆ
ใช้ Cursor background agents เมื่อคุณอยู่กับ Cursor ทั้งหมด editor เดียว agent เดียว คลาวด์เดียว ทั้งทีมเขียนโค้ดใน Cursor รีวิวบน GitHub และไม่มีแผนจะเพิ่ม runtime อื่น ในโลกแบบนั้น background agents คือเส้นทางที่สั้นที่สุดจากไอเดียไปสู่ branch ที่ผ่านการรีวิว และการเพิ่ม layer อีกชั้นจะเป็น overhead ที่คุณไม่จำเป็นต้องแบก
ใช้ layer ที่เป็นกลางเมื่อทีมใช้ runtime ผสมกันและต้องการการรีวิวร่วม ทันทีที่คุณมี Claude Code ที่หนึ่ง Codex อีกที่หนึ่ง และมีคนใช้ Cursor ปนอยู่หนึ่งหรือสองคน สิ่งที่คุณขาดไม่ใช่ agent เพิ่ม แต่เป็นบันทึกที่ใช้ร่วมกัน คุณต้องการ Task หนึ่งรายการที่เก็บเป้าหมาย diff การพูดคุย และการรีวิวโดยคนไว้ด้วยกัน ไม่ว่างานนั้นจะทำด้วย runtime ไหน นั่นเป็นงานของ layer ที่อยู่เหนือทุกเครื่องมือ ไม่ใช่ layer ที่อยู่ในเครื่องมือใดเครื่องมือหนึ่ง
นี่คือทางแยกเดียวกับที่นักพัฒนาต้องเลือกเมื่อโตเกินบอร์ดในเครื่องแล้ว ซึ่งเราเขียนไว้ใน คู่มือทางเลือกแทน Vibe Kanban orchestration จาก vendor เดียวจะสบายไปเรื่อย ๆ จนถึงวินาทีที่ vendor นั้นไม่ใช่เรื่องทั้งหมดอีกต่อไป
Sharkly อยู่ตรงไหน: layer กลางที่ครอบทุก runtime
Sharkly ไม่ใช่ตัวแทนของ Cursor, Claude Code, Codex หรือเครื่องมือ execution อื่น ๆ มันเพิ่ม layer ที่ใช้ร่วมกันสำหรับ Task, Computer, context, การควบคุม และการรีวิว ให้ครอบเครื่องมือที่ทีมคุณใช้อยู่แล้ว ประโยคนี้คือความสัมพันธ์ทั้งหมด อ่านสองรอบเลยก็ได้ คุณยังเก็บ Cursor ไว้ คุณยังใช้ background agents ของมันในจุดที่เหมาะสม Sharkly คือสิ่งที่ประสานงานทั้ง fleet เมื่อ fleet ใหญ่กว่า vendor เดียว
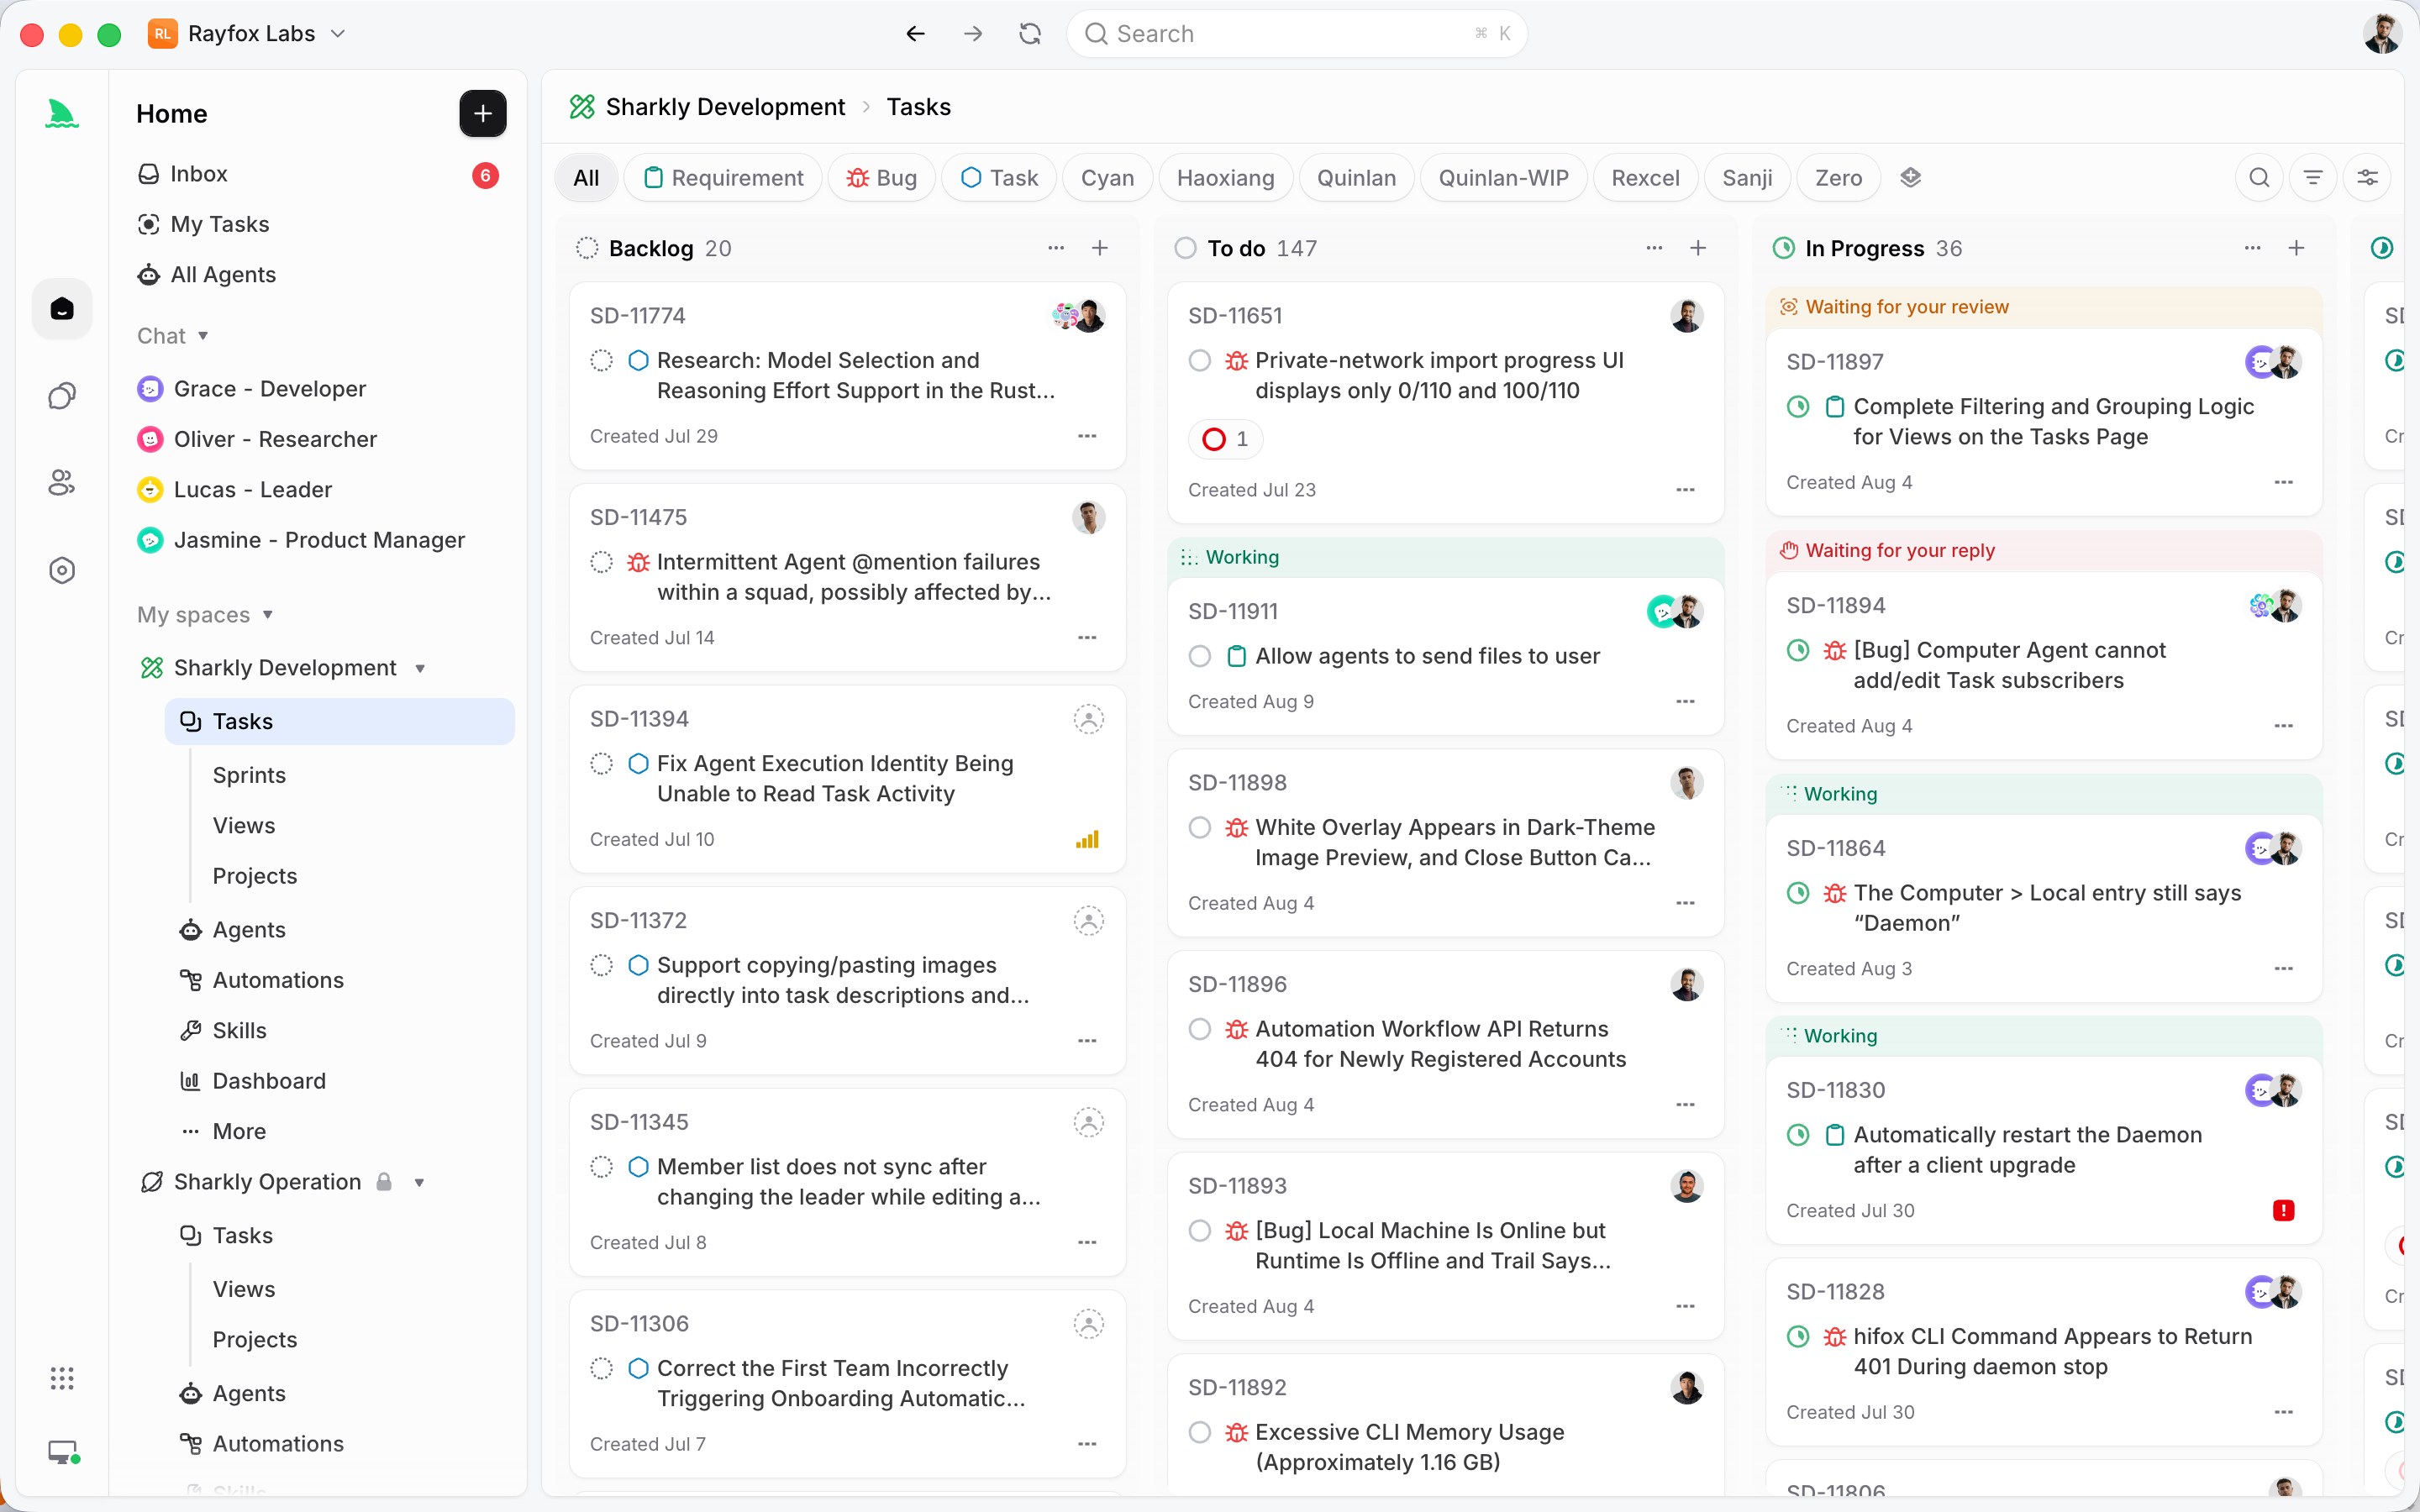
การแบ่งงานกันชัดเจน Cursor, Claude Code, Codex และเครื่องมือทำนองเดียวกันทำหน้าที่ execution ส่วน Sharkly จัดการการมอบหมายงานระดับทีม, Computer ที่เชื่อมต่อ, context ของ Task, ความคืบหน้า, อุปสรรค, ผลลัพธ์ และการรีวิวโดยคนข้ามเครื่องมือเหล่านั้น agent ค้นคว้า ลงมือทำ ทดสอบ และรายงาน คนกำหนดทิศทาง ให้อำนาจ และยอมรับผลลัพธ์ ระบบอัตโนมัติจะหยุดตรงจุดที่ต้องใช้วิจารณญาณของทีม
พูดให้ชัด ๆ Task ใน Sharkly คือหน่วยหลักของงาน และมันเก็บทุกอย่างเกี่ยวกับงานชิ้นหนึ่งไว้ในที่เดียว คุณมอบหมายมันให้ Agent ที่รันบน Computer ที่คุณควบคุม ด้วย Runtime ที่คุณเลือก การลงมือทำ อุปสรรค ผลลัพธ์ และการพูดคุยติดตามผลจะกลับมาอยู่บน timeline ของ Task แทนที่จะกระจัดกระจายไปตามเทอร์มินัลส่วนตัว คลาวด์ของ vendor รายหนึ่ง และเธรดใน Slack เป้าหมาย diff การพูดคุย และการรีวิวของทุกรอบการทำงานอยู่ด้วยกัน ไม่ว่ารอบนั้นจะใช้ Claude Code หรือ Codex หรือเครื่องมืออะไรก็ตามที่คุณจะนำมาใช้ปีหน้า
และมันไม่ขอให้คุณสร้างอะไรใหม่ทั้งหมด ใช้เครื่องมือที่ทีมคุณใช้อยู่ต่อไป แต่ทำให้แต่ละรอบการทำงานมอบหมายและติดตามได้ การใช้งานโมเดลยังคงผ่าน subscription หรือ API key ที่ตั้งค่าไว้ในเครื่องมือเหล่านั้น คุณจึงใช้ subscription ของตัวเอง และ Sharkly เพิ่ม layer การประสานงานเข้าไปด้านบน ถ้าคุณเพิ่งรู้จักแพลตฟอร์มนี้ ทำความรู้จัก Sharkly จะพาดูแนวคิดหลัก และคู่มือเริ่มงานแรกจะแสดงเวอร์ชันที่ใช้งานได้จริงที่เล็กที่สุดตั้งแต่ต้นจนจบ คุณสามารถดาวน์โหลด Sharkly และเชื่อมต่อ Computer หนึ่งเครื่องเพื่อลองกับงานจริงได้
ตัวอย่างการใช้งานจริง
สมมติทีมของคุณรับ ticket SH-312: "เพิ่ม rate limiting ให้ public API และเขียนเทสต์ครอบคลุม" มาดูว่าทั้งสองรูปแบบจัดการมันอย่างไร
ถ้าใช้แค่ background agents คนที่ใช้ Cursor จะสั่ง background agent ขึ้นมาตัวหนึ่ง มันทำงานบนคลาวด์ของ Cursor แล้วส่ง pull request กลับมา ดีอยู่หรอก ตราบใดที่คนที่ทำคือคนที่ใช้ Cursor คนนั้น แต่หัวหน้าฝ่าย backend ของคุณรัน Claude Code และอยากรับส่วน middleware ที่ยากกว่า ตอนนี้ SH-312 มีทั้ง pull request จาก Cursor และเซสชัน Claude Code แยกกันโดยไม่มีบ้านร่วม ใครก็ตามที่รีวิวต้องเอาสองอย่างมาเชื่อมกันด้วยความจำ
ถ้าใช้ Sharkly SH-312 คือ Task เดียว Agent ฝั่ง middleware รันบน Computer ของหัวหน้าทีมภายใต้ Claude Code ส่วน Agent ที่ทำ test coverage รันภายใต้ Runtime อีกตัว และทั้งคู่ส่งงานกลับมาที่ Task เดียวกัน คนรีวิวเปิดดูที่เดียวแล้วเห็นภาพทั้งหมด: แต่ละ Agent ทำอะไร อะไรติดบล็อก อะไรผ่าน typecheck และเทสต์ และอะไรกำลังรอการตัดสินใจจากคน งาน frontend, backend และ test coverage เดินหน้าไปพร้อมกัน ซึ่งเป็นรูปแบบการพัฒนาขนานที่เราอธิบายไว้ในagentic coding หมายถึงอะไรจริง ๆ คนเป็นคนกดยอมรับ ขอแก้ไข หรือตัดสินใจ merge runtime ยังคงเป็นอย่างที่เคยเป็น สิ่งที่เพิ่มเข้ามาคือการประสานงาน
ข้อผิดพลาดที่พบบ่อยและควรหลีกเลี่ยง
- เข้าใจว่า "background" หมายถึง "ไม่มีคนดูแล" ไม่ใช่แบบนั้น ทั้ง background agents และ orchestration layer ใด ๆ ยังต้องมีการยอมรับจากคน ปล่อยให้การยอมรับขั้นสุดท้ายและการตัดสินใจ release เป็นเรื่องของคน และอ่านทุก diff ก่อน merge
- นำ orchestration ของ vendor รายเดียวมาใช้ราวกับเป็นกลยุทธ์ทั้งหมดของคุณ ถ้าวันนี้คุณตั้งมาตรฐานเป็น background agents แล้วไตรมาสหน้าเพิ่ม Claude Code คุณก็แยกพื้นที่รีวิวออกเป็นสองส่วนโดยไม่รู้ตัว ตัดสินใจตั้งแต่เนิ่น ๆ ว่าคุณเป็นทีมที่ใช้ runtime เดียวหรือ fleet ที่ใช้ผสมกัน
- ข้ามการตั้งค่า environment background agent จะดีได้เท่ากับ environment ที่คุณตั้งไว้ให้มัน การตั้งค่าแบบคลุมเครือหมายถึงรอบการทำงานที่เอาแน่เอานอนไม่ได้ กำหนด base image คำสั่งติดตั้ง และ secrets ให้ชัดเจน เพื่อให้ทุกรอบเริ่มจากสถานะที่รู้แน่นอนเหมือนกัน
- ใช้ pull request เป็น coordination layer pull request คือพื้นที่รีวิว ไม่ใช่ layer สำหรับมอบหมายงานและเก็บ context ใครเป็นเจ้าของ Task มันขึ้นกับอะไร และทำไมถึงติดบล็อก ไม่สามารถยัดใส่ diff ได้
Cursor background agents vs. orchestration layer ที่เป็นกลาง
อ่านส่วนนี้เป็นการแบ่งงานกัน ไม่ใช่การให้คะแนน
| มิติ | Cursor background agents | Layer ที่เป็นกลาง (Sharkly) |
|---|---|---|
| รัน agent ตัวไหน | agent ของ Cursor | Claude Code, Codex, Gemini, OpenCode และอื่น ๆ |
| งานรันที่ไหน | cloud environment ของ Cursor | Computer ที่ทีมคุณเชื่อมต่อและควบคุม |
| จุดสั่งงาน | Cursor editor, Slack | การมอบหมาย Task, CLI, REST API |
| บันทึกร่วมข้ามเครื่องมือ | branch หรือ PR ต่อรอบการทำงาน | Task เดียวที่เก็บ context, ความคืบหน้า, อุปสรรค, ผลลัพธ์ |
| การรีวิวข้าม runtime | เฉพาะ vendor เดียว | การรีวิวโดยคนข้ามทุก runtime ที่เชื่อมต่อ |
| เหมาะที่สุดกับ | ทีมที่ตั้งมาตรฐานเป็น Cursor ทั้งหมด | ทีมที่ใช้ runtime ผสมกันและต้องการการรีวิวร่วม |
| ความสัมพันธ์ | ฟีเจอร์ orchestration ที่อยู่ในเครื่องมือหนึ่ง | layer ที่ครอบเครื่องมือที่คุณใช้อยู่แล้ว |
ไม่มีคอลัมน์ไหน "ผิด" ถ้าคำตอบของคุณในแต่ละแถวไปตกอยู่คอลัมน์ซ้ายเป็นส่วนใหญ่ background agents ก็เหมาะกับคุณ แต่ถ้ามันเริ่มเอนไปทางขวา โดยเฉพาะในแถวที่เกี่ยวกับบันทึกร่วมและการรีวิวข้าม runtime แสดงว่าคุณโตเกิน orchestration จาก vendor เดียวแล้ว
ประเด็นสำคัญ
- Cursor background agents คือ coding agent แบบ asynchronous ที่โฮสต์บนคลาวด์ เปิดใช้งานจาก editor หรือ Slack และส่งงานออกมาเป็น branch หรือ pull request
- พวกมันทำสิ่งเหล่านี้ได้ดี: การรันขนานแบบ async โดยไม่สร้างภาระบนเครื่อง, environment แยกกันในแต่ละรอบ, จุดสั่งงานที่ลดแรงเสียดทาน และการส่งต่องานเข้าสู่การรีวิวบน GitHub อย่างราบรื่น
- ข้อจำกัดของมันเป็นไปตามดีไซน์: พวกมัน orchestrate agent ของ Cursor ไม่ใช่ Claude Code, Codex หรือ Gemini และไม่ได้มอบ review layer ร่วมหนึ่งเดียวให้ทีมที่ใช้ runtime ผสมกัน
- ใช้ background agents เมื่อทั้งทีมของคุณอยู่กับ Cursor ใช้ layer ที่เป็นกลางเมื่อคุณใช้หลาย runtime และต้องการการมอบหมาย context และการรีวิวร่วมกัน
- Sharkly ทำงานเคียงข้าง Cursor ไม่ใช่แทนที่: เก็บเครื่องมือของคุณไว้ ใช้ subscription ของคุณเอง และให้ทุกรอบการทำงานกลับมาที่ Task เดียวตั้งแต่คำขอจนถึงการ release
ขั้นถัดไปตั้งใจให้เล็กไว้ก่อน เชื่อมต่อ Computer หนึ่งเครื่อง สร้าง Agent หนึ่งตัว แล้วมอบหมายงานน่าเบื่อ ๆ ให้มันสักงาน เอกสารของเราอธิบายแต่ละแนวคิดไว้ละเอียดขึ้นที่ docs.sharkly.ai
คำถามที่พบบ่อย
Cursor background agent คืออะไรในหนึ่งประโยค? มันคือ coding agent ที่ทำงานแบบ asynchronous ใน remote environment ที่ Cursor จัดเตรียมไว้ เปิดใช้งานจาก editor หรือ Slack โดยจะโคลน repo ของคุณ แก้ไขโค้ด รันคำสั่ง และส่งงานออกมาเป็น branch หรือ pull request
background agent ต่างจาก Cursor agent ปกติอย่างไร? agent ปกติทำงานในเซสชัน editor บนเครื่องคุณขณะที่คุณนั่งดูอยู่ ส่วน background agent ออกจากเครื่องคุณไปทำงานด้วยตัวเองบนคลาวด์ คุณจึงไม่ถูกบล็อกและรันหลายตัวพร้อมกันได้
Cursor background agents รัน Claude Code หรือ Codex ได้ไหม? ไม่ได้ background agents รัน agent ของ Cursor เอง ถ้าทีมคุณใช้ Claude Code หรือ Codex งานเหล่านั้นจะเกิดขึ้นแยกกัน นี่คือเหตุผลที่ทีมที่ใช้ runtime ผสมกันต้องมี layer ที่เป็นกลางอยู่เหนือทุกเครื่องมือ ดูคู่มือของเราเรื่องการรัน Claude Code agents หลายตัวสำหรับฝั่งนั้นของ fleet
ต้องเปลี่ยนจาก Cursor มาใช้ Sharkly ไหม? ไม่ต้อง Sharkly ไม่ใช่ตัวแทนของ Cursor หรือเครื่องมือ execution ใด ๆ มันเพิ่ม layer ร่วมสำหรับ Task, context และการรีวิวให้ครอบเครื่องมือที่คุณใช้อยู่แล้ว ดังนั้น Cursor และ background agents ของมันยังทำงานเหมือนเดิมทุกประการ
เมื่อไหร่ที่ไม่ควรเพิ่ม orchestration layer เข้าไปด้านบน? ถ้าทั้งทีมของคุณอยู่กับ Cursor และไม่มีแผนจะเพิ่ม runtime อื่น background agents อาจเป็น orchestration ทั้งหมดที่คุณต้องใช้ เพิ่ม layer ที่เป็นกลางเฉพาะเมื่อคุณใช้หลายเครื่องมือและต้องการบันทึกร่วมหนึ่งเดียวที่ครอบทุกตัว
Sharkly เปลี่ยนวิธีจ่ายค่าโมเดลไหม? ไม่เปลี่ยน คุณใช้ subscription ของตัวเอง การใช้งานโมเดลยังคงผ่าน subscription หรือ API key ที่ตั้งค่าไว้ในเครื่องมือที่คุณเชื่อมต่อ และโควตาโมเดลก็ขึ้นอยู่กับแผนและบัญชี API ที่ทีมคุณเชื่อมไว้
จะลองใช้แนวทาง layer ที่เป็นกลางโดยไม่ต้อง migrate ใหญ่ได้อย่างไร? เริ่มจาก workflow ที่เล็กที่สุดที่ใช้งานได้: เชื่อมต่อ Computer หนึ่งเครื่อง สร้าง Agent หนึ่งตัว และมอบหมาย Task ที่มีความเสี่ยงต่ำสักหนึ่งงาน คู่มือเริ่มงานแรกอธิบายไว้ทีละขั้นตอน


