
coding agent สี่ตัวทำงานเสร็จภายในชั่วโมงเดียวกันและเปิด pull request มาสี่รายการ ตัวหนึ่งแตะโค้ดเส้นทางการ retry ของระบบเรียกเก็บเงิน อีกตัวเปลี่ยนชื่อ test helper ตัวหนึ่งเพิ่ม migration และอีกตัวแก้คำผิดใน README คอขวดไม่ใช่ตัวโค้ดหรือเทสต์ แต่เป็นคำถามที่คนต้องตอบก่อนจะได้อ่าน diff สักบรรทัดด้วยซ้ำ นั่นคือ "ฉันควรดูอันไหนก่อน" เราเคยเขียนไว้แล้วว่า การรีวิวโดยมนุษย์คือคอขวด เมื่อ agent ทำงานแบบขนานกัน โพสต์นี้จะพูดถึงส่วนที่เป็นกลไกของปัญหานั้น นั่นคือการจัดลำดับคิว และโมเดลการตัดสินใจอย่าง Jev จะช่วยแบ่งเบาส่วนนี้ออกจากจานของนักรีวิวได้อย่างไร โดยที่ไม่ได้เข้าไปทำหน้าที่รีวิวแทน
Jev คืออะไร
Jev คือ System One Model จาก TypeSafe AI คุณส่ง state หนึ่งชิ้นพร้อมชุดคำถามแบบมีชนิดข้อมูล (typed questions) เข้าไป แล้วมันจะตอบกลับมาทีละคำถามพร้อมความน่าจะเป็นที่ผ่านการปรับเทียบแล้ว (calibrated probability) ไม่ใช่ข้อความอิสระ เพื่อความชัดเจนเรื่องชื่อ Jev นี้หมายถึงโมเดล Jev ของ TypeSafe ไม่ใช่ยูทูบเบอร์หรือวัคซีนไข้สมองอักเสบเจอี โพสต์เปิดตัวของ TypeSafe อธิบายว่าเป็น "รับ state ที่ไม่มีโครงสร้างเข้าไป ส่งการตัดสินใจเชิงความน่าจะเป็นแบบมีชนิดข้อมูลออกมา" ส่วน API มีปลายทางเดียวคือ POST https://api.typesafe.ai/v1/systemone ใช้ Bearer key เลือกโมเดล jev-latest และมีคำถามสามประเภท ได้แก่ noul (ความน่าจะเป็นแบบใช่/ไม่ใช่), choice (เลือกหนึ่งตัวจากตัวเลือกไม่เกิน 255 ตัว) และ score (ตำแหน่งบน rubric ที่มี 2 ถึง 10 ระดับ) รองรับเฉพาะข้อความ 64k โทเคนต่อคำขอ โดยแบ่งเป็น 32k สำหรับ state ราคา $0.042 ต่อล้านโทเคนขาเข้า ส่วนขาออกไม่คิดเงิน โพสต์คู่กันของเราเรื่อง Jev ในฐานะชั้นการตัดสินใจสำหรับ coding agent พูดถึงตัวโมเดลโดยภาพรวม ส่วนในโพสต์นี้เราจะใช้มันกับงานเพียงอย่างเดียว
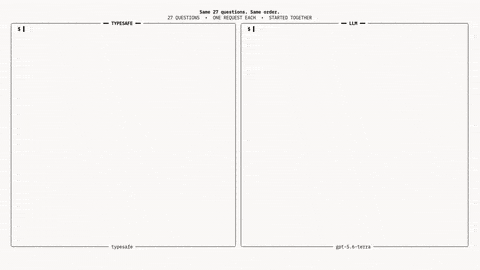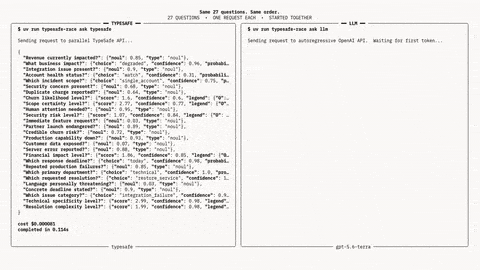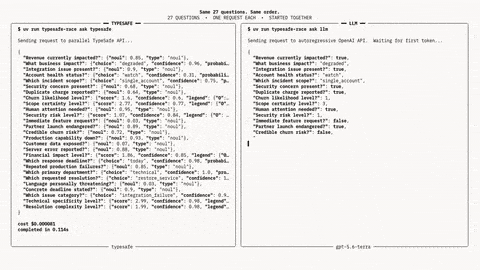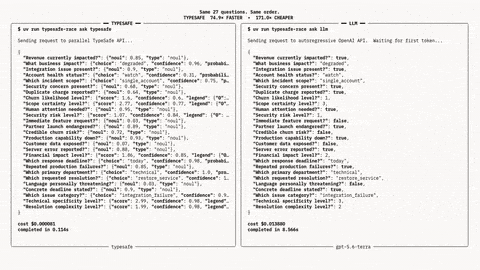
สามคำถามในการรีวิว
ทุก PR ที่ coding agent เปิดขึ้นมาล้วนก่อให้เกิดคำถามสามข้อเดียวกัน และแต่ละข้อก็จับคู่กับ primitive หนึ่งตัว โดย state ที่ส่งไปนั้นเหมือนกันทั้งสามคำถาม นั่นคือสรุป diff ผลการทดสอบ และ path ที่ถูกแตะ ไม่ใช่ diff ทั้งก้อน การใช้สรุปช่วยให้คำขออยู่ในงบประมาณ และทำให้โมเดลยังคงตอบคำถามเรื่องการจัดเส้นทาง แทนที่จะไปรีวิวโค้ดซ้ำอีกครั้ง
อันนี้ต้องให้คนดูก่อน merge ไหม? ใช้ noul นี่คือตัวกรอง มันตัดสินว่า PR นี้จะเข้าคิวของมนุษย์เลยหรือไปรอลำดับความสำคัญต่ำ
ควรให้รีวิวคนไหน หรือเข้าคิวไหน? ใช้ choice จากคิวที่ทีมคุณใช้งานจริง ๆ คำตอบจะมาพร้อมตัวเลือกที่ถูกเลือกและการกระจายความน่าจะเป็นเต็มชุด ดังนั้นการแบ่ง 0.48 / 0.44 ระหว่างสองคิวจึงบอกคุณได้ว่า PR นี้คาบเกี่ยวเส้นแบ่งความเป็นเจ้าของ ซึ่งตัวข้อมูลนี้เองก็มีคุณค่า
มันมีความเสี่ยงแค่ไหน? ใช้ score บน rubric แบบเรียงลำดับ ผลลัพธ์คือตำแหน่งที่ถ่วงน้ำหนักด้วยความน่าจะเป็น ดังนั้นการเปลี่ยนแปลงหนึ่งอย่างอาจตกที่ 2.6 ซึ่งอยู่ระหว่าง "แก้ logic ที่มีเทสต์คลุมอยู่" กับ "แตะ auth, billing หรือข้อมูล" ตัวเลขนี้คือคีย์สำหรับจัดเรียงคิว
คำขอเดียวตอบได้ทั้งสามคำถาม:
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
คำตอบที่ได้คือคำตอบแบบมีชนิดข้อมูลสามค่าภายใต้คีย์เดียวกัน สำหรับ SH-418 คาดว่า needs_human จะอยู่ราว 0.9, queue เลือก payments และ risk จะอยู่ใกล้ระดับบนสุดของ rubric การแก้ระบบ retry ของ billing ที่เทสต์ผ่านทั้งหมดก็ยังต้องไปอยู่หัวคิวของ payments เพราะเทสต์สีเขียวไม่ได้ตอบคำถามที่ว่า "ควรมีคนอ่านอันนี้ไหม"
เกณฑ์ตัดสิน และแต่ละช่วงคะแนนทำอะไร
ความน่าจะเป็นจะมีประโยชน์ก็ต่อเมื่อมีโค้ดแปลงมันเป็นการกระทำ ช่วงคะแนนด้านล่างนี้เป็นเพียงจุดตั้งต้น ไม่ใช่คำแนะนำสำหรับ repository ของคุณ ให้ลองปรับหลังใช้งานไปหนึ่งสัปดาห์
needs_human |
การกระทำ |
|---|---|
| 0.85 ขึ้นไป | หัวคิวของมนุษย์ เรียงตาม risk จากมากไปน้อย |
| 0.15 ถึง 0.85 | คิวของมนุษย์ เรียงตาม risk ต่อจากช่วงข้างบน |
| ต่ำกว่า 0.15 | ช่องทางลำดับความสำคัญต่ำ ยังมีคน merge อยู่ แต่เป็นเวลาของเขาเอง |
มีสองกฎที่ทำให้วิธีนี้ยังซื่อสัตย์ต่อความจริง ข้อแรก risk ที่อยู่ระดับบนสุดของ rubric จะดัน PR ขึ้นมาอยู่ช่วงหัวคิวเสมอ ไม่ว่า needs_human จะบอกว่าอะไร โมเดลที่มั่นใจแค่ 0.12 ว่า schema migration ต้องมีการรีวิว แปลว่ามันเห็นแค่สรุป diff ที่เรียบร้อย ไม่ได้เห็นสภาพโปรดักชันจริง ข้อสอง choice ที่สองตัวเลือกแรกห่างกันไม่เกิน 0.1 ให้ส่งไปทั้งสองคิว ไม่ใช่ไม่ส่งไปเลย ความกำกวมเรื่องความเป็นเจ้าของเป็นเหตุผลให้มีคนสองคนเหลือบดูการเปลี่ยนแปลงนี้ ไม่ใช่เหตุผลให้ไม่มีใครดูเลย
สังเกตว่าสิ่งที่ยังอยู่กับคนในทุกช่วงคะแนนคือการ merge ช่วงคะแนนเปลี่ยนแค่ลำดับการอ่านและความลึกในการอ่านเท่านั้น ไม่เคยเปลี่ยนว่าใครเป็นคนตัดสิน
ใช้ Jev จัดคิว ไม่ใช่ตัดสินผล
ใช้ Jev เมื่อคำถามมีชุดคำตอบที่แน่นอนตายตัว state ที่ส่งไปเป็นสรุปที่ตรงตามจริง และคุณต้องการใช้ความสนใจของคนให้เกิดประโยชน์สูงสุดในลำดับที่ดีกว่า นั่นคือ ใครควรอ่านสิ่งนี้ เร็วแค่ไหน ในคิวไหน คำถามเหล่านี้โผล่มาทุก PR และด้วยราคาระดับนี้ก็ถูกพอที่จะถามทุกครั้งที่รัน
แต่ให้ใช้คน หรือใช้ language model ที่แสดงเหตุผลของตัวเองได้ เมื่อคำถามคือการเปลี่ยนแปลงนี้ถูกต้องหรือไม่ ความน่าจะเป็นที่ว่าการเปลี่ยนแปลงต้องได้รับการรีวิวไม่ใช่การรีวิว Jev ไม่มีคอมไพเลอร์ ไม่มี test runner และไม่ได้เข้าถึงไฟล์ที่มันกำลังให้คะแนน มีแค่สรุปที่คุณส่งไปให้ คะแนน 0.96 ในคำถาม "ปลอดภัยพอจะ merge ได้ไหม" เป็นเหตุผลหนักแน่นที่จะเอา PR นั้นไปไว้บนสุดของรายการใครสักคน แต่ไม่เคยเป็นเหตุผลที่จะข้ามคนคนนั้นไป approval gate อยู่หลังโมเดล และโมเดลไม่มีทางเปิดมันได้เอง
สิ่งที่คอมมูนิตี้สร้างขึ้น
ภายในไม่กี่วันหลังเปิดตัว นักพัฒนาคนหนึ่งได้เผยแพร่ jev-review ซึ่ง README ของโปรเจกต์อธิบายว่าเป็น "เวิร์กโฟลว์รีวิวโค้ดขนาดเล็กที่สร้างด้วย TypeSafe Jev" มันรีวิวได้ทั้ง Git diff หรือทั้ง codebase ตรวจสอบความถูกต้อง ความปลอดภัย ความน่าเชื่อถือ ความเข้ากันได้ และความครอบคลุมของเทสต์ เลือกภูมิภาคของโค้ดก่อนที่จะให้คะแนนผลกระทบ นำเกณฑ์ตัดสินและนโยบายเวิร์กโฟลว์ไปใช้ในโค้ด แล้วแสดงผลในแดชบอร์ดภายในเครื่อง README ระบุขอบเขตของตัวเองไว้อย่างรอบคอบ โดยเรียกโปรเจกต์นี้ว่า "การทดลองนำการตัดสินใจแบบมีชนิดข้อมูลที่รวดเร็วมาประกอบเป็นเวิร์กโฟลว์การรีวิว" และบอกว่ามัน "ยังไม่ได้ผสานรวม compiler diagnostics, static analyzer, การทำดัชนี repository หรือคำอธิบายที่สร้างขึ้นอัตโนมัติ"
มีสองอย่างในดีไซน์นั้นที่ควรเอาแบบอย่าง อย่างแรกคือ orchestration อยู่ในโค้ด และ Jev ตอบแค่คำถามที่มีขอบเขตชัดเจน อย่างที่สองคือการแบ่งงานเป็นขั้น เลือกภูมิภาคก่อน แล้วค่อยให้คะแนน แทนที่จะถามคำถามยักษ์ข้อเดียวครอบทั้ง diff นอกจากนี้ Jev ยังอยู่บน Vercel AI Gateway ในชื่อ typesafe-ai/jev ผ่าน experimental_evaluate ใน AI SDK 7 โดย เอกสารของ Gateway ระบุว่าฟีเจอร์นี้ใช้ได้ผ่าน AI SDK เท่านั้น
เรื่องนี้เข้ากับ Sharkly ตรงไหน
Sharkly ไม่ได้เรียก Jev แทนคุณ และก็ไม่ใช่โมเดลการตัดสินใจ มันคือชั้นสำหรับงานที่ใช้ร่วมกัน, Computer, context และการรีวิวที่ห่ออยู่รอบ coding agent ที่ทีมคุณใช้อยู่แล้ว สิ่งที่คิวที่จัดลำดับแล้วต้องการจากชั้นนี้ก็คือ ที่ให้รัน และที่ให้ผลลัพธ์ไปตกอยู่
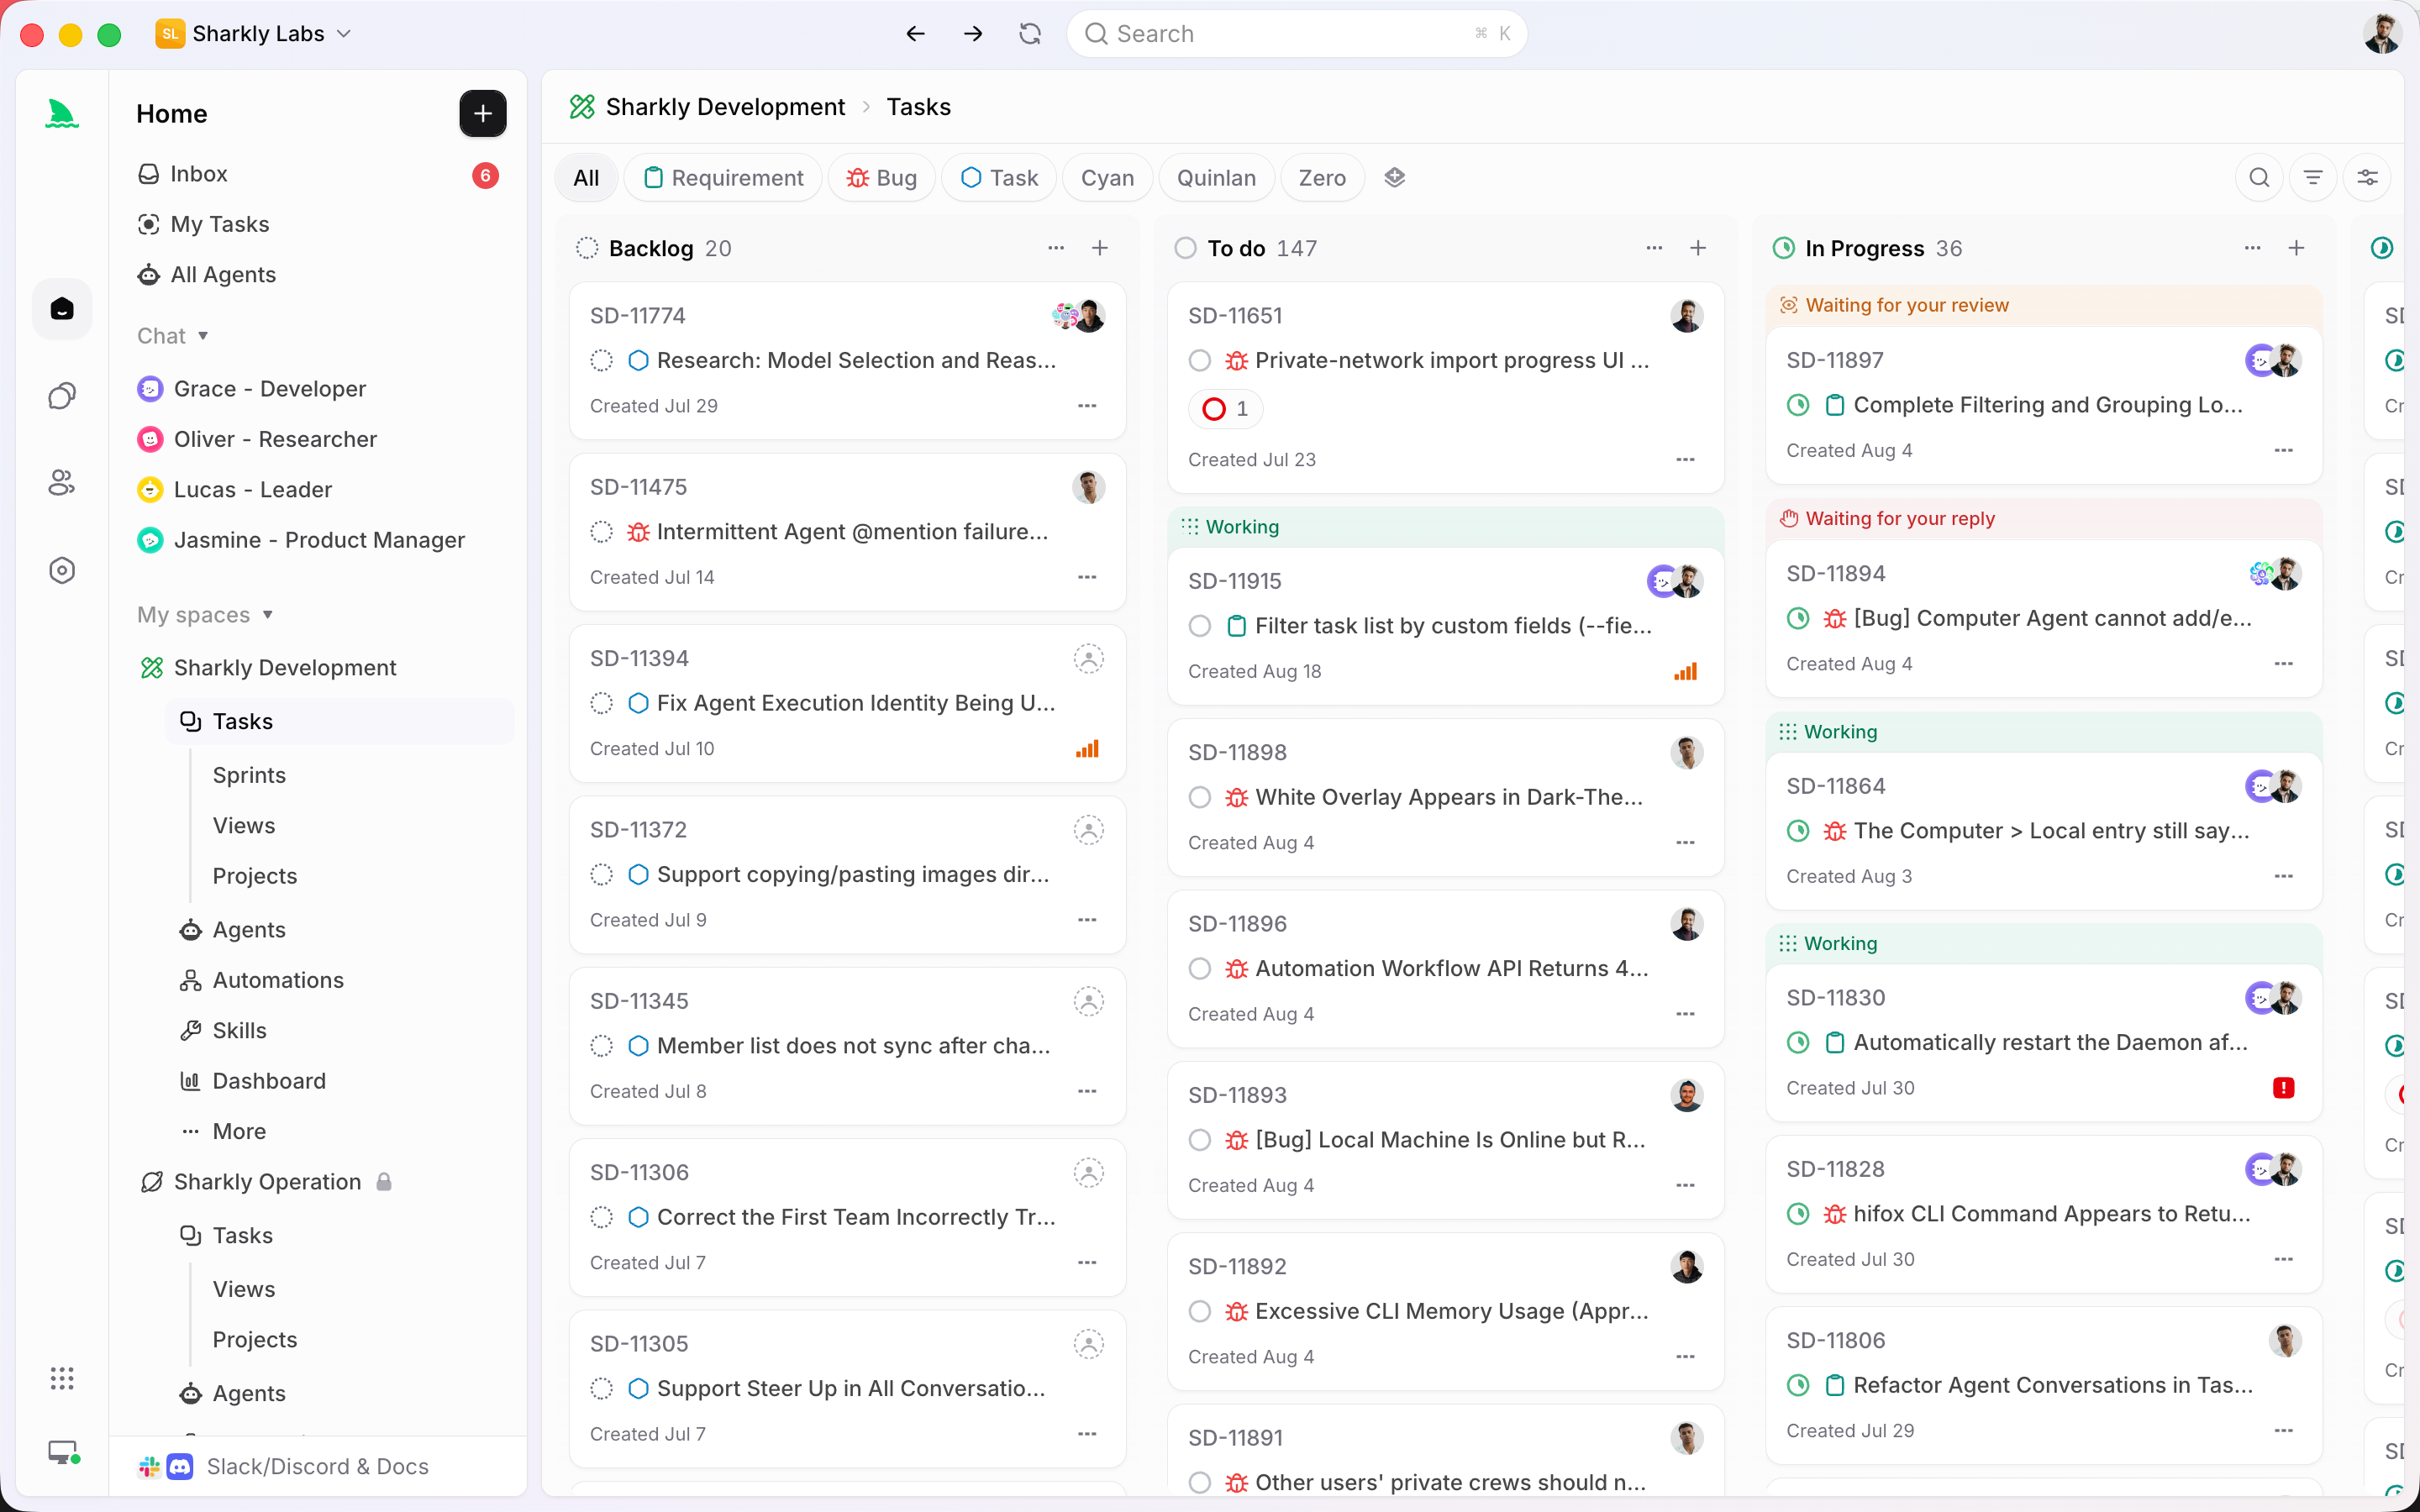
ที่ให้รันคือ Automation ซึ่งเป็นกฎที่ Space เป็นเจ้าของ ใช้เริ่ม Agent พร้อมชุดคำสั่งเมื่อมีทริกเกอร์เกิดขึ้น และทริกเกอร์หนึ่งก็คือเมื่อ Task เคลื่อนเข้าสู่สถานะที่กำหนด ตั้งให้มันทำงานเมื่อ Agent ไปถึงสถานะที่ PR เปิดขึ้น แล้วชุดคำสั่งก็จะเป็น: อ่านสรุป diff ผลการทดสอบ และ path ที่ถูกแตะของ Task นั้น เรียก Jev ด้วยคำถามสามข้อ เขียนคำตอบและช่วงคะแนนกลับไปเป็นคอมเมนต์บน Task แล้วติด label สำหรับคิว เอกสารระบุชัดเจนว่าการรันที่เสร็จสมบูรณ์ "ไม่ใช่คำสัญญาว่าผลลัพธ์ทางธุรกิจปลายทางทุกอย่างจะถูกต้อง" ซึ่งเป็นขอบเขตเดียวกับที่ช่วงคะแนนการรีวิวขีดไว้
ที่ให้ผลลัพธ์ไปตกอยู่คือตัว Task เอง ช่วงคะแนน คิว และคะแนนความเสี่ยงจะกลับไปอยู่บน Task ที่นักรีวิวมองอยู่แล้ว ข้าง ๆ สรุปการเปลี่ยนแปลงและผลการตรวจสอบของการรันนั้น คนเปิดบอร์ดที่เรียงตามความเสี่ยง แล้วเห็นว่าทำไม PR แต่ละอันถึงอยู่ตรงที่มันอยู่ Agent เปิด pull request รันเทสต์ แล้วรายงานกลับ ส่วนคนอ่านตามลำดับที่คิวย่อยเสนอ และตอบรับหรือปฏิเสธ ลำดับมาจากความน่าจะเป็น แต่การตัดสินใจไม่ได้มาจากมัน
ถ้าคุณรัน agent หลายตัวอยู่แล้วและสิ่งที่เจ็บคือคิวการรีวิว นั่นแหละคือเวิร์กโฟลว์ที่ เริ่มต้นใช้งาน Sharkly ตั้งไว้ให้: หนึ่ง Computer หนึ่ง Agent หนึ่ง Task พร้อมหลักฐานที่การจัดลำดับต้องการ
คำถามที่พบบ่อย
Jev อ่าน diff ทั้งก้อนแทนสรุปได้ไหม
มันรับ state ได้ถึง 32k โทเคน ดังนั้น diff เล็ก ๆ ก็ส่งไปได้ แต่ก็ยังควรส่งสรุปไปอยู่ดี เพราะ diff จาก agent ทะลุงบประมาณไปไกล และสรุปก็ช่วยให้คำถามยังอยู่ที่ระดับการจัดเส้นทาง ส่วน diff ทั้งก้อนนั่นคือสิ่งที่มนุษย์อ่าน โดยมีหลักฐานระดับ Taskอยู่ข้าง ๆ
ถ้า agent เขียนสรุป diff เองล่ะ
ถ้าอย่างนั้นสรุปก็อาจผิดไปในทางที่เป็นประโยชน์กับ agent และการจัดลำดับก็รับข้อผิดพลาดนั้นไปด้วย ควรใช้สรุปที่สร้างจาก diff ด้วยขั้นตอนแยกต่างหาก และเปิดทางให้คะแนน risk ระดับสูงสุด override needs_human ที่ต่ำได้เสมอ ข้อจำกัดของการรีวิวโค้ดด้วย AIใช้กับตรงนี้ด้วย โมเดลจัดลำดับสิ่งที่ถูกป้อนให้ได้ แต่ยืนยันสิ่งที่ไม่ได้ป้อนให้ไม่ได้
ช่วงคะแนนต่ำหมายความว่า PR จะ merge อัตโนมัติหรือเปล่า
ไม่ใช่ ช่วงคะแนนต่ำหมายความว่ามีคนจะ merge มันทีหลังตามเวลาของเขา โดยไม่ต้องอ่านมันก่อนในคิว ความเป็นเจ้าของการ merge และของงานที่ agent สร้างขึ้น ยังอยู่กับบุคคลที่ระบุชื่อได้ในทุกช่วงคะแนน
Jev ใช้ฟรีผ่าน Sharkly ไหม
Sharkly ไม่ได้ขายต่อ Jev หรือโมเดลใด ๆ คุณต้องนำคีย์ TypeSafe หรือ Gateway ของคุณเองมาใช้ เช่นเดียวกับการรันที่คิดเงินตาม subscription ที่ผูกกับ Runtimes ของคุณ ส่วน Sharkly เองตอนนี้ใช้ฟรีสำหรับองค์กรที่มีสมาชิกไม่เกิน 5 คน


