
โพสต์เปิดตัว Muse Wonder ของ Meta ได้อธิบายถึงพฤติกรรมที่เรียกว่า Active Focus ไว้ว่า ตัวโมเดลจะพยายามทำงานมุ่งสู่เป้าหมายที่ยากอย่างต่อเนื่อง พร้อมลองใช้วิธีการอื่นๆ ฝ่าฟันอุปสรรคต่างๆ และตามคำกล่าวของ Meta คือ จะสอบถามเพื่อขอความชัดเจนเมื่อจำเป็น รวมถึงรายงานตัวตรวจสอบ (check-in) ก่อนจะดำเนินการที่สำคัญ นอกจากนี้ Meta ยังแนะนำให้มนุษย์เป็นผู้ยืนยันก่อนการดำเนินการที่ส่งผลกระทบสำคัญ และใน coding-agents guide ก็ได้ปล่อย Muse Code โดยเปิดใช้ระบบการอนุมัติ (approval) และ sandbox ไว้ตั้งแต่การรันครั้งแรก
นี่เป็นการออกแบบที่ถูกต้อง แต่มันก็นำมาซึ่งคำถามที่ทุกทีมที่รันเอเจนต์แบบขนาน (parallel) คุ้นเคยกันดี นั่นคือ เมื่อโมเดลหยุดเพื่อถาม จะมีใครคอยตอบ ตอบได้เร็วแค่ไหน และมีบริบทอะไรบ้าง? การเช็กอินที่โผล่ขึ้นมาใน terminal ที่ไม่มีใครเฝ้าดูอยู่ก็คือการรันที่ค้างเติ่ง แต่การเช็กอินที่ส่งตรงเข้ามาใน Inbox ส่วนกลาง พร้อมแนบอยู่กับ Task ต้นเรื่อง คือขั้นตอนการตรวจสอบ (review step) และบทความนี้จะพูดถึงการสร้างระบบในแบบที่สอง
สิ่งที่ Active Focus สร้างขึ้นมา
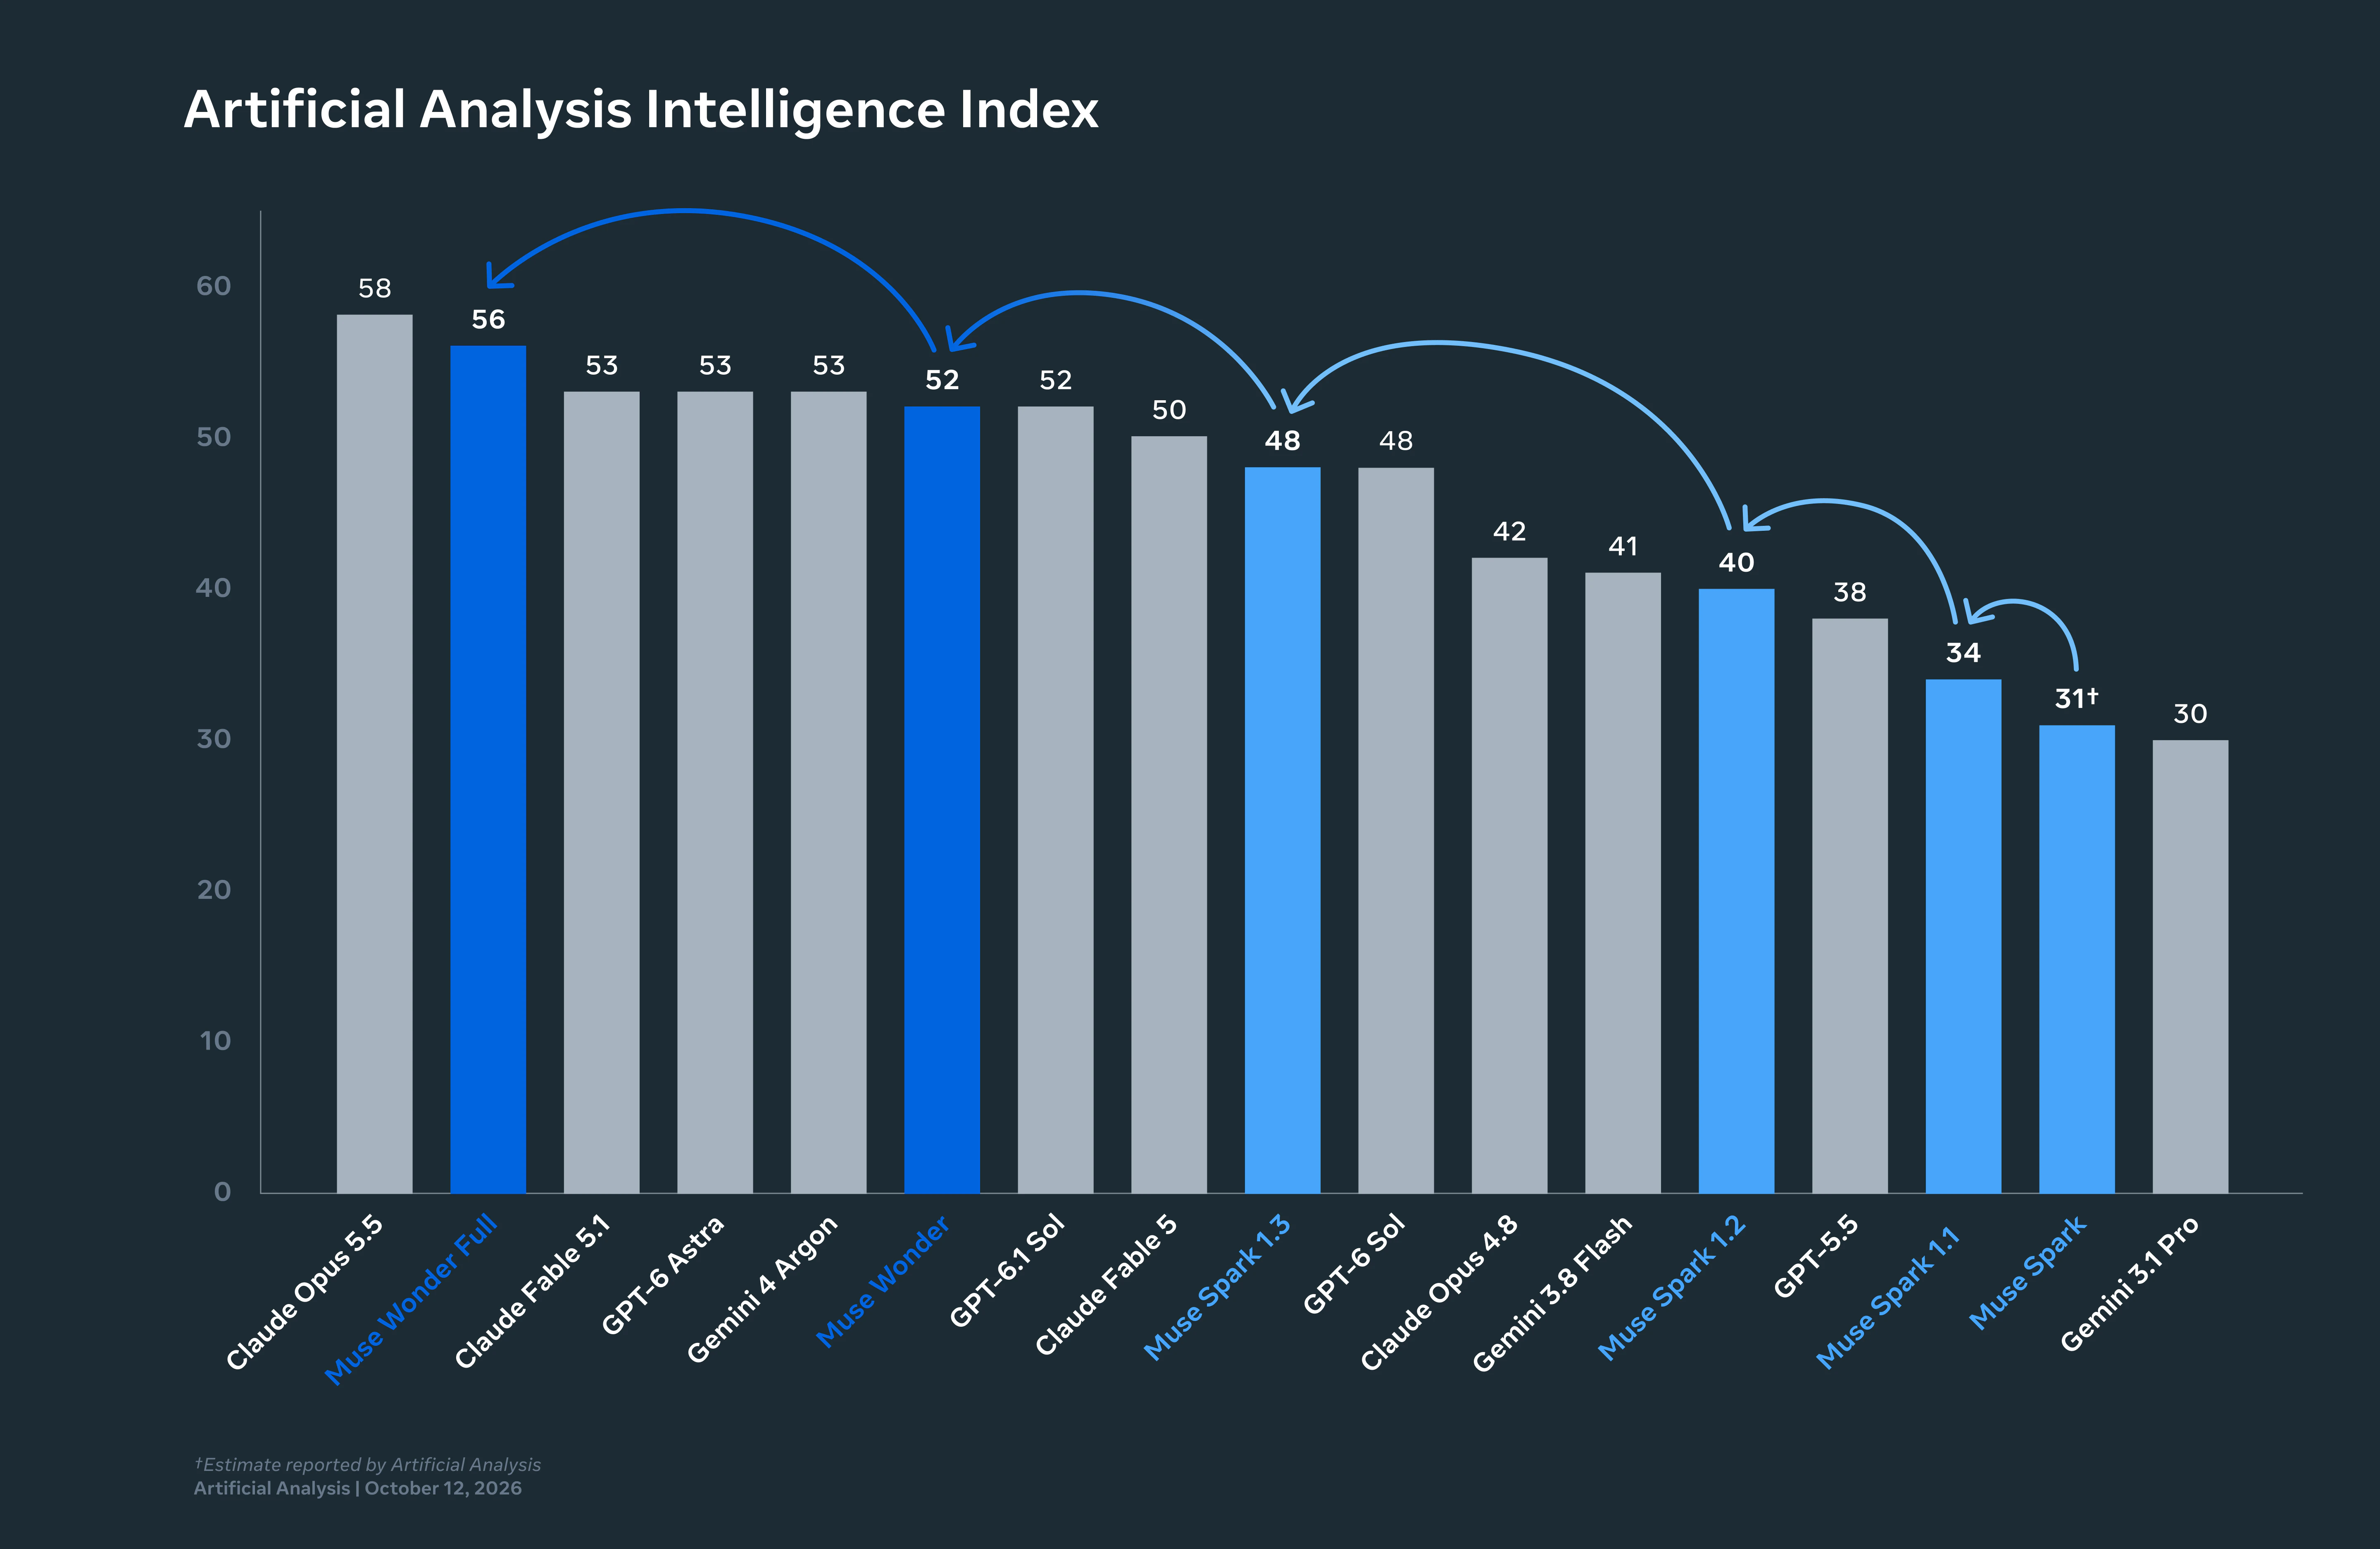
Meta ได้ฝึกฝนโมเดลเพื่อเน้นพฤติกรรม 3 ประการ และวัดผลด้วยเกณฑ์มาตรฐานภายในที่เรียกว่า FocusBench โดย Muse Wonder Full ทำคะแนนนำอยู่ที่ 54.2% และ Wonder เวอร์ชันที่เปิดให้ใช้ผ่าน API อยู่ที่ 44.9% ตามหลัง GPT-6 Astra และ Claude Opus 5.5 แต่พักเรื่องคะแนนไว้ก่อน สิ่งที่สำคัญต่อกระดานงาน (board) คือตัวพฤติกรรมเหล่านี้ต่างหาก:
- Persistence (ความพยายามต่อเนื่อง). โมเดลจะเดินหน้าลุยต่อแม้จะพบความล้มเหลว บน SWE-Marathon ซึ่งเป็นเบนช์มาร์กการเขียนโค้ดระยะยาว Wonder ได้คะแนน 53.1 เทียบกับ Opus 5.5 ที่ได้ 46.3 การรันที่ยาวนานขึ้น ความพยายามที่มากขึ้น ย่อมหมายถึงสิ่งที่จะต้องตรวจสอบมากขึ้นตามไปด้วย
- Clarification (การขอความชัดเจน). โมเดลจะเอ่ยถามเมื่อ Task มีความคลุมเครือแทนที่จะเดาเอาเอง หากอยู่บนกระดานงาน สิ่งนี้จะมาในรูปแบบของความคิดเห็นใน Task แต่ถ้าอยู่ใน terminal มันจะเป็นเพียงพรอมต์ที่ค้างรอคนมากดแป้นพิมพ์
- Check-ins (การตรวจสอบยืนยัน). โมเดลจะหยุดชั่วคราวก่อนดำเนินการในสิ่งที่ประเมินว่าสำคัญ โดยคำแนะนำของ Meta เองคือให้มนุษย์เป็นผู้ยืนยันสำหรับการดำเนินการใดๆ ก็ตามที่ส่งผลกระทบสำคัญ
พฤติกรรมแต่ละอย่างส่งผลต่อรูปแบบของคิวการรีวิว (review queue) แตกต่างกันไป Persistence ทำให้ปริมาณงานต่อ Task เพิ่มขึ้น Clarification ก่อให้เกิดการขัดจังหวะ (interrupt) ส่วน Check-ins จะเพิ่มการตัดสินใจที่จะระงับการรันไว้จนกว่าจะมีคนเข้ามาตัดสินใจ
การเช็กอินถูกส่งไปลงที่ไหน
ใน Muse Code พรอมต์ขออนุมัติจะปรากฏขึ้นบน terminal ของผู้ใช้งาน แล้วการรันจะหยุดรอ สำหรับการรันแบบ Headless (muse exec) จะไม่มีพรอมต์แบบโต้ตอบ เอกสารของ Meta จึงระบุว่าให้เลือกนโยบาย (policy) ที่สามารถทำงานจนเสร็จได้โดยไม่ต้องมีคนดูแล หรือไม่เช่นนั้นก็ต้องยอมรับว่าการดำเนินการที่ถูกระงับไว้จะค้างอยู่อย่างนั้น นี่คือข้อแลกเปลี่ยนที่ตรงไปตรงมา: ไม่คุณต้องนั่งเฝ้าหน้าคีย์บอร์ด ก็ต้องสั่งรันโมเดลโดยปิดระบบอนุมัติไปเลย หรือไม่การดำเนินการนั้นก็จะต้องรอคอยไปตลอดกาล
แต่บนกระดานของ Sharkly การรันจะเป็น Task ที่มอบหมายให้กับ Agent บน Computer เมื่อ Agent หยุดเพื่อถาม คำถามจะถูกส่งกลับมาที่ Task ในรูปแบบคอมเมนต์ และส่งต่อไปยัง Inbox โดย Task จะเก็บรักษารายละเอียดบริบททั้งหมดไว้ ไม่ว่าจะเป็นคำถามคืออะไร Agent ทำอะไรไปแล้วบ้าง บันทึกการทำงาน (execution log) ของการเรียกใช้เครื่องมือ (tool calls) ตลอดจนเหตุการณ์ต่างๆ ใน Runtime ไม่ว่าใครที่เข้ามารับเรื่องก็สามารถตอบกลับได้ใน Task นั้น และการรันก็สามารถกลับมาทำงานต่อจากจุดเดิมได้ทันที การเช็กอินยังคงเป็นการตัดสินใจโดยมนุษย์ แต่เป็นการตัดสินใจที่มีบันทึก มีคิว และมีคนพร้อมรับช่วงต่อได้มากกว่าหนึ่งคน
นี่คือความแตกต่างระหว่างระบบป้องกัน (safeguard) กับการทำงานที่หยุดชะงัก (stall) พฤติกรรมของโมเดลเหมือนกันทุกประการ แต่ระบบรอบข้างต่างหากที่เป็นตัวชี้ขาดว่าการเช็กอินแต่ละครั้งจะกินเวลาเพียงหนึ่งนาทีหรือทั้งวัน
เขียน Agent อย่างไรให้การเช็กอินมีประโยชน์จริง
การเช็กอินจะมีประสิทธิภาพได้ก็ขึ้นอยู่กับคุณภาพของคำถาม จงกำหนดมาตรฐานของคำถามที่ดีไว้ในคำสั่ง (instructions) ของ Agent:
Stop and ask before anything destructive, anything that sends data outside the
attached repositories, any payment or external account action, and any change
to CI, deploy or access configuration.
When you ask, state in one comment: what you are about to do, why the Task needs
it, what you considered instead, and what happens if the answer is no.
Do not ask about reversible edits inside the repository. Make them, test them,
and report.
If you have waited for an answer and the Task has a deadline, say so in a second
comment rather than proceeding.
กฎข้อแรกเป็นการกำหนดขอบเขตให้ชัดเจน โมเดลของ Meta อาจตัดสินด้วยตัวเองว่าอะไรคือเรื่องสำคัญ แต่คำสั่งนี้จะบอกอย่างเจาะจงว่าทีมมองอะไรเป็นเรื่องสำคัญ กฎข้อที่สองทำให้ใครก็ตามที่ไม่ได้นั่งเฝ้าดูการทำงานตั้งแต่ต้นสามารถเข้ามาตอบคอมเมนต์ได้ภายในสามสิบวินาที กฎข้อที่สามช่วยป้องกันไม่ให้โมเดลคอยถามไปเสียทุกเรื่อง ซึ่งเป็นจุดบกพร่องที่เปลี่ยนเอเจนต์ที่รอบคอบให้กลายเป็นเอเจนต์ที่น่ารำคาญ โดยบทความเรื่อง guardrails สำหรับ Opus 5.5 ก็ได้กล่าวถึงขอบเขตเดียวกันนี้ในแง่ของ prompt-injection ไว้ว่า จุดตรวจสอบสำหรับการรีวิวคือกลไกการควบคุมที่แท้จริง ไม่ว่าตัวโมเดลจะให้คำมั่นสัญญาไว้อย่างไรก็ตาม
การกะขนาดคิวงาน
Persistence หมายถึงภาระการรีวิวต่อ Task ที่เพิ่มขึ้น ไม่ใช่ลดลง ดังนั้นจงวางแผนรับมือไว้ล่วงหน้า
| เลน (Lane) | การรันทั่วไป | สิ่งที่จะเข้ามาในคิว |
|---|---|---|
| Muse Wonder กับ Task ขนาดยาว | มีหลายขั้นตอน ย้อนกลับ (revert) วิธีการไปหลายรอบ | diff ที่ยาวขึ้น log ที่ยาวขึ้น และมีการเช็กอิน 0 ถึง 3 ครั้ง |
| Opus 5.5 กับ Task เดียวกัน | มีขั้นตอนน้อยกว่า ตัดสินใจเด็ดขาดกว่า | diff ที่สั้นกว่า หรือไม่ก็ส่ง Task คืนมาทั้งที่เสร็จแค่ครึ่งเดียว |
| โมเดลใดก็ตามที่ปล่อยรันทิ้งไว้ข้ามคืนโดยไม่มีคนดูแล | ขึ้นอยู่กับว่านโยบาย (policy) อนุญาตสิ่งใดบ้าง | ไม่การดำเนินการถูกระงับค้างไว้ ก็เป็นการดำเนินการที่ไม่มีใครยืนยัน |
มี 3 แนวทางปฏิบัติที่จะช่วยให้คิวเดินหน้าได้อย่างต่อเนื่อง: กำหนดเส้นทางส่งการเช็กอินไปยังผู้ตรวจสอบ (reviewer) ที่ระบุชื่อชัดเจนสำหรับแต่ละเลน แทนที่จะส่งหาทุกคน เพื่อไม่ให้คำถามต้องค้างรอการตอบจากคนทั้งกลุ่ม, ตั้งค่า timeout สำหรับแต่ละ Task ของ Agent เพื่อให้การรันที่ติดขัดเพราะรอการเช็กอินล้มเหลว (fail) ออกมาให้เห็นอย่างชัดเจน แทนที่จะค้างอยู่ในสถานะ running นานหลายชั่วโมง, และควรอ่าน log ด้วย ไม่ใช่ดูแค่ diff สำหรับการรันด้วย Wonder เพราะเส้นทางที่ผ่านความล้มเหลวมาสามระลอกนั้นคือสิ่งที่โมเดลที่มี persistence เพิ่มเข้ามา และยังเป็นจุดที่ข้อผิดพลาดเล็กๆ น้อยๆ แอบซ่อนอยู่ ทั้งนี้ บทความ Coding agents while you’re away ได้ครอบคลุมถึงกรณีการปล่อยรันข้ามคืนไว้แล้ว และบทความ human review is the bottleneck ก็ได้อธิบายว่าทำไมสิ่งเหล่านี้ไม่ได้มีต้นทุนถูกลงเลยแม้โมเดลจะเก่งขึ้นก็ตาม
การเช็กอินที่ดีบนกระดานงานมีหน้าตาเป็นอย่างไร
นี่คือรูปแบบผลลัพธ์ที่ได้จากคำสั่งข้างต้น ในฐานะคอมเมนต์บน Task ที่ผู้ตรวจสอบสามารถเข้ามาจัดการผ่านโทรศัพท์มือถือได้ทันที:
Check-in before action.
About to: drop the legacy `orders_v1` table in the migration.
Why: the Task says remove v1 read paths; the table is the last reference.
Considered: keeping the table and removing only the code. Rejected because
the nightly job still writes to it and would fail silently.
If no: I will leave the table, remove the code paths, and note the job in
the report for a follow-up Task.
สี่บรรทัด หนึ่งการตัดสินใจ พร้อมทางเลือกทั้งสองทางที่วางแผนไว้ล่วงหน้าแล้ว ผู้ตรวจสอบเพียงพิมพ์ “yes” หรือ “no, keep it” บน Task การรันก็จะดำเนินต่อ และบันทึกก็จะเก็บข้อมูลไว้ว่าใครเป็นคนตัดสินใจ ลองเปรียบเทียบสิ่งนี้กับพรอมต์บน terminal ที่ขึ้นว่า Allow? [y/N] ให้กับคนที่ไม่ได้นั่งดู 40 ขั้นตอนก่อนหน้านั้นดู
การปรับแต่งเพิ่มเติม 2 ข้อหลังจากเปิดใช้งานเลนไปได้หนึ่งสัปดาห์: หากมีผู้ตรวจสอบคนใดคนหนึ่งต้องคอยตอบการเช็กอินเกือบทั้งหมด ให้เพิ่มผู้ตรวจสอบที่ระบุชื่อคนที่สองให้กับ Agent ในเลนนั้น เพื่อไม่ให้การติดประชุมช่วงบ่ายมาทำให้การรันระยะยาวทุกงานต้องหยุดชะงัก และหาก Agent มักจะถามเรื่องเดิมๆ ในลักษณะเดียวกันซ้ำๆ การดำเนินการประเภทนั้นควรถูกใส่ไว้ในคำสั่ง (instructions) ให้เป็น yes หรือ no ถาวรไปเลย ไม่ควรปล่อยให้หลุดเข้ามาในคิว
กรณีการใช้งานคอมพิวเตอร์ (Computer Use)
Meta ระบุว่าความสามารถในการใช้งานคอมพิวเตอร์ (computer use) เป็นหนึ่งในฟีเจอร์ของ Wonder ทั้งการควบคุมเบราว์เซอร์ เดสก์ท็อป และแอปบนมือถือ ซึ่งนี่คือจุดที่การเช็กอินมีความสำคัญที่สุด และเป็นจุดที่พรอมต์บน terminal ตอบโจทย์ได้น้อยที่สุด เพราะการดำเนินการนั้นคือการคลิกบนหน้าจอที่ผู้ตรวจสอบมองไม่เห็น โดยเราสามารถนำกฎเกณฑ์เดียวกับในบทความเรื่อง Astra computer-use มาปรับใช้ได้ นั่นคือ Agent จะทำงานบน Computer ที่ทีมเลือก การเช็กอินจะระบุชื่อหน้าจอและการดำเนินการที่ชัดเจน และผู้ที่ต้องกดยืนยันสามารถดู log ของ Task ได้ก่อนที่จะตอบตกลง โมเดลที่ขออนุญาตกดปุ่ม Submit จะปลอดภัยก็ต่อเมื่อมีใครสักคนรู้ว่าการกด Submit นั้นจะส่งผลอะไรตามมา
สิ่งที่ฟีเจอร์นี้ไม่ได้เป็น
Active Focus เป็นเพียงพฤติกรรมของโมเดล และพฤติกรรมของโมเดลก็ไม่ใช่สิ่งรับประกัน Meta เองยังระบุใน model card ว่าโมเดลอาจเกิดข้อผิดพลาดได้ในงานที่มีหลายขั้นตอนและไม่คุ้นเคย อีกทั้งรายงานความปลอดภัยฉบับเต็มก็ยังอยู่ระหว่างการดำเนินการ การเช็กอินเป็นเพียงฟีเจอร์ที่ช่วยให้ระบบรีวิวที่ดีอยู่แล้วมีประสิทธิภาพยิ่งขึ้น แต่มันไม่ได้เข้ามาแทนที่ระบบรีวิว ทีมใดที่ตีความว่า “รายงานตัวตรวจสอบก่อนดำเนินการสำคัญ” คือไฟเขียวให้ปล่อยรันงานได้โดยไม่ต้องดูแล ถือว่าเข้าใจผิดอย่างยิ่ง ส่วนทีมที่จัดสรร Task, ผู้ตรวจสอบ และ timeout ให้กับการเช็กอินทุกครั้ง คือทีมที่สร้างระบบขึ้นมาตรงตามวัตถุประสงค์ที่ฟีเจอร์นี้ถูกออกแบบไว้
ค่าใช้จ่ายทั้งหมดนี้จะไม่ถูกเรียกเก็บในบิลของ Sharkly เนื่องจากการใช้งานโมเดลจะคิดผ่าน Meta key ที่กำหนดค่าไว้บน Computer ตัวโมเดลมีการอัปเดตเมื่อวันที่ 12 ตุลาคม แต่บริบท ความคืบหน้า อุปสรรค ผลลัพธ์ และการรีวิวโดยมนุษย์ยังคงมองเห็นได้อย่างชัดเจนตั้งแต่เริ่มส่งคำขอไปจนถึงการปล่อยงาน (release) คุณสามารถสร้างระบบนี้ขึ้นมาเองได้โดยใช้ worktrees หรือจะเลือกใช้ Sharkly เพื่อจัดการเวิร์กโฟลว์ทั้งหมดนี้ก็ได้


