
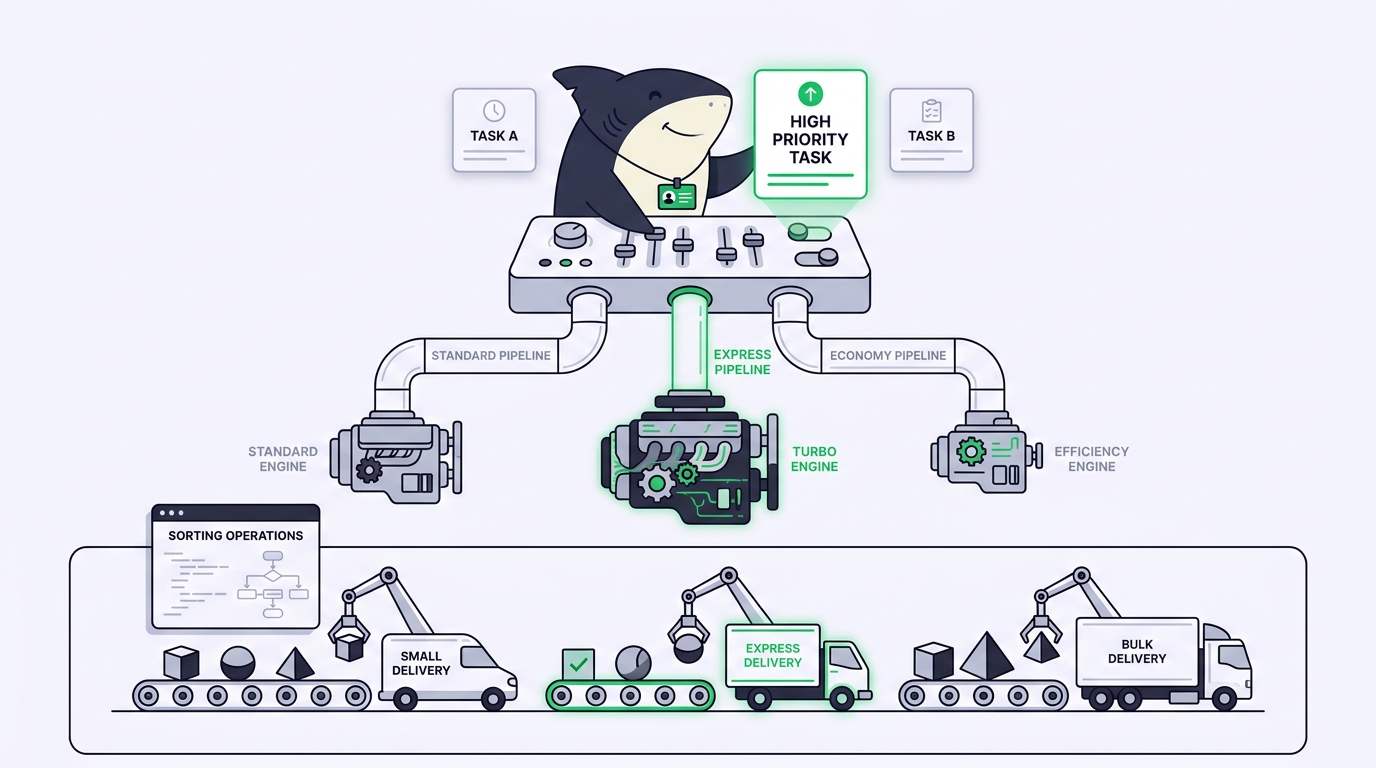
TL;DR: เลิกตามหาโมเดลที่ดีที่สุดเพียงตัวเดียวได้แล้ว จับคู่แต่ละโมเดลกับรูปร่างของงานที่อยู่ตรงหน้า: งานที่ต้องใช้การให้เหตุผลเชิงลึกสำหรับงานสถาปัตยกรรมและการรีแฟกเตอร์ข้ามไฟล์, เร็วและถูกสำหรับโค้ดซ้ำซากและการเขียนเทสต์, คอนเท็กซ์ยาวสำหรับคำถามระดับทั้งรีโป, และการใช้เครื่องมืออย่างสม่ำเสมอสำหรับการแก้ไขหลายขั้นตอน การเลือกโมเดลแบบทีละเทอร์มินัลใช้ได้ผลเมื่อมีเอเจนต์หนึ่งหรือสองตัว แต่เมื่อคุณรันหลายงานข้ามหลายรีโป การจับคู่นั้นควรอยู่ใน Agent ที่บันทึกไว้ ไม่ใช่ในหัวของคุณ นี่คือแผนผังที่ว่า ตัวอย่างจริง และเช็กลิสต์ที่คุณนำไปใช้ได้วันนี้
คุณมีเทอร์มินัลเปิดอยู่ห้าตัว ตัวหนึ่งถืองานรีแฟกเตอร์สุดหิน ตัวหนึ่งต้องเขียนยูนิตเทสต์เป็นชุด ตัวหนึ่งกำลังตอบคำถามเกี่ยวกับโค้ดเบสที่คุณจำได้ครึ่ง ๆ กลาง ๆ ตัวหนึ่งกำลังไล่ล่าเทสต์อินทิเกรชันที่รันบ้างไม่รันบ้าง อีกตัวหนึ่งกำลังเปลี่ยนชื่อสัญลักษณ์ในสี่สิบไฟล์ แต่ละตัวถามคำถามเงียบ ๆ คำถามเดียวกัน: งานนี้ควรใช้โมเดลไหนรัน? ถ้าเอาโมเดลให้เหตุผลระดับหนักไปทำงานเปลี่ยนชื่อ คุณก็เผาโทเคนและเวลาไปกับงานที่โมเดลเร็ว ๆ ตัวไหนก็ทำเสร็จเรียบร้อย แต่ถ้าเอาโมเดลเร็วไปทำงานเปลี่ยนสถาปัตยกรรม มันก็มองข้าม dependency ที่อยู่ห่างออกไปสามไฟล์ ข้อบ่นที่เจอบ่อยจึงไม่ค่อยใช่ “โมเดลห่วย” แต่เป็น “ฉันไม่รู้ว่าจะใช้ตัวไหน”
ทางแก้ไม่ใช่ตารางจัดอันดับ เพราะอันดับเปลี่ยนทุกไม่กี่สัปดาห์ และผู้ชนะบน benchmark ทั่วไปมักเป็นตัวเลือกที่ผิดสำหรับงานเฉพาะของคุณ สิ่งที่ยั่งยืนคือการจับคู่โมเดลกับรูปร่างของงาน: ต้องใช้การให้เหตุผลมากแค่ไหน ต้องถือคอนเท็กซ์มากแค่ไหน ต้องทำตามเครื่องมือได้เสถียรแค่ไหน และคุณจะจ่ายต่อการรันเท่าไหร่ คุณสมบัติเหล่านี้แทบไม่เปลี่ยน แม้ชื่อโมเดลจะเปลี่ยนไป
นี่คือจุดที่เลเยอร์งาน (task layer) เข้ามามีบทบาท Sharkly เป็นแพลตฟอร์มสั่งการและจัดการ Agent แบบครบวงจร มันวางตัวอยู่เหนือโค้ดดิ้งเอเจนต์ของคุณ ดังนั้นคำถาม “โมเดลไหนสำหรับงานไหน” จึงไม่ใช่การตัดสินใจที่คุณต้องตัดซ้ำใหม่ในทุกเทอร์มินัล คุณบันทึกการตัดสินใจนั้นครั้งเดียวเป็น Agent ซึ่งเป็นการตั้งค่าที่นำกลับมาใช้ซ้ำได้ของบทบาท (role) รันไทม์ (runtime) และกฎของมัน แล้วมอบหมาย Task ให้กับ Agent ที่มีรูปร่างเหมาะกับงาน คุณมีโค้ดดิ้งเอเจนต์อยู่แล้ว Sharkly เปลี่ยนพวกมันให้กลายเป็นทีม
จับคู่โมเดลกับรูปร่างของงาน ไม่ใช่ตารางจัดอันดับ
การเลือกโมเดลจริง ๆ แล้วคือสี่คำถามที่ต้องถามตามลำดับ
- ความลึกของการให้เหตุผล งานนี้ต้องวางแผนหลายขั้นตอนข้ามไฟล์ หรือเป็นแค่การเปลี่ยนแปลงเชิงกลในจุดเดียว? งานสถาปัตยกรรม รีแฟกเตอร์ที่ซับซ้อน และการดีบักหาสาเหตุราก ได้ประโยชน์จากโมเดลให้เหตุผลที่แข็งแกร่งกว่า ส่วนการเปลี่ยนชื่อ จัดฟอร์แมต และสร้างโครงเริ่มต้นไม่ได้ประโยชน์
- ขนาดคอนเท็กซ์ โมเดลต้องถือทั้งรีโป สเปกยาว ๆ หรือล็อกยักษ์ในคราวเดียวหรือไม่? คำถามระดับทั้งโค้ดเบสและการไมเกรตขนาดใหญ่ได้ประโยชน์จากโมเดลคอนเท็กซ์ยาว ถึงแม้มันจะให้เหตุผลลึกได้น้อยกว่านิดหน่อย
- ความเสถียรในการทำตามเครื่องมือ งานหลายขั้นตอน (แก้ไข รันเทสต์ อ่านผลลัพธ์ แก้ไขอีกครั้ง) อยู่หรือตายที่ว่าโมเดลใช้เครื่องมือได้สม่ำเสมอแค่ไหนโดยไม่หลุดสคริปต์ โมเดลที่ให้เหตุผลเก่งเลิศแต่ลืมรันเทสต์ ย่อมแย่กว่าโมเดลที่เสถียรกว่าในจุดนี้
- ความเร็วและต้นทุน งานปริมาณมากและความเสี่ยงต่ำ (เทสต์ โค้ดซ้ำซาก ดอคสตริง) ควรไปที่โมเดลที่เร็วและถูกที่สุดที่ผ่านเกณฑ์ เก็บโมเดลให้เหตุผลราคาแพงไว้สำหรับงานที่ผลลัพธ์ขึ้นอยู่กับมันจริง ๆ
ใช้โมเดลให้เหตุผลระดับหนักเมื่องานที่ก้าวผิดหนึ่งก้าวทำให้คุณต้องเสียบ่ายทั้งบ่ายไปกับการดีบัก ใช้โมเดลเร็วราคาถูกเมื่องานเป็นเชิงกลและตรวจสอบได้ง่าย และส่วนใหญ่ในแต่ละวันคุณต้องใช้ทั้งสองแบบ กับงานต่างกัน ในเวลาเดียวกัน นั่นคือเหตุผลที่การตั้งโมเดลเดียวแบบครอบจักรวาลให้ความรู้สึกผิดที่ผิดทาง: มันบังคับคำตอบเดียวกับงานที่ต้องการคำตอบต่างกัน
แผนผังคร่าว ๆ จากประเภทงานไปสู่บทบาทของโมเดล
ชื่อประเภทงานด้านล่างนี้อยู่ยืนยาวกว่าเวอร์ชันโมเดลใด ๆ อ่านโมเดลการ์ดล่าสุดของผู้ให้บริการก่อนที่คุณจะผูกแต่ละกลุ่มกับชื่อโมเดล จากนั้นก็เก็บกลุ่มนั้นไว้
| งานที่อยู่ตรงหน้าคุณ | สิ่งที่ควรปรับให้เหมาะ | บทบาทของโมเดล |
|---|---|---|
| สถาปัตยกรรม, รีแฟกเตอร์ข้ามไฟล์, รีวิวการออกแบบ | ความลึกของการให้เหตุผล | โมเดลให้เหตุผลระดับหนัก |
| ดีบักหาสาเหตุราก, ไล่ล่าเทสต์ที่รันบ้างไม่รันบ้าง | การให้เหตุผล + เครื่องมือที่เสถียร | โมเดลให้เหตุผลระดับหนัก |
| ถาม-ตอบทั้งรีโป, การไมเกรตขนาดใหญ่, งานที่ใช้สเปกยาว | ขนาดคอนเท็กซ์ | โมเดลคอนเท็กซ์ยาว |
| ยูนิตเทสต์, โค้ดซ้ำซาก, ดอคสตริง, โครงเริ่มต้น | ความเร็วและต้นทุน | โมเดลเร็ว ราคาถูก |
| เปลี่ยนชื่อเชิงกล, จัดฟอร์แมต, แก้ไขจำนวนมาก | ความเร็ว | โมเดลเร็ว ราคาถูก |
| ลูปเอเจนต์หลายขั้นตอน (แก้ไข, เทสต์, ทำซ้ำ) | ความเสถียรในการทำตามเครื่องมือ | ผู้ใช้เครื่องมือที่เสถียร |
หมายเหตุสองข้อตามตรง ข้อแรก “ระดับหนัก” ไม่ได้แปลว่า “ดีกว่าเสมอ” กับงานเปลี่ยนชื่อ โมเดลให้เหตุผลเชิงลึกจะช้ากว่า แพงกว่า และก็ไม่ได้ถูกต้องกว่าตัวเร็วเลย ข้อสอง รันไทม์อย่าง Claude Code, Codex หรือ Gemini CLI ต่างมีโมเดลเริ่มต้นของตัวเอง และการใช้งานโมเดลจะดำเนินต่อไปผ่านการสมัครสมาชิกหรือ API keyที่ตั้งค่าไว้ในเครื่องมือนั้น ตัวเลือกจริงของคุณจึงคือโมเดลที่ทีมคุณจ่ายเงินอยู่แล้ว จับคู่กับกลุ่มเหล่านี้ benchmark งานแบบสาธารณะอย่าง SWE-bench บอกคุณได้คร่าว ๆ ว่าโมเดลอยู่ระดับไหน ไม่ได้บอกว่างานเฉพาะของคุณต้องใช้โมเดลตัวไหน
จุดที่การเลือกโมเดลทีละเทอร์มินัลไปต่อไม่ได้
ถ้ามีเอเจนต์แค่หนึ่งหรือสองตัว การเลือกด้วยมือก็โอเค คุณเปิดเทอร์มินัล ตั้งโมเดล แล้วคุณก็จำได้ว่าอะไรอยู่ตรงไหน เพราะมีแค่สองตัว การตั้งค่าที่ใช้ได้ผลในวันนี้คือคนหนึ่งคนกับเครื่องมือสองสามชิ้น
ปัญหาจะเริ่มเมื่อมีปริมาณมากขึ้น รันหกงานข้ามสามรีโป แล้วการจับคู่โมเดลกับงานตอนนี้ก็อยู่ในหัวคุณ: เทอร์มินัลไหนคือตัวถูก รีโปไหนที่คุณตั้งเป็นตัวให้เหตุผลเมื่อวันอังคารที่แล้ว ทำไมการไมเกรตถึงอืดอาด (คุณเผลอปล่อยให้มันใช้โมเดลเร็ว) เมื่อเพื่อนร่วมทีมมารับงานต่อ การจับคู่นั้นไม่ติดไปกับงานด้วย มันอยู่ในความทรงจำของคุณ และผลลัพธ์ก็กระจัดกระจายอยู่ในเทอร์มินัลส่วนตัว แทนที่จะกลับไปที่ใดที่แชร์ร่วมกัน
Agent คือการตั้งค่าที่บันทึกไว้สำหรับวิธีจัดการงานชนิดหนึ่ง: บทบาท รันไทม์และโมเดลของมัน และกฎที่มาพร้อมกัน แทนที่จะตัดสินใจเลือกโมเดลใหม่ทุกเทอร์มินัล คุณสร้าง Agent ขึ้นมาครั้งเดียว (“Test Writer” บนโมเดลเร็ว, “Refactorer” บนโมเดลให้เหตุผล) แล้วมอบหมาย Task ให้กับ Agent ที่มีรูปร่างเหมาะกับงาน การเลือกโมเดลจึงนำกลับมาใช้ซ้ำได้ ไม่ใช่เกมทายความจำ เอเจนต์ค้นคว้า ลงมือทำ เทสต์ และรายงาน ส่วนคนเป็นผู้กำหนดทิศทางและรับผลลัพธ์ การดำเนินการ อุปสรรค และผลลัพธ์จะกลับไปที่ Task ดังนั้นเหตุผลเบื้องหลังการเลือกโมเดลแต่ละครั้งจึงมองเห็นได้ตั้งแต่คำขอจนถึงการรีลีส ไม่ได้ถูกฝังอยู่ในประวัติการเลื่อนหน้าจอ
Sharkly ไม่ใช่ตัวแทนที่มาแทน Claude Code, Codex หรือเครื่องมือลงมือทำอื่น ๆ มันเพิ่มเลเยอร์งาน คอนเท็กซ์ และการรีวิวที่แชร์ร่วมกันให้กับโมเดลที่ทีมคุณรันอยู่แล้ว ถ้าคุณรันเอเจนต์แค่ตัวเดียวในเทอร์มินัลเดียวตลอด ก็ไม่จำเป็นต้องใช้ แต่เมื่อคุณรันหลายเอเจนต์พร้อมกัน การตัดสินใจจับคู่โมเดลก็เป็นสิ่งที่ควรบันทึกไว้อย่างยิ่ง
ตัวอย่างจริง: สามงาน สาม Agent
สมมติว่าช่วงสปรินต์มีงานสามงานเข้ามาในคิว
- SH-312: เปลี่ยนชื่อ
UserSessionเป็นAuthSessionทั่วทั้งรีโป เป็นงานเชิงกล ตรวจสอบง่าย ส่งให้ Agent “Renamer” บนโมเดลเร็วราคาถูก มันแก้ไข รัน type checker แล้วคืนดิฟที่สะอาด การเผาโทเคนของโมเดลให้เหตุผลตรงนี้ไม่ได้อะไรเลย - SH-318: โฟลว์เช็คเอาต์คิดเงินซ้ำเมื่อลองใหม่ เป็นการดีบักหาสาเหตุรากข้ามเซอร์วิส ส่งให้ Agent “Debugger” บนโมเดลให้เหตุผลระดับหนักที่ใช้เครื่องมือได้เสถียร มันต้องวางแผน อ่านล็อก ตั้งสมมติฐาน และทดสอบ โมเดลเร็วในงานนี้จะเดาสุ่มและทำให้เสียรอบรีวิวเปล่า ๆ
- SH-324: ตอบคำถามว่า “ระบบบิลลิงของเรากระทบยอดกับ Stripe อย่างไร” จากโค้ดเบส เป็นคำถามระดับทั้งรีโป ส่งให้ Agent “Codebase Analyst” บนโมเดลคอนเท็กซ์ยาวที่ถือไฟล์ที่เกี่ยวข้องได้ในคราวเดียว
แต่ละ Agent รันในworktree ที่แยกออกจากกันของตัวเอง ดังนั้นโมเดลสามตัวจึงทำงานสามงานพร้อมกันโดยไม่ก้าวก่ายกัน ผลลัพธ์แต่ละอันจะกลับไปที่ Task ของมันพร้อมสรุปการเปลี่ยนแปลงและหลักฐาน คุณรีวิวงานที่เสร็จแล้วสามชิ้น ไม่ใช่เทอร์มินัลสามตัวที่คุณต้องปะติดปะต่อจากความทรงจำ ระบบอัตโนมัติจะหยุดตรงจุดที่ต้องใช้ดุลยพินิจของคุณ: คุณรับงาน ขอให้แก้ไข หรือตัดสินใจ merge
เช็กลิสต์ที่คุณนำไปใช้ได้วันนี้
ทำตามนี้ก่อนเริ่มงานเอเจนต์ชุดถัดไปของคุณ
- [ ] สำหรับแต่ละงาน ระบุรูปร่างของมันก่อน: เน้นการให้เหตุผล เน้นคอนเท็กซ์ เน้นลูปเครื่องมือ หรือปริมาณมากและเป็นงานเชิงกล
- [ ] เลือกโมเดลที่ถูกที่สุดที่ผ่านเกณฑ์สำหรับรูปร่างนั้น เก็บโมเดลให้เหตุผลไว้สำหรับงานที่ก้าวผิดแล้วเสียเวลาจริง ๆ
- [ ] งานที่ต้องใช้คอนเท็กซ์ยาวให้ใช้โมเดลคอนเท็กซ์ยาว ไม่ใช่ใช้โมเดลให้เหตุผลตัวโปรดตามความเคยชิน
- [ ] สำหรับลูปหลายขั้นตอน ให้น้ำหนักกับความเสถียรในการทำตามเครื่องมือมากกว่าอันดับบน benchmark
- [ ] เขียนการจับคู่ลงไปครั้งเดียวเป็น Agent ที่ใช้ซ้ำได้ต่อบทบาท เพื่อให้คุณและเพื่อนร่วมทีมหยุดตัดสินใจใหม่ทุกเทอร์มินัล
- [ ] ให้คนเป็นผู้รับงานขั้นสุดท้าย โมเดลเลือกเส้นทาง คุณอนุมัติผลลัพธ์
จับคู่โมเดลกับงาน บันทึกการจับคู่นั้นเป็น Agent แล้วคำถามที่จุดประกายเรื่องนี้ (“ฉันจะใช้ตัวไหน?”) ก็จะถูกตอบเพียงครั้งเดียวต่อบทบาท ไม่ใช่ครั้งเดียวต่อเทอร์มินัล
ถ้าคุณอยากใช้โค้ดดิ้งเอเจนต์หลายตัวต่อไป แทนที่จะเลือกโมเดลเดียวสำหรับทุกอย่าง นั่นคือปัญหาที่ Sharkly ถูกสร้างมาเพื่อแก้ คุณจะเลือกโมเดลด้วยมือในทุกเทอร์มินัล หรือจัดการเวิร์กโฟลว์ทั้งหมดในที่เดียว แล้วให้ผลลัพธ์แต่ละอันกลับไปที่ Task
คำถามที่พบบ่อย
ควรใช้โมเดลที่อันดับสูงสุดกับทุกงานไปเลยไหม? ไม่ควร โมเดลทั่วไปที่อันดับสูงสุดนั้นช้ากว่าและแพงกว่าที่จำเป็นสำหรับงานเชิงกล และก็ไม่ได้ถูกต้องกว่าในงานแบบนั้น อันดับบอกคุณว่าโมเดลอยู่ระดับไหน ส่วนรูปร่างของงานคุณต่างหากที่บอกว่าคุณต้องใช้ระดับไหน การจับคู่ทั้งสองย่อมดีกว่าการใช้ตัวชนะบนตารางอันดับเป็นค่าเริ่มต้น
ถ้ายังไม่รู้ว่างานยากแค่ไหน จะเลือกโมเดลอย่างไร? เริ่มจากตัวถูกแล้วไล่ขยับขึ้น ให้โมเดลเร็วลองทำงานก่อน ถ้ามันตัน เดาสุ่ม หรือไม่ผ่านการรีวิว นั่นคือสัญญาณว่างานนี้เน้นการให้เหตุผล และคุณก็เลื่อนไปใช้โมเดลที่แรงขึ้น ขั้นตอนรีวิวแบบมีคนอยู่ในลูปคือจุดที่คุณจับความไม่เข้ากันได้ก่อนที่งานจะออกไป
Sharkly เลือกโมเดลให้ฉันหรือเปล่า? Sharkly ไม่ได้เลือกโมเดลเอง คุณผูกบทบาทกับรันไทม์และโมเดลของมันตอนสร้าง Agent แล้วจึงมอบหมาย Task ให้กับ Agent ที่มีรูปร่างเหมาะกับงาน ทางเลือกยังเป็นของคุณ Sharkly ทำให้มันใช้ซ้ำได้และเก็บผลลัพธ์ของทุกการรันไว้ที่ Task แทนที่จะปล่อยไว้ในเทอร์มินัลส่วนตัว


