
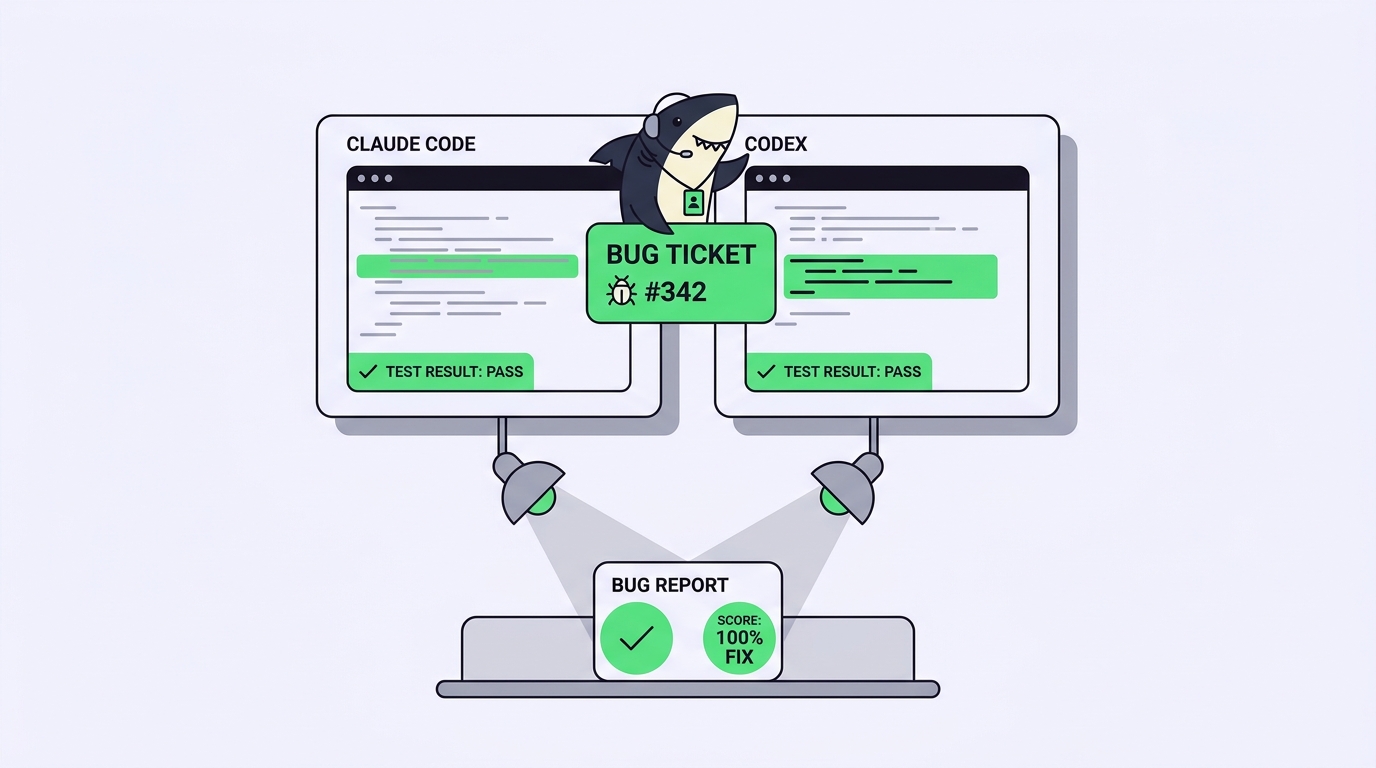
Önünüzde gerçek bir hata var ve onu düzeltebilecek iki ajan: Claude Code ve Codex. Sekmeler "hangisi daha akıllı" tartışmalarıyla dolu, ama hiçbiri bu depoda, bugün, bu hataya hangisini yönlendirmeniz gerektiğini söylemiyor. Herkese açık benchmark rakamları da söylemiyor. Bir liderlik tablosu, ince ayarlı bir test düzeneğiyle sabit bir açık kaynak problem kümesini ölçer. Sizin hatanız ise özel bir problem: sizin konvansiyonlarınız, sizin flaky testiniz, yalnızca tek bir kişinin anladığı modül.
"Claude Code mu Codex mi" sorusunun dürüst cevabı, ikisini de aynı hatada, aynı koşullar altında çalıştırıp her birinin ne getirdiğini okumaktır. Kulağa basit geliyor ama hızla karmaşaya dönüşüyor: iki ajan aynı dosyaları düzenliyor, iki terminal, iki test çıktısı ve bunları yan yana karşılaştırmanın temiz bir yolu yok. İstediğiniz karşılaştırma ajanlarla ilgili. Önünüzdeki iş ise onların çarpışmasını önlemek.
İşte Sharkly bu çarpışmayı ortadan kaldırıyor. Sharkly hepsi bir arada bir Agent komut ve yönetim platformudur: aynı Task'ı iki farklı Agent'a atarsınız, her biri bağlı bir Computer üzerinde kendi izole worktree'sinde çalışır ve her çalıştırma kendi diff'ini, test sonuçlarını ve incelemesini tek bir yere döndürür. Sharkly, Claude Code ya da Codex'in yerini almaz ve bir benchmark düzeneği de değildir. İkinci bir terminal açmadan adil bir kafa kafaya karşılaştırmayı mümkün kılan katmandır. Bu rehberde yöntemi, tek bir hata için puanlama ölçütlerini ve her ajanın nerelerde öne geçme eğiliminde olduğunu ele alıyoruz.
Kısa cevap
Claude Code ile Codex'i dürüstçe karşılaştırmak için ikisine de aynı hatayı, aynı başlangıç commit'ini ve aynı kabul testini verin; her biri kendi en iyi yapılandırmasında çalışsın. Sonra dönen sonuçları puanlayın: düzeltme geçiyor mu, diff kapsam içinde kalıyor mu ve değişikliği incelemeniz ne kadar sürüyor. Bir hatayı kazanan ajan, sadece bir hatayı kazanmıştır. Sonuca güvenmeden önce yöntemi birkaç hata üzerinde çalıştırın.
"Hangisi daha iyi" neden yanlış soru
Claude Code ve Codex, ikisi de terminal öncelikli kodlama ajanlarıdır. Deponuzu okur, dosyaları düzenler, komutlar çalıştırır ve rapor verir. Sizi nasıl yapılandırdığınızda ve baskı altındaki davranışlarında farklılaşırlar, ama normal bir sprint'i dolduran işlerde hiçbiri evrensel olarak önde değildir.
Tek bir küresel sıralama, sizin önemsediğiniz kısmı gizler. "Hangisi daha iyi" her şeyi, kod tabanınızla temas ettiğinde geçerliliğini yitiren bir sayıya indirger. "Bu tür bir hatada, benim depomda, inceleme anında hangisi daha iyi" sorusu cevaplanabilir ve zahmete değer tek versiyon da budur. Her ajanın hangi modeli çalıştırması gerektiğine hâlâ karar veremiyorsanız, modelleri ajan rollerine eşleştirmek, herhangi bir liderlik tablosundan daha iyi bir ilk sorudur.
İkisini de aynı hatada çalıştırın: güvenebileceğiniz bir yöntem
Adil bir karşılaştırma, ajan dışındaki her şeyi sabit tutar. Bunu sağlayan dört kural var.
- Oyuncak bir istem yerine gerçek bir hata seçin. Backlog'unuzdan, çalıştırabileceğiniz bir kabul testi ve birkaç dakikada okuyabileceğiniz bir diff'i olan, kapsamı sınırlı bir hata seçin. Bunu hata takip sisteminizin yazacağı gibi yazın:
SH-312: fix the timezone drift in the invoice exportgibi bir görev. "Bir yapılacaklar uygulaması yap" size kodunuz hakkında hiçbir şey söylemez. - İkisine de birebir aynı girdiyi verin. Aynı görev tanımı, aynı başlangıç commit'i, aynı kabul kriterleri. Claude Code, Codex'ten daha zengin bir istem alırsa, ölçtüğünüz şey ajan değil, sizin isteminiz olur.
- Her birini en iyi halinde çalıştırın. Claude Code'a
CLAUDE.mddosyasını, Codex'eAGENTS.mddosyasını ve yapılandırmasını verin; her birine kendi dokümanlarının önerdiği izinleri ve modeli tanıyın. İyi kurulmuş bir ajanı çıplak bir ajanla karşılaştırmak, hangisini yapılandırmaya zahmet ettiğinizi ölçer. - İki çalıştırmayı birbirinden izole edin. Her ajanın kendi çalışma kopyasına ihtiyacı var. Tek bir checkout'ta iki ajan birbirinin üzerine yazar ve öğleden sonranızı iki temiz denemeyi okumak yerine bir merge'ü çözmeye harcarsınız. İzole worktree'ler tam da bunun için.
İki denemeyi çalıştırın, sonra kaybeden branch'i atın. Güvendiğiniz düzeltme ve neden güvendiğinizin kanıtı sizde kalır.
Tek bir hata düzeltmesi için puanlama ölçütleri
"Geçti mi" tek bir bitlik bilgidir. Gerçek bir düzeltmeye karar verirken bundan fazlasına bakılır; ölçütleri sonuca bakmadan önce yazmak karşılaştırmayı dürüst tutar.
| Puanladığınız şey | Cevapladığı soru | Neden önemli |
|---|---|---|
| Doğruluk | Kabul testi geçiyor mu ve başka bir şey bozulmuyor mu? | Alt sınır. "Bitti" yazan bir ajan hiçbir şeyi geçmiş sayılmaz. |
| Kapsam disiplini | Diff yalnızca hatanın gerektirdiği yerlere mi dokundu? | İlgisiz dört dosyayı baştan yazan bir düzeltmeyi incelemek, sağladığı faydadan daha pahalıdır. |
| Test kalitesi | Ajan, regresyonu yakalayacak bir test ekledi mi ya da güncelledi mi? | Testi olmayan bir düzeltme, tekrar yapacağınız bir düzeltmedir. |
| İnceleme süresi | Değişikliğe güvenmeniz ne kadar sürdü? | Çoğu zaman gerçek darboğaz budur ve öğleden sonranızı alana kadar göz ardı etmesi kolaydır. |
| Dürüstlük | Ajan kendi sınırlarını ve varsayımlarını belirtti mi? | Güvenebileceğiniz çalıştırma, size doğrulamadığı şeyleri söyleyendir. |
İki denemeyi de aynı hatada, aynı beş ölçütle puanlayın; kazanan artık bir zevk meselesi olmaktan çıkar. İnceleme süresi ekstra ağırlığı hak eder: iki ajan da yirmi dakikada bitirebilir ve yine de her birini kontrol etmek birer saat alabilir. O saat, çoğu zaman bir ekibin kaldırabileceği ajan işinin gerçek sınırıdır.
Her biri nerelerde öne çıkma eğiliminde
Burada uydurma sayılar yok, sadece nelere dikkat etmeniz gerektiği var. Claude Code, CLAUDE.md proje hafızasına yaslanır ve çok dosyalı değişikliklerde depo konvansiyonlarının içinde kalma eğilimindedir; bu da birkaç modüle yayılan refactor'larda kendini gösterir. Codex, sandbox'lı ve yapılandırma odaklı bir kurulumda rahattır ve yeni kodu testleriyle birlikte genellikle temiz biçimde kurgular; bu da kapsamı sınırlı düzeltmelerde öne çıkar. Depo büyüdükçe ikisi de daha fazla savrulur ve ikisi de size özgüvenle geçmeyen bir değişiklik uzatabilir. Bunların herhangi birini kesinleşmiş kabul etmeden önce kendi hatanızı çalıştırın.
İşte çoğu karşılaştırmanın atladığı dürüst kısım. Yalnızca tek bir ajan kullanıyorsanız ve tek bir terminalde yaşıyorsanız, bunu çalıştırmak için bir platforma ihtiyacınız yok. Tek bir worktree'de iyi ayarlanmış bir Claude Code oturumu ya da tek bir Codex çalıştırması yeterlidir ve diff'e kendiniz göz atabilirsiniz. Denklem, iki ajanı birden fazla hatada karşılaştırmaya başladığınızda ve sonuçları başkasının okuyabileceği bir biçimde istediğinizde değişir.
Kafa kafaya karşılaştırmayı Sharkly'de çalıştırmak
Sharkly tam burada yerini hak ediyor. Hata için tek bir Task oluşturur, sonra bunu hem bir Claude Code Agent'ına hem de bir Codex Agent'ına atarsınız. Her Agent, bağlı bir Computer üzerinde kendi worktree'sinde çalışır, böylece iki deneme aynı dosyalara asla dokunmaz. Yürütme, engeller, sonuçlar ve değişiklik özeti Task zaman çizelgesine döner; siz de hangi terminalin hangisini tuttuğunu hatırlamaya çalışmak yerine iki diff'i ve iki test çalıştırmasını tek bir görünümde karşılaştırırsınız.
İş bölümü net kalır. Ajanlar araştırır, yürütür, test eder ve raporlar. Yönü insanlar belirler, sonucu insanlar kabul eder. Otomasyon, sizin yargınızın gerektiği yerde durur; Sharkly ise bağlamı, ilerlemeyi, engelleri, sonuçları ve insan incelemesini talepten sürüme kadar görünür tutar. Kararı bir araca bırakmıyorsunuz; iki denemeyi de önünüze serilmiş halde buluyorsunuz, böylece iş dakikalar alıyor. İki ajanı da tek seferlik bir test yerine günlük işler için elinizde tutmak istiyorsanız, Claude Code ve Codex'i tek bir kod tabanında birlikte çalıştırmak aynı iş akışıdır, sadece rutinleşmiş halidir.
Ekip büyüklüğüne göre hangisine yönelmeli
Doğru seçim, seçimi kimin yaptığına ve karşılaştırmanın neyi ayakta tutması gerektiğine bağlıdır.
| Ekip büyüklüğü | En çok ağırlık verilecek şey | Yönelinecek şey |
|---|---|---|
| Tek geliştirici | İnceleme süresi ve kendi makinesinde çalıştırma | Hangisinin incelemesi daha hızlıysa o; tek okuyucu sizsiniz |
| Küçük ekip | Paralel çalıştırmalar ve paylaşılan görünürlük | İkisi de; tek bir Task üzerinden atanır, böylece herkes aynı kanıtı görür |
| Platform ekibi | Entegrasyonlar ve sağlayıcı bağımsızlığı | İkisini de tutun; iş akışı, gelecek çeyrek hangi ajan öne geçerse geçsin ayakta kalmalı |
O son satır, bir favori seçip onu savunmak yerine karşılaştırmayı çalıştırmanın gerçek nedeni. Bu çeyreğin en iyi ajanı, gelecek çeyreğin en iyisi olmayabilir; lider her değiştiğinde sürecinizi baştan kurmak da başlı başına bir vergidir. Kendi hatalarınız üzerinde, herhangi bir ajanı çalıştıran bir iş akışında karşılaştırma yapmak, cevap değiştiğinde geçiş yapmakta özgür kalmanızı sağlar.
Tek bir ekosisteme bağlanmak yerine birden fazla kodlama ajanı kullanmaya devam etmek istiyorsanız, Sharkly tam da bu problem için tasarlandı. Sharkly'yi indirin, bir Computer bağlayın ve aynı gerçek hatayı iki ajana da atayın. Geri aldığınız sonuç sizin kod tabanınızla ilgili olur; haftanızı tahmin edebilecek tek şey de o.
SSS
Hata düzeltmede Claude Code mu Codex mi daha iyi? Genel olarak hiçbiri kazanmaz. Aynı hatada, en iyi yapılandırmalarıyla genellikle biri diğerinin önüne geçer ve hangisinin geçtiği, hatanın türüne ve deponun büyüklüğüne göre değişir. Backlog'unuzdan gerçek bir hatayı ikisinde de çalıştırın; doğruluk, kapsam, testler ve inceleme süresi üzerinden puanlayın.
Claude Code ve Codex'i aynı hatada aynı anda çalıştırabilir miyim? Evet, her birinin kendi çalışma kopyası olması koşuluyla. Tek bir checkout'ta iki ajan birbirinin üzerine yazar. Her birine izole bir worktree verin ya da Sharkly'de Task'ı ikisine de atayın ve her Agent kendi Computer'ında çalışsın.
Benchmark skorları hangi ajanı kullanacağımı söyler mi? Hangi ajanların test etmeye değer olduğunu söylerler; bir ajanın sizin deponuzda nasıl davrandığını değil. Herkese açık bir veri kümesi sizin dahili kütüphanelerinizi, lint yapılandırmanızı ya da test edilmemiş modülünüzü asla içeremez. Liderlik tablosunu bir filtre olarak görün, sonra asıl sayılan karşılaştırmayı kendi kodunuzda yapın.
Sharkly, Claude Code ya da Codex'in yerini alır mı? Hayır. Sharkly, ekibinizin hâlihazırda çalıştırdığı kodlama ajanlarının etrafındaki atama, bağlam ve inceleme katmanıdır. Yürütmeyi ajanlar yapar; Sharkly Task'ı yönetir, çalıştırmaları görünür tutar ve kabulü insanlara bırakır.
Karar vermeden önce kaç hatayı karşılaştırmalıyım? Bir hata size yalnızca o hata hakkında bir şey söyler. Bir örüntüye güvenmeden önce yöntemi birkaç farklı hata türünde çalıştırın ve sonuçların üst üste konabilmesi için ölçütleri her seferinde aynı tutun.


