Fatura, değiştirmesi en kolay ama okuması en önemsiz sayıdır. Ekibinizin rutin işlerini milyon token başına 0,10 $ ve 0,50 $ maliyetle GPT-6 Luna'ya yönlendirirseniz, model maliyeti kalemi bir gün içinde dibe vurur. İki hafta sonra fatura hâlâ düşüktür, panoda her zamankinden daha fazla tamamlanmış çalıştırma birikmiştir ve geçen salı gününden kalan dört değişiklik hâlâ birinin bunları onaylamasını beklemektedir.
Ters giden hiçbir şey yok. Yalnızca maliyeti, gözünüzü ayırmadığınız bir kalemden kimsenin fiyatlandırmadığı bir kaleme kaydırdınız.
Kabul edilen değişiklik başına maliyet; bir insanın onayladığı tek bir değişikliğe ulaşana dek yapılan her denemeye harcanan toplam para ve insan zamanıdır. Başarısız çalıştırmaları, kimsenin birleştirmediği (merge etmediği) çıktıları ve birinin her ikisi hakkında karar verirken harcadığı dakikaları hesaba katar. Hiçbir sağlayıcı bunu yayımlamaz, hiçbir kıyaslama testi (benchmark) bunu ölçmez; oysa ekibinizin canlıya aldığı işlerle birlikte değişen tek rakam tam olarak budur.
TL;DR
Daha ucuz bir model, tek bir denemenin maliyetini düşürürken incelemeyi yapan kişinin dikkatiyle ödenen üç unsuru artırır: yayına alınan değişiklik başına deneme sayısı, deneme başına çıktı miktarı ve yayına alınan değişiklik başına verilen karar sayısı. İncelemecinin dikkati 22 Eylül 2026'da ucuzlamadı. Ucuz katman, bir denemenin başarılı olup olmadığına bir makinenin karar verdiği her yerde gerçekten daha ucuzdur; bu kararı bir insanın vermesi gereken her yerde ise sinsice pahalıdır. Ajanlar araştırır, yürütür, test eder ve raporlar. İnsanlar ise yön belirler, yetki verir ve sonucu kabul eder. Çözüm, yönlendirme (routing) mantığını değiştirmeden önce muhasebe yaklaşımını değiştirmektir: Her Runtime için kabul edilen değişiklik başına düşen deneme sayısını ve harcanan insan dakikasını ölçün; bir insanı bekleyen işleri cuma günleri kapıldığınız bir his olmaktan çıkarıp sayabileceğiniz somut bir durum (state) haline getirin.
Üç farklı birim ve bunlardan yalnızca biri gerçekten sizin
| Birim | Kim kullanır | Ne söyler | Neyi göz ardı eder |
|---|---|---|---|
| Milyon token başına | Sağlayıcı fiyatlandırma sayfaları | Girdi ve çıktının ne kadara mal olduğu | İşinizin kaç token tükettiği |
| Tamamlanan görev başına | Kıyaslama (benchmark) tabloları | Puanlanan tek bir denemenin maliyeti | Başarısız denemeler, kod tabanınız, inceleme süreci |
| Kabul edilen değişiklik başına | Ekibiniz | Yayına alınan bir değişikliğin uçtan uca maliyeti | Hiçbir şeyi; kimsenin bunu yayımlamamasının sebebi de bu |
Her iki yapay zekâ laboratuvarı da 22 Eylül 2026'da modellerini yayımladı ve ikisi de verilerini ortadaki sütuna göre paylaştı. Bu tabloları en sağdaki sütunmuş gibi okumayın.
Ucuz katmanın maliyeti ve elde ettiği skorlar
| GPT-6 Luna | GPT-6 Sol | Claude Opus 5.5 | |
|---|---|---|---|
| API kimliği | gpt-6-luna |
gpt-6-sol |
claude-opus-5-5 |
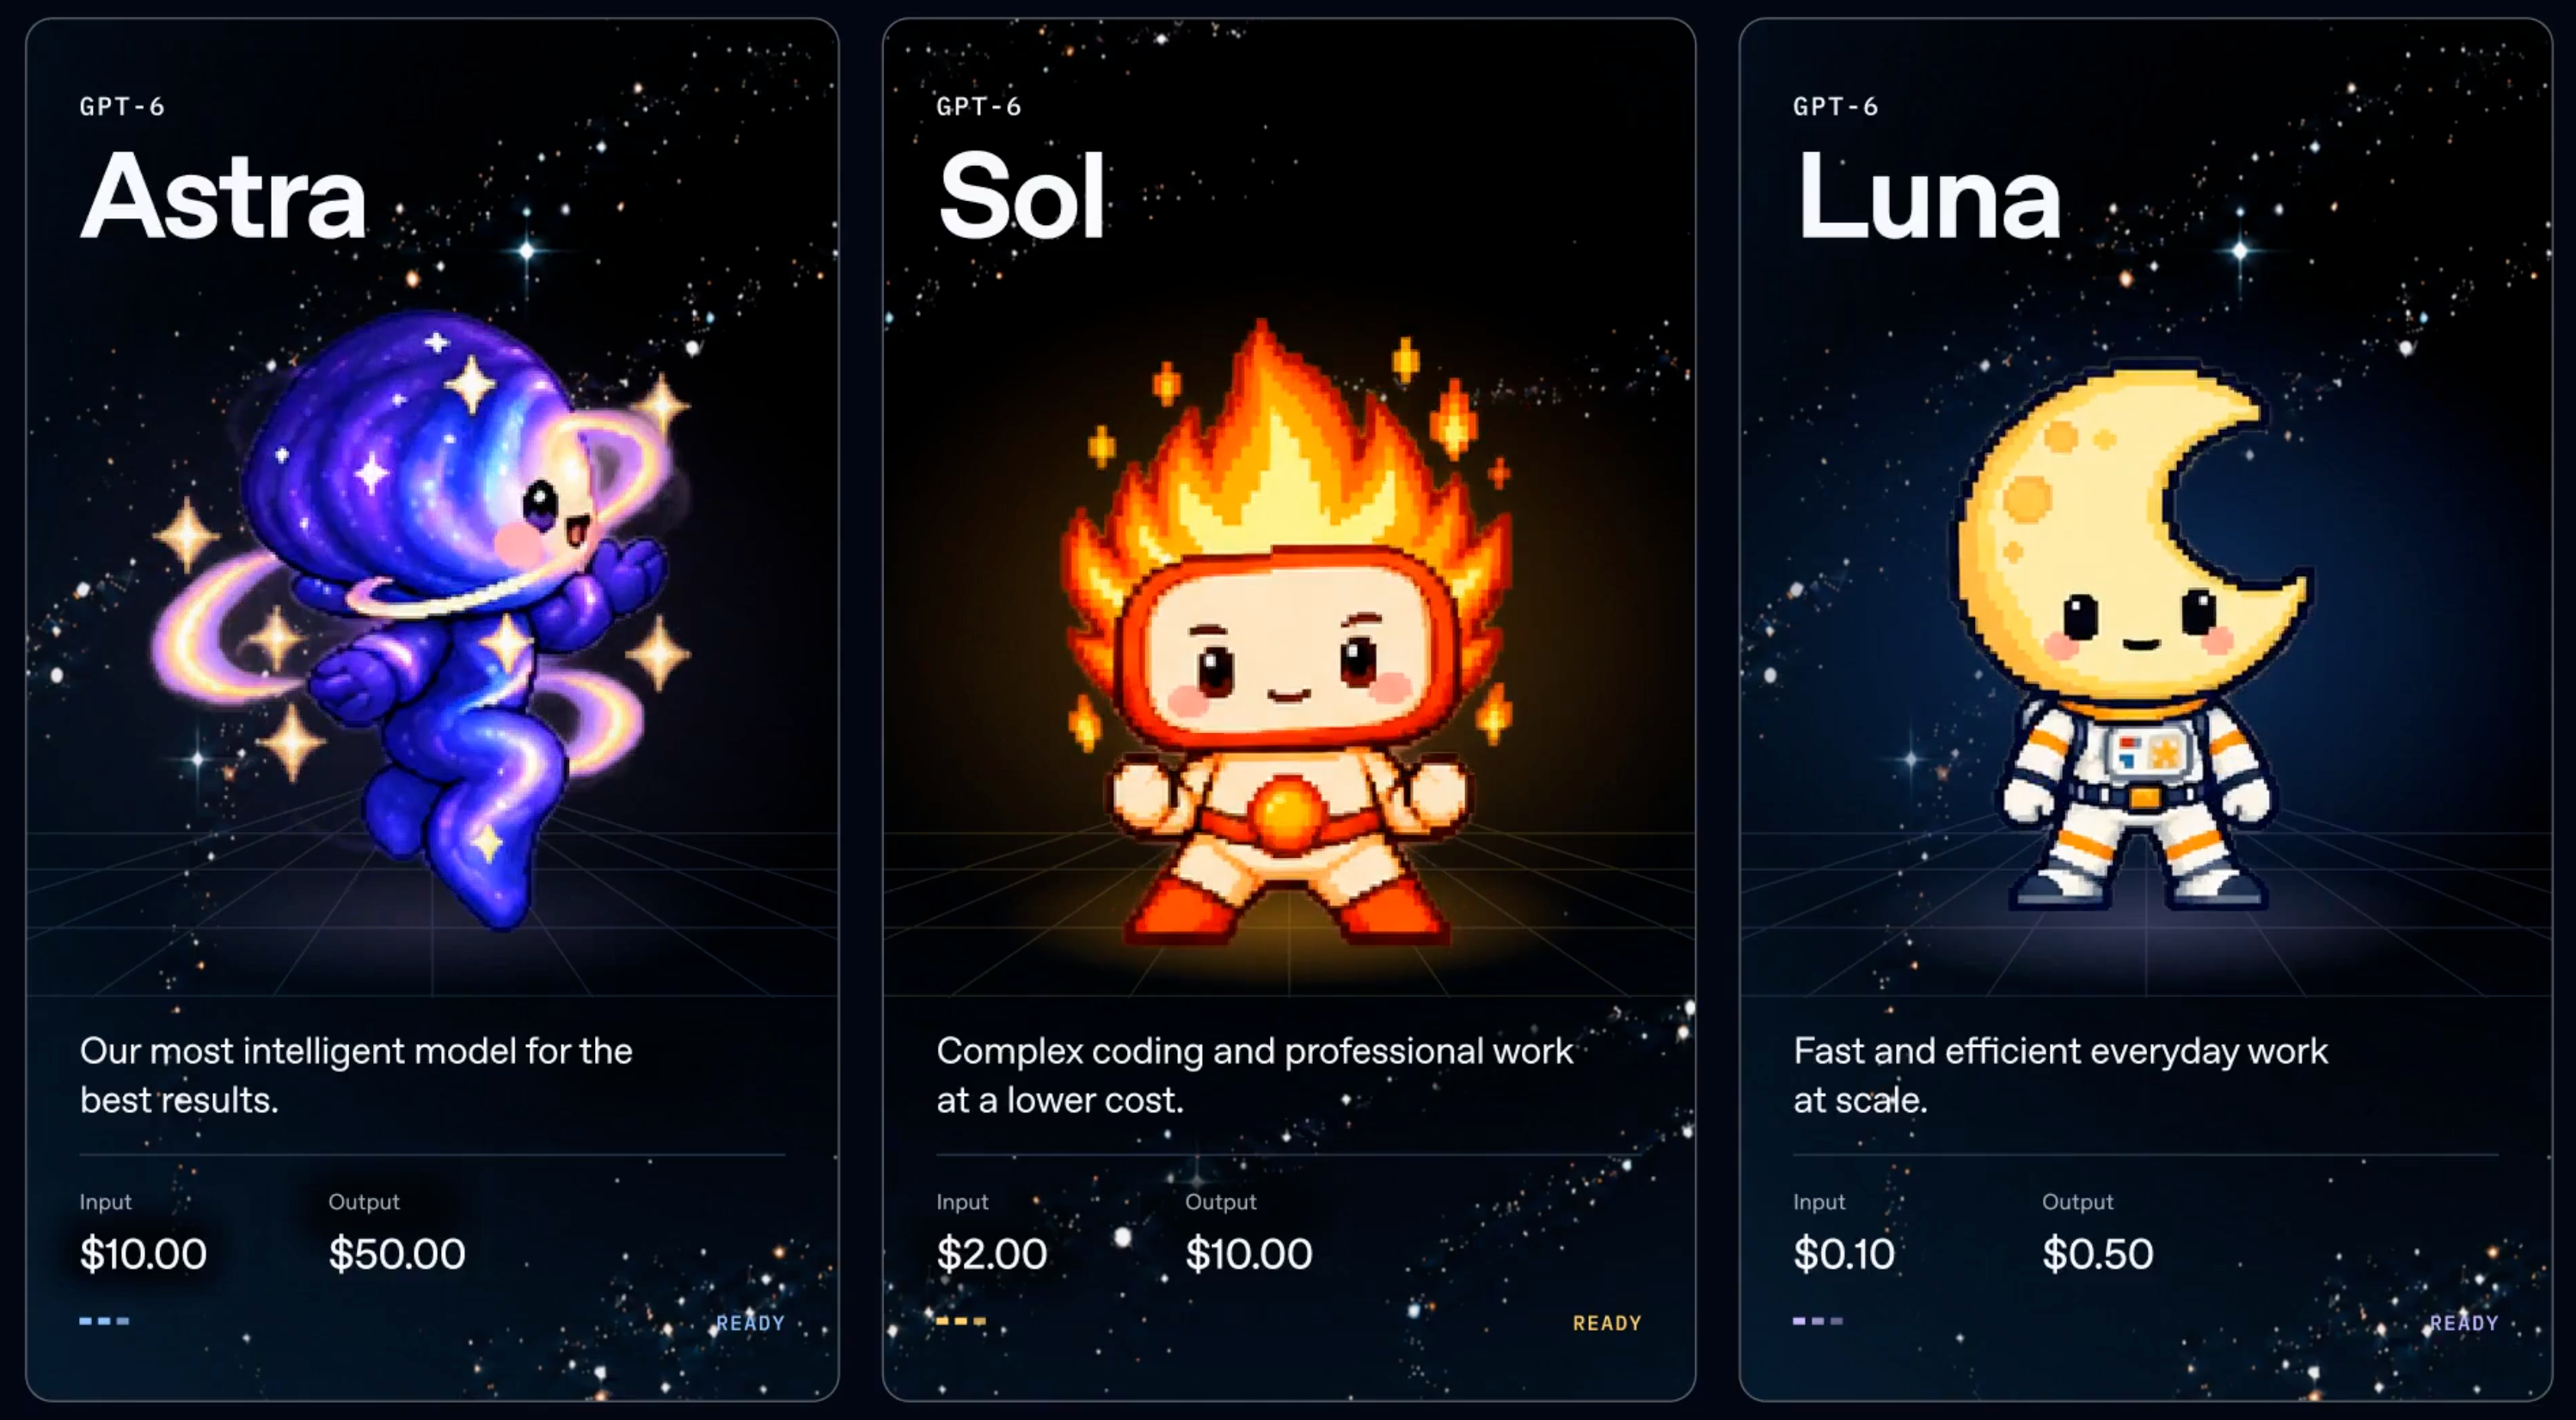
| 1M başına girdi / çıktı | $0.10 / $0.50 | $2 / $10 | $4 / $20 |
| Önbelleğe alınmış girdi | Okumalarda %90 indirim | Okumalarda %90 indirim | 0,20 $ okuma, 5 $ yazma |
| Bağlam penceresi | 1M | 872k | 1M |
| Maksimum akıl yürütmede DeepSWE 1.1 | %66,6 | %68,8 | Lansman materyallerinde yer almıyor |
| Artificial Analysis endeksi | 37 | 48 | 58, 212 model arasında 1. |
Anthropic, Opus 5.5 için AutomationBench'te %40,0 başarı bildiriyor. OpenAI ise AutomationBench 1.0.6 üzerinde, görev başına 0,27 $ maliyetle ve ekstra yüksek akıl yürütme seviyesindeki Sol için %33,2 açıklıyor. İki laboratuvar, iki farklı test ortamı ve görev başına yayımlanan tek bir maliyet. Bu iki veri doğrudan birbiriyle kıyaslanamaz ve asıl mesele de zaten bunları kıyaslayamıyor olmanızdır: Hiçbir sağlayıcı tablosu sizi kabul edilen değişiklik başına maliyete ulaştırmaz.
Birinci gizli etken: Kabul edilen değişiklik başına deneme sayısı
OpenAI, DeepSWE 1.1 üzerinde maksimum akıl yürütme seviyesindeki Luna'nın skorunu %66,6, Sol'un skorunu ise %68,8 olarak belirtiyor. Kendi hesaplarımıza göre bu, Luna ile yapılan yaklaşık her üç denemeden birinin başarısızlıkla sonuçlanması anlamına geliyor. Kendi kod deponuz elbette DeepSWE değildir ve oranlarınız farklı olacaktır; ancak genel tablo değişmez: Birkaç puan daha düşük alan ucuz bir katman, çalıştırma başına yalnızca birkaç puan daha kötü demek değildir; önünüze bir tur daha çalışma gerektiren bir iş getirme ihtimali birkaç puan daha yüksektir.
Bu fazladan turun parasal maliyeti önemsiz kalmaya devam eder. OpenAI, aynı testte maksimum akıl yürütmeli Luna'nın Claude Opus 5'e kıyasla görev başına %93 daha ucuz olduğunu bildiriyor. Deneme sayısını iki katına çıkarsanız bile, yine kendi hesabımıza göre yaklaşık %86 daha ucuz kalırsınız. Model maliyeti kalemi hiçbir zaman asıl sorun haline gelmez.
Fakat başarısız olan o deneme başka hiçbir yerde bedava değildir. Bir dal (branch), bir değişiklik özeti ve insana ait bir karar süreci doğurmuştur. Başarısız bir çalıştırma sıfır maliyet demek değildir. Sonunda hiçbir değişikliğin çıkmadığı bir inceleme yüküdür.
İkinci gizli etken: Ucuz katman daha uzun düşünerek iyi sonuç verir
Luna'nın bu başarılı sayılarının nereden geldiğine dikkat edin. %66,6 skoru maksimum akıl yürütme seviyesinde elde edilmiştir ve OpenAI'ın doğruluk notuna göre Luna, daha yüksek efor harcadığında yaklaşık yüzde bir maliyetle GPT-5.6 Sol seviyesine ulaşmaktadır. Ucuz katman, kabul edilebilir kaliteye daha fazla efor harcayarak ulaşır; bu efor ise daha fazla çıktı token'ı ve daha uzun bekleme süresi (wall clock) olarak geri döner.
İki sağlayıcıdan da bağımsız bir üçüncü taraf olan Artificial Analysis, maksimum akıl yürütme varyantlarında Luna için saniyede 153,9 çıktı token'ı ve ilk token'a kadar 124,23 saniye; Sol içinse saniyede 115,2 token ve ilk token'a kadar 102,15 saniye ölçüyor. Bunları gösterge niteliğinde kabul edin: Üçüncü taraf verileridir, doğrudan maksimum varyantları kapsar ve laboratuvarlar yeni ölçümler yaptıkça değişir.
Bunun faturanıza değil, ekibinize yansıyan iki sonucu olur. İki dakika boyunca sessiz kalan bir çalıştırma, donup kalmış bir çalıştırmayla birebir aynı görünür; bu yüzden biri gidip kontrol eder. Ayrıca daha uzun bir yürütme izi (trace) ve daha uzun bir diff, birisi onay vermeden önce deneme başına okunması gereken daha fazla şey demektir. Okumak kıt bir kaynaktır ve siz az önce bu kaynağı tüketen şeyden daha fazla satın aldınız.
Üçüncü gizli etken: Diff'ler değil, kararlar
Bir Görevin (Task) atanması ile bir değişikliğin kabul edilmesi arasında insanın vermesi gereken kararları sayın. Güçlü bir Runtime üzerinde olağan yol tektir: oku ve onayla. Doğrulanamayan bir iş yapan ucuz bir Runtime üzerinde ise bu yol dallanır ve her dal bir insan demektir:
- Çalıştırma başarısız oldu. Aynı Runtime üzerinde yeniden mi denemeli, yoksa daha güçlü bir modele mi aktarmalı?
- Çalıştırma testleri geçti ancak sizin tercih etmeyeceğiniz bir yaklaşım benimsedi. Kabul mü etmeli, geri mi göndermeli?
- Çalıştırma üç kısmi sonuç üretti. Asıl değişiklik hangisi?
- Çalıştırma bir soru sormak için durdu. Kim yanıtlayacak ve bu yanıt nerede saklanacak?
Bunların hiçbiri token faturasında görünmez. Tümü, insan incelemesinden sorumlu kişinin takvimine yansır.
Kendi rakamlarınızla toplam hesap
cost per accepted change
  = attempts per accepted change
      x (model cost per attempt + reviewer minutes per attempt x loaded cost per minute)
  + escalation cost when the cheap tier hands the job back
Bu formülü bizim değil, kendi rakamlarınızla doldurun. Milyon token başına 0,10 $ ve 0,50 $ seviyesinde parantez içindeki model maliyeti neredeyse sıfıra yuvarlanır; dolayısıyla bu ifadeyi belirleyen şey deneme sayısıyla çarpılan inceleme dakikalarıdır. Daha ucuz bir Runtime'a geçmek, zaten küçük olan bir gider kalemini daha da küçültürken, küçük olmayan kalemi katbekat artırır. Bu bazen yine de karlı bir takas olabilir; ancak asla sadece bir fiyatlandırma sayfasına bakarak değerlendirebileceğiniz bir takas değildir.
Ucuz katman ne zaman gerçekten daha ucuzdur?
Denemenin başarılı olup olmadığına bir makine karar veriyorsa ucuz bir Runtime kullanın. Tip denetimi (typecheck), birim testler, derleme (build), lint kuralları, şema doğrulaması: Sonuç, bir insan dikkatini harcamadan önce gelir ve fazladan yapılan denemeler cuma gününüzü tüketmek yerine test altyapısı tarafından eritilir. Çalışan bir Crew'daki iş hacminin büyük kısmı bundan ibarettir ve sıkıcı işleri Luna'ya yönlendirmenin en mantıklı gerekçesi de budur.
İşin kabul edilmesi bir muhakeme gerektirdiğinde ucuz bir Runtime kullanmayın. Mimari kararlar, veri taşımaları (data migrations), güvenlikle ilgili her konu ve "bu doğru mu?" sorusunun bir komutla yanıtlanamadığı her durum buna dahildir. Bu noktalarda puan farkı doğrudan incelemecinin dakikalarına dönüşür ve satın alabileceğiniz en ucuz şey, yalnızca bir kez okumanızın yettiği bir denemedir.
Eskalasyon kuralını kişisel tercihlere bırakmak yerine yazılı hale getirin; çünkü tercihler her zaman daha ucuz fiyata yenik düşer. Model yönlendirme, her şeyden önce doğrulanabilirlikle, ancak ikinci planda maliyetle ilgili bir kuraldır.
Hiçbir sağlayıcı bunu size neden söylemez?
Her iki laboratuvar da aynı gün birbirine karşı kıyaslama yaptı ve OpenAI'ın karşılaştırma tabanı Claude Opus 5 oldu; oysa Anthropic birkaç saat sonra onun yerine Opus 5.5'i duyurdu. Her sağlayıcının ucuz katmanı, kendi müşteri kazanım hunisinin (funnel) tepesidir. Hiçbiri "ekonomik modelimiz incelemecilerinize fazladan bir inceleme turuna mal olacak" cümlesini yayımlamayacaktır ve bunu belirtmemekte de haksız sayılmazlar: Zira bu sayı kod tabanınıza ve ekibinize bağlıdır.
Sharkly model token'ı satmaz. Model kullanımı, ekibinizin zaten kullandığı araçlarda yapılandırılmış abonelikler veya API anahtarları üzerinden devam eder; bu nedenle buradaki hiçbir çıkar hangi Runtime'ı seçtiğinize bağlı değildir. Bu argümanın dürüstçe savunulabileceği yegâne konum da budur ve iş akışınızın bir sonraki ucuz model çıktığında baştan kurulmaya ihtiyaç duymadan ayakta kalmasının sebebi de tam olarak budur.
Kontrol paneline bunun yerine ne koymalı?
Runtime başına, kabul edilen değişiklik başına düşen insan dakikası. Geçişten sonra bu süre arttıysa, daha ucuz olan model aslında daha pahalıdır ve artık elinizde bunun kanıtı vardır. Çalıştırma başına maliyet (dolar), 22 Eylül 2026 itibarıyla bağlayıcılığını yitirmiş bir soruya yanıt verir.
Runtime başına, kabul edilen değişiklik başına deneme sayısı. Geriye kalan her şeyi bu değişken belirler ve bunu size hiçbir sağlayıcı veremez. Bu veriyi, her bir denemeyi hangi Runtime'ın ürettiğini ait olduğu Görev (Task) üzerinde kaydederek elde edersiniz.
Bir insanı beklemeyi gerçek bir durum (state) olarak tanımlamak. Yürütme, engelleyiciler, sonuçlar ve takip eden tartışmalar Görev (Task) zaman çizelgesine döner; böylece insan müdahalesi gerektiren kuyruk kulaktan dolma bir his olmaktan çıkıp sayılabilir hale gelir. Her çalıştırmanın kendi kanıtıyla birlikte sunulmasını zorunlu kılın:
Before a run reaches a person, the Task carries:
- the change summary
- typecheck, test, and build results
- known limits and what was not attempted
- the attempt number and which Runtime produced it
Küçük ölçekte bunların hiçbirine ihtiyacınız yoktur. Eğer tek bir kişi iki Ajan çalıştırıyor ve üretilen her şeyi aynı öğleden sonra okuyabiliyorsa, böyle devam edin: Durumlar ve kuyruklar, henüz sahip olmadığınız bir sorun için gereksiz yükten (overhead) ibarettir. Bu hesaplama mantığı, tamamlanmış kaç çalıştırmanın beklemede olduğunu artık kimse ezbere söyleyemediğinde önem kazanmaya başlar.
Ucuzlamayan kısım
İki laboratuvar da aynı gün tek bir denemenin fiyatını düşürdü. Ancak hiçbiri sizin yerinize diff okuyan bir şey sunmadı ve değişikliğin nihai sorumluluğu yine bir insanda bitiyor. Daha ucuz bir model, daha ucuz bir iş akışı anlamına gelmez. Sadece daha ucuz bir deneme anlamına gelir; denemeler ise en pahalı adımı insan olan bir süreci besler.
Hâlihazırda birden fazla kodlama ajanı çalıştırıyorsanız Sharkly; hangi Runtime'ın hangi denemeyi ürettiğini, kanıt olarak ne eklediğini ve şu anda bir insanın önünde ne kadar işin beklediğini tek bir yerden görmenizi sağlar.