
TL;DR: MIT CSAIL'daki bir ekip, bir frontier modele Qwen3.5-0.8B'nin ağırlıklarını bir Python sandbox'ı içinde okuttu ve düzenlettirdi; hem forward pass'ler için katı bir bütçe hem de her adımın tam kaydı vardı. Yazarlar MATH-500'ün %7,9'dan %48,1'e çıktığını bildiriyor. Siz de bir coding agent'a model ağırlıklarını aynı şekilde düzenlettirebilirsiniz: panoda beş görev, her görevin içine yazılmış bütçe, değerlendirme için ikinci bir agent ve düzenlenen dosyayı onaylayan bir insan.
2 Kasım 2026'da Rikiya Takehi, Jayden Teoh, Alex Zhang ve Omar Khattab, Sparks of Weight-Space Programming başlıklı yazıyı yayımladı. Çalışmalarındaki model GPT-6 Astra, ağırlık tensörlerini açtı, bunlar üzerinde numpy ve PyTorch kodu yazdı, bir hipotez kurdu ve 0,8 milyar parametreli bir modelde 131.072 sayıyı değiştirdi.
Kurulumu okuduğunuzda tanıdık geliyor: bir sandbox, bir araç bütçesi, her prompt'un ve çalıştırılan hücrenin kaydı. Bu, harness'ı olan bir coding agent; ve bugün ekibinizin kopyalayabileceği kısım da harness.
MIT ekibinin yaptıkları, rakamlarla
Weight-space programming, bir LLM'in bir ağın parametrelerini veri olarak okuyup doğrudan düzenlemesi anlamına gelir; gradient descent yok, eğitim koşusu yok. MIT yazısı bunu küçük modeller üzerinde, katı araç sınırları altında ve her tur kaydedilerek aktarıyor.
Öne çıkan sonuç, Qwen3.5-0.8B düzenlemesi:
| Metrik (yazarların rakamları) | Temel model | Düzenlenmiş model |
|---|---|---|
| MATH-500 | %7,9 | %48,1 |
| GSM8K | %13,8 | %67,1 |
| IFEval | %21,0 | %62,3 |
| 32.768 token sınırına takılan koşular | %93,0 | %33,1 |
Astra, modelin token'ı bitene kadar döngüye girme alışkanlığının izini 15. ve 19. katmanlardaki MLP'lerin yazdığı tek bir yöne kadar sürdü ve sonra bunu her katmanda 64 çıktı sütunundan çıkardı: 131.072 ağırlık, yani modelin %0,016'sı. Yayımlanan checkpoint Apache-2.0 lisanslı ve kartında temel modelden yalnızca iki tensörün farklı olduğu yazıyor: o iki katmandaki down_proj.weight matrisleri.
Sonucu neden harness belirliyor
Yazıdaki iki bulgu, bir ekip için manşet sonuçtan daha önemli.
Bütçe sonucu değiştirdi. Her forward pass, ortalama 64 dizilik bir batch işledi. 10 pass ile MATH-500 %12,3'e ulaştı. 25 ile %14,1'e. 50 ile %48,1'e. Aynı model, aynı görev, ama agent'ın bir fikri kaç kez test edebileceğine dair farklı bir tavan.
Araçlar sonucu değiştirdi. Yalnızca iki Gemma 3 270M varyantının ağırlıkları verildiğinde Astra, dört denemenin hiçbirinde hangisinin yalakalık yaptığını söyleyemedi. Kendi yazdığı en fazla 16 metin için attention ağırlıklarını döndüren bir araç verildiğinde ise üç çiftin hepsinde yalakalık yapanı doğru tespit etti.
Demek ki iki kaldıraç var: agent'ın ne kadar harcayabileceği ve neye bakabileceği. İkisi de koşu başlamadan önce yazılı olmalı.
Sınırlar da aynı netlikte. Astra, Gemma 3 270M'i MATH-500'de iyileştiremedi: %6,8'lik bir temelden en iyi düzenlemesi %7,7'ye ulaştı. Yazarlar bunu, modelin sahip olmadığı bir yeteneği eklemek değil, bir engeli kaldıran bir düzenleme olarak yorumluyor. Bulguların erken olduğunu ve birçoğunun tek koşuya dayandığını söylüyorlar. Kendi deneyinizi bir düzeltme değil, bir test olarak planlayın.
Bir coding agent'ın model ağırlıklarını güvenle düzenlemesini nasıl sağlarsınız
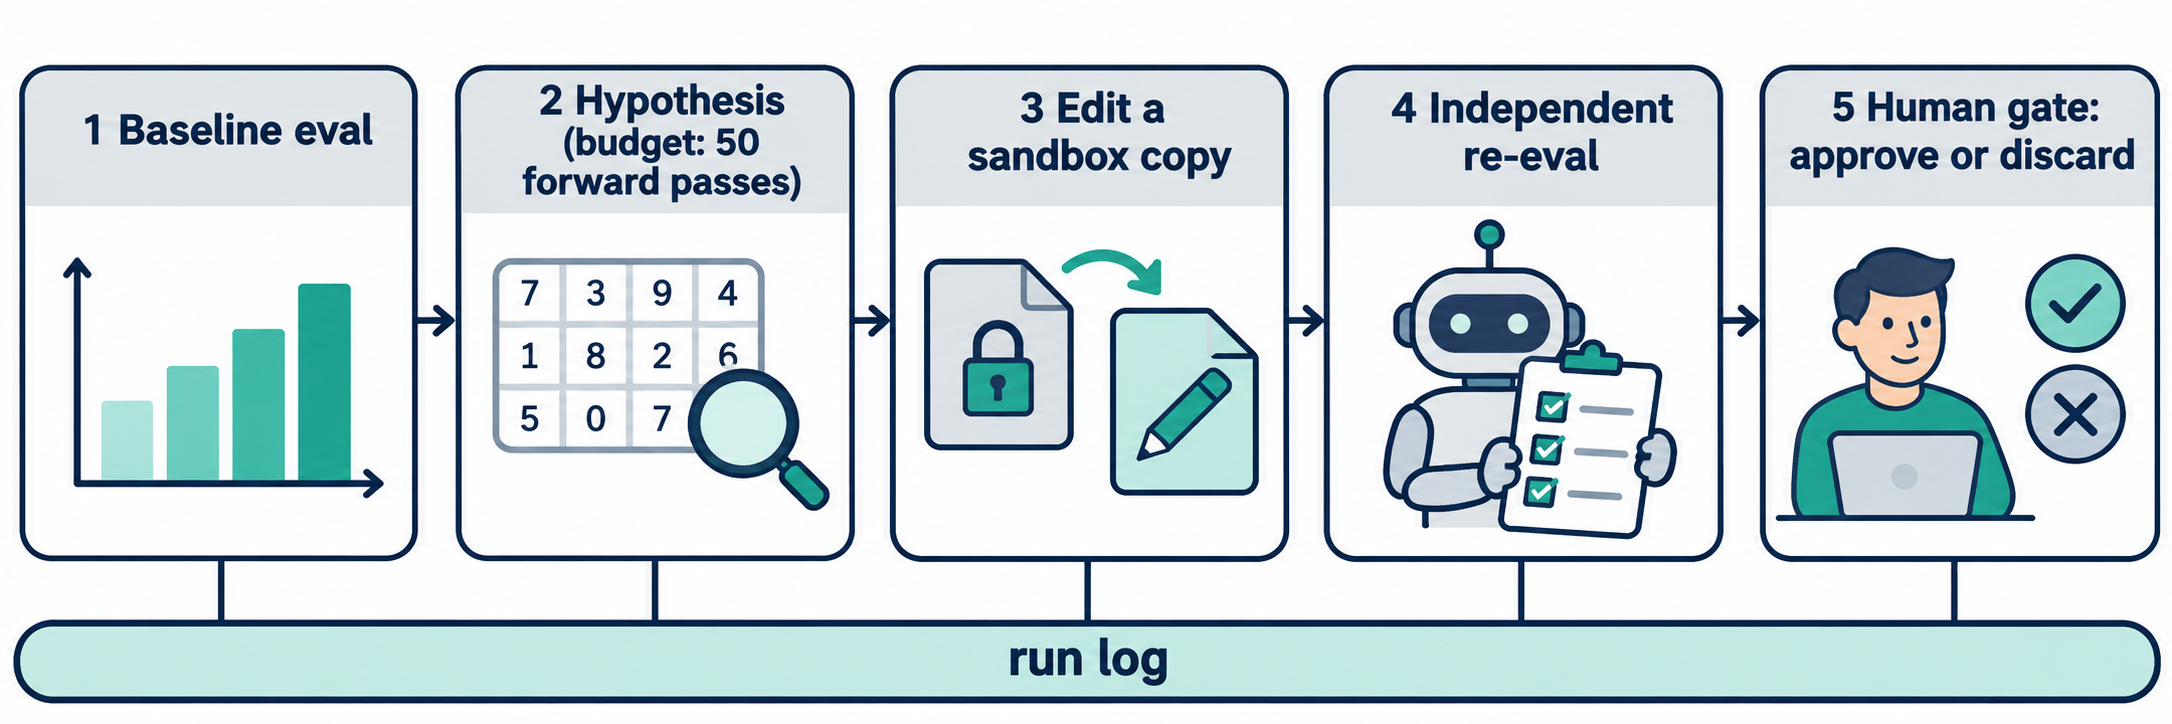
Güvenli bir weight-space deneyinin beş özelliği vardır:
- Orijinal ağırlıklar her agent için salt okunurdur.
- Forward pass bütçesi, görevin içinde bir sayıdır ve sandbox tarafından uygulanır.
- Düzenleyicinin gördüğü değerlendirme seti, reviewer'ın çalıştırdığı regresyon setinden ayrıdır.
- Her koşunun kaydı, ait olduğu aşamaya bağlı kalır.
- Düzenlenen dosya sandbox dışında herhangi bir yere yüklenmeden önce bir insan onay verir.
Sharkly forward pass'leri saymaz veya tensörleri incelemez. Bunu sandbox script'iniz yapar; okuma ve düzenlemeyi ise runtime'ınız (Claude Code, Codex veya halihazırda kullandığınız başka bir agent) üstlenir. Sharkly işi bir arada tutar: her aşamanın sahibi, ne kadar harcayabileceği, neyin geri döndüğü ve kimin onay verdiği. MIT ekibinin kendi log deposunda bir Codex yapılandırması ve sandbox script'i içeren bir harness/ klasörü var; sandbox tarafı için faydalı bir referans.
Aşama 1: Dokunulmamış modelin temel değerlendirmesi
İlk görev, değerlendirmenizi orijinal checkpoint üzerinde çalıştırır; skorları ve modelin nerede başarısız olduğunu kaydeder. Qwen3.5-0.8B için koşuların %93,0'ı token sınırına takıldı. Hipotez görevi bu başarısızlık açıklamasına ihtiyaç duyar.
Aşama 2: Ağırlıkları oku ve bir hipotez yaz
Bütçenin olduğu görev bu. Sayıyı gövdeye, agent'ın yanlış okuyamayacağı bir biçimde koyun:
## Stage 2: Hypothesis from weights

Model: ./models/qwen3.5-0.8b-base (READ-ONLY, mounted ro)
Budget: 50 forward passes, batch 64. The sandbox stops at 50.
Tools: numpy, torch (CPU), forward() wrapper. No attention tool.
Inputs: Stage 1 failure notes (task COIN-xxx), GSM8K/MATH practice split only.
Output: one-page hypothesis naming layers, tensors and the direction to change,
plus the passes used. Do not write any weights in this stage.
Görevdeki bütçe bir söz; sandbox wrapper'ındaki bütçe ise garanti. İkisini de yazın ve wrapper'a kullanılan pass sayısını bastırın ki bu sayı koşu kaydına geçsin.
Aşama 3: Düzenlemeyi bir sandbox kopyasında yap
Düzenleyen agent, checkpoint'in bir kopyasını değiştirir ve diff'i bildirir. Orijinale hiçbir zaman yazma erişimi almaz. Sharkly'de her görev koşusu kendi izole dizinini alır ve repo çalışmaları her koşu için ayrı bir worktree kullanabilir; böylece 3. aşama, 1. aşamanın ölçtüğü şeye dokunamaz.
Aşama 4: Bir reviewer agent tarafından bağımsız yeniden değerlendirme
Bu aşamayı, düzenlemeyi yapan agent'tan farklı bir agent'a atayın. 1. aşamanın değerlendirmesini yeniden çalıştırır ve düzenleyicinin hiç görmediği bir regresyon seti ekler. Bir Crew çalıştırıyorsanız lider, düzenlemeyi bir üyeye, yeniden değerlendirmeyi başka bir üyeye verebilir. Bu örüntü, ayrı bir reviewer'ı olan karma model Crew ile örtüşür: değişikliği yazan agent, onu puanlayan agent değildir.
Düzenleyici, görebildiği şeye göre optimize etti; dolayısıyla yalnızca o problemlerde ortaya çıkan bir kazanç pek bir şey kanıtlamaz.
Aşama 5: Diff üzerinde insan onay kapısı
Son görev bir kişiye üç ekle ulaşır: değişen tensör listesi, öncesi-sonrası tablosu ve reviewer'ın regresyon sonuçları. Bu görev ilerlemeden hiçbir şey düzenlenmiş checkpoint'i sandbox dışında yüklemez.
Bu kısa script ilk eki üretir. İki safetensors checkpoint'ini karşılaştırır ve değişen her tensörü listeler:
from safetensors import safe_open
import torch

BASE = "models/qwen3.5-0.8b-base/model.safetensors"
EDIT = "sandbox/qwen3.5-0.8b-edit/model.safetensors"

changed, total = [], 0
with safe_open(BASE, "pt") as a, safe_open(EDIT, "pt") as b:
    assert set(a.keys()) == set(b.keys()), "tensor names differ"
    for name in a.keys():
        x, y = a.get_tensor(name), b.get_tensor(name)
        total += x.numel()
        n = (x != y).sum().item()
        if n:
            changed.append((name, n, (x - y).abs().max().item()))

for name, n, dmax in changed:
    print(f"{name}: {n:,} weights changed, max |delta| {dmax:.4g}")
print(f"{sum(c[1] for c in changed):,} of {total:,} weights changed")
Yayımlanan checkpoint'te model kartı, tam olarak iki down_proj.weight tensörü görmeniz gerektiğini söylüyor. Kendi düzenlemeniz hipotezin hiç adlandırmadığı tensörlere dokunuyorsa, onu çöpe atmanızın nedeni budur.
Panoyu Sharkly'de çalıştırmak
İşte tek bir deney için pano. Her satır, kendi atananı, durumu ve koşu geçmişi olan bir görev.
| Görev | Atanan | Bütçe veya kapı | Tamamlanma koşulu |
|---|---|---|---|
| 1. Temel değerlendirme | Değerlendirme agent'ı | Yalnızca değerlendirme seti | Skorlar ve başarısızlık notları paylaşıldı |
| 2. Ağırlıklardan hipotez | Düzenleyici agent | 50 forward pass | Hipotez paylaşıldı, kullanılan pass sayısı kaydedildi |
| 3. Sandbox düzenlemesi | Düzenleyici agent | Yalnızca kopya, orijinal salt okunur | Diff ve düzenlenmiş dosya sandbox'ta |
| 4. Yeniden değerlendirme ve regresyon | Reviewer agent | Ayrılmış regresyon seti | Öncesi/sonrası tablosu paylaşıldı |
| 5. Onayla veya çöpe at | Bir kişi | İnsan kapısı | Karar göreve kaydedildi |
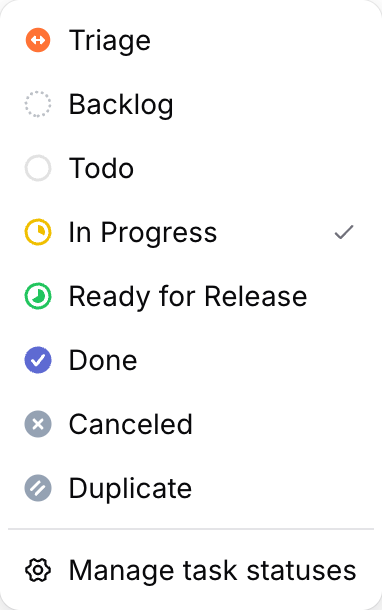
Aşamaları blocks ilişkileriyle bağlayın ki pano zinciri göstersin. Sharkly'nin görev ilişkileri kapsamı konusunda dürüsttür: bir ilişki kartta bağımlılığı ve ilerlemeyi gösterir, ama tek başına bir görevi taşımaz veya bir koşu başlatmaz. Her aşamayı, kendinden önceki bitene kadar Backlog'da tutun. Bir agent'a atanan görev, Backlog'da durduğu sürece koşu başlatmaz; dolayısıyla onu oradan çıkarmak tetikleyicidir.
4. aşama bittiğinde agent, görevi insan incelemesi bekliyor olarak bırakabilir ve kişi bunu Inbox'ta görür. Execution log, her koşunun başlangıcını, bitişini, araç çağrılarını ve tetikleyicisini kaydeder: denetim iziniz, ait olduğu aşamada tutulur. Agent'ları nerede durdurmanız gerektiği hakkında daha fazlası için coding agent'lar için onay kapıları yazısına bakın.
Başlamadan önce pratik sınırlar
- Küçük başlayın. Çalışmada CPU üzerinden tensör erişimiyle 0,8B ve 270M modeller kullanıldı. Dakikalar içinde değerlendirebileceğiniz bir model seçin.
- Eksik yeteneklerde kazanç beklemeyin. Gemma sonucu, bir düzenlemenin modelin önünü açabileceğini ama ona bir şey öğretemeyeceğini söylüyor.
- Tek koşuyu bir anekdot olarak görün. Düzenlemeye güvenmeden önce deneyi yeni bir agent'la tekrarlayın.
Sonuç
MIT yazısından çıkarılacak yeniden kullanılabilir ders harness: yazılı bir bütçe, sınırlı araçlar, eksiksiz bir kayıt ve başkasının kontrol edebileceği sonuçlar. Bunlar, kod düzenleyen bir coding agent'ın etrafında zaten istediğiniz kontrollerdir.
Denemek için beş görevi bir Sharkly Space'te oluşturun, 1'den 4'e kadar olan aşamaları bağlı Computer'ınızdaki agent'lara atayın ve 5. aşamayı kendinize ayırın. Sharkly'ye sharkly.ai adresinden ücretsiz başlayabilirsiniz.
SSS
Bir coding agent model ağırlıklarını düzenleyebilir mi?
MIT CSAIL çalışmasında evet. GPT-6 Astra, bir Python sandbox'ında Qwen3.5-0.8B tensörlerini okudu ve 131.072 ağırlığı değiştirdi. Yazarlar MATH-500'ün %7,9'dan %48,1'e çıktığını bildiriyor. Çalışma henüz erken, küçük modeller üzerinde yapıldı ve birçok sonuç tek koşuya dayanıyor.
Weight-space programming nedir?
Bir LLM, bir ağın parametrelerini veri olarak okuyup eğitim olmadan doğrudan düzenler. Tensörleri kodla analiz eder, bir hipotez kurar, ağırlıkları değiştirir ve etkisini sınırlı sayıda forward pass ile ölçer.
Forward pass bütçesi neden önemli?
Yazarların Qwen ablasyonunda 10 pass MATH-500'de %12,3'e, 25 pass %14,1'e ve 50 pass %48,1'e ulaştı. Bütçe, agent'ın kaç fikri test edebileceğini belirler. Bunu göreve yazın ve sandbox'ta uygulayın.
Ağırlık düzenleme bir modele yeni yetenekler kazandırabilir mi?
Çalışma bunun aksini öneriyor. Astra'nın en iyi düzenlemesi, Gemma 3 270M'i MATH-500'de %6,8'den %7,7'ye taşıdı. Yazarlar, düzenlemenin Qwen'de bir yetenek eklemekten çok bir engeli kaldırdığı sonucuna varıyor.
Düzenlenmiş ağırlıkların production'a ulaşmasını nasıl engellerim?
Orijinali salt okunur olarak bağlayın, bir kopyayı düzenleyin, bağımsız bir yeniden değerlendirme çalıştırın ve dosya sandbox dışında herhangi bir yere yüklenmeden önce bir insanın tensör diff'ini onaylamasını şart koşun.


