
Aynı saat içinde dört kodlama ajanı işini bitirip dört pull request açıyor. Biri faturalandırma yeniden deneme yoluna dokunuyor, biri bir test yardımcı fonksiyonunun adını değiştiriyor, biri bir migration ekliyor, biri de README'deki bir yazım hatasını düzeltiyor. Darboğaz kod ya da testler değil. Darboğaz, kişinin tek bir diff'i okumadan önce yanıtladığı soru: bunlardan hangisine önce bakayım? Ajanlar paralel çalışmaya başladığında insan incelemesinin darboğaz olduğunu savunmuştuk. Bu yazı, o sorunun mekanik kısmını, yani kuyruğun sıralanmasını ve Jev gibi bir karar modelinin incelemeyi devralmadan bu yükü gözden geçirenin sırtından nasıl alabileceğini ele alıyor.
Jev nedir
Jev, TypeSafe AI'ın bir System One Model'idir: ona bir durum parçası ve bir dizi tipli soru gönderirsiniz, o da her soru için kalibre edilmiş bir olasılıkla yanıt döner; asla serbest metin değil. İsim karışıklığını baştan giderelim: buradaki Jev, TypeSafe'in modeli olan Jev; YouTuber ya da Japon ensefaliti aşısı değil. TypeSafe'in lansman yazısı bunu "girdi yapılandırılmamış durum, çıktı tipli olasılıksal kararlar" olarak tanımlıyor. API tek bir uç noktadan oluşuyor: POST https://api.typesafe.ai/v1/systemone, Bearer anahtarı, jev-latest modeli ve üç soru tipi: noul (evet/hayır olasılığı), choice (255'e kadar seçenek arasından tek seçim) ve score (2 ile 10 düzey arasındaki bir rubrikte konum). Yalnızca metin; istek başına 64k token, bunun 32k'sı durum için, milyon girdi token'ı başına 0,042 $, çıktı için ücret alınmıyor. Kodlama ajanları için karar katmanı olarak Jev başlıklı diğer yazımız modeli genel hatlarıyla ele alıyor; burada ise onu tek bir iş için kullanıyoruz.
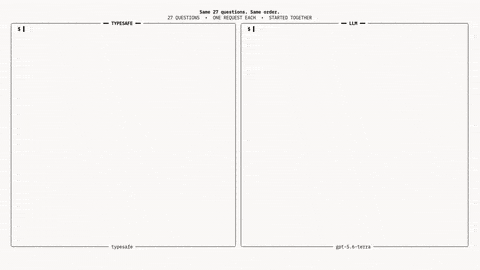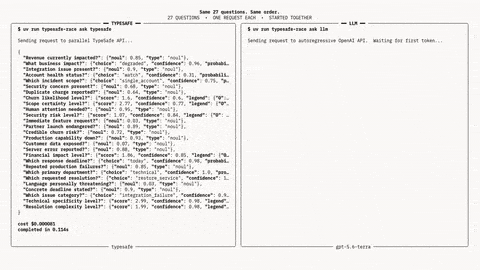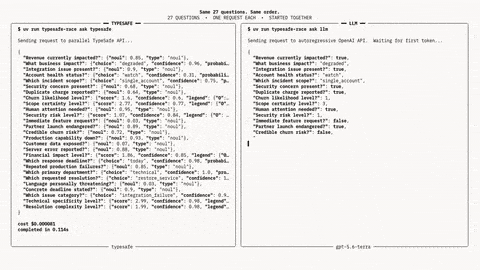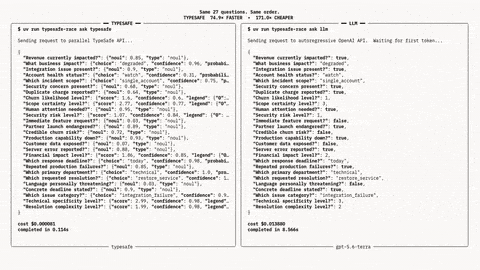
İncelemenin üç sorusu
Bir kodlama ajanının açtığı her PR aynı üç soruyu doğurur ve her biri tek bir primitife karşılık gelir. Üçü için de durum aynıdır: bir diff özeti, test sonucu ve dokunulan yollar. Diff'in tamamı değil. Özet, çağrıyı bütçe içinde tutar ve modelin kodu baştan incelemesi yerine yönlendirme sorusunu yanıtlamasını sağlar.
Merge öncesi bir insan gerekiyor mu? Bir noul. Filtre budur. Bir PR'ın insan kuyruğuna girip girmeyeceğine ya da düşük öncelikli bir hatta bekleyip beklemeyeceğine bu karar verir.
Hangi gözden geçiren ya da kuyruk? Ekibinizin gerçekten işlettiği kuyruklar üzerinden bir choice. Yanıt, seçimin yanında tam dağılımı da getirir; böylece iki kuyruk arasındaki 0,48 / 0,44 gibi bir bölünme, PR'ın bir sahiplik sınırının tam üzerinde durduğunu söyler ki bu da başlı başına bilinmeye değerdir.
Ne kadar risk taşıyor? Sıralı bir rubrik üzerinde bir score. Sonuç, olasılıkla ağırlıklandırılmış bir konumdur; yani bir değişiklik "testlerle kapsanan mantık değişikliği" ile "auth, faturalandırma veya veriye dokunuyor" arasında 2,6'ya düşebilir. Bu sayı, kuyruğun sıralama anahtarıdır.
Tek bir istek üçünü birden yanıtlar:
{
  "model": "jev-latest",
  "state": {
    "task": "SH-418 Fix double charge on retried webhook",
    "diff_summary": "billing/retry.ts adds an idempotency key check; new test covers the retry path",
    "tests": "58 passed, 0 failed",
    "touched_paths": ["billing/retry.ts", "billing/retry.test.ts"]
  },
  "questions": {
    "needs_human": {
      "type": "noul",
      "instructions": "Does this change need a person to read it before merge?"
    },
    "queue": {
      "type": "choice",
      "instructions": "Which review queue owns this change?",
      "criteria": {
        "payments": "billing, invoicing, refunds, retries",
        "infra": "deploy, migrations, config",
        "frontend": "UI and client code",
        "docs": "documentation and comments only"
      }
    },
    "risk": {
      "type": "score",
      "instructions": "How much damage can this change do if it is wrong?",
      "criteria": ["cosmetic", "logic change covered by tests", "touches auth, billing, or data"]
    }
  }
}
Yanıt, aynı anahtarlar altında üç tipli cevaptır. SH-418 için needs_human değerinin 0,9 civarında, queue seçiminin payments ve risk değerinin rubriğin tepesine yakın çıkmasını bekleyin. Testleri yeşil olan bir faturalandırma yeniden deneme düzeltmesi yine payments kuyruğunun önüne geçer, çünkü yeşil testler "bunu bir insan okumalı mı" sorusunu yanıtlamaz.
Eşikler ve her bandın ne yaptığı
Bir olasılık, ancak kod onu bir eyleme dönüştürdüğünde işe yarar. Aşağıdaki bantlar bir başlangıç noktasıdır; deponuz için bir öneri değildir, bir hafta çalıştırdıktan sonra kendinize göre ayarlayın.
needs_human |
Eylem |
|---|---|
| 0,85 ve üzeri | İnsan kuyruğunun önü, risk değerine göre azalan sırada |
| 0,15 ile 0,85 arası | İnsan kuyruğu, risk değerine göre sıralı, yukarıdaki bandın arkasında |
| 0,15'in altı | Düşük öncelikli hat; yine de bir kişi kendi takvimine göre merge eder |
İki kural bu işi dürüst tutar. Birincisi, rubriğin tepesindeki risk, needs_human ne derse desin bir PR'ı her zaman ön banda taşır. Bir şema migration'ının inceleme gerektirdiğine 0,12 olasılıkla inanan bir model, üretimi değil, düzenli görünen bir diff özetini görmüştür. İkincisi, ilk iki seçeneği birbirine 0,1'den daha yakın olan bir choice, hiçbirine değil, iki kuyruğa birden yönlendirir. Sahiplik konusundaki belirsizlik, bir değişikliğe iki kişinin göz atması için bir sebeptir; sıfır kişinin bakması için değil.
Her bantta kişide kalan şeye dikkat edin: merge. Bantlar okuma sırasını ve okuma derinliğini değiştirir. Kararı kimin verdiğini ise asla değiştirmezler.
Jev'i kuyruk için kullanın, kararı o vermesin
Jev'i, sorunun sabit bir yanıt kümesi olduğunda, durum aslına sadık bir özet olduğunda ve bir insanın dikkatini daha iyi bir sırayla harcamak istediğinizde kullanın: bunu kim okuyacak, ne kadar yakında, hangi kuyrukta. Bu sorular her PR'da karşımıza çıkar ve bu fiyatla her çalıştırmada sorulacak kadar ucuzdur.
Soru, değişikliğin doğru olup olmadığıysa bir insanı ya da akıl yürütmesini gösterebilen bir dil modelini kullanın. Bir değişikliğin inceleme gerektirdiğine dair bir olasılık, inceleme değildir. Jev'in derleyicisi yok, test çalıştırıcısı yok ve puanladığı dosyaya erişimi yok; elinde yalnızca sizin gönderdiğiniz özet var. "Merge edilmesi güvenli" için 0,96, o PR'ı birinin listesinin başına koymak için güçlü bir sebeptir; o birini atlamak için asla bir sebep değildir. Onay kapısı modelden sonra gelir ve modelin onu açmasının hiçbir yolu yoktur.
Topluluk neler yaptı
Lansmandan günler sonra bir geliştirici, README'sinde "TypeSafe Jev ile kurulmuş küçük bir kod inceleme iş akışı" olarak tanımlanan jev-review'ü yayımladı. Araç ya bir Git diff'ini ya da tüm bir kod tabanını inceliyor; doğruluk, güvenlik, güvenilirlik, uyumluluk ve test kapsamı açısından tarama yapıyor, etkiyi puanlamadan önce kod bölgelerini seçiyor, eşikleri ve iş akışı politikalarını kod içinde uyguluyor ve sonuçları yerel bir panoda gösteriyor. README kapsam konusunda temkinli: projeyi "hızlı tipli yargıları bir inceleme iş akışında birleştirme deneyi" olarak adlandırıyor ve "henüz derleyici tanılamalarını, statik analiz araçlarını, depo indekslemeyi veya üretilmiş açıklamaları entegre etmediğini" söylüyor.
Bu tasarımda kopyalamaya değer iki şey var: orkestrasyon kodda yaşar ve Jev yalnızca sınırları belli soruları yanıtlar; ayrıca iş aşamalara bölünmüştür — tüm diff üzerinde tek bir dev soru yerine önce bölgeyi seç, sonra puanla. Jev ayrıca Vercel AI Gateway'de typesafe-ai/jev olarak, AI SDK 7'deki experimental_evaluate üzerinden yer alıyor; Gateway belgeleri bunun yalnızca AI SDK üzerinden kullanılabildiğini belirtiyor.
Bu iş Sharkly'de nereye oturuyor
Sharkly sizin yerinize Jev'i çağırmaz ve bir karar modeli de değildir. Ekibinizin zaten çalıştırdığı kodlama ajanlarının etrafındaki paylaşılan Task, Computer, bağlam ve inceleme katmanıdır. Sıralanmış bir kuyruğun bu katmandan ihtiyaç duyduğu şey, çalışacak bir yer ve konacak bir yerdir.
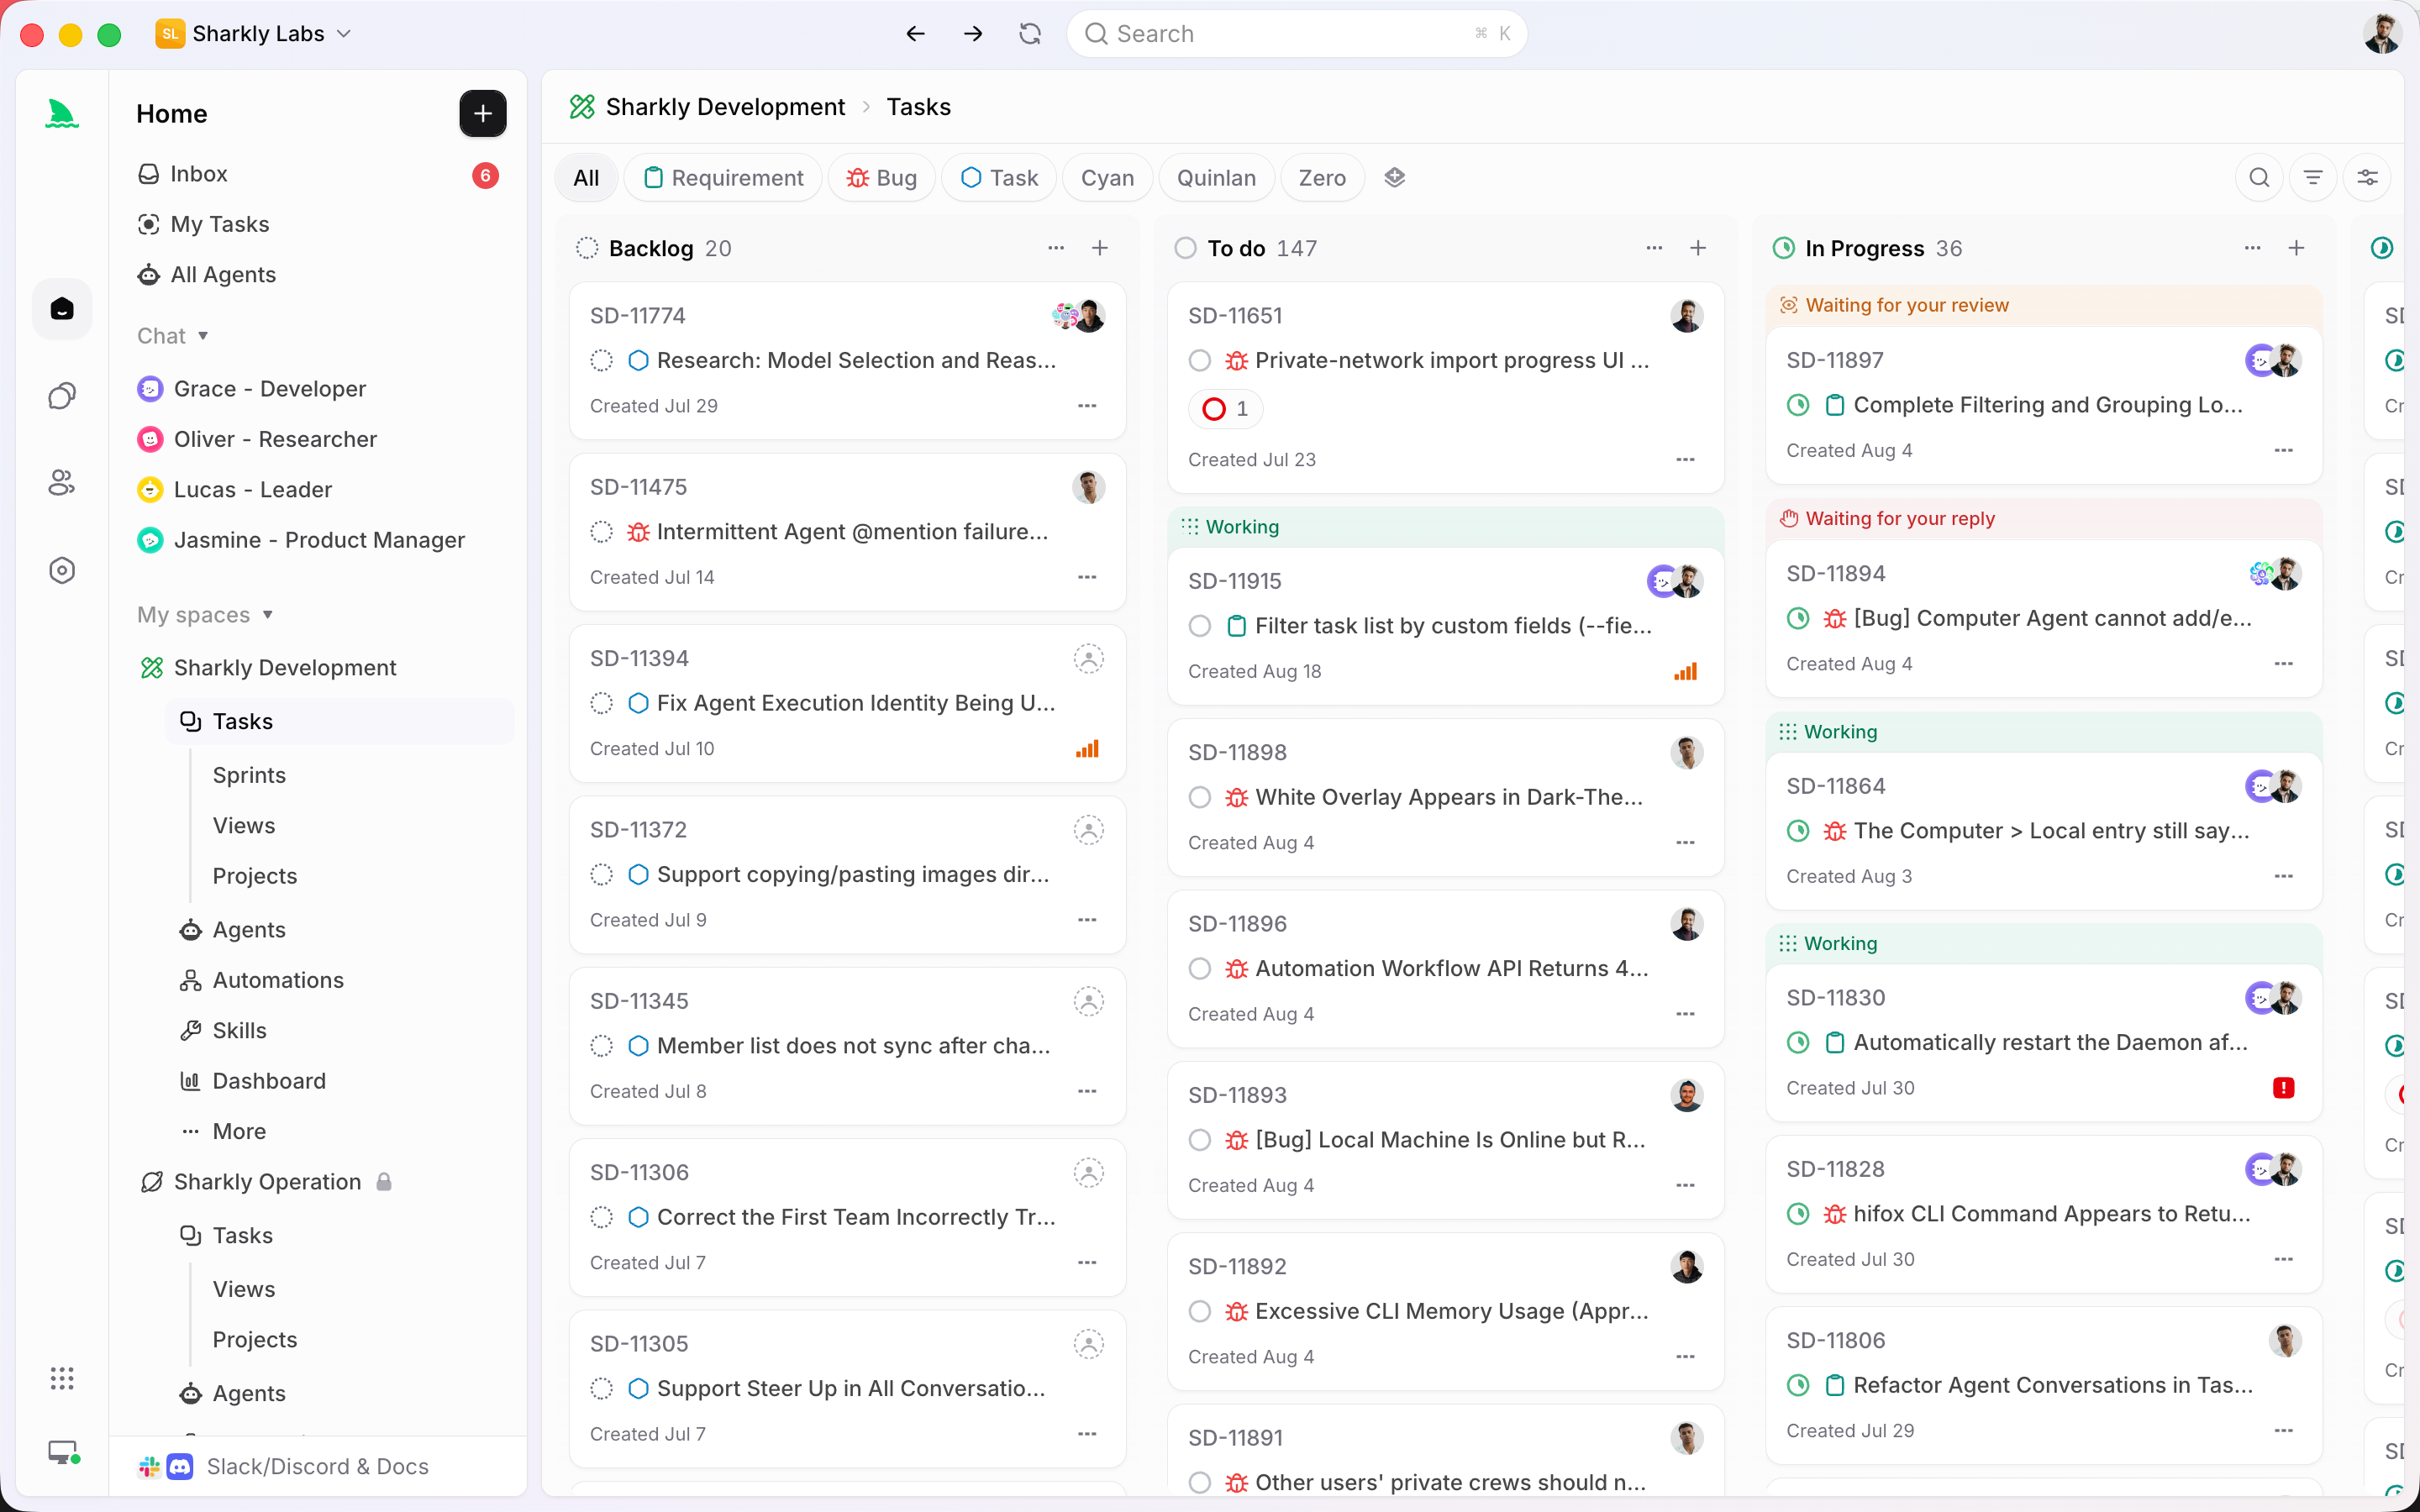
Çalışacak yer bir Automation'dır: bir tetikleyici üzerine bir Agent'ı bir dizi talimatla başlatan, Space'e ait bir kural. Tetikleyicilerden biri de bir görevin seçilen bir duruma geçmesidir. Bunu, Agent'larınızın bir PR açıldığında ulaştığı duruma yönlendirin; talimatlar da şöyle olur: Task'ın diff özetini, test sonucunu ve dokunulan yolları oku; Jev'i üç soruyla çağır; yanıtları ve bandı Task'a yorum olarak yaz; kuyruk için bir etiket ayarla. Belgeler, tamamlanan bir çalıştırmanın "sonraki tüm iş sonuçlarının doğru olduğuna dair bir vaat olmadığını" açıkça belirtiyor; bu da inceleme bantlarının çizdiği sınırın aynısıdır.
Konacak yer ise Task'ın kendisidir. Bant, kuyruk ve risk puanı, gözden geçirenin zaten baktığı yere, çalıştırmanın değişiklik özeti ile doğrulama sonuçlarının yanına döner. Kişi, risk değerine göre sıralanmış panoyu açar ve her PR'ın neden orada durduğunu görür. Ajanlar pull request'i açar, testleri çalıştırır ve rapor eder. İnsanlar kuyruğun önerdiği sırayla okur, kabul ya da ret eder. Sıra bir olasılıktan geldi; karar gelmedi.
Zaten birkaç ajan çalıştırıyorsanız ve canınızı yakan şey inceleme kuyruğuysa, Sharkly ile başlarken kurulan iş akışı tam da budur: bir Computer, bir Agent ve sıralamanın ihtiyaç duyduğu kanıtı taşıyan bir Task.
SSS
Jev özet yerine diff'in tamamını okuyabilir mi?
32k token'a kadar durum alabiliyor, yani küçük bir diff sığar. Yine de özet gönderin: ajan diff'leri bütçeyi kolayca aşar ve özet, soruyu yönlendirme düzeyinde tutar. İnsanın okuduğu şey diff'in tamamıdır; yanında da görev düzeyinde kanıt bulunur.
Ya diff özetini ajanın kendisi yazdıysa?
O zaman özet ajanın lehine yanlış olabilir ve sıralama da bunu devralır. Diff'ten ayrı bir adımda üretilmiş bir özeti tercih edin ve tepedeki bir risk puanının her zaman düşük bir needs_human değerini geçersiz kılmasına izin verin. AI kod incelemesinin sınırları burada da geçerli: model kendisine gösterileni sıralayabilir, gösterilmeyeni doğrulayamaz.
Düşük bant, PR'ın otomatik olarak merge edildiği anlamına mı gelir?
Hayır. Düşük bant, bir kişinin onu kendi takvimine göre, kuyrukta ilk sırada okumadan daha sonra merge edeceği anlamına gelir. Merge'in ve ajanın ürettiği işin sahipliği her bantta adı belli bir kişide kalır.
Jev, Sharkly üzerinden ücretsiz mi?
Sharkly, Jev'i ya da başka bir modeli yeniden satmaz; kendi TypeSafe veya Gateway anahtarınızı getirirsiniz; tıpkı çalıştırmaların Runtime'larınıza bağlı abonelikler üzerinden ücretlendirilmesi gibi. Sharkly'ın kendisi şu anda 5 kişiye kadar olan organizasyonlar için ücretsizdir.


