
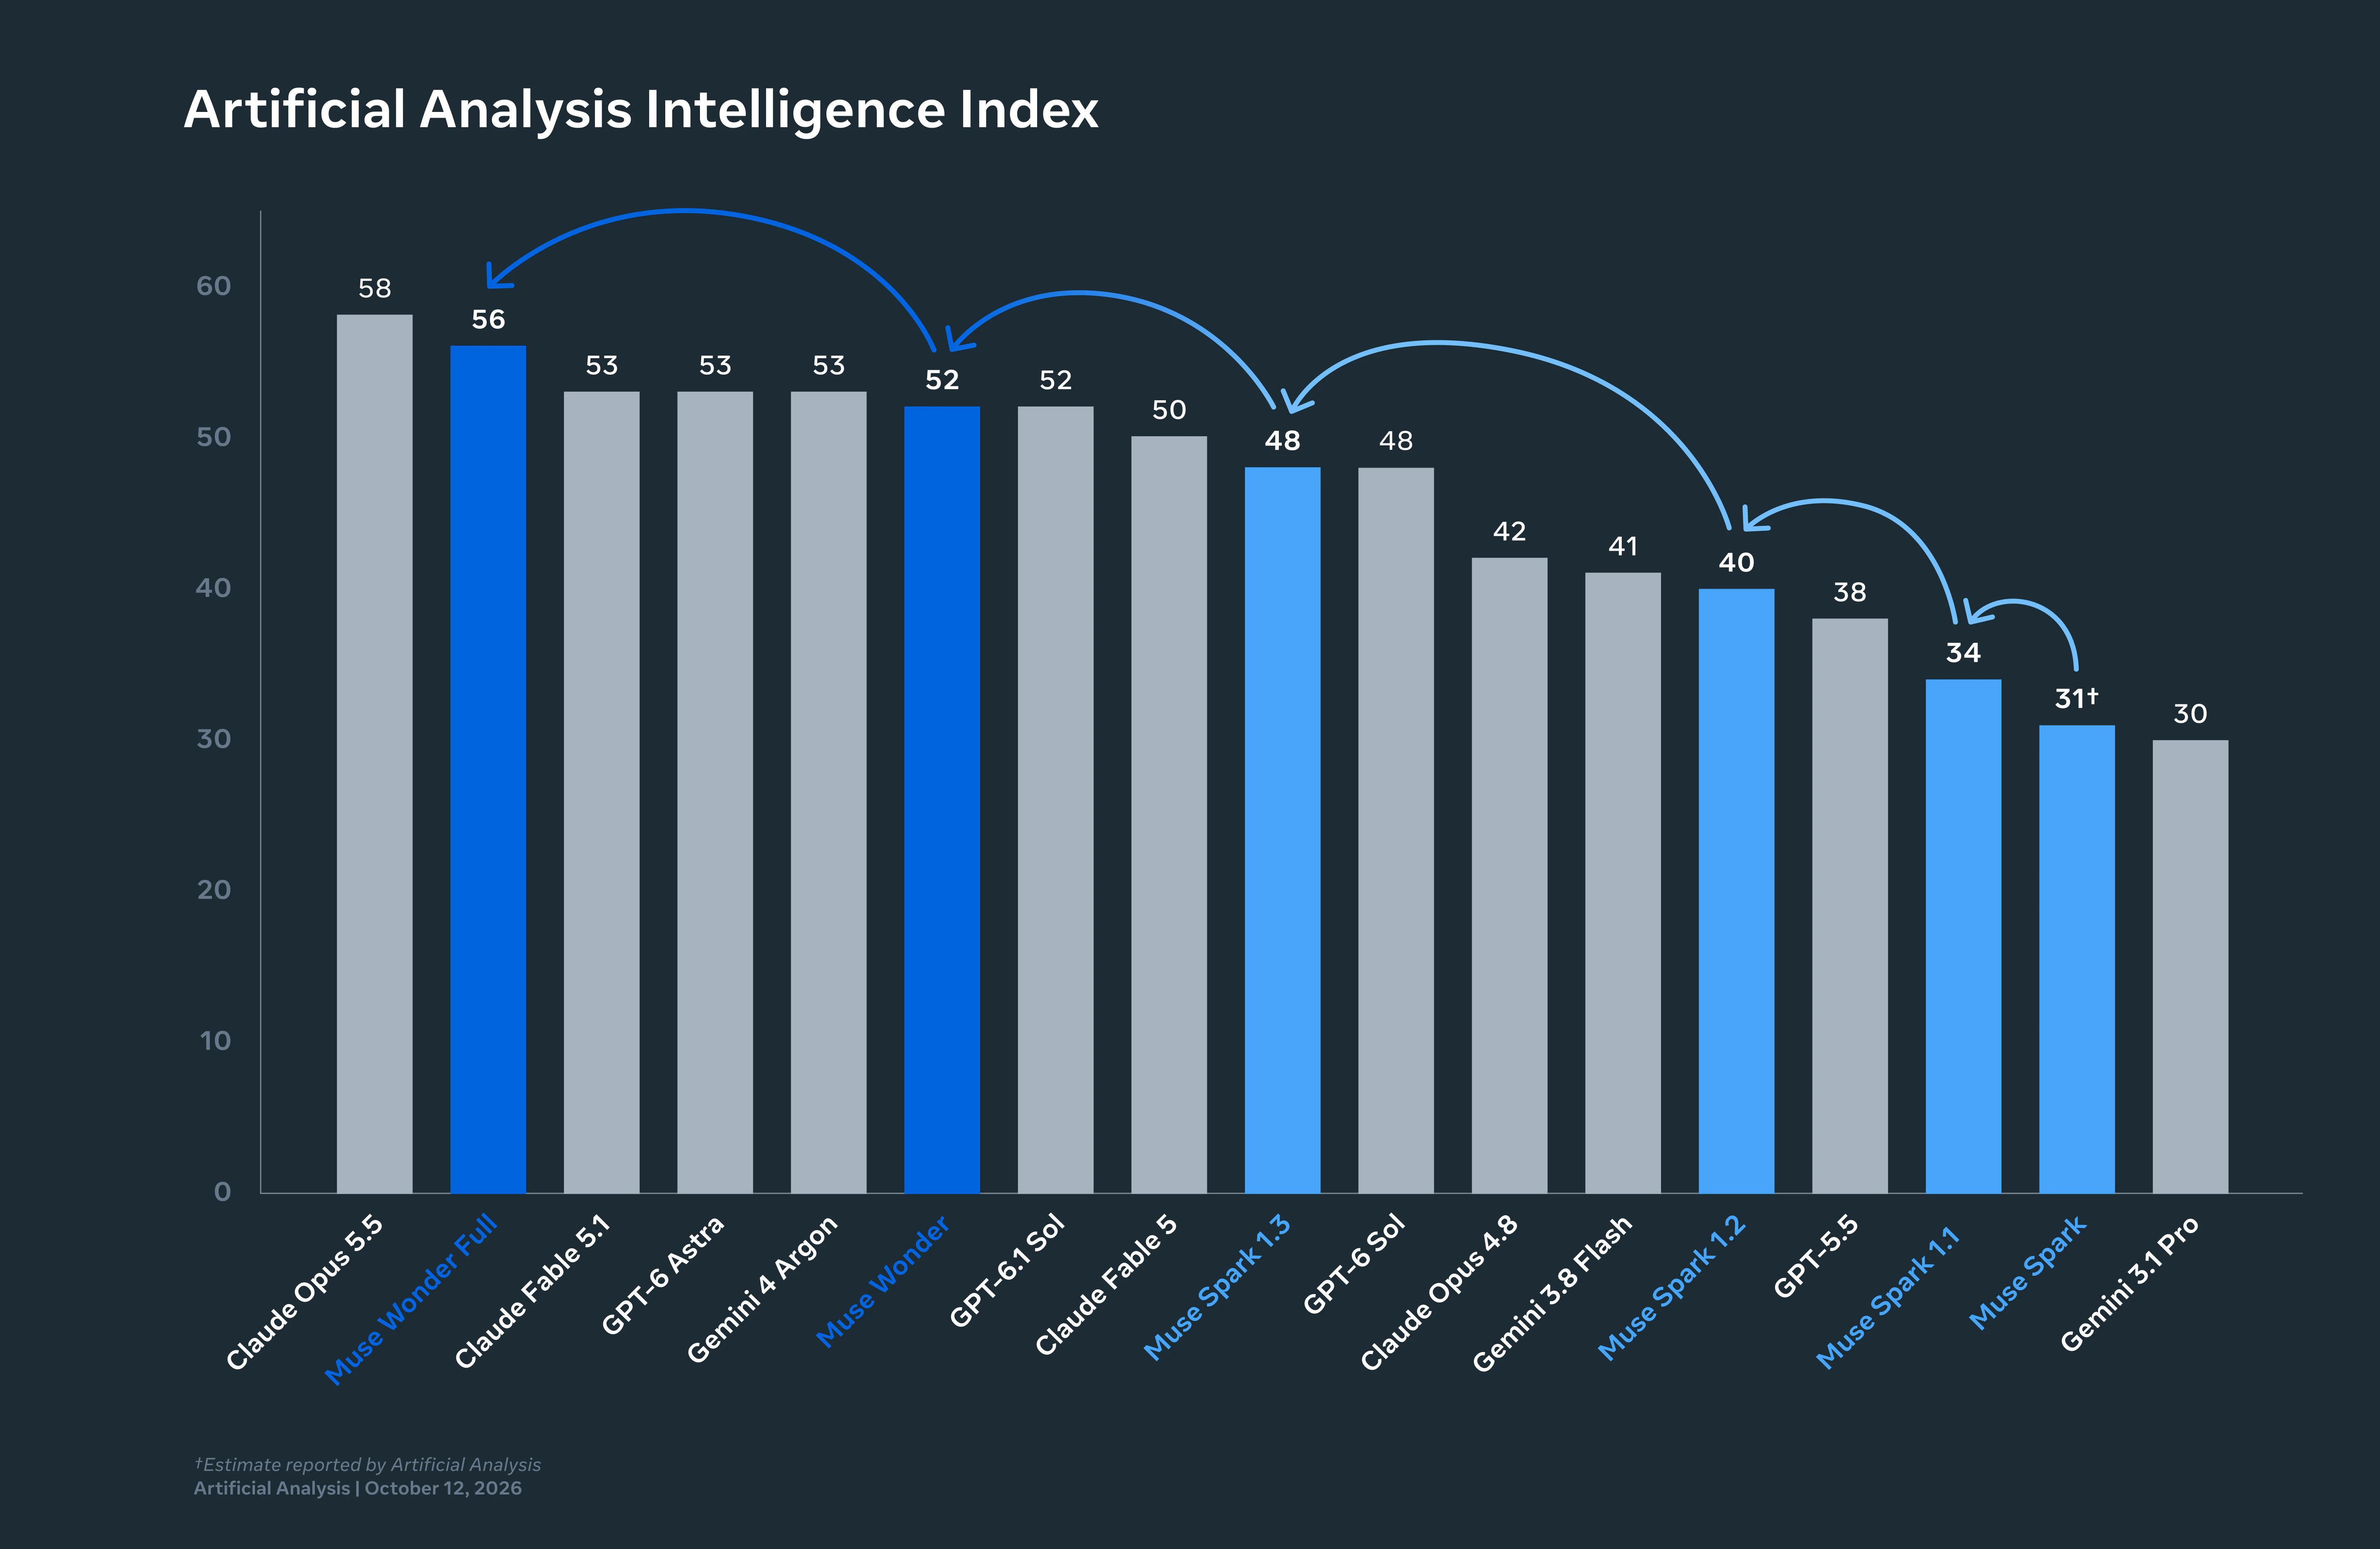
Muse Wonder ve Claude Opus 5.5 aynı fiyata sahip: bir milyon girdi (input) token'ı başına 4 dolar ve bir milyon çıktı (output) token'ı başına 20 dolar. Dolayısıyla bir Crew için ikisi arasındaki tercih bir bütçe kalemi değil, bir yönlendirme kuralıdır (routing rule). Meta'nın model kartına göre Wonder, uzun soluklu kodlama süreçlerini ölçen kıyaslamada önde yer alırken (SWE-Marathon, 46,3'e karşı 53,1); Opus ise terminal çalışmalarında (52,0'ye karşı 59,6), genel zekâda (bağımsız endekste 52'ye karşı 58) ve bilgi seviyesinde (25'e karşı 46) üstünlük sağlıyor. Bu dört rakam iki farklı Agent profilini tanımlıyor; seçimleri varsayılan bir modele bırakmak yerine bu verilere göre yönlendirme yapan bir pano, her iki modelden de çok daha yüksek verim alır.
Bu yazı söz konusu rakamları somut görev dağıtımlarına dönüştürüyor: Hangi Görevlerin Muse Wonder Agent'ına gideceği, hangilerinin Opus 5.5'te kalacağı, her birinin inceleme kuyruğuna (review queue) etkisi ve kuralın çalışıp çalışmadığının bir hafta sonra nasıl anlaşılacağı. Meta kulvarının kurulum detayları için Sharkly'de Muse Wonder ajanları nasıl çalıştırılır rehberine göz atabilirsiniz.
Yönlendirme için kritik olan rakamlar
| Ölçüm | Muse Wonder | Claude Opus 5.5 | Kaynak |
|---|---|---|---|
| SWE-Marathon (uzun süreli kodlama maratonları) | 53.1 | 46.3 | Meta model kartı |
| DeepSWE 1.1 | 78.8 | 74.2 | Meta model kartı |
| Terminal-Bench 4.0 | 52.0 | 59.6 | Meta model kartı |
| AA-Omniscience (bilgi) | 25 | 46 | Artificial Analysis |
| Halüsinasyon oranı | %27 | AA sıralamasına göre daha düşük | Artificial Analysis |
| Zekâ Endeksi | 52 | 58 | Artificial Analysis |
| Kodlama Agent'ları Endeksi | 63 | 66 (Claude Code) | Artificial Analysis |
| Endeks görevi başına maliyet | $4.52 | $5.98 | Artificial Analysis |
| Girdiler | Metin, görsel, video, ses | Metin, görsel, PDF | Sağlayıcı belgeleri |
Bu tabloyu iki ayrı profil olarak değerlendirin. Wonder: azimli, çıktıları net ve öz olduğu için görev başına daha hesaplı, bilgi hatırlama konusunda daha zayıf, video ve ses dosyalarını kabul ediyor. Opus: genel toplamda daha zeki, kabuk (shell) ortamında daha güçlü, bilgi dağarcığı daha geniş, görev başına maliyeti daha yüksek. Hiçbir profil mutlak olarak diğerinden üstün değildir; ikisi de farklı Görevlere hitap eder.
Muse Wonder Agent'ına uygun Görevler
Buradaki ortak payda, engeller barındıran uzun süreçlerdir. Meta modeli, "Aktif Odak" (Active Focus) adını verdiği yaklaşımla; farklı yöntemler deneyip engelleri aşacak biçimde eğitti ve SWE-Marathon da tam olarak bunu ölçmek için geliştirilmiş bir kıyaslama testidir.
- Test paketinin yeşilde tutulması gereken çok dosyalı yeniden yapılandırmalar (refactoring). Çok sayıda adım, her biri ayrı ayrı doğrulanabilir aşamalar ve ikinci ya da üçüncü bir yaklaşımı gerektiren başarısızlıklar.
- Bağımlılık ve çatı (framework) geçişleri. Klasik uzun soluklu maraton: yükselt, bozulsun, düzelt, tekrarla; burada modelin görevi on birinci adımda pes etmemektir.
- Kararsız (flaky) test paketlerine karşı düzeltme ve doğrulama döngüleri. Kendi oluşturduğu hatayı test paketinin kararsızlığından ayırt etmesi gereken çalışma süreçleri.
- Video veya ses girdisi içeren Görevler. Bir hatanın ekran kaydı, gereksinimleri içeren bir toplantı kaydı. Opus 5.5 bu tür girdileri desteklemez.
Kabul kriterlerini, çalışan sürecin bunu bizzat denetleyebileceği netlikte yazın. Wonder, Görev tanımında "packages/api altındaki tüm testler geçmeli ve changelog dosyasına bir girdi eklenmeli" dendiğinde en iyi sonucunu verir; bir işin "tamamlanmış" sayılmasının ne anlama geldiğine kendisi karar vermek zorunda kaldığında ise bocalayabilir.
Opus 5.5'te kalması gereken Görevler
- Ağırlıklı olarak terminal gerektiren işler. Altyapı betikleri, dağıtım işlem hatları (deploy pipelines), ajanın bir kabuk ortamında çalıştığı tüm senaryolar. Terminal-Bench'teki 7,5 puanlık fark ciddi bir ayrımı gösterir.
- Bilgiye dayalı her türlü görev. 46'ya karşı 25'lik Omniscience puanı, Wonder'ın bir olguyu bilmeme ihtimalinin iki kat daha yüksek olduğu anlamına gelir. Daha önce karşılaşmadığı kütüphane API'leri, nadir görülen hata kodları veya etki alanına (domain) özgü bilgiler söz konusu olduğunda; Wonder'ın araştırmak ya da tahmin yürütmek zorunda kaldığı yerlerde Opus doğrudan hafızasından yanıt verir.
- İnceleyici (reviewer) rolü. Başka bir Agent'ın kod farkını (diff) okuyup doğru olup olmadığına karar veren Agent, elinizdeki en yüksek zekâ seviyesine sahip model olmalıdır. Bileşik endekste bu model Opus'tur ve karma modelli Crew mimarisi de maliyetli modeli zaten bu pozisyona yerleştirir.
- Kısa ve net Görevler. DeepSWE'de iki model birbirine son derece yakınken, genel zekâda Opus öndedir. Eğer bir süreç yalnızca on dakika sürecekse, azim avantajı hiçbir zaman kendini gösteremez.
Her bir modelin inceleme kuyruğuna etkisi
Yönlendirme kararları, incelemeyi yapacak kişilerin önüne neyin geleceğini değiştirir ve asıl maliyet de tam olarak burada gizlidir.
Uzun bir Görevde çalışan Wonder daha uzun bir rota çizer: daha fazla deneme, vazgeçilen daha fazla yaklaşım ve daha çok commit. Bu durum modelin işini yaptığını gösterir; ancak diff'in tüm hikâyeyi anlatmadığı anlamına da gelir. İnceleyicinin çalışma günlüğüne (run log) ihtiyacı vardır; bu nedenle Agent talimatlarında, denediği yöntemlerin kaydını adım adım tutması istenmelidir. İnsan incelemesi darboğazdır gerçeği burada daha da belirginleşir: Azimli bir model, Görev başına incelenecek materyal miktarını azaltmaz, aksine artırır.
Wonder'ın bilgi açığı, kendinden emin bir dille ifade edilen yanlış ayrıntılar olarak karşımıza çıkar: Var olmayan bir bayrak (flag) veya iki sürüm önce adı değiştirilmiş bir metot gibi. Halüsinasyon oranı kendi kategorisi için düşük sayılsa da (Artificial Analysis ölçümüne göre %27), %27 sıfır değildir. Agent'a, emin olmadığı her şeyi repoda teyit etmesini ve teyit edemediği durumları açıkça belirtmesini söyleyin; inceleyicinin de özellikle bu satırları tek tek doğrulamasını sağlayın.
Aynı Görevde çalışan bir Opus ise genellikle daha kısa, daha kararlı bir yol haritası çizer ve görev başına daha yüksek bir maliyet çıkarır. Çalışma başına düşen inceleme yükü daha hafiftir. Ancak Görev uzun ve engellerle dolu olduğunda, Opus'un işi erken bırakma ihtimali daha yüksektir; bu da kuyruğa farklı bir iş yükü bırakır: Yarıda kalmış ve kapsamının yeniden belirlenmesi gereken bir Görev.
Üç Görevin yönlendirilmesi
Somut örnekler, bu kuralı görev atama esnasında uygulamayı kolaylaştırır.
“Servisler genelinde ORM'yi v5'ten v7'ye yükseltin; tüm entegrasyon testleri geçmeli.” Wonder. Düzinelerce adım, her aşamada farklı biçimlerde başarısızlığa uğrayacak bir test paketi ve net bir bitiş çizgisi. Modelin azmi burada en büyük değerdir ve çalışan süreç kabul kriterini kendi kendine doğrulayabilir.
“Yeni staging ortamı için Terraform kodunu yazın ve uygulayın (apply).” Opus. Yoğun terminal kullanımı, altyapıya özgü derin bilgi ve kritik sonuçları olan bir işlem. Terminal-Bench sonuçları Opus'u işaret eder; olası etki alanı (blast radius) ise model hangisi olursa olsun Agent'ın apply adımından önce durup onay alması gerektiğini söyler.
“Ödeme webhook'unun neden iki kez tetiklendiğini açıklayın ve bir çözüm önerin.” Açıklama için Opus; çünkü bu durum sağlayıcının yeniden deneme semantiğinin (retry semantics) nasıl çalıştığını bilmeye, yani bilgi hatırlamaya dayanır. Eğer önerilen çözüm testler içeren çok dosyalı bir değişikliğe dönüşürse, bu takip Görevi Wonder'a yönlendirilebilir.
Temel formül şudur: Bitiş çizgisiyle tanımlanan Görevler için Wonder, bilinmesi gerekenlerle tanımlanan Görevler için Opus. Bir Görev her ikisini de kapsıyorsa, onu parçalara bölün. Sharkly, kulvar başına Agent başına bir Görev düşecek ve iş devri birilerinin aklında değil panoda kayıt altına alınacak şekilde tam olarak bu ayrım için geliştirilmiştir.
İkisini birlikte çalıştırmak ve sonuçları değerlendirmek
Bu kuralı bir hafta boyunca panonuzda uygulayın ve kararı Görevlerin gidişatına bırakın.
- Muse Wonder Agent'ını oluşturun ve Opus 5.5 Agent'ını koruyun. Sharkly model kimliğini göstermediğinden, her iki Agent'ın talimatlarında da raporun en üstünde model kimliğini yazmasını talep edin.
- Kişisel tercihlere göre değil, yukarıdaki kurala göre görev dağıtımı yapın. Uzun ve engellerle dolu işleri Wonder'a; terminal ve bilgi gerektirenleri Opus'a; incelemeleri ise yine Opus'a yönlendirin.
- Bir haftanın ardından, her Agent'ın tamamladığı Görevleri çekin ve şu üç metriği değerlendirin: Kaç görev sonuç yerine soruyla geri döndü, kaçı ikinci bir çalıştırmaya ihtiyaç duydu ve her biri kaç inceleme yorumu aldı?
Eğer Wonder'ın uzun Görevleri daha az yeniden çalıştırma ile tamamlanıyor ve Opus'un terminal Görevleri daha az düzeltmeyle kapanıyorsa, kural doğru işliyor demektir. Eğer Wonder'ın Görevleri, yeniden çalıştırmalardan kazandırdığı zamandan daha fazla inceleme yorumuna yol açıyorsa, ona gönderdiğiniz görev kapsamını daraltın. Tablodaki veriler test kıyaslamalarının genel ortalamalarıdır; esas önemli olan test ise kendi Görevlerinizdir.
Bunların hiçbiri Sharkly faturanıza eklenmez. Model kullanımı, Computer üzerinde yapılandırılan Meta ve Anthropic anahtarları üzerinden gerçekleşir ve liste fiyatları birebir aynı olduğundan, tek maliyet farkı her çalıştırma için usage bloğunun bildirdiği tutardır.
Bu ay modeller güncellendi. Ancak bağlam, ilerleme, engeller, sonuçlar ve insan incelemesi talepten canlıya alma aşamasına kadar görünür kalmayı sürdürdü. Bu yapıyı worktree'ler yardımıyla manuel olarak kurabilir ya da iş akışını yönetmek için Sharkly'yi tercih edebilirsiniz.


