
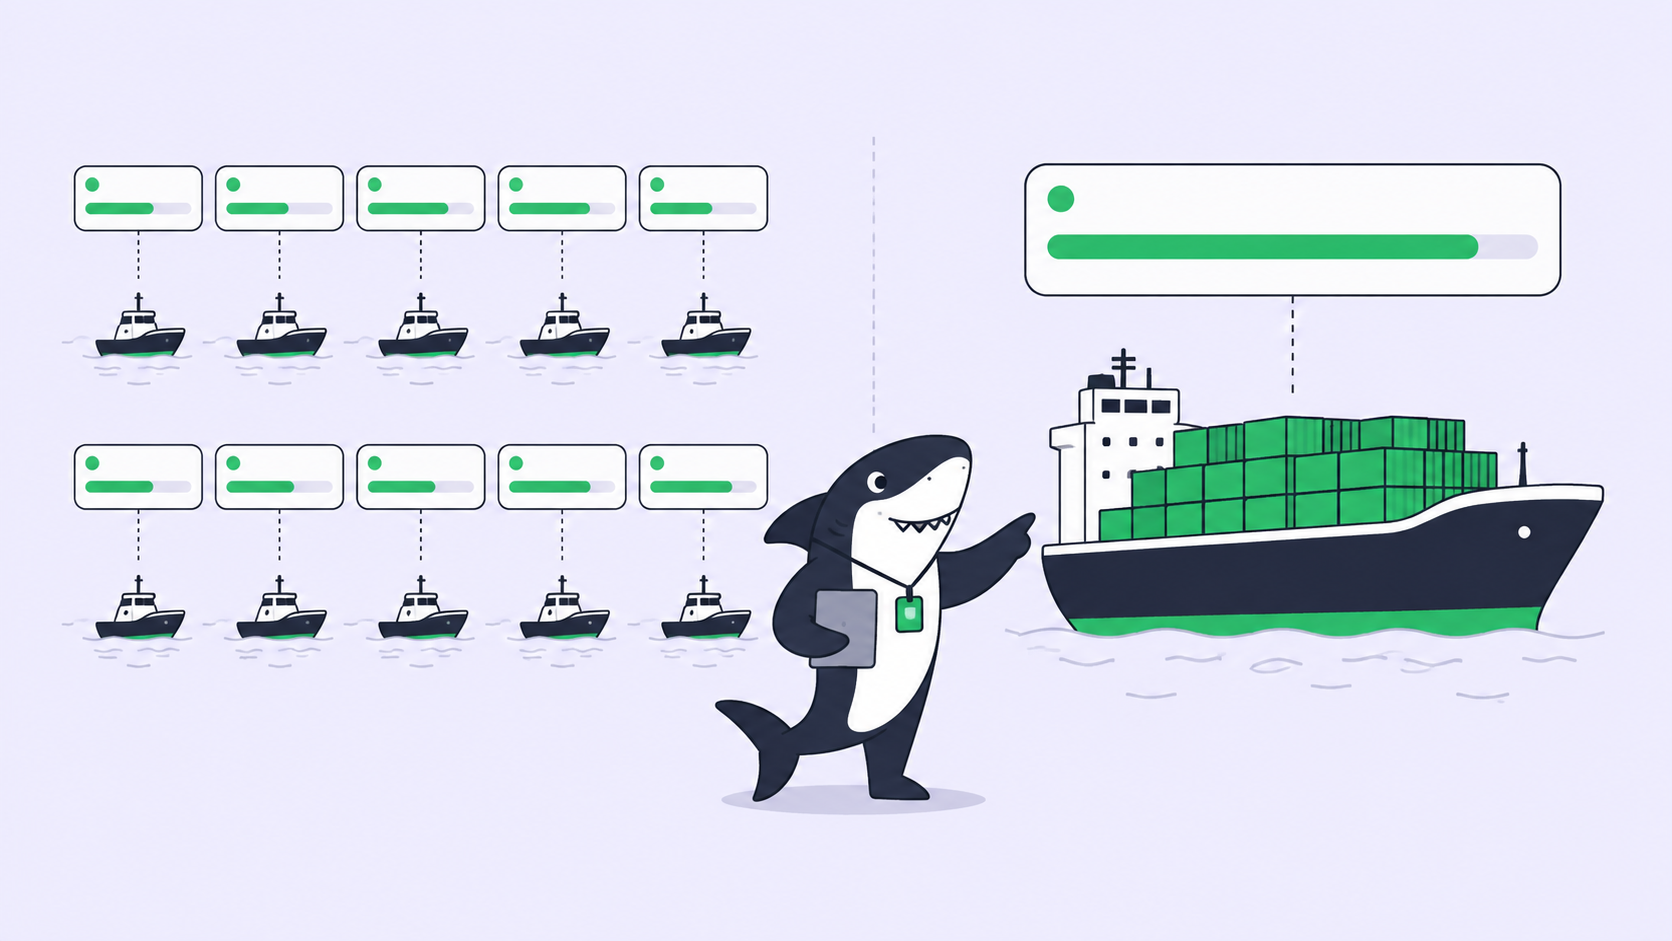
Sabit sayıda inceleyiciniz var ve 2026-09-22'den bu yana, artık sizin adınıza hiçbir şeye karar vermeyen bir model faturası var. GPT-6 Luna, milyon giriş token'ı başına $0,10 ve milyon çıkış token'ı başına $0,50 liste fiyatıyla sunuluyor; API kimliği gpt-6-luna. Claude Opus 5.5 ise $4 ve $20 liste fiyatıyla geliyor; API kimliği claude-opus-5-5. Bu, ölçeğin her iki ucunda da 40 katlık bir fark demek; hesap, iki satıcının kendi liste fiyatlarından çıkardığımız bir sonuç ve bir zamanlar teorik kalan bir soruyu haftalık bir planlama kararına dönüştürüyor. Aynı parayla on tane ucuz Agent mı çalıştırırsınız, yoksa tek bir pahalı Agent mı?
Bu iki yapılandırma birbirinin ikamesi değil. Aralarındaki farkı belirleyen şey model kalitesi değil ve bu fark koşunun başında değil, sonunda ortaya çıkıyor: her biri bir insanın önüne farklı miktarda iş yığıyor.
Soruyu gündeme getiren hesap
OpenAI, puana ek olarak görev başına maliyeti de yayımlıyor; bu, bir fiyat listesinden çok daha işe yarar. DeepSWE 1.1'de Luna, en yüksek akıl yürütme eforunda %66,6 puan alıyor. OpenAI bunu, orta efordaki Claude Opus 5 ve Fable 5 ile karşılaştırılabilir olarak tanımlıyor; görev başına maliyet ise Opus 5'ten %93, Fable 5'ten %96 daha düşük.
İlk rakamı tersine çevirip hesaplarsanız, bir Opus 5 görevi yaklaşık on dört Luna görevine denk geliyor. Yani o harness üzerinde on Luna koşusu, tek bir Opus 5 koşusunun kabaca onda yedisi kadar tutuyor. Bu çarpma bize ait; OpenAI'ın açıkladığı %93'ten yola çıktık.
Anthropic, Opus 5.5'i çalıştırmanın Opus 5'ten %40 daha ucuza geldiğini söylüyor. Bunu hesaba katarsanız oran dokuzda bire kadar iniyor. Bu rakam, farklı harness'lerde alınmış iki ayrı satıcı ölçümünü birbirine zincirliyor; dolayısıyla bunu bir sayı olarak değil, bir yön olarak değerlendirin: on ucuz deneme ile bir pahalı deneme artık neredeyse aynı paraya geliyor, nasıl hesaplarsanız hesaplayın.
| GPT-6 Luna | Claude Opus 5.5 | |
|---|---|---|
| API kimliği | gpt-6-luna |
claude-opus-5-5 |
| 1M başına giriş / çıkış | $0,10 / $0,50 | $4 / $20 |
| Önbelleğe alınmış giriş | okumalarda %90 indirim | okuma $0,20, yazma $5 |
| Bağlam penceresi | 1M | 1M |
| Satıcının uzun ufuk iddiası | belirtilmemiş | 18+ saat görevde kalıyor |
| Artificial Analysis Endeksi | 37 | 212 arasında 1. sırada, 58 |
Bu tabloyla birlikte iki uyarıyı da akılda tutmak gerekiyor. OpenAI'ın manşeti, Sol ve Luna'nın her birinin GPT-5.6 promosyon fiyatlandırmasından %50 daha ucuz olduğu yönünde ve “promosyon” kelimesi bizzat OpenAI'a ait: karşılaştırma liste fiyatına değil, indirimli bir tarifeye karşı yapılıyor. Ayrıca iki lansman yazısı kafa kafaya bir karşılaştırma değil. İki satıcı da aynı gün bir AutomationBench puanı bildiriyor, ama farklı harness sürümlerinde ve farklı efor seviyelerinde. Bu iki yüzdeyi tek satırda birleştirmek, hiçbir laboratuvarın yapmadığı bir karşılaştırma ortaya çıkarır. Yukarıdaki görev başına maliyet oranları geçerliliğini koruyor, çünkü tek bir satıcının kendi ölçümünün içinden geliyorlar.
Tek bir tercih gibi görünen üç yapılandırma
“On agent mı, bir agent mı” aslında üç ayrı düzenek ve bunlar inceleme adımında farklı davranıyor.
| Yapılandırma | İncelemeye ne geliyor | Kazananı kim seçiyor | Ne zaman işe yarar |
|---|---|---|---|
| On ucuz Agent, on Task | On diff, on karar | Bir insan, on kez | İş yığını genişse ve her madde tek başına kabul edilebilirse |
| On ucuz Agent, tek Task | Tek diff, tek karar | Test paketiniz | Bir makine, denemeleri insan okumadan sıralayabiliyorsa |
| Tek pahalı Agent, tek Task | Tek diff, tek karar | Bir insan, bir kez | Ufuk uzunsa, otomatik sinyal zayıfsa ya da değişiklik baştan sona muhakeme gerektiriyorsa |
Asıl fiyat indiriminin mümkün kıldığı satır ortadaki ve çoğu ekibin atladığı da o. Aynı Task'ı on kez çalıştırıp typecheck, testler ve build'den geçen denemeyi tutmak, ancak bir denemenin maliyeti gerçek para tutmaktan çıkınca karşılanabilir hale gelen bir strateji. Üçte ikiye yakın bir benchmark başarı oranında, tek denemelerin üçte biri başarısız oluyor. Denemeler birbirinden bağımsız başarısız olsaydı, on denemenin hepsinin birden başarısız olması neredeyse hiç görülmezdi. Ama bağımsız başarısız olmuyorlar: belirsiz bir gereksinimi olan ya da fixture'ı eksik bir görev, her denemeyi aynı şekilde bozuyor. Fan-out size varyansı kazandırır, garanti değil.
İlk satır ise çoğu ekibin gerçekte uzandığı satır ve pahalı olan da o. Dolar bazında değil. On Task üzerinde çalışan on Agent, on diff üretiyor ve her birinin bir insan tarafından okunması, Agent'ın neyi seçtiğinin anlaşılması ve merge sorumluluğunun üstlenilmesi gerekiyor. Bu maliyet 2026-09-22'de düşmedi ve hiçbir model sürümü ona dokunmuyor. paralel agent çalışmasında insan incelemesinin neden darboğaz olduğunu ve bir insan iş gününün kaç agent iş gününü kaldırabildiğini yazmıştık; oradaki hesap, daha ucuz token'larla değişmiyor.
Luna üzerinde on Agent, on kat çıktı demek değil. On kat gelen iş demek. Daha ucuz bir model deneme satın alır. İnceleme kapasitesi satın almaz; fatura izlenen tek sayı olduğunda bu ikisini birbirine karıştırmak çok kolaydır.
Aktarılabilen rakam: kabul edilen değişiklik başına maliyet
Kabul edilen değişiklik başına maliyet, bir insanın gerçekten okuyup kabul ettiği her diff için ekibinizin çıkarıma harcadığı tutardır. Yayına alınan işle bağlantılı tek agent maliyet rakamı budur, çünkü kimsenin incelemediği bir deneme hiçbir şeyi yayına almış sayılmaz.
Bu tanım, üç yapılandırmayı anında birbirinden ayırıyor. Tek bir Task üzerinde fan-out, on denemeyi tek bir inceleme kararına böler; böylece daha ucuz denemeler, kabul edilen değişiklik başına maliyeti dümdüz bir çizgi halinde düşürür. On Task'a yayılan genişlikte ise bir denemeye bir inceleme kararı düşer ve bu on kez tekrarlanır; dolayısıyla daha ucuz denemeler çıkarım kalemini düşürürken inceleme kalemi sabit kalır ve kısıt haline gelir. Tek bir pahalı Agent üzerinde derinlik ise inceleyicinizin önündeki tek denemenin merge edilmeye değer olma ihtimalini yükseltir.
Pratikte ancak kendini gösteren ikinci bir etki daha var. On ucuz denemeyle çalışmak ile bir pahalı denemeyle çalışmak aynı hissi vermiyor. Artificial Analysis, bu modellerin en yüksek akıl yürütme varyantlarını Luna için ilk token'a 124,23 saniye, Sol için 102,15 saniye olarak ölçüyor; bunlar özellikle maksimum varyantlara ait üçüncü taraf rakamlar ve planınızı bunlara göre yapmadan önce doğrulamaya değer. Tek bir karakter üretmeden önce iki dakika sessiz kalan on Agent, hızlı bir iş akışı değil. Hepsi aynı anda takılmış gibi görünen on koşu demek; bu da model sorunu değil, bir status sorunu.
Karar ikilisi
Kararı bir makine veriyorsa on ucuz Agent kullanın. Yani Task'ın, insan müdahalesi olmadan çalışan gerçek bir kabul sinyali olmalı: bugün başarısız olan ve geçmesi gereken bir test, bir typecheck, bir build, bir lint kuralı, bir yeniden üretim betiği. Triage, etiketleme, test iskeleti kurma ve mekanik refactor'lar bu kapsama giriyor. “İşe yaradı mı” sorusunun cevabının bir görüş değil bir komut olduğu her değişiklik de öyle.
Kararı bir insan veriyorsa tek bir pahalı Agent kullanın. Değişikliği kabul etmek için kodu okuyup bir görüş oluşturmak gerekiyorsa, fazladan denemeler işe yaramaz; sadece okunacak işi katlar. Aynısı uzun ufuklu işler için de geçerli: Anthropic, Opus 5.5'in görevde 18 saat veya daha fazla kaldığını belirtiyor ve bir öğleden sonra boyunca bir hedefi koruyan bir koşu, aynı yarım anlayıştan yeniden başlayan on koşudan daha değerlidir.
Kabul sinyalini yazmaktan kaçınmak için fan-out'a başvurmayın. Otomatik bir hakem olmadan on akla yatkın diff, tek bir diff'ten daha kötüdür; çünkü on akla yatkın diff arasından seçim yapmak, birini incelemekten daha zor bir iştir ve bu iş, korumaya çalıştığınız kişinin sırtına biner.
Geniş yapılandırmanın bir üst katmandan bekledikleri
Aynı anda çalışan on Agent, maliyet sorunundan önce bir koordinasyon sorunudur. Gereken parçalar belli: her koşu kendi worktree'sinde çalışmalı ki iki Agent'ın aynı dosyayı düzenlemesi bir olaya dönüşmesin; her Task için tek Assignee olmalı ki sahiplik asla belirsizleşmesin; ve çalışıyor, bekliyor ile başarısız durumlarını birbirinden ayıran bir status bulunmalı.
Agent, işin nasıl ele alınacağını tanımlar. Computer, host'u ve yerel kaynakları sağlar. Runtime, oturumu yürütür. Task ise ortak kayıt olarak kalır. On koşu birbirine bir saat içinde tamamlandığında, o son madde, o bir saatin on terminal arasında bir hazine avına dönüşmesini engelleyen şeydir.
Tamamlanmış bir Luna koşusu, sonucu özel bir oturum kaydına değil, kendi Task'ına şunun gibi bir şey olarak döndürmeli:
SH-312  Add retry with backoff to the webhook dispatcher
Runtime   gpt-6-luna (fan-out, 8 attempts, 3 passed the suite)
Selected  attempt 6, smallest diff of the passing set
Evidence  typecheck ok, 214 tests pass, build ok, coverage +0.4%
Known limit  no test for the 429 path, dispatcher is not idempotent yet
Status    Ready for review, waiting on a human
Asıl önemli olan kısım, seçim satırı. Neyin karar verdiğini söylüyor, böylece inceleyici bir makinenin seçimini mi onayladığını yoksa kendi kararını mı verdiğini biliyor. Seçim kaydı olmayan on deneme, tek bir Task gibi görünen on kat iştir.
Cevap
Kararı bir test paketi veriyorsa ve iş yığını onları meşgul edecek kadar genişse, on ucuz Agent daha fazla iş yayına alır. Kabul kararı insana aitse, ufuk uzunsa ya da otomatik sinyal zayıfsa, tek bir pahalı Agent daha fazla iş yayına alır. Çoğu ekip ikisini de ister; tercihe göre değil, Task tipine göre yönlendirilmiş şekilde. Modelleri agent rollerine eşleme yazısındaki argüman da bu.
Hiçbir yapılandırma son adımı değiştirmiyor. Agent'lar araştırır, yürütür, test eder ve raporlar. Yönü insanlar belirler, yetkiyi insanlar verir ve sonucu insanlar kabul eder. Model fiyatları bir günde 40 kat hareket etti; ekibinizin sorumlulukla kabul edebileceği değişiklik sayısı ise hiç kıpırdamadı.
Hâlihazırda birkaç agent çalıştırıyorsanız Sharkly, diff'i hangi runtime üretmiş olursa olsun; bağlamı, ilerlemeyi, engelleri, sonuçları ve insan incelemesini talepten yayına kadar görünür tutabileceğiniz tek bir yer sunar.


