
Tóm tắt nhanh: Giá của Claude Fable 5.2 là $8 cho mỗi triệu token đầu vào (input) và $40 cho mỗi triệu token đầu ra (output) trên standard API của Anthropic. Chế độ Fast mode có giá lần lượt là $16 và $80. Cần lập ngân sách cho toàn bộ quy trình: ngữ cảnh lặp lại, thời gian suy luận (thinking), số lần thử lại, điều phối agent, công cụ (tools) và khâu đánh giá của con người. Biểu giá được cập nhật vào ngày 10 tháng 11 năm 2026.
Giá token cho bạn biết chi phí của một lượt gọi model. Nhưng ngân sách kỹ thuật của bạn lại cần chi phí cho một kết quả được nghiệm thu. Một quá trình migration cần tới ba lần thử, sự đánh giá từ một agent khác và một lần chỉnh sửa từ con người sẽ có nhiều khoản chi phí cộng dồn vào cùng một hạng mục bàn giao.
Nếu bạn đang chạy nhiều coding agent, Sharkly cung cấp một không gian dùng chung cho các Task và kết quả của chúng. Hãy bắt đầu phân tích chi phí từ đó: xác định rõ thế nào được coi là hoàn thành trước khi so sánh các model.
Claude Fable 5.2 có giá bao nhiêu?
Anthropic tính phí riêng cho input token và output token, với các mức giá khác nhau cho caching, batch processing và fast mode. Một MTok tương đương một triệu token. Các mức giá (USD) dưới đây được lấy từ tài liệu giá chính thức, cập nhật ngày 10 tháng 11 năm 2026. Bảng này áp dụng cho mức sử dụng API, không phải gói thuê bao lập trình cố định hàng tháng.
| Danh mục tính phí | Input / MTok | Output / MTok |
|---|---|---|
| Standard API | $8 | $40 |
| Fast mode | $16 | $80 |
| Batch API | $4 | $20 |
| Ghi cache tiêu chuẩn 5 phút | $10 | Không áp dụng |
| Ghi cache tiêu chuẩn 1 giờ | $16 | Không áp dụng |
| Cache hit tiêu chuẩn | $0.20 | Không áp dụng |
Ghi cache và cache hit thuộc danh mục input, chứ không áp dụng giảm giá cho output. Giá cache ở fast mode áp dụng hệ số nhân caching cho mức giá input của fast mode. Xử lý hàng loạt (Batch processing) được giảm giá 50% cho cả input và output, nhưng không thể kết hợp fast mode với Batch.
Fable hỗ trợ toàn bộ context window 1 triệu token theo đơn giá tiêu chuẩn cho mỗi token. Tuy vậy, context lớn vẫn rất tốn kém: input không được cache sẽ tích lũy qua từng lượt gọi. Các nền tảng đám mây do đối tác vận hành có thể áp dụng mức giá khác; hãy xác nhận endpoint xuất hóa đơn cho nhóm của bạn.
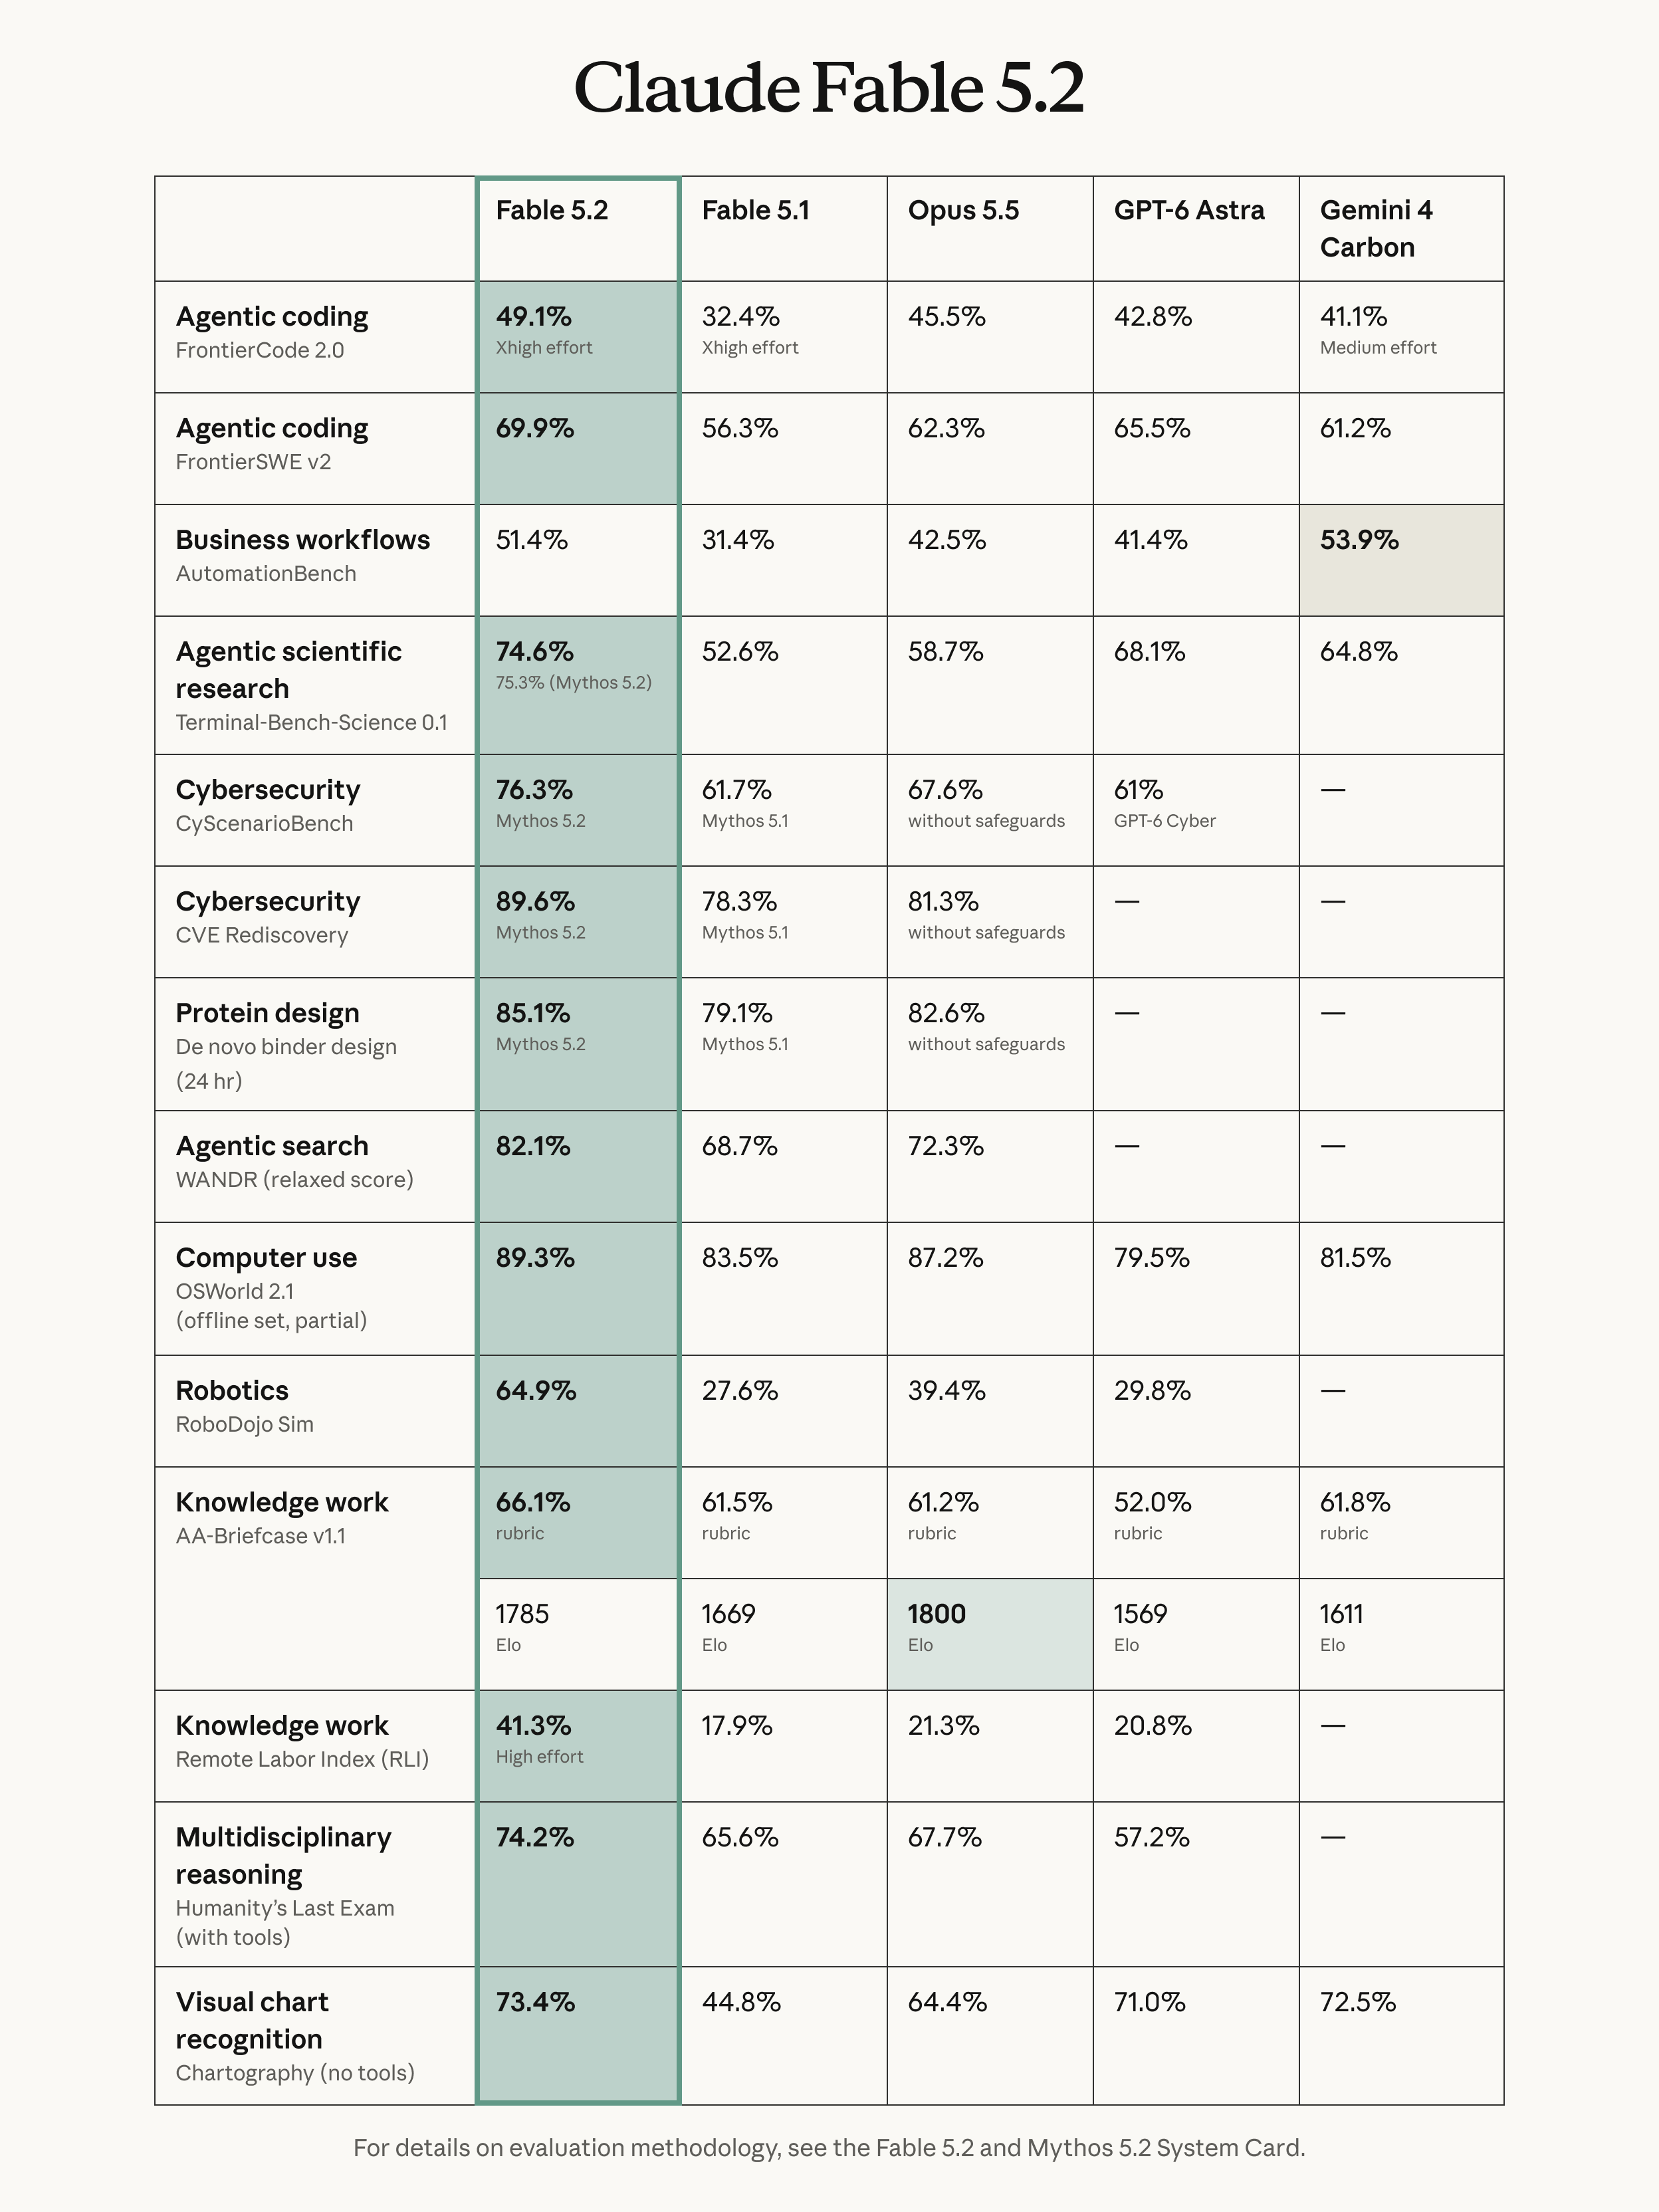
Cách tính ngân sách cho toàn bộ quy trình
Đối với một lượt gọi tiêu chuẩn không dùng cache, hãy nhân số lượng input token với $8 mỗi triệu token và output token với $40 mỗi triệu token, sau đó cộng kết quả lại. Lặp lại bước này cho mọi lượt gọi trong từng lần thử. Cộng thêm chi phí công cụ và hạ tầng riêng biệt, cùng với thời gian con người đánh giá, để ước tính tổng chi phí bàn giao.
# Hypothetical standard-API example, not a measured benchmark.
input_tokens = 100_000
output_tokens = 20_000
api_cost = input_tokens / 1_000_000 * 8
api_cost += output_tokens / 1_000_000 * 40
print(f"${api_cost:.2f}")  # $1.60
Ở đây, output là tổng số output tính phí, bao gồm cả quá trình suy luận (thinking) nếu có. Đừng lấy độ dài câu trả lời hiển thị để thay thế cho mức sử dụng thực tế do nhà cung cấp báo cáo.
Giả sử bạn chạy 20 tác vụ với tổng lượng token như trên. Trong đó 5 tác vụ cần thử lại một lần y hệt. Giả định rằng agent điều phối phát sinh thêm tổng cộng $2, và một người kiểm duyệt mất 15 phút với chi phí nội bộ là $80 mỗi giờ.
| Thành phần giả định | Cách tính | Chi phí |
|---|---|---|
| Các lần thử ban đầu | 20 × $1.60 | $32 |
| Các lần thử lại bổ sung | 5 × $1.60 | $8 |
| Điều phối viên (Coordinator) | Chi phí model tổng hợp giả định | $2 |
| Đánh giá của con người | 0.25 giờ × $80 | $20 |
| Tổng cộng | Chưa tính công cụ, hạ tầng và thuế | $62 |
Nếu toàn bộ 20 tác vụ đều được nghiệm thu, ví dụ đó tốn $3.10 cho mỗi tác vụ được chấp thuận. Nếu chỉ có 16 tác vụ được duyệt, cùng số tiền $62 đó sẽ tiêu tốn khoảng $3.88 cho mỗi tác vụ được nghiệm thu. Mẫu số thay đổi sẽ làm thay đổi quyết định.
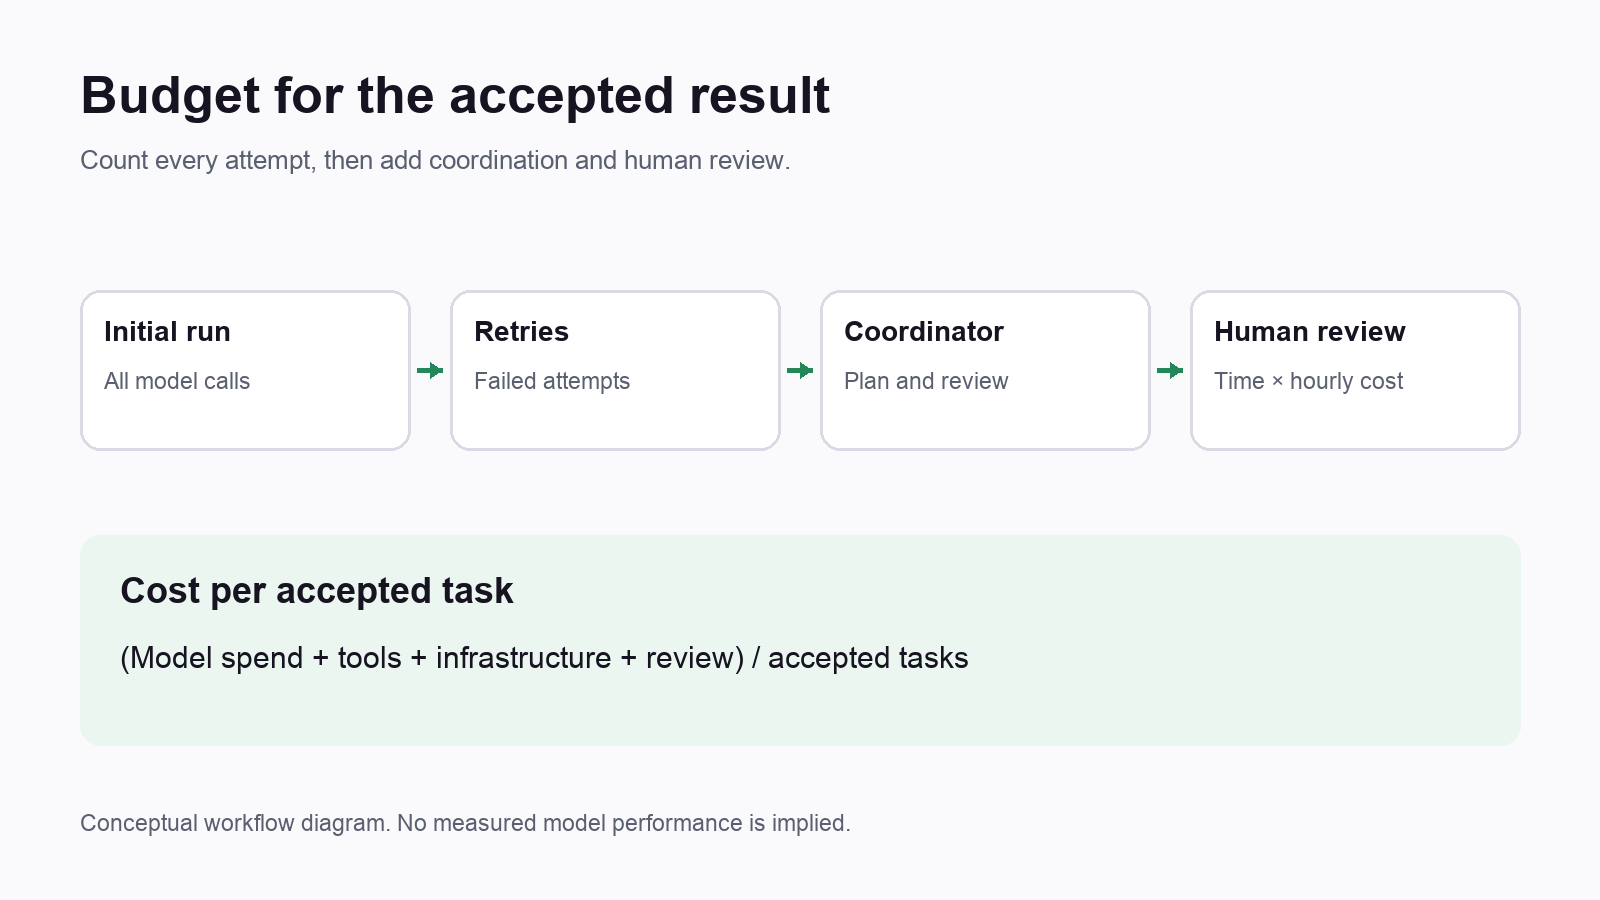
Đây chỉ là các giả định lập kế hoạch, không phải hiệu năng thực tế được đo lường của Fable. Hãy thay thế chúng bằng tổng số token, số lần thử lại, kết quả nghiệm thu và thời gian đánh giá thực tế của bạn. Bài hướng dẫn của chúng tôi về cách tính chi phí chạy agent trên mỗi thay đổi được chấp thuận giải thích rõ lý do tại sao sự so sánh này lại quan trọng.
Fast mode và thiết lập effort ảnh hưởng đến các chi phí khác nhau
Fast mode tăng giá token để giảm thời gian tạo phản hồi (generation time). Trong khi đó, thiết lập effort thay đổi khối lượng công việc model thực hiện, bao gồm cả quá trình suy luận (thinking) và gọi công cụ. Hãy xem chúng là hai cơ chế kiểm soát riêng biệt: tốc độ sinh token nhanh hơn không đảm bảo toàn bộ quy trình từ đầu đến cuối sẽ ngắn hơn, và mức effort thấp hơn cũng không tạo ra một hạn mức chi tiêu cố định.
Thông báo ra mắt của Anthropic khẳng định fast mode tạo token nhanh hơn tới 2,5 lần. Đó là tuyên bố của nhà cung cấp về tốc độ tạo token, chứ không phải lời đảm bảo rằng các quá trình build, kiểm thử, gọi mạng hay khâu kiểm duyệt của con người cũng sẽ hoàn thành nhanh hơn 2,5 lần.
Với cùng số lượng token, ví dụ $1.60 ở trên sẽ thành $3.20 trong fast mode. Hãy dùng fast mode khi giá trị của việc giảm thời gian chờ đợi lớn hơn mức phí chênh lệch. Dùng standard mode cho các tác vụ chạy ngầm tự động (unattended) khi độ trễ tạo phản hồi không ảnh hưởng đến tiến độ bàn giao.
Tài liệu về effort liệt kê các mức Low, Medium, High, Xhigh và Max cho Fable 5.2. Giá trị mặc định của API là High. Thông báo ra mắt nêu rõ Medium là mức mặc định trong các ứng dụng Claude và Claude Code. Hãy ghi lại sản phẩm và thiết lập cụ thể khi thực hiện so sánh.
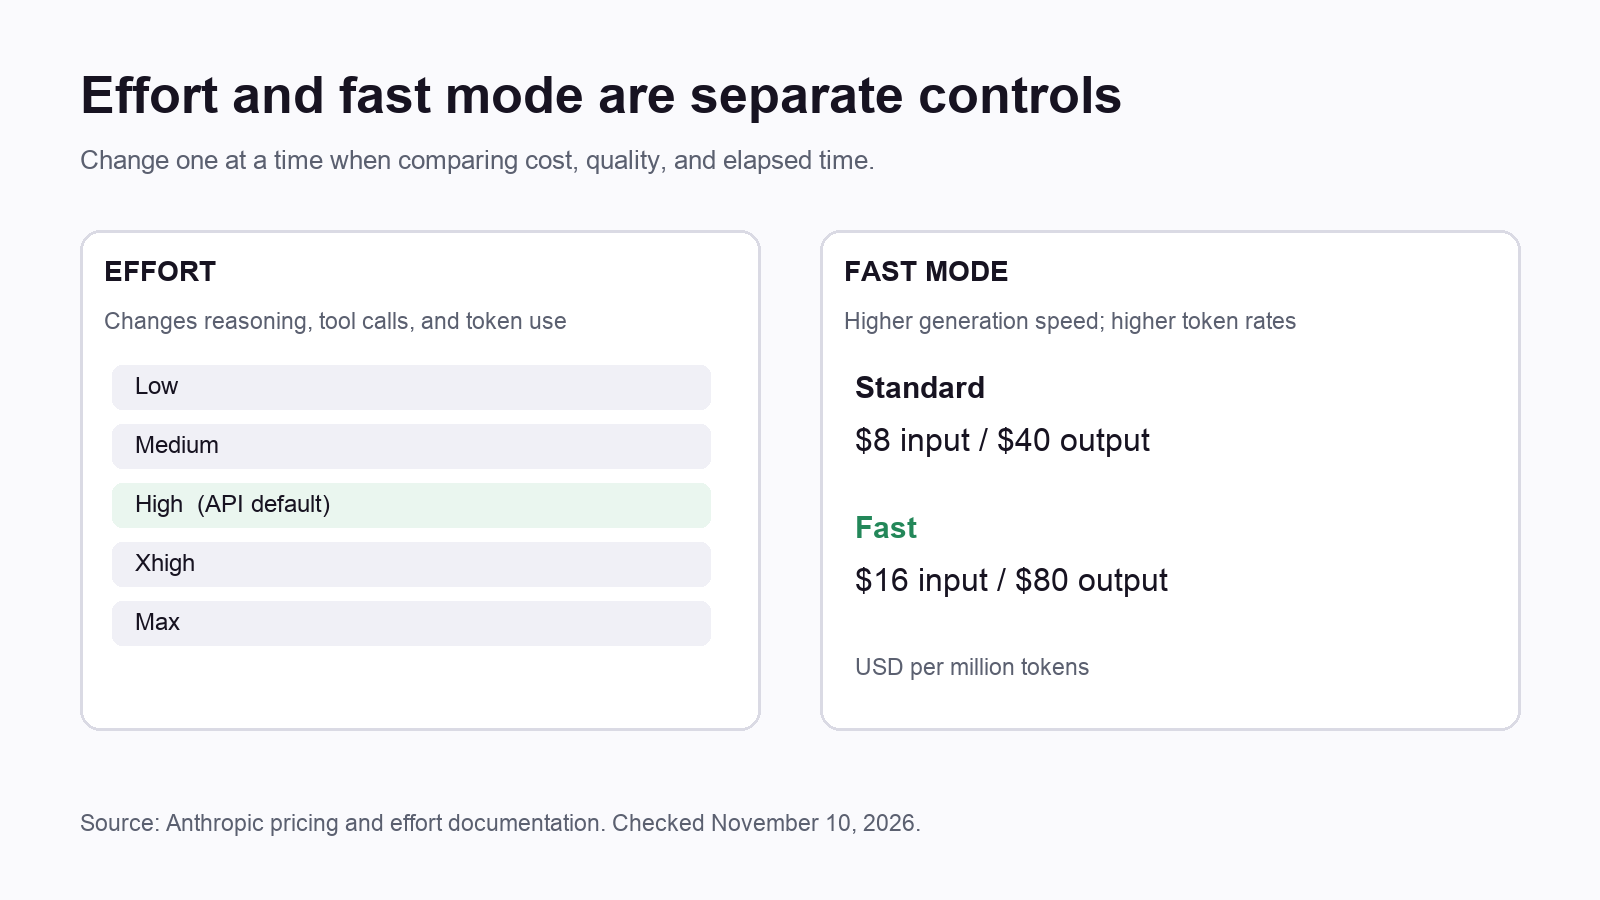
Anthropic khuyến nghị nên bắt đầu các workload trên API ở mức High, giảm effort nếu các đánh giá cho thấy chất lượng vẫn được duy trì, và chuyển sang Xhigh khi các tác vụ khó cho thấy sự cải thiện rõ rệt qua đo lường. Max ưu tiên tối đa năng lực mà không bận tâm đến chi phí token. Effort chỉ là một tín hiệu định hướng hành vi; bạn cần thực thi các hạn mức chi tiêu thực tế ngay trong ứng dụng và quy trình vận hành của mình.
Kiểm soát ngữ cảnh lặp lại, số lần thử lại và quy trình điều phối
Hãy áp dụng sáu biện pháp kiểm soát sau trước khi tăng số lượng agent:
- Đo lường mọi lần thử. Tính cả các lần thử thất bại và bị hủy vào tổng chi phí của tác vụ đó.
- Cache ngữ cảnh cố định. Tái sử dụng hướng dẫn repository và các tài liệu không thay đổi khi khối lượng công việc đủ điều kiện dùng prompt caching.
- Giới hạn số lần thử lại. Thiết lập ngưỡng thử lại tối đa và yêu cầu chẩn đoán nguyên nhân trước khi tiến hành một lần thử tốn kém khác.
- Điều hướng theo độ khó. Chỉ chuyển tiếp các bước suy luận chưa giải quyết được thay vì giao mọi bước trích xuất hay định dạng cho Fable.
- Lập ngân sách cho khâu điều phối. Tính toán các lượt gọi lập kế hoạch, điều phối, tóm tắt và đánh giá song song với các lượt gọi của worker.
- Giới hạn lượng việc chuyển sang kiểm duyệt. Điều chỉnh khối lượng công việc hoàn thành tương ứng với số lượng thay đổi mà người kiểm duyệt của bạn có thể đánh giá được.
Định nghĩa công cụ và kết quả trả về từ công cụ đều làm tăng input của model. Một số công cụ phía server có tính phí riêng, như tài liệu giá của Anthropic đã giải thích. Một lệnh trả về file log khổng lồ có thể làm tăng chi phí ngữ cảnh cho các lượt gọi sau, ngay cả khi bản thân lệnh đó tốn rất ít chi phí thực thi.
Việc caching cũng cần được đo lường cụ thể. Với một đoạn prefix giả định gồm 100.000 token, phí ghi cache tiêu chuẩn trong 5 phút là $1. Một lượt cache hit sau đó tốn $0.02, so với $0.80 nếu không dùng cache cho input. Các con số này chưa tính input mới và output. Hãy kiểm tra mức sử dụng cache hit thực tế trước khi mặc định rằng sẽ tiết kiệm được chi phí.
Để có một chính sách định tuyến nhất quán, hãy tham khảo tổng quan về model. Anthropic khuyến nghị dùng Opus 5.5 cho hầu hết các workload và Fable cho những bài toán suy luận phức tạp hoặc công việc cần tầm nhìn dài hạn (long-horizon). Đó là chính sách khởi đầu để bạn đánh giá, chứ không phải bằng chứng cho thấy bất kỳ model nào cũng sẽ vượt trội trên repository của bạn.
Bạn nên đo lường những gì trong đợt thử nghiệm (pilot)?
Hãy giữ nguyên phạm vi tác vụ và các bài kiểm thử nghiệm thu giữa các cấu hình khác nhau. Trong ghi chú thời gian, cần tách biệt thời gian chờ hàng đợi, thời gian model tạo phản hồi, thời gian chạy công cụ và thời gian con người đánh giá. Nếu không, một bộ kiểm thử chậm chạp có thể che mất lợi ích của tốc độ sinh văn bản nhanh hơn, hoặc một tập hợp tác vụ dễ dàng có thể khiến một thiết lập tốn kém trông có vẻ tiết kiệm.
Ghi nhận riêng input được cache và input không được cache. Lưu lại tổng mức sử dụng thực tế từ nhà cung cấp cho mỗi lần thử thay vì ước tính token dựa trên kích thước tệp. Khi thay đổi thiết lập effort, hãy so sánh cả kết quả được nghiệm thu và khối lượng công việc phải làm lại chứ không chỉ nhìn vào phản hồi đầu tiên. Một lượt chạy ban đầu ngắn hơn có thể để lại hóa đơn sửa lỗi lớn hơn về sau.
Hãy đặt điều kiện dừng trước khi bắt đầu thử nghiệm: số lần thử tối đa, ngưỡng chi tiêu hoặc mốc kiểm tra đánh giá. Một model liên tục tự điều tra, thử nghiệm có thể làm cạn kiệt ngân sách của bạn trong khi những kết quả nó đạt được vẫn chưa thể nghiệm thu.
Gắn liền ngân sách với từng đầu việc cụ thể
Mô tả sản phẩm chính thức của Sharkly đưa các Task, coding agent, Máy tính (Computer) kết nối và các lượt đánh giá của con người vào chung một không gian làm việc. Bạn vẫn giữ tài khoản API hoặc gói thuê bao lập trình được cấu hình trong các công cụ của mình. Mức sử dụng model sẽ được ghi nhận trực tiếp trên các tài khoản nhà cung cấp đó.
Hãy sử dụng bản ghi công việc chung đó để báo cáo model, mức effort, số lần thử, bằng chứng và kết quả đánh giá. Đối với việc migration, hãy yêu cầu Agent trả về kết quả kiểm thử và các giới hạn đã biết cùng với những thay đổi mã nguồn. Sau đó, con người sẽ chấp thuận công việc hoặc yêu cầu chỉnh sửa. Đọc thêm bài viết cách đánh giá code do AI tạo với bằng chứng ở cấp độ tác vụ để nắm bắt quy trình đánh giá thực tế.
Với các bản sửa lỗi nhỏ, hãy chỉ định một Agent. Sử dụng Crew khi tác vụ cần nhiều chuyên gia riêng biệt và sự phối hợp nhịp nhàng. Việc có thêm agent sẽ phát sinh thêm các lượt gọi và bước bàn giao qua lại (handoffs), vì vậy hãy đo lường kết quả trước khi biến quy trình làm việc song song thành mặc định. Hướng dẫn về Crew kết hợp đa model sẽ phân tích sâu hơn về các bước bàn giao này.
Hãy bắt đầu với mười tác vụ mang tính đại diện. Ghi lại tổng chi phí, thời gian đã trôi qua, tỷ lệ nghiệm thu và số phút kiểm duyệt của con người cho từng cấu hình. Kết nối một Máy tính trong Sharkly, giao một Task có phạm vi rõ ràng và yêu cầu cung cấp bằng chứng đi kèm khi bàn giao. Chỉ mở rộng quy mô sau khi bạn đã giải trình rõ ràng được chi phí trên mỗi kết quả được nghiệm thu.
Câu hỏi thường gặp
Chế độ fast mode của Claude Fable 5.2 có đắt gấp đôi không?
Đơn giá niêm yết cho input token và output token của fast mode cao gấp đôi so với giá tiêu chuẩn. Tuy nhiên, tổng chi phí cho toàn bộ quy trình làm việc của bạn còn phụ thuộc vào số lượng token, cơ chế caching, các công cụ sử dụng và số lần thử lại.
Mức effort Medium có làm thay đổi giá token không?
Effort làm thay đổi hành vi của model và lượng token tiêu thụ. Nó không thay thế đơn giá input và output niêm yết bằng một biểu giá riêng theo effort.
Ngân sách thuê bao (subscription) có giống với ngân sách API không?
Không. Bài viết này tính toán dựa trên mức sử dụng API theo lưu lượng thực tế (metered usage). Bạn cần kiểm tra riêng các điều khoản và hạn ngạch của gói thuê bao lập trình mà bạn đã kết nối.
Batch processing có giúp giảm chi phí hóa đơn không?
Batch API niêm yết mức giá $4 cho input và $20 cho output trên mỗi triệu token của Fable. Hãy tận dụng xử lý bất đồng bộ (asynchronous processing) nếu quy trình làm việc có thể chờ đợi; lưu ý rằng fast mode không khả dụng với Batch.
Chi phí mỗi lượt gọi thấp hơn có đồng nghĩa với chi phí bàn giao rẻ hơn không?
Chỉ khi số lần thử lại, tỷ lệ nghiệm thu, khâu điều phối và đánh giá vẫn giữ được lợi thế đó. Hãy so sánh tổng chi tiêu dựa trên số tác vụ được nghiệm thu thực tế, áp dụng cùng các tiêu chí nghiệm thu.
Tài nguyên bổ sung
Để lập kế hoạch quy trình liên quan, hãy đọc thêm bài viết về quản lý chi phí coding agent và năng lực kiểm duyệt của con người cho các agent chạy song song. Hãy kiểm tra lại tài liệu về giá và effort được dẫn link của Anthropic trước khi áp dụng các mức giá này vào ngân sách mới.


